Cours
Créer des applications d'IA avec Pinecone
3 h
11.6K
Une base de données vectorielle est un système conçu spécifiquement pour stocker et interroger des données sous forme de vecteurs. Ici, un vecteur est un ensemble ordonné de valeurs numériques pouvant représenter aussi bien des coordonnées spatiales que des attributs de caractéristiques — comme en machine learning et en data science, où les vecteurs servent souvent à décrire les caractéristiques d’objets. La base de données vectorielle permet de stocker et de retrouver ces vecteurs de caractéristiques de manière efficace.
Illustration par Gary Alway
L’embedding vectoriel consiste à représenter des objets (mots, phrases ou entités) sous forme de vecteurs dans un espace continu. Cette technique sert couramment à convertir des données dimensionnelles élevées et catégorielles en vecteurs continus de plus faible dimension, plus facilement exploitables par les algorithmes de machine learning. Les embeddings vectoriels sont particulièrement populaires en traitement automatique du langage (NLP), où ils représentent des mots ou des expressions.
L’idée clé des embeddings vectoriels est de capturer les relations sémantiques entre objets. Par exemple, pour des embeddings de mots, ceux qui ont des sens proches sont représentés par des vecteurs plus proches dans l’espace. Cela aide les modèles de machine learning à mieux comprendre les relations contextuelles et sémantiques entre les mots.
En s’appuyant sur ce principe, les grands modèles de langage (LLM) utilisent ces représentations numériques pour résoudre des tâches complexes de compréhension et de génération de langage.
À titre d’exemple concret, l’architecture sous-jacente du modèle de chat GPT repose sur l’usage de vecteurs. Le modèle traite des données en entrée (comme du texte) en les convertissant en vecteurs numériques.
Ces vecteurs capturent l’information sémantique et contextuelle de l’entrée, ce qui permet au modèle de produire des réponses cohérentes et pertinentes. L’architecture Transformer, sur laquelle GPT-3.5 est construit, utilise des mécanismes d’auto-attention pour pondérer l’importance des mots dans une séquence, améliorant encore la capture des relations et du contexte.
« Auto‑attention » désigne la capacité du modèle à affecter des degrés d’importance variables aux différents mots de la séquence en entrée.
En somme, le modèle GPT-3.5 fonctionne sur des représentations vectorisées du langage pour mener diverses tâches de compréhension et de génération. Cette approche fondée sur les vecteurs est un facteur clé de ses performances sur un large éventail d’applications liées au langage.
PG Vector est une extension open‑source pour la recherche de similarité vectorielle dans Postgres. Passons tout de suite à la pratique et créons une base avec Docker. Créez un fichier nommé docker-compose.yml, puis exécutez la commande suivante : docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
La prochaine étape consiste à créer une table. Dans cet exemple, nous allons cataloguer des ressources d’apprentissage DataCamp : cours, articles de blog, tutoriels, podcasts, fiches mémo, code alongs et certifications.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
La colonne embedding sera générée à partir d’un objet JSON sérialisé représentant les attributs de la ressource { name, content, slug, type }. Pour créer cet embedding vectoriel, nous allons utiliser un modèle d’embedding.
Un modèle disponible sur AWS Bedrock est amazon.titan-embed-text-v1. La configuration de Bedrock n’est pas couverte ici ; c’est simplement un exemple parmi de nombreux modèles d’embedding capables d’atteindre des résultats similaires. L’objectif est de transformer un texte en entrée, d’utiliser un modèle d’embedding pour générer des vecteurs, puis de les stocker dans la colonne embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]En stockant les données avec leurs embeddings, on exploite tout le potentiel des bases vectorielles : il devient possible d’interagir avec la base « en langage naturel » et de récupérer facilement des résultats pertinents.
Formulez simplement la question que vous souhaitez « poser à vos données » et appliquez le même embedding à ce texte. Voici à quoi ressemble la requête SQL :
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Cette requête effectue une recherche par similarité cosinus. Le paramètre $1 correspond à l’embedding de votre question en entrée, tandis que le paramètre $2 définit un seuil de similarité à ajuster par expérimentation. Sa valeur optimale dépendra notamment de la taille de votre jeu de données et du niveau de pertinence attendu, ce qui influence la granularité des résultats.
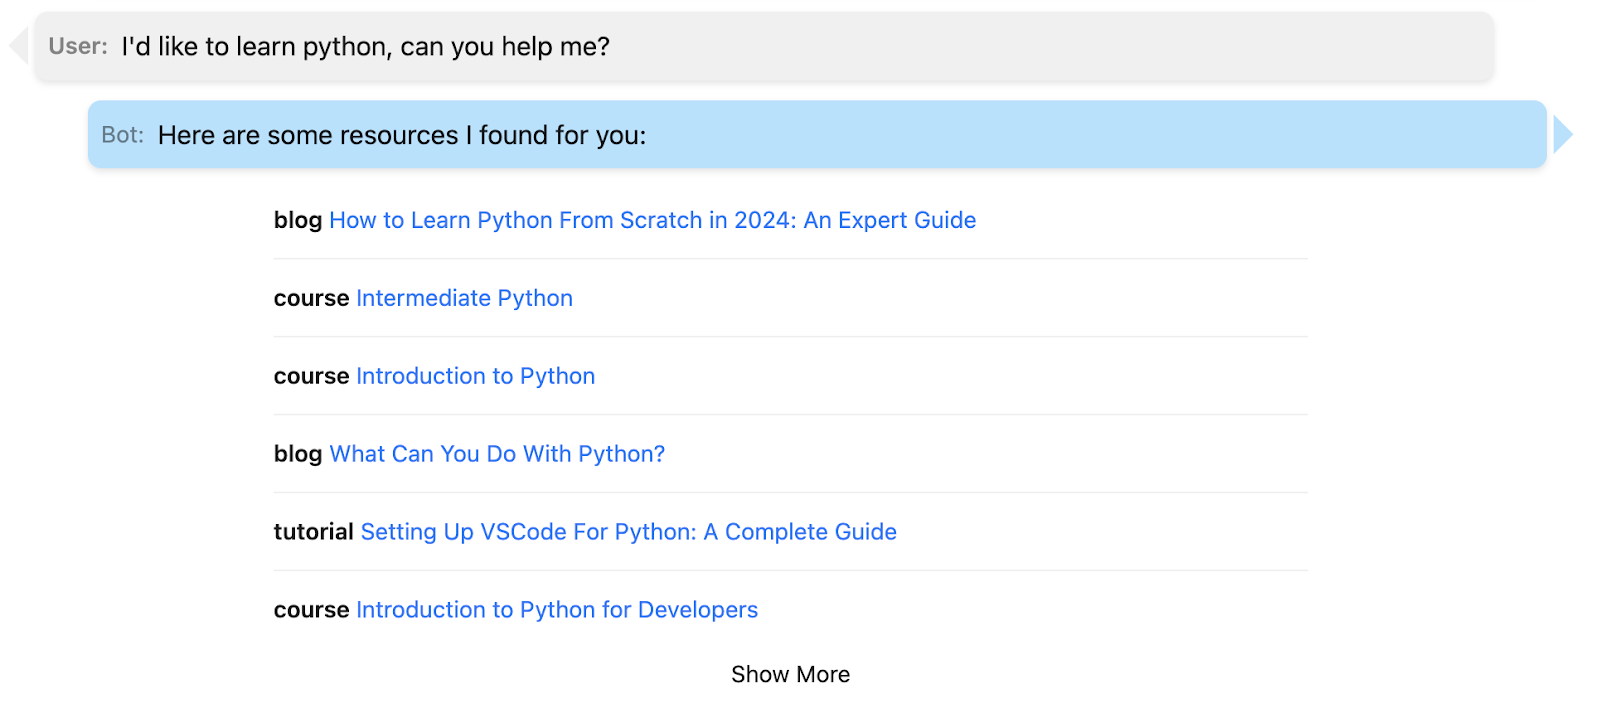
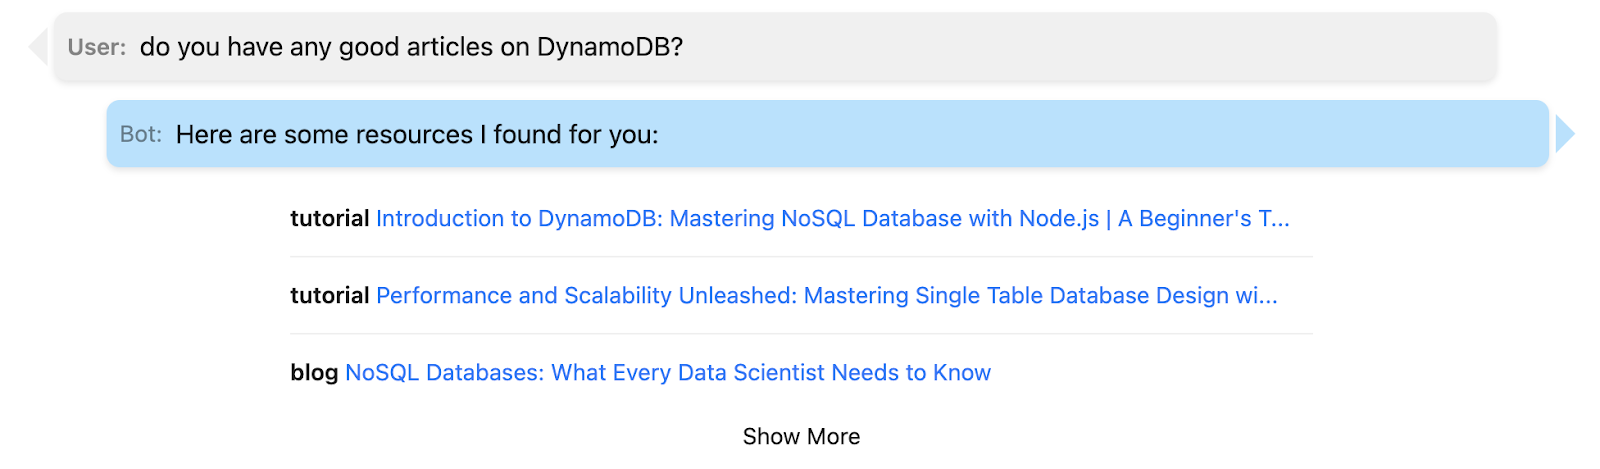
Avec ces éléments en place, créer une interface de type chat devient assez direct. Les détails d’implémentation sortent du cadre de cet article, mais voici quelques exemples basés sur mon jeu de données DataCamp, qui comprend plus de 600 enregistrements :
Dans cet article, nous avons exploré la puissance des bases de données vectorielles et mis à profit PG Vector pour améliorer nos capacités de stockage et de recherche. Si vous débutez avec les embeddings, il y a encore beaucoup à découvrir. Pour approfondir PG Vector, consultez leur readme, qui propose davantage de détails et des liens vers des clients dans votre langage de programmation préféré.
La suite naturelle, après les embeddings, est la Retrieval Augmented Generation (RAG). Il s’agit d’injecter des données contextuelles dans les grands modèles de langage (LLM). Ainsi, RAG apporte au modèle des connaissances hors de ses données d’entraînement, pour des réponses plus informées et pertinentes.
Vous trouverez aussi de nombreuses ressources DataCamp couvrant d’autres aspects des bases vectorielles, notamment :
Bon code, et que vos projets fondés sur les vecteurs soient à la fois riches d’enseignements et fructueux !
Poursuivez votre exploration des vecteurs dès aujourd’hui !
Cours
Cours
Cours