Ajuste de Hiperparâmetros em Python
BasicSkill Level
4 h
25.3K learners
A melhor forma de pensar em hiperparâmetros é como as “configurações” de um algoritmo que você ajusta para otimizar a performance — como girar os botões de um rádio AM até pegar um sinal limpo. Ao criar um modelo, você fará escolhas de design sobre a arquitetura. Muitas vezes, não dá para saber de imediato qual é a configuração ideal, então é útil explorar possibilidades. No verdadeiro espírito do machine learning, o ideal é que a própria máquina faça essa exploração e selecione automaticamente a arquitetura ótima.
No estudo de caso, você verá como a escolha certa de hiperparâmetros impacta a performance do modelo. Esse processo de escolher o melhor conjunto de valores é conhecido como “otimização de hiperparâmetros” ou “ajuste de hiperparâmetros”.
Modelos podem ter muitos hiperparâmetros, e encontrar a melhor combinação pode ser tratado como um problema de busca.
Embora existam muitos algoritmos de otimização/ajuste hoje, este post trata de duas estratégias simples: 1. busca em grade (grid search) e 2. busca aleatória (random search).
Grid search é uma abordagem que constrói e avalia, de forma sistemática, um modelo para cada combinação de hiperparâmetros especificada em uma grade.
Considere o exemplo:
Suponha que um modelo X receba os hiperparâmetros a1, a2 e a3. Na busca em grade, você primeiro define o intervalo de valores de cada um: a1, a2 e a3. Pense nisso como um array de valores para cada hiperparâmetro. A técnica de grid search vai então construir várias versões de X com todas as combinações possíveis de (a1, a2, a3) que você definiu. Esse conjunto de valores é a grade.
Suponha que você definiu a grade como:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Observe que os arrays de valores precisam ser válidos: você não pode fornecer valores float se o hiperparâmetro só aceita inteiros.
Agora, a busca em grade começará a construir várias versões de X com a grade definida.
Ela começará com a combinação [0,10,105] e terminará com [5,60,125], passando por todas as combinações intermediárias — o que torna a grid search computacionalmente cara.
Vamos ver a outra técnica de busca, a aleatória:
A ideia da busca aleatória foi proposta por James Bergstra & Yoshua Bengio. Você pode conferir o artigo original aqui.
A busca aleatória difere da busca em grade. Em vez de fornecer um conjunto discreto de valores para cada hiperparâmetro, você define uma distribuição estatística para cada um, da qual os valores serão amostrados aleatoriamente.
Antes de avançar, vamos alinhar o que significam distribuição e amostragem:
Em estatística, distribuição é o arranjo dos valores de uma variável mostrando a frequência observada ou teórica de ocorrência.
Já amostragem é o processo de escolher uma amostra representativa de uma população-alvo e coletar dados dessa amostra para entender algo sobre o todo.
Voltando à ideia da busca aleatória.
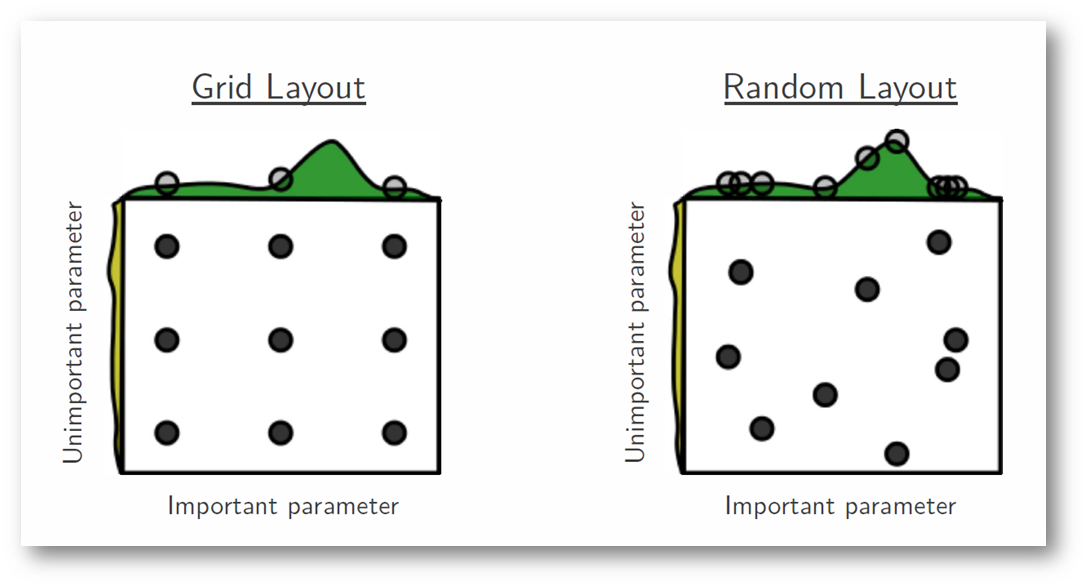
Você define uma distribuição de amostragem para cada hiperparâmetro. Também pode definir quantas iterações deseja construir ao buscar o modelo ótimo. A cada iteração, os valores dos hiperparâmetros serão definidos por amostragem dessas distribuições. Um dos fundamentos teóricos para preferir a busca aleatória à busca em grade é que, na maioria dos casos, os hiperparâmetros não têm a mesma importância. Segundo o artigo original:
“…para a maioria dos conjuntos de dados, apenas alguns hiperparâmetros realmente importam, mas hiperparâmetros diferentes são importantes em conjuntos de dados diferentes. Esse fenômeno torna a busca em grade uma escolha ruim para configurar algoritmos em novos conjuntos de dados.”
Na figura a seguir, buscamos em um espaço onde um dos hiperparâmetros influencia muito mais o score do modelo — as distribuições em cada eixo representam o score. Em ambos os casos, avaliamos nove modelos. A grid search ignora o modelo ótimo e gasta tempo redundante explorando o parâmetro pouco importante. Nela, isolamos cada hiperparâmetro e buscamos o melhor valor mantendo os demais constantes. Quando o hiperparâmetro analisado pouco afeta o score, há desperdício de esforço. Já a busca aleatória explora melhor e foca em encontrar o valor ideal do hiperparâmetro crítico.
Nas seções seguintes, você verá grid search e random search na prática com Python. Você também poderá decidir qual é melhor em eficácia e eficiência.
O ajuste de hiperparâmetros é uma etapa final no processo de machine learning aplicado antes de apresentar os resultados.
Usaremos o dataset de diabetes das Índias Pima. É um problema de classificação em que você precisa prever se uma pessoa terá diabetes com base em 8 variáveis do conjunto. A descrição completa está aqui.
O dataset tem 768 observações. A primeira tarefa é carregar os dados. Antes, vamos importar as dependências necessárias.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Com as dependências importadas, vamos carregar o dataset Pima Indians em um DataFrame do Pandas.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
O dataset foi carregado no DataFrame data. Vamos dar uma olhada.
data.head()

Você tem 8 variáveis e um rótulo 1/0, onde 1 indica diabetes e 0 indica ausência. O dataset é conhecido por conter valores ausentes. Especificamente, há observações faltantes em algumas colunas marcadas como zero. Isso fica claro pela definição dessas colunas e pelo conhecimento de domínio: zero para índice de massa corporal ou pressão arterial é inválido.
(Valores ausentes geram muitos problemas ao treinar um modelo. Aqui, vamos usar Regressão Logística para prever se o paciente tem diabetes. Regressão Logística não lida com valores ausentes.)
(Se quiser um reforço rápido sobre Regressão Logística, veja aqui.)
Vamos obter algumas estatísticas com o describe() do Pandas.
data.describe()

Útil.
Vemos colunas com valor mínimo zero (0). Em algumas, zero não faz sentido e indica valor inválido/ausente.
Especificamente, as seguintes colunas têm mínimo zero inválido:
Agora precisamos identificar e marcar esses valores como ausentes. Vamos confirmar olhando os primeiros 20 registros.
data.head(20)

Percebeu os zeros em várias colunas?
Você pode contar quantos valores ausentes existem em cada coluna. Para isso, marque como True os zeros no subconjunto de colunas de interesse e some os True por coluna. Precisaremos reimportar os dados sem nomes de coluna.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
As colunas 1, 2 e 5 têm poucos zeros; as 3 e 4 têm muito mais — quase metade das linhas. A coluna 0 também tem alguns valores ausentes, o que pode ocorrer. A coluna 8 é o alvo; ter ‘0’ nela é natural.
Isso mostra que diferentes estratégias de tratamento de “valores ausentes” podem ser necessárias por coluna para manter registros suficientes para treinar o modelo.
Em Python (Pandas, NumPy e Scikit-Learn), valores ausentes são marcados como NaN.
Valores NaN são ignorados em operações como soma, contagem etc.
Você pode marcar valores como NaN facilmente com replace() em um subconjunto do DataFrame.
Depois de marcar os ausentes, use isnull() para marcar todos os NaN como True e conte por coluna.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
As colunas 1:5 têm o mesmo número de ausentes que os zeros identificados — sinal de que marcamos corretamente.
Resumo útil. Mas vale conferir os dados para não se enganar.
Abaixo, os 5 primeiros registros.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Fica claro que marcar os ausentes funcionou. Agora, vamos imputar os valores faltantes. Imputar é substituir ausentes por valores estimados. Entre várias opções, usaremos imputação pela média — substituir ausentes pela média da coluna. Vamos fazer isso com fillna() do Pandas.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Perfeito! Agora o problema de valores ausentes foi tratado. Vamos usar esses dados para treinar um modelo de Regressão Logística com scikit-learn.
Primeiro, veremos o modelo com alguns hiperparâmetros aleatórios. Depois, vamos treinar dois outros modelos usando duas estratégias diferentes — grid search e random search.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Você criou o modelo de Regressão Logística com alguns hiperparâmetros definidos. Os hiperparâmetros usados foram:
Mais adiante, vamos otimizar/ajustar esses hiperparâmetros para comparar os resultados.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Hora de checar a acurácia.
lr.score(X,y)
0.7747395833333334
No passo acima, você avaliou o modelo no mesmo conjunto de dados. Mas sempre é preciso validar a estabilidade do seu modelo. Não dá para treinar no treino e esperar que funcione bem em dados inéditos. Você precisa de alguma garantia de que o modelo captou bem os padrões.
Para isso, usamos validação cruzada. Não entrarei em detalhes aqui, mas este post explica muito bem.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Você definiu n_splits=3, ou seja, validação cruzada 3-fold. Também definiu random_state=7 para reprodutibilidade. Poderia ser qualquer inteiro. Vamos aplicar.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Houve uma pequena queda no score. Dá para melhorar com ajuste/otimização de hiperparâmetros.
Vamos montar outro modelo de RL, agora ajustando os hiperparâmetros. Primeiro com grid search.
Importe a utilidade GridSearchCV do scikit-learn.
from sklearn.model_selection import GridSearchCV
Defina a grade de valores para os hiperparâmetros usados acima.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Grade definida. Vamos executar a busca e ver os resultados com tempo de execução.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Você pode definir uma grade maior e aplicar a busca em grade.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Houve ganho de acurácia, mas o tempo de execução também cresceu. Quanto maior a grade, maior o tempo.
Agora, vamos repetir com busca aleatória. O scikit-learn oferece RandomSearchCV. Importe as dependências.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Uau! A busca aleatória obteve a mesma acurácia em muito menos tempo.
Isso encerra o estudo de caso. Vamos recapitular!
Neste tutorial, você aprendeu sobre parâmetros e hiperparâmetros em modelos de machine learning e suas diferenças. Também viu o papel do ajuste de hiperparâmetros na construção de modelos eficientes. Construímos um classificador de Regressão Logística em Python com scikit-learn.
Você ajustou os hiperparâmetros com grid search e random search e comparou o desempenho.
Além disso, conferimos etapas simples de pré-processamento (como tratar valores ausentes) necessárias antes de treinar o modelo. Também cobrimos validação cruzada.
É bastante conteúdo — e tudo isso é importante na sua jornada em ciência de dados. Seguem leituras adicionais:
Leituras adicionais:
Para quem já está mais avançado, recomendo muito este artigo para otimizar hiperparâmetros em redes neurais de forma eficaz: link
Se você quer aprender mais sobre Machine Learning, faça estes cursos da DataCamp:
Saiba mais sobre machine learning
Curso
Curso
Curso
Tutorial
Kurtis Pykes
11 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Avinash Navlani
10 min
Tutorial
Tutorial
Moez Ali
14 min
Tutorial