Optimisation des hyperparamètres en Python
BasicSkill Level
4 h
25.3K learners
La meilleure façon de voir les hyperparamètres, c’est comme des réglages d’algorithme que vous pouvez ajuster pour optimiser les performances, un peu comme vous tournez le bouton d’une radio AM pour obtenir une réception nette. Lorsque vous créez un modèle de machine learning, vous devrez faire des choix d’architecture. Souvent, vous ne connaissez pas d’emblée la configuration optimale pour un modèle donné ; vous souhaitez donc explorer un éventail de possibilités. Fidèle à l’esprit du machine learning, l’idéal est de laisser la machine explorer et sélectionner automatiquement l’architecture la plus performante.
Vous verrez dans l’étude de cas comment le choix des bons hyperparamètres impacte les performances d’un modèle. Ce choix s’appelle généralement « optimisation des hyperparamètres » ou « réglage des hyperparamètres ».
Les modèles peuvent comporter de nombreux hyperparamètres, et trouver la meilleure combinaison se formule comme un problème de recherche.
Bien qu’il existe aujourd’hui de nombreux algorithmes d’optimisation des hyperparamètres, nous allons en présenter deux simples : 1. la recherche sur grille (grid search) et 2. la recherche aléatoire (random search).
La recherche sur grille consiste à construire et évaluer méthodiquement un modèle pour chaque combinaison d’hyperparamètres définie dans une grille.
Exemple :
Supposons qu’un modèle X prenne trois hyperparamètres a1, a2 et a3. En recherche sur grille, vous commencez par fixer un ensemble de valeurs possibles pour chacun d’eux. Vous pouvez voir cela comme un tableau de valeurs par hyperparamètre. La grid search va ensuite construire de multiples versions de X avec toutes les combinaisons possibles des valeurs (a1, a2, a3) que vous avez définies. Cet ensemble de valeurs forme la grille.
Par exemple, si vous définissez :
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Notez que les valeurs définies pour chaque hyperparamètre doivent être valides : vous ne pouvez pas fournir des valeurs flottantes si l’hyperparamètre n’accepte que des entiers.
La grid search va alors générer plusieurs versions de X à partir de la grille que vous avez définie.
Elle commencera par la combinaison [0,10,105] et finira par [5,60,125], en testant toutes les combinaisons intermédiaires, ce qui rend la recherche sur grille très coûteuse en calcul.
Passons maintenant à l’autre technique, la recherche aléatoire :
La recherche aléatoire d’hyperparamètres a été proposée par James Bergstra et Yoshua Bengio. Vous pouvez consulter l’article original ici.
La recherche aléatoire diffère de la recherche sur grille. Au lieu de fournir un ensemble discret de valeurs à explorer pour chaque hyperparamètre, vous spécifiez une loi statistique pour chaque hyperparamètre, à partir de laquelle des valeurs sont échantillonnées aléatoirement.
Avant d’aller plus loin, clarifions « distribution » et « échantillonnage » :
En statistique, une distribution est l’agencement des valeurs d’une variable et la fréquence observée ou théorique de leur apparition.
L’échantillonnage désigne le processus qui consiste à choisir un échantillon représentatif au sein d’une population cible et à collecter des données sur cet échantillon pour comprendre la population dans son ensemble.
Revenons maintenant à la recherche aléatoire.
Vous allez définir une distribution d’échantillonnage pour chaque hyperparamètre, ainsi que le nombre d’itérations à exécuter durant la recherche du modèle optimal. À chaque itération, les valeurs des hyperparamètres seront fixées par échantillonnage dans les distributions définies. L’un des arguments théoriques majeurs en faveur de la recherche aléatoire plutôt que la grille est que, dans la plupart des cas, tous les hyperparamètres n’ont pas la même importance. Selon l’article original :
« … pour la plupart des jeux de données, seuls quelques hyperparamètres comptent vraiment, et ces hyperparamètres importants diffèrent d’un jeu de données à l’autre. Ce phénomène rend la recherche sur grille peu adaptée pour configurer des algorithmes sur de nouveaux jeux de données. »
Dans la figure suivante, on explore un espace d’hyperparamètres où l’un d’eux a une influence bien plus forte sur l’optimisation du score — les distributions sur chaque axe représentent le score du modèle. Dans chaque cas, nous évaluons neuf modèles. La recherche sur grille passe à côté du modèle optimal et gaspille du temps sur le paramètre le moins important. En isolant chaque hyperparamètre et en cherchant la meilleure valeur tout en gardant les autres constants, si l’hyperparamètre étudié a peu d’effet sur le score, l’effort est perdu. À l’inverse, la recherche aléatoire offre un meilleur pouvoir exploratoire et peut se concentrer sur la valeur optimale de l’hyperparamètre critique.
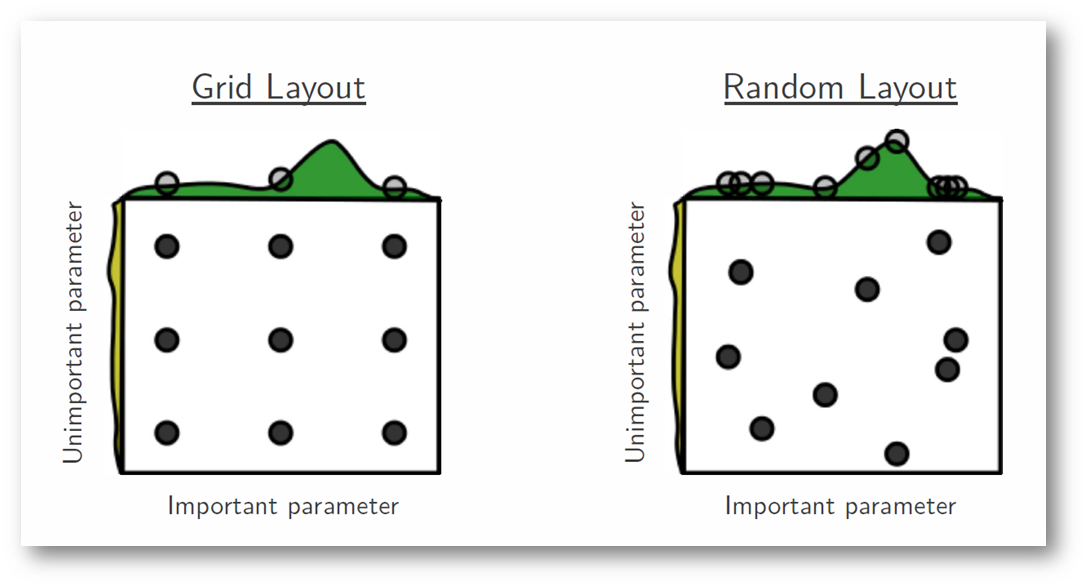
Dans les sections suivantes, vous verrez la grid search et la random search en action avec Python, et vous pourrez comparer efficacité et efficience.
Le réglage des hyperparamètres constitue l’ultime étape d’un projet de machine learning appliqué avant la présentation des résultats.
Nous utiliserons le jeu de données Pima Indians Diabetes. Il s’agit d’un problème de classification : prédire si une personne est susceptible de développer un diabète à partir de 8 variables. La description complète du jeu de données est disponible ici.
Le jeu de données contient 768 observations. Commencez par le charger pour pouvoir avancer. Mais d’abord, importons les dépendances nécessaires.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Maintenant que les dépendances sont importées, chargeons le jeu Pima Indians dans un DataFrame avec la bibliothèque Pandas.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Le jeu de données est chargé dans l’objet DataFrame data. Jetons un œil aux premières lignes.
data.head()

On observe 8 variables explicatives et une étiquette binaire 1/0, où 1 signifie que la personne a un diabète et 0 l’inverse. Ce jeu est connu pour contenir des valeurs manquantes. Plus précisément, certaines colonnes comportent des zéros là où cette valeur est invalide selon la définition et le bon sens médical : par exemple, un indice de masse corporelle ou une pression artérielle à zéro n’ont pas de sens.
(Les valeurs manquantes posent de nombreux problèmes quand on construit un modèle. Ici, nous allons utiliser une régression logistique pour prédire la présence de diabète. Or, la régression logistique ne gère pas directement les valeurs manquantes.)
(Pour un rappel rapide sur la régression logistique, vous pouvez consulter cet article.)
Récupérons quelques statistiques avec la méthode describe() de Pandas.
data.describe()

Utile.
On voit que certaines colonnes ont une valeur minimale à zéro (0). Pour certaines variables, un zéro n’a pas de sens et indique une valeur invalide ou manquante.
En particulier, les colonnes suivantes ont un minimum invalide égal à zéro :
Vous devez maintenant identifier et marquer ces valeurs comme manquantes. Vérifions-le en affichant les 20 premières lignes.
data.head(20)

Vous voyez des 0 dans plusieurs colonnes, n’est-ce pas ?
Calculons le nombre de valeurs manquantes dans chacune de ces colonnes. Pour cela, marquez comme True les zéros dans le sous-ensemble de colonnes concernées, puis comptez les True par colonne. Il faut réimporter les données sans noms de colonnes.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Les colonnes 1, 2 et 5 comptent peu de zéros, tandis que les colonnes 3 et 4 en ont beaucoup plus, près de la moitié des lignes. La colonne 0 a aussi plusieurs zéros, mais c’est attendu. La colonne 8 est la variable cible : y trouver des « 0 » est normal.
Cela montre que différentes stratégies de gestion des valeurs manquantes peuvent être nécessaires selon les colonnes, tout en conservant assez d’observations pour entraîner un modèle prédictif.
En Python (Pandas, NumPy, Scikit-Learn), on marque les valeurs manquantes par NaN.
Les NaN sont ignorés par des opérations comme sum, count, etc.
Vous pouvez remplacer facilement les zéros par NaN dans un sous-ensemble de colonnes avec la méthode replace() de Pandas.
Après avoir marqué les valeurs manquantes, utilisez isnull() pour repérer les NaN (True) et obtenir un comptage par colonne.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Les colonnes 1 à 5 affichent le même nombre de valeurs manquantes que de zéros précédemment identifiés : vous avez correctement balisé les valeurs manquantes.
Ce résumé est utile, mais vérifions visuellement les données pour s’assurer que tout est correct.
Ci-dessous, on affiche les 5 premières lignes.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
À la lecture des données brutes, le balisage des valeurs manquantes a bien fonctionné. Passons à l’imputation : remplacer les valeurs manquantes par des valeurs estimées. Parmi les différentes approches, utilisons l’imputation par la moyenne : on remplace les valeurs manquantes d’une colonne par sa moyenne. Faisons-le avec fillna() de Pandas.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Parfait ! Le problème des valeurs manquantes est résolu. Utilisons maintenant ces données pour construire un modèle de régression logistique avec scikit-learn.
Nous allons d’abord entraîner un modèle avec des hyperparamètres choisis arbitrairement. Puis nous en entraînerons deux autres via deux stratégies différentes : recherche sur grille et recherche aléatoire.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Vous avez créé un modèle de régression logistique avec quelques hyperparamètres. Ceux-ci sont :
Plus loin, nous optimiserons ces hyperparamètres pour comparer les résultats.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Vérifions l’accuracy.
lr.score(X,y)
0.7747395833333334
Ici, vous avez évalué le modèle sur les mêmes données que l’entraînement. Il faut néanmoins valider la robustesse d’un modèle. On ne peut pas se contenter d’ajuster le modèle sur l’entraînement en espérant qu’il généralisera bien sur des données inédites. Il faut s’assurer qu’il a bien capté les principaux motifs des données.
La validation croisée vient à la rescousse. Sans entrer dans les détails (hors périmètre ici), cet article l’explique très bien.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Vous avez fourni n_splits=3 : il s’agit donc d’une validation croisée en 3 plis. Le random_state=7 permet de reproduire les résultats (toute autre valeur entière aurait convenu). Appliquons-la.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
L’accuracy diminue légèrement. Vous pourrez faire mieux grâce au réglage des hyperparamètres.
Construisons un autre modèle, cette fois avec hyperparamètres optimisés. Commençons par la recherche sur grille.
Importons l’outil GridSearchCV de scikit-learn.
from sklearn.model_selection import GridSearchCV
Définissons la grille de valeurs pour les hyperparamètres utilisés plus haut.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
La grille est définie. Lançons la recherche et observons les résultats et le temps d’exécution.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Vous pouvez également définir une grille plus large et relancer la recherche.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
On constate un gain d’accuracy, mais le temps d’exécution augmente sensiblement. Plus la grille est grande, plus le temps explose.
Relançons maintenant avec la recherche aléatoire. Scikit-learn propose RandomSearchCV. Importons ce qu’il faut.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Super ! La recherche aléatoire atteint la même accuracy en bien moins de temps.
C’est tout pour l’étude de cas. Concluons !
Dans ce tutoriel, vous avez découvert les paramètres et hyperparamètres d’un modèle de machine learning, ainsi que leurs différences. Vous avez également vu le rôle clé de l’optimisation des hyperparamètres pour construire des modèles performants. Enfin, vous avez bâti un classificateur de régression logistique en Python avec scikit-learn.
Vous avez réglé les hyperparamètres avec la recherche sur grille et la recherche aléatoire et comparé leurs performances.
Vous avez aussi appliqué quelques étapes de prétraitement (gestion des valeurs manquantes) et abordé la validation croisée.
Cela fait beaucoup d’informations, toutes importantes pour votre progression en data science. Voici quelques lectures pour aller plus loin.
Ressources complémentaires :
Pour les profils plus avancés, je recommande vivement cet article pour optimiser efficacement les hyperparamètres des réseaux de neurones : lien
Pour approfondir le machine learning, suivez ces cours sur DataCamp :
En savoir plus sur le machine learning
Cours
Cours
Cours