Hyperparameter-Tuning in Python
BasicSkill Level
4 Std.
25.3K learners
Am besten denkst du über Hyperparameter wie über die „Einstellungen“ eines Algorithmus nach, die du zur Leistungsoptimierung verstellen kannst – ähnlich wie du an einem AM-Radio drehst, um einen klaren Empfang zu bekommen. Beim Erstellen eines Machine-Learning-Modells triffst du Architekturentscheidungen. Oft weißt du nicht sofort, welche Architektur optimal ist, und möchtest deshalb verschiedene Möglichkeiten ausloten. Im Sinne von Machine Learning lässt du diese Erkundung idealerweise die Maschine übernehmen und automatisch eine optimale Modellarchitektur auswählen.
In der Fallstudie wirst du sehen, wie sich die Wahl der Hyperparameter konkret auf die Modellleistung auswirkt. Die Auswahl der passenden Werte wird in der Regel als „Hyperparameter-Optimierung“ oder „Hyperparameter-Tuning“ bezeichnet.
Modelle können viele Hyperparameter besitzen, und die beste Kombination zu finden ist eine Suchaufgabe.
Es gibt inzwischen viele Verfahren zum Hyperparameter-Tuning. Hier betrachten wir zwei einfache Strategien: 1. Grid Search und 2. Random Search.
Grid Search baut und bewertet systematisch ein Modell für jede Kombination von Algorithmusparametern, die du in einem Gitter festgelegt hast.
Ein Beispiel:
Angenommen, ein Modell X hat die Hyperparameter a1, a2 und a3. Beim Grid Search definierst du zunächst für jeden Hyperparameter einen Wertebereich – praktisch ein Werte-Array. Die Grid-Search-Technik konstruiert dann viele Versionen von X mit allen möglichen Kombinationen der Hyperparameterwerte (a1, a2, a3), die du festgelegt hast. Dieser Wertebereich heißt Grid.
Beispiel-Grid:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Achte darauf, dass die Wertelisten gültig sind. Du kannst z. B. keine Gleitkommazahlen angeben, wenn der Hyperparameter nur ganze Zahlen akzeptiert.
Nun beginnt die Grid Search, mit deinem Grid viele Modellvarianten von X zu konstruieren.
Sie startet etwa mit der Kombination [0,10,105] und endet bei [5,60,125] – inklusive aller Zwischenkombinationen. Das macht Grid Search rechnerisch sehr aufwendig.
Schauen wir uns als Nächstes die Random-Search-Technik an:
Die Idee der zufälligen Suche nach Hyperparametern stammt von James Bergstra & Yoshua Bengio. Das Originalpaper findest du hier.
Random Search unterscheidet sich von Grid Search: Du gibst keine diskreten Wertemengen für jeden Hyperparameter vor, sondern eine statistische Verteilung, aus der Werte zufällig gezogen werden.
Bevor wir weitergehen, ein kurzer Blick auf Verteilungen und Sampling:
In der Statistik meint Verteilung die Anordnung der Werte einer Variablen und wie häufig sie beobachtet werden (oder theoretisch auftreten).
Sampling bezeichnet das Ziehen einer repräsentativen Stichprobe aus einer Grundgesamtheit, um Rückschlüsse auf das Ganze zu ziehen.
Zurück zur zufälligen Suche:
Du definierst für jeden Hyperparameter eine Stichprobenverteilung. Außerdem legst du fest, wie viele Iterationen du ausprobieren möchtest. In jeder Iteration werden die Hyperparameterwerte des Modells durch Ziehen aus den definierten Verteilungen gesetzt. Ein zentrales theoretisches Argument für Random Search statt Grid Search: In den meisten Fällen sind nicht alle Hyperparameter gleich wichtig. Laut Originalpaper:
„…für die meisten Datensätze sind nur wenige Hyperparameter wirklich entscheidend, aber je nach Datensatz sind es verschiedene. Dieses Phänomen macht Grid Search ungeeignet, um Algorithmen für neue Datensätze zu konfigurieren.“
In der folgenden Abbildung durchsuchen wir einen Hyperparameterraum, in dem ein Hyperparameter den Modellerfolg stark dominiert – die Verteilungen auf den Achsen zeigen den Modellscore. In beiden Fällen bewerten wir neun Modelle. Grid Search verfehlt das Optimum deutlich und verschwendet Zeit auf den unwichtigen Parameter. Bei Grid Search wurde jeder Hyperparameter isoliert betrachtet, während die anderen konstant gehalten wurden. Wenn der betrachtete Hyperparameter wenig Einfluss hat, führt das zu unnötigem Aufwand. Random Search hingegen exploriert besser und fokussiert sich eher auf den kritischen Hyperparameter.
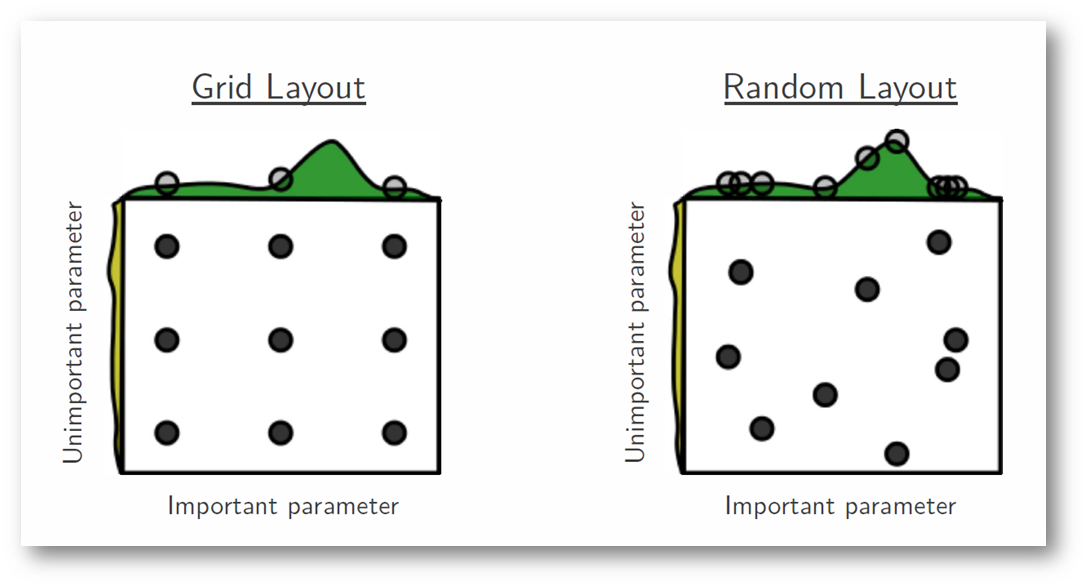
In den nächsten Abschnitten siehst du Grid Search und Random Search in Python im Einsatz und kannst Effektivität und Effizienz vergleichen.
Hyperparameter-Tuning ist der letzte Schritt im angewandten Machine Learning, bevor du Ergebnisse präsentierst.
Wir verwenden den Pima-Indians-Diabetes-Datensatz. Es handelt sich um ein Klassifikationsproblem: Anhand von 8 Merkmalen soll vorhergesagt werden, ob eine Person Diabetes hat. Die vollständige Beschreibung findest du hier.
Der Datensatz umfasst 768 Beobachtungen. Zuerst lädst du die Daten, vorher importieren wir die benötigten Abhängigkeiten.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Jetzt laden wir den Pima-Indians-Datensatz mit Pandas in ein DataFrame.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Die Daten liegen im DataFrame data. Werfen wir einen Blick darauf.
data.head()

Es gibt 8 Merkmale, und das Ziel ist 1 oder 0, wobei 1 für Diabetes steht und 0 für kein Diabetes. Der Datensatz enthält fehlende Werte. Manche Spalten haben fehlende Beobachtungen, die als 0 markiert sind. Das ist anhand der Spaltendefinitionen und der Fachlogik erkennbar: Ein Wert von 0 für BMI oder Blutdruck ist ungültig.
(Fehlende Werte sind problematisch beim Modellbau. In diesem Beispiel nutzen wir einen Logistic-Regression-Klassifikator. Logistic Regression kann fehlende Werte nicht verarbeiten.)
(Wenn du eine Auffrischung zu Logistic Regression brauchst, findest du sie hier.)
Lass uns mit describe() einige Statistiken abrufen.
data.describe()

Das ist hilfreich.
Wir sehen Spalten mit einem Minimum von 0. In einigen Spalten ist 0 unsinnig und bedeutet fehlend/ungültig.
Konkret sind folgende Spalten mit 0 als Minimum ungültig:
Nun markieren wir diese Werte als fehlend. Zur Bestätigung schauen wir uns die ersten 20 Zeilen an.
data.head(20)

Du siehst mehrere 0-Werte, richtig?
Wir zählen nun die Anzahl der Nullwerte in diesen Spalten. Dazu markieren wir in einem Spalten-Subset 0-Werte als True und zählen pro Spalte die True-Werte. Dafür laden wir die Daten ohne Spaltennamen neu.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Die Spalten 1, 2 und 5 haben nur wenige Nullen, Spalten 3 und 4 deutlich mehr – nahezu die Hälfte der Zeilen. Spalte 0 weist ebenfalls fehlende Werte auf, was aber unkritisch ist. Spalte 8 ist das Ziel; dort sind Nullen erwartbar.
Das zeigt: Unterschiedliche Strategien zum Umgang mit fehlenden Werten können je Spalte sinnvoll sein, damit genug Daten zum Trainieren bleiben.
In Python – insbesondere mit Pandas, NumPy und Scikit-Learn – werden fehlende Werte als NaN markiert.
NaN-Werte werden bei Operationen wie Summe oder Zählen ignoriert.
Mit DataFrame.replace() kannst du Werte in ausgewählten Spalten leicht durch NaN ersetzen.
Anschließend kannst du mit isnull() alle NaN-Werte als True markieren und pro Spalte zählen.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Die Spalten 1–5 haben nun genauso viele fehlende Werte wie zuvor Nullen. Das zeigt, dass die Markierung korrekt war.
Die Übersicht ist nützlich – zur Sicherheit schauen wir uns wieder die Rohdaten an.
Unten dieselbe Abfrage mit den ersten 5 Zeilen.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Die Rohdaten bestätigen die beabsichtigte Wirkung. Jetzt imputieren wir die fehlenden Werte. Beim Imputieren ersetzt ein Verfahren die fehlenden Werte. Wir nutzen Mean Imputation, also den Spaltenmittelwert. Mit Pandas fillna() geht das schnell.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Super – das Thema fehlende Werte ist erledigt. Jetzt bauen wir mit scikit-learn ein Logistic-Regression-Modell.
Zuerst mit zufällig gewählten Hyperparametern. Danach trainieren wir zwei weitere Modelle mit Grid Search und Random Search.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Du hast ein Logistic-Regression-Modell mit einigen zufälligen Hyperparametern erzeugt. Diese Hyperparameter hast du verwendet:
Später in der Fallstudie optimierst du diese Hyperparameter und vergleichst die Ergebnisse.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Zeit für den Accuracy-Score.
lr.score(X,y)
0.7747395833333334
Bisher hast du das Modell auf dieselben Daten angewandt und bewertet. Du musst aber prüfen, wie stabil dein Modell ist. Ein Modell nur auf Trainingsdaten zu fitten und zu hoffen, dass es auf unbekannten Daten gut funktioniert, reicht nicht. Du brauchst Evidenz, dass dein Modell die Muster tatsächlich gelernt hat.
Hier hilft Cross-Validation. Details sprengen den Rahmen, aber dieser Beitrag erklärt es sehr gut.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Mit n_splits=3 führst du eine 3-fach-Cross-Validation aus. random_state=7 dient der Reproduzierbarkeit; jeder andere Integer wäre auch möglich. Anwenden wir das Ganze.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Die Genauigkeit sinkt leicht. Mit Hyperparameter-Tuning geht da mehr.
Wir bauen nun ein weiteres LR-Modell, diesmal mit getunten Hyperparametern – zuerst via Grid Search.
Dafür stellt scikit-learn die Utility GridSearchCV bereit.
from sklearn.model_selection import GridSearchCV
Definieren wir das Grid für die oben genutzten Hyperparameter.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Das Grid steht. Jetzt führen wir die Suche aus und messen die Laufzeit.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Du kannst das Grid auch vergrößern und erneut suchen lassen.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Die Accuracy steigt, aber auch die Laufzeit. Je größer das Grid, desto länger die Suche.
Jetzt wiederholen wir alles mit Random Search. In scikit-learn heißt das RandomizedSearchCV. Importieren wir, was wir brauchen.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Stark! Random Search erreicht dieselbe Accuracy in deutlich kürzerer Zeit.
Das war die Fallstudie. Fassen wir zusammen.
In diesem Tutorial hast du Parameter und Hyperparameter von Machine-Learning-Modellen kennengelernt und ihre Unterschiede verstanden. Du weißt nun, welche Rolle Hyperparameter-Optimierung beim Aufbau leistungsfähiger Modelle spielt. Außerdem hast du mit scikit-learn eine einfache Logistic Regression in Python gebaut.
Du hast Hyperparameter mit Grid Search und Random Search getunt und gesehen, welche Methode in diesem Beispiel besser abschneidet.
Zusätzlich hast du kleine Schritte der Datenvorverarbeitung (Umgang mit fehlenden Werten) und Cross-Validation angewendet.
Das ist viel Stoff – und alles ist wichtig für deinen Weg in der Data Science. Hier sind weiterführende Quellen:
Weiterführende Literatur:
Für Fortgeschrittene empfehle ich dieses Paper zur effektiven Optimierung von Hyperparametern in neuronalen Netzen: link
Wenn du mehr über Machine Learning lernen möchtest, empfehlen wir diese DataCamp-Kurse:
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Matt Crabtree
5 Min.



