Curso
Entendendo Machine Learning
2 h
308.6K
Modelos de machine learning têm hiperparâmetros que impactam diretamente seu desempenho. Você pode pensar nesses parâmetros como a temperatura certa para assar um bolo ou o ângulo ideal para virar uma panqueca. Em reinforcement learning, os hiperparâmetros afetam as aproximações de política e de recompensa e, quando bem ajustados, podem melhorar drasticamente os resultados.
Neste artigo, vamos explorar o Optuna, um poderoso framework open source para otimização de hiperparâmetros. Se você está começando no tema, vale conferir o curso Understanding Machine Learning, que faz uma introdução sem código. Para praticar em Python, experimente nossa trilha Machine Learning Fundamentals with Python, que utiliza scikit-learn. Depois, o curso MLOps Concepts ajuda você a entender como levar modelos de ML do notebook local para produção. Por fim, faça o Preprocessing for Machine Learning in Python, altamente relevante aqui, pois ensina a limpar e preparar seus dados para modelos de machine learning.
Optuna é um framework open source de otimização de hiperparâmetros para automatizar a busca de configurações. Ele pode ser usado com qualquer framework de machine learning ou deep learning. Algumas das principais capacidades do Optuna incluem:
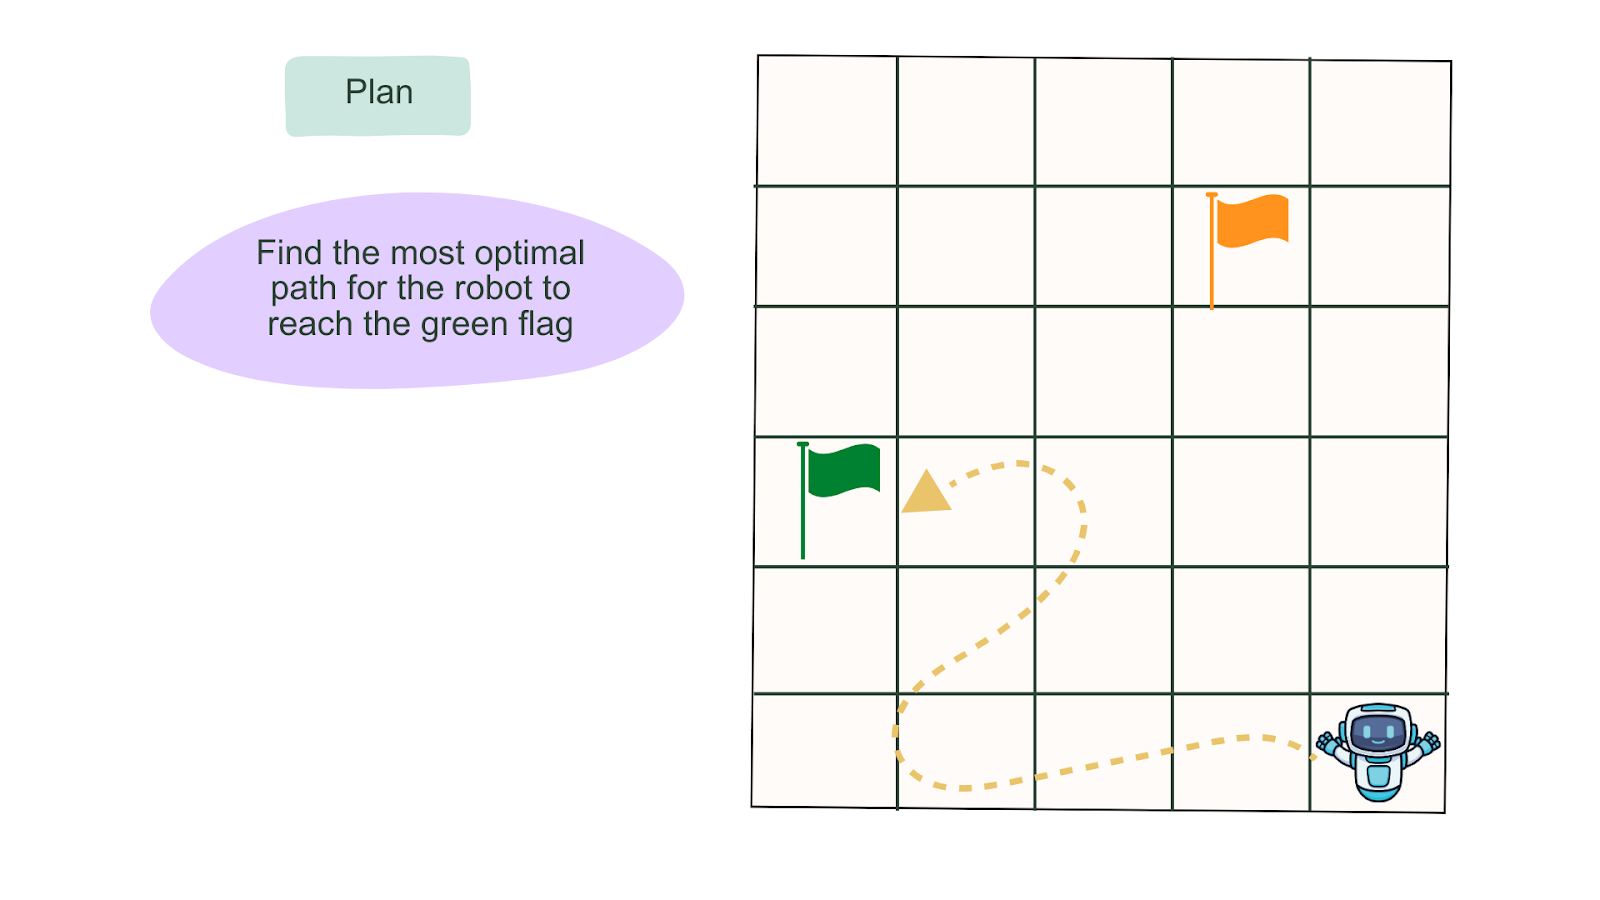
Encontrando o caminho ideal. Fonte: imagem do autor
Reinforcement learning (RL) combina machine learning e controle ótimo. Ele estuda como um agente inteligente deve agir em um ambiente dinâmico para maximizar sua recompensa cumulativa. Em termos simples, reinforcement learning é ensinar um agente a tomar decisões que maximizem suas recompensas em um ambiente. A recompensa a cada passo pode ser positiva ou negativa, conforme ele se aproxima do objetivo desejado.
Diferente de machine learning supervisionado, algoritmos de reinforcement learning tomam decisões buscando resultados ótimos, em um processo parecido com tentativa e erro que usamos para atingir metas. Deep reinforcement learning difere de RL clássico por usar redes neurais profundas para aproximar funções complexas. Também podemos dizer que o RL tradicional tende a abordagens mais determinísticas, enquanto o deep RL usa abordagens estocásticas.
Em um ambiente, pode haver várias rotas até o destino. E, comparado ao aprendizado supervisionado, o deep reinforcement learning é bem mais sensível à escolha de hiperparâmetros como taxa de aprendizado, gamma, número de passos, e assim por diante.
Uma má escolha de hiperparâmetros pode levar a convergência fraca ou instável. Esse desafio é agravado pela variabilidade de desempenho causada pelas sementes aleatórias (usadas para inicializar pesos da rede e o ambiente).
Nesta seção, vamos passar pelo processo de configurar o Optuna e dependências relacionadas, definir o espaço de busca e rodar a otimização para o algoritmo MountainCarContinuous-v0. O MountainCarContinuous-v0 é um dos algoritmos de RL do RL-Zoo, um framework de treino que oferece scripts para avaliar agentes e plotar resultados. O MountainCarContinous-v0 modela um ambiente onde o agente (um carro) tenta alcançar seu objetivo (chegar à bandeira).
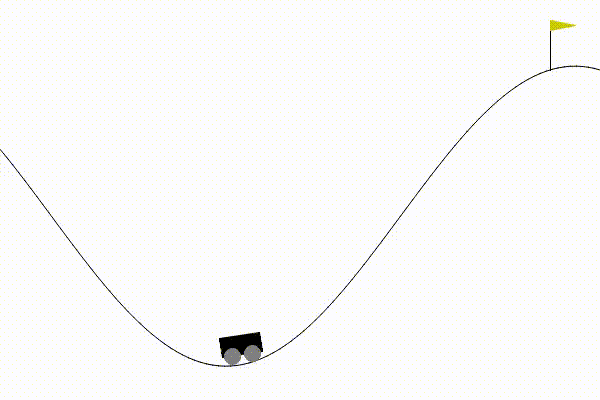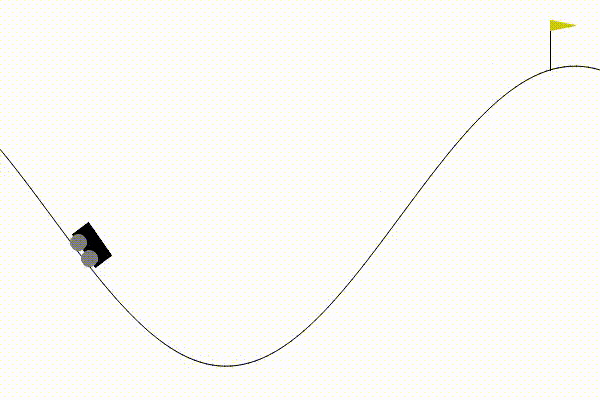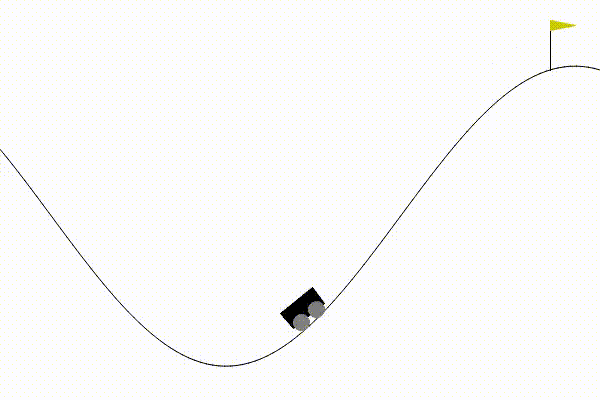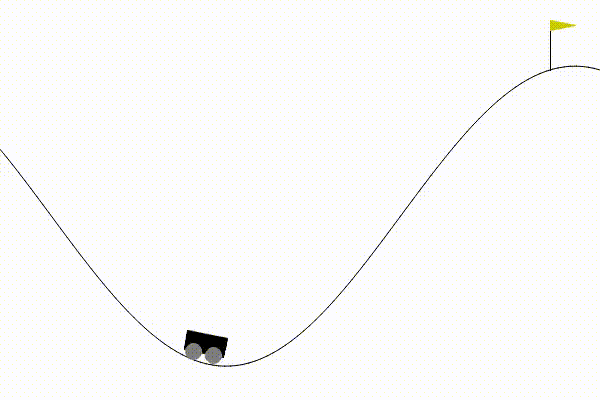
Representação do algoritmo MountainCarContinuous-v0 ajustado. Imagem do autor.
Para começar, você precisa:
Depois de criar um novo ambiente virtual, instalamos os pacotes. Observação: o Optuna suporta Python 3.7 ou superior. Se quiser revisar como criar um ambiente virtual, leia nosso tutorial Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribVamos usar o pacote gym para criar o ambiente onde o agente irá executar ações.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Este projeto vai usar o MountainCarContinuous-v0 com Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — um dos algoritmos Actor-Critic — é uma arquitetura híbrida que combina métodos baseados em valor (mede a recompensa de uma ação tomada) e baseados em política (controla as ações do agente), ajudando a estabilizar o treino ao reduzir a variância.
Vamos definir as configurações usadas nesta tarefa.
N_TRIALS = 100 # Número máximo de tentativas (trials)N_JOBS = 1 # Número de jobs em paraleloN_STARTUP_TRIALS = 5 # Parar a amostragem aleatória após N_STARTUP_TRIALSN_EVALUATIONS = 2 # Número de avaliações durante o treinoN_TIMESTEPS = 100000 # Orçamento de treinoEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutosENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Vamos sugerir um intervalo de valores para os hiperparâmetros.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Amostra hiperparâmetros de A2C para um trial do Optuna.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Foi definida uma função de CallBack, TrialEvalCallback(), porque queremos retornar resultados de avaliação periódicos das tarefas de otimização. Confira o notebook no Google Colab para a implementação do callback.
def objective(trial: optuna.Trial) -> float: """ Esta função será usada pelo Optuna para avaliar um conjunto de hiperparâmetros por vez.Dado um objeto trial, ela vai amostrar hiperparâmetros, avaliá-los e reportar o resultado. :param trial: objeto trial do Optuna :return: recompensa média por episódio após o treino """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Amostrar hiperparâmetros e atualizar os argumentos nomeados kwargs.update(a2c_hyper_params(trial)) # 2. Criar o modelo de RL model = A2C(**kwargs) # 3. Criar ambientes de avaliação com make_vec_env, ENV_ID e N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Criar o callback TrialEvalCallback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Treinar o modelo model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Às vezes, hiperparâmetros aleatórios podem gerar NaN print(e) nan_encountered = True finally: # Liberar memória model.env.close() eval_envs.close() # Informar ao otimizador que o trial falhou if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardPruning é reduzir parâmetros ou regiões do espaço de busca com menor chance de resultado ideal — neste caso, podando após um determinado orçamento. No Optuna, o pruning remove trials que têm desempenho pior nas etapas iniciais do treino. Isso reduz o conjunto de parâmetros e o tempo para chegar ao espaço de busca ótimo. O Optuna possui alguns pruners, incluindo o Median Pruner, que usa a regra de parada pela mediana. Saiba mais sobre Pruners na documentação do Optuna.
O algoritmo Median Pruner faz pruning se o melhor resultado atual for pior que a mediana dos resultados anteriores. A divisão por três é usada porque só queremos podar após 1/3 do orçamento máximo ser utilizado.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Selecione o sampler, que pode ser random, TPESampler, CMAES, etc.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Agora estamos prontos para criar um estudo no Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Vamos dar uma olhada em alguns recursos mais avançados do Optuna.
O Optuna oferece um dashboard que permite visualizar, acompanhar e analisar execuções atuais e anteriores. Antes, você talvez precisasse conectar uma ferramenta de tracking, como MLFlow, para gerenciar os resultados.
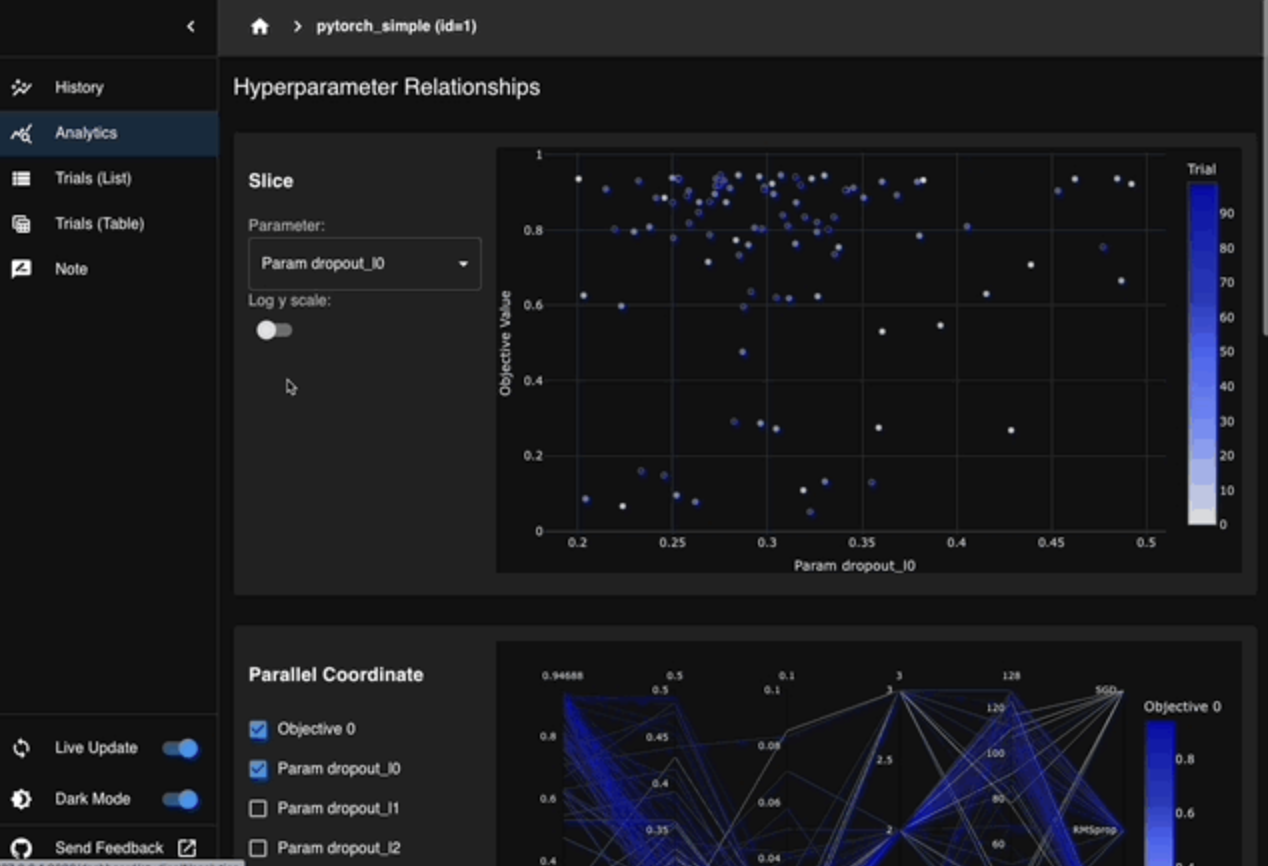
Optuna Dashboard. Fonte: Optuna
O suporte do Optuna a treino distribuído permite conectar seu backend distribuído, como Kubernetes ou Dask, para aproveitar mais recursos computacionais em experimentos em grande escala. Você também pode conectar um backend de armazenamento para guardar e gerenciar os resultados das sessões. É possível usar armazenamento em nuvem como o do Dask ou SQLite para execuções locais.
Aqui vão algumas dicas para evitar armadilhas comuns no ajuste de hiperparâmetros:
Aprenda machine learning com a DataCamp
Curso
Curso
Curso
Tutorial
Abid Ali Awan
11 min
Tutorial
Tutorial
Kurtis Pykes
11 min
Tutorial
DataCamp Team
10 min
Tutorial
Avinash Navlani
10 min
Tutorial
Moez Ali
14 min




