

Instalar o pandas
Instale o pandas com o comando pip install no seu terminal. O pandas 3 requer Python 3.11 ou superior; em uma versão mais antiga, o pip instala a versão 2.x mais recente compatível com o seu Python.
pip install pandasComo alternativa, você pode instalar via conda:
conda install pandasDepois de instalar o pandas, é uma boa prática checar a versão instalada para garantir que tudo esteja funcionando corretamente:
import pandas as pd
print(pd.__version__) # Prints the pandas versionIsso confirma que o pandas foi instalado corretamente e permite verificar a compatibilidade com outros pacotes.
O que mudou no pandas 3.0 e 3.1
O pandas 3.0, lançado em janeiro de 2026, mudou como funcionam cópias, strings e atribuições, e o pandas 3.1 (outubro de 2026) descontinuou a maioria dos usos de inplace=True. Códigos de tutoriais antigos em geral ainda rodam, mas quatro mudanças costumam pegar as pessoas de surpresa:
- Copy-on-Write é o padrão. Qualquer subconjunto ou resultado de método se comporta como uma cópia, então alterá-lo nunca muda o DataFrame original. O
SettingWithCopyWarningsumiu, assim como a necessidade de chamadas defensivas a.copy(). - Atribuição encadeada não funciona mais.
df["Age"][0] = 35atualiza uma cópia temporária e deixadfinalterado; o pandas avisa com umChainedAssignmentError. Use uma única chamada.loc[]no lugar. - Strings têm seu próprio tipo. Colunas de texto agora são inferidas como
strem vez deobject, com backend em PyArrow quando instalado. inplace=Trueestá descontinuado emsort_values(),reset_index(),dropna(),drop_duplicates(),rename()e vários outros métodos. Reatribua o resultado:df = df.dropna().
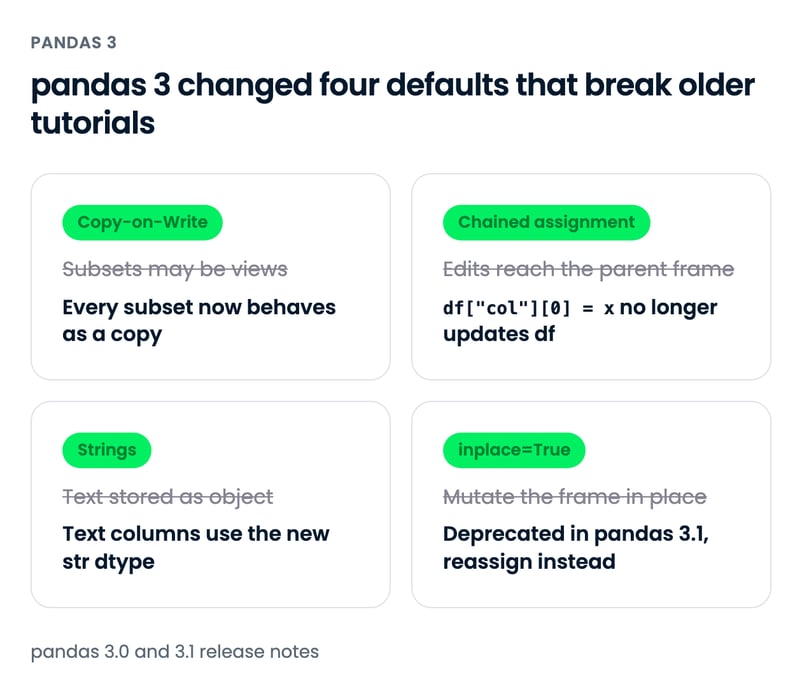
Veja a mudança de atribuição encadeada em um DataFrame pequeno:
import pandas as pd
patients = pd.DataFrame({"name": ["Ana", "Ben", "Chloe"], "age": [34, 51, 28]})
patients["age"][0] = 35 # chained assignment: patients is not changed
patients.loc[0, "age"] = 35 # a single .loc[] call: patients is updated
print(patients.dtypes)name str
age int64
dtype: objectTodo exemplo neste tutorial segue as regras do pandas 3. Para a lista completa de mudanças, veja as notas oficiais de lançamento do pandas 3.0 e do pandas 3.1. Se você mantém código antigo, nosso guia sobre o SettingWithCopyWarning explica o comportamento que o Copy-on-Write substituiu.
Importando dados no pandas
Para começar a trabalhar com o pandas, importe o pacote conforme abaixo. Ao importar, o alias mais comum é pd.
import pandas as pdImportando arquivos CSV
Use read_csv() com o caminho do arquivo para ler um CSV (veja nosso tutorial sobre importação com read_csv() para mais detalhes).
df = pd.read_csv("diabetes.csv")Essa leitura carrega o arquivo diabetes.csv em um DataFrame chamado df. Ao longo do tutorial, usamos o conjunto de dados Pima Indians Diabetes: 768 pacientes, oito medições de saúde como Glucose, BMI e Age, e uma coluna Outcome onde 1 significa diagnóstico de diabetes.
Importando arquivos de texto
Ler arquivos de texto é parecido com CSV. A única nuance é especificar um separador com o argumento sep, como abaixo. O separador é o caractere que separa os valores (colunas) em cada linha. Vírgula (sep=","), tabulação (sep="\t"), dois-pontos (sep=":") e espaço em branco (sep=r"\s+") são os mais comuns. r"\s+" é uma expressão regular que casa um ou mais espaços em branco; o prefixo r cria uma raw string, então o Python não trata \s como sequência de escape inválida.
df = pd.read_csv("diabetes.txt", sep=r"\s+")Importando arquivos Excel (uma planilha)
Leia arquivos Excel com a função read_excel(), passando o caminho do arquivo. O pandas precisa de um pacote extra para Excel: instale openpyxl para arquivos .xlsx ou xlrd para os antigos .xls.
df = pd.read_excel('diabetes.xlsx')Você também pode especificar outros argumentos, como header para definir qual linha vira o cabeçalho do DataFrame. O padrão é 0, que marca a primeira linha como nomes de coluna. Você pode definir nomes de coluna como uma lista no argumento names. O argumento index_col (padrão None) pode ser usado se o arquivo contiver um índice de linhas.
Observação: Em um DataFrame ou Series do pandas, o índice identifica a posição de uma linha ou coluna. Em resumo, o índice rotula a linha ou a coluna do DataFrame e permite acessar um item específico usando seu índice (você verá isso adiante). O índice de linhas pode ser um intervalo (ex.: 0 a 303), uma série temporal (datas ou timestamps), um identificador único (ex.: employee_ID em uma tabela employees) ou outros tipos. Para colunas, geralmente é uma string (o nome da coluna).
Importando arquivos Excel (múltiplas planilhas)
Ler Excel com várias planilhas não é muito diferente. Basta usar o argumento adicional sheet_name, passando uma string com o nome da planilha ou um inteiro com a posição (lembre que o Python usa indexação base 0; a primeira planilha é sheet_name = 0)
# Extraindo a segunda planilha (Python usa indexação base 0)
df = pd.read_excel('diabetes_multi.xlsx', sheet_name=1)Importando arquivo JSON
Semelhante ao read_csv(), você pode usar read_json() para arquivos JSON, passando o nome do arquivo (para mais detalhes, leia este tutorial sobre importar JSON e HTML no pandas). O código abaixo lê um JSON do disco e cria um DataFrame df.
df = pd.read_json("diabetes.json")Se quiser aprender mais sobre importação com pandas, confira este cheat sheet sobre importação de vários tipos de arquivo em Python.
Importando dados de bancos SQL
Para carregar dados de um banco relacional, use pd.read_sql() junto com uma conexão de banco.
import sqlite3
# Abre uma conexão com um banco SQLite
conn = sqlite3.connect("my_database.db")
# Lê dados de uma tabela
df = pd.read_sql("SELECT * FROM my_table", conn)Para outros bancos, como PostgreSQL ou MySQL, passe um engine do SQLAlchemy como conexão em vez de sqlite3. Para tabelas grandes, defina o argumento chunksize para ler o resultado em lotes.
Importando dados de uma API (formato JSON)
Se seus dados vêm de uma API web, o pandas pode ler direto usando pd.read_json():
df = pd.read_json("https://api.example.com/data.json")Se a resposta da API for um JSON aninhado, achate-o com pd.json_normalize(), que transforma chaves aninhadas em colunas separadas por ponto:
records = [
{"id": 1, "vitals": {"glucose": 148, "bmi": 33.6}},
{"id": 2, "vitals": {"glucose": 85, "bmi": 26.6}},
]
pd.json_normalize(records) id vitals.glucose vitals.bmi
0 1 148 33.6
1 2 85 26.6Exportando dados no pandas
Assim como o pandas importa dados de vários formatos, ele também exporta para diversos tipos. Isso é comum quando você transforma dados com pandas e precisa salvá-los localmente. Veja como exportar DataFrames para diferentes formatos.
Exportar um DataFrame para CSV
Um DataFrame (aqui usamos df) é salvo como CSV com o método .to_csv(). Passe o caminho do arquivo e defina index=False a menos que você precise do índice de linhas no arquivo (o padrão, index=True, escreve o índice como uma coluna extra sem nome). Nosso tutorial sobre salvar um DataFrame em CSV cobre os outros argumentos.
df.to_csv("diabetes_out.csv", index=False)Exportar um DataFrame para JSON
Exporte um DataFrame para JSON chamando .to_json().
df.to_json("diabetes_out.json")Observação: Um arquivo JSON armazena um objeto tabular como pares chave-valor. Assim, você verá cabeçalhos de coluna repetidos no JSON.
Exportar um DataFrame para arquivo de texto
Como ao escrever CSVs, você pode chamar .to_csv(). As diferenças são que a saída é .txt e você deve definir um separador com o argumento sep.
df.to_csv('diabetes_out.txt', header=df.columns, index=None, sep=' ')Exportar um DataFrame para Excel
Chame .to_excel() no DataFrame para salvar como .xlsx (isso requer openpyxl). O pandas não grava mais arquivos .xls legados.
df.to_excel("diabetes_out.xlsx", index=False)Visualizando e entendendo DataFrames no pandas
Depois de ler dados tabulares em um DataFrame, vale dar uma olhada geral. Você pode ver uma amostra pequena do conjunto ou um resumo estatístico.
Como visualizar dados com .head() e .tail()
Veja as primeiras ou últimas linhas de um DataFrame com .head() ou .tail(), respectivamente. Você pode especificar o número de linhas pelo argumento n (padrão 5).
df.head()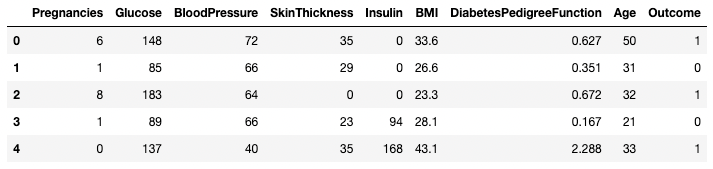
Primeiras cinco linhas do DataFrame
df.tail(n = 10)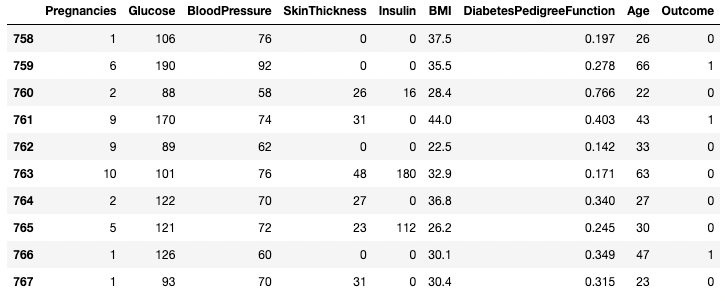
Últimas 10 linhas do DataFrame
Entendendo os dados com .describe()
O método .describe() imprime estatísticas de resumo de todas as colunas numéricas, como contagem, média, desvio padrão, faixa e quartis.
df.describe()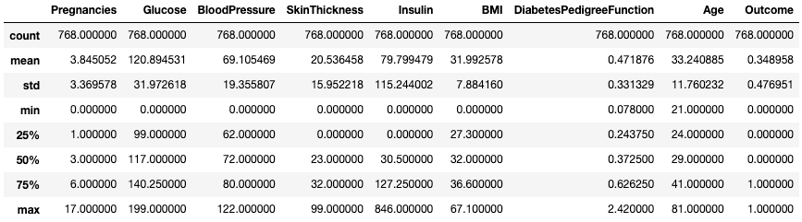
Obtenha estatísticas de resumo com .describe()
Isso dá uma visão rápida da escala, assimetria e faixa dos dados numéricos.
Você também pode ajustar os quartis usando o argumento percentiles. Aqui, por exemplo, olhamos para os percentis de 30%, 50% e 70% nas colunas numéricas do DataFrame df.
df.describe(percentiles=[0.3, 0.5, 0.7])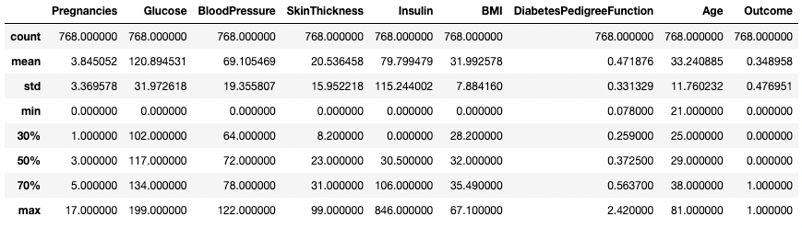
Estatísticas de resumo com percentis específicos
Você também pode isolar tipos específicos no resumo usando o argumento include. Aqui, por exemplo, estamos resumindo apenas colunas com tipo de dado integer.
df.describe(include=[int])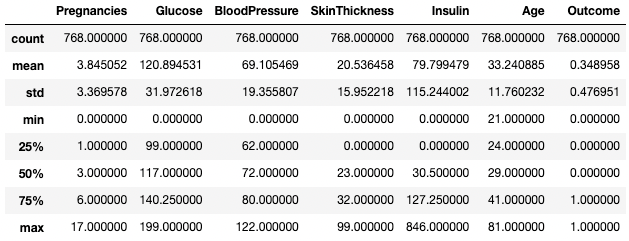
Resumo apenas das colunas inteiras
Da mesma forma, você pode excluir certos tipos usando o argumento exclude.
df.describe(exclude=[int]) BMI DiabetesPedigreeFunction
count 768.000000 768.000000
mean 31.992578 0.471876
std 7.884160 0.331329
min 0.000000 0.078000
25% 27.300000 0.243750
50% 32.000000 0.372500
75% 36.600000 0.626250
max 67.100000 2.420000
Muitas vezes é mais fácil visualizar essas estatísticas transpondo com o atributo .T.
df.describe().T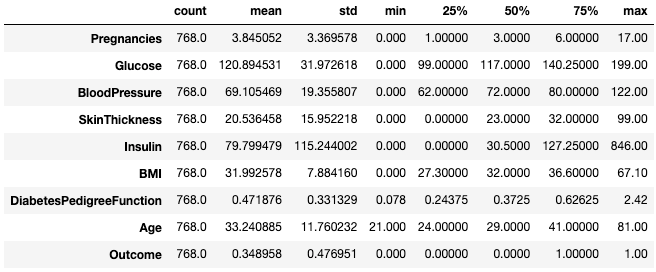
Transpondo o resumo estatístico com .T
Para saber mais sobre descrição de DataFrames, confira este cheat sheet.
Entendendo os dados com .info()
O método .info() é uma forma rápida de ver tipos de dados, valores ausentes e tamanho de um DataFrame. Aqui, definimos show_counts como True, que mostra o número de valores não ausentes em cada coluna. Também definimos memory_usage como True, que exibe o uso total de memória dos elementos do DataFrame. Quando verbose é True, ele imprime o resumo completo de .info().
df.info(show_counts=True, memory_usage=True, verbose=True)<class 'pandas.DataFrame'>
RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Pregnancies 768 non-null int64
1 Glucose 768 non-null int64
2 BloodPressure 768 non-null int64
3 SkinThickness 768 non-null int64
4 Insulin 768 non-null int64
5 BMI 768 non-null float64
6 DiabetesPedigreeFunction 768 non-null float64
7 Age 768 non-null int64
8 Outcome 768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KBEntendendo seus dados com .shape
O número de linhas e colunas de um DataFrame é identificado pelo atributo .shape. Ele retorna uma tupla (linhas, colunas) e pode ser indexado para obter apenas a contagem de linhas ou de colunas.
df.shape # Número de linhas e colunas
df.shape[0] # Número de linhas
df.shape[1] # Número de colunas(768,9)
768
9Listar todas as colunas e nomes de colunas
Chamar o atributo .columns de um DataFrame retorna os nomes das colunas como um objeto Index. Relembrando: um índice no pandas é o endereço/rótulo de linha ou coluna.
df.columnsIndex(['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI',
'DiabetesPedigreeFunction', 'Age', 'Outcome'],
dtype='str')Você pode convertê-lo em lista usando list().
list(df.columns)['Pregnancies',
'Glucose',
'BloodPressure',
'SkinThickness',
'Insulin',
'BMI',
'DiabetesPedigreeFunction',
'Age',
'Outcome']Verificando valores ausentes no pandas com .isnull()
O DataFrame de exemplo não tem valores ausentes. Vamos inserir alguns para deixar mais interessante. O método .copy() cria uma cópia do DataFrame original. Trabalhar na cópia mantém o df intacto para os exemplos seguintes. Usando .loc (coberto mais adiante), você pode definir as linhas rotuladas de 2 a 5 da coluna Pregnancies como ausentes. Como ausências são armazenadas como NaN, um float, o pandas converte a coluna de int64 para float64.
df2 = df.copy()
df2.loc[2:5,'Pregnancies'] = None
df2.head(7)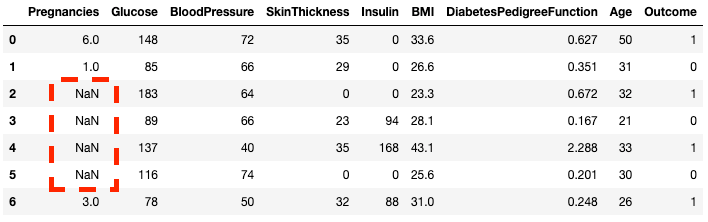
Agora as linhas 2 a 5 estão NaN
Você pode verificar se cada elemento é ausente usando o método .isnull().
df2.isnull().head(7)Como muitas vezes é mais útil saber quanto falta, combine .isnull() com .sum() para contar o número de nulos em cada coluna.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Você também pode somar duas vezes para obter o total de nulos no DataFrame.
df2.isnull().sum().sum()4Ordenando, fatiando e extraindo dados no pandas
O pandas oferece várias formas de ordenar, criar subconjuntos, filtrar e isolar dados nos seus DataFrames. Aqui vão as mais comuns.
Ordenando dados
Para ordenar um DataFrame por uma coluna específica, use .sort_values(). Ele retorna um novo DataFrame ordenado e deixa df inalterado, então atribua o resultado a uma variável se quiser mantê-lo:
df.sort_values(by="Age", ascending=False) # Ordena por Age em ordem decrescenteVocê pode ordenar por múltiplas colunas:
df.sort_values(by=["Age", "Glucose"], ascending=[False, True])Reiniciando o índice
Ordenar ou filtrar mantém os rótulos de linha originais, então o índice pode ficar fora de ordem. Use .reset_index() para obter um índice novo começando em 0 (veja nosso tutorial de reset de índice no pandas para mais opções):
df_sorted = df.sort_values(by="Age", ascending=False).reset_index(drop=True) # drop=True descarta o índice antigo
df_sorted[["Age", "Glucose", "Outcome"]].head(3) Age Glucose Outcome
0 81 134 0
1 72 119 0
2 70 145 1Isolando uma coluna usando [ ]
Você pode isolar uma única coluna usando colchetes [ ] com o nome da coluna. A saída é uma Series do pandas. Uma Series é um array unidimensional com dados de qualquer tipo, como inteiro, float, string, booleano, objetos Python etc. Um DataFrame é composto por várias Series que funcionam como colunas.
df['Outcome']0 1
1 0
2 1
3 0
4 1
..
763 0
764 0
765 0
766 1
767 0
Name: Outcome, Length: 768, dtype: int64Isolando duas ou mais colunas usando [[ ]]
Você também pode fornecer uma lista de nomes de colunas dentro dos colchetes para buscar mais de uma coluna. Aqui, os colchetes são usados de duas formas: os externos indicam um subconjunto do DataFrame e os internos criam uma lista.
df[['Pregnancies', 'Outcome']] Pregnancies Outcome
0 6 1
1 1 0
2 8 1
3 1 0
4 0 1
.. ... ...
763 10 0
764 2 0
765 5 0
766 1 1
767 1 0
[768 rows x 2 columns]Isolando uma linha usando [ ]
Uma única linha pode ser obtida passando uma Series booleana com um valor True. No exemplo abaixo, é retornada a segunda linha com index = 1. Aqui, .index retorna os rótulos das linhas do DataFrame, e a comparação vira um array booleano unidimensional.
df[df.index==1]
Isolando uma linha no pandas
Isolando duas ou mais linhas usando [ ]
Da mesma forma, duas ou mais linhas podem ser retornadas usando o método .isin() em vez do operador ==.
df[df.index.isin(range(2,10))]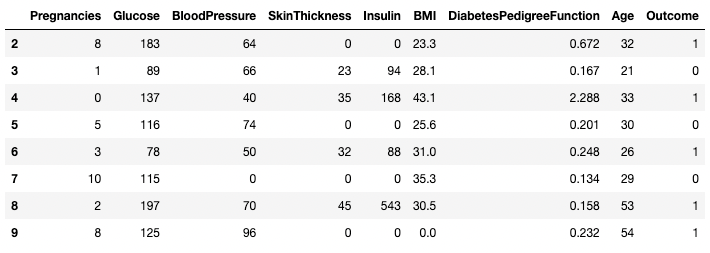
Isolando linhas específicas no pandas
Usando .loc[] e .iloc[] para buscar linhas
Você pode buscar linhas específicas por rótulos ou condições usando .loc[] e .iloc[] ("location" e "integer location"). .loc[] usa o rótulo para apontar para linha, coluna ou célula, enquanto .iloc[] usa a posição numérica. Nosso guia de loc vs iloc cobre todas as diferenças; para ver a principal aqui, vamos alterar o índice de df2 criado antes para que rótulos e posições não coincidam mais.
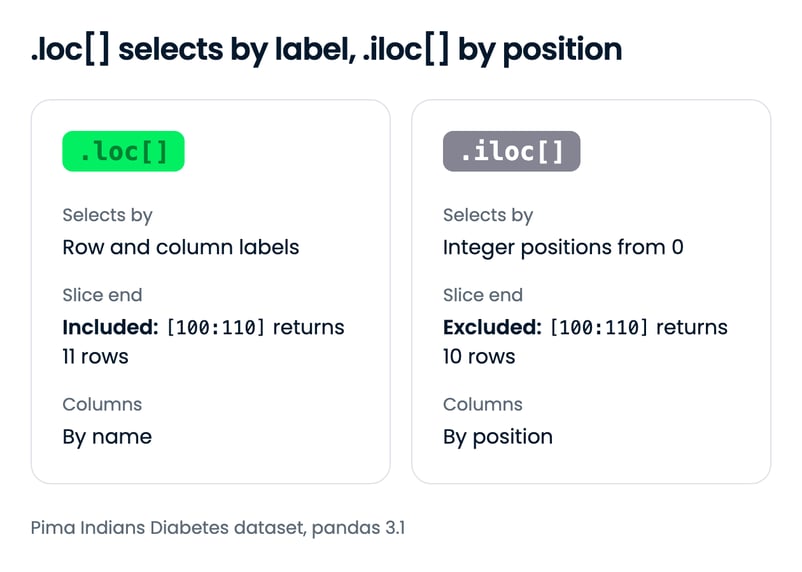
df2.index = range(1,769)O exemplo abaixo retorna uma Series em vez de um DataFrame. Em .loc[1], 1 é um rótulo, então ele retorna a linha rotulada 1 (a primeira após a reindexação). Em .iloc[1], 1 é uma posição base 0, então retorna a segunda linha, que tem rótulo 2.
df2.loc[1]Pregnancies 6.000
Glucose 148.000
BloodPressure 72.000
SkinThickness 35.000
Insulin 0.000
BMI 33.600
DiabetesPedigreeFunction 0.627
Age 50.000
Outcome 1.000
Name: 1, dtype: float64df2.iloc[1]Pregnancies 1.000
Glucose 85.000
BloodPressure 66.000
SkinThickness 29.000
Insulin 0.000
BMI 26.600
DiabetesPedigreeFunction 0.351
Age 31.000
Outcome 0.000
Name: 2, dtype: float64Você também pode buscar várias linhas fornecendo um intervalo entre colchetes. Os dois acessores tratam o final do intervalo de forma diferente: .loc[100:110] inclui o rótulo 110 e retorna 11 linhas, enquanto .iloc[100:110] para antes da posição 110 e retorna 10 linhas.
df2.loc[100:110]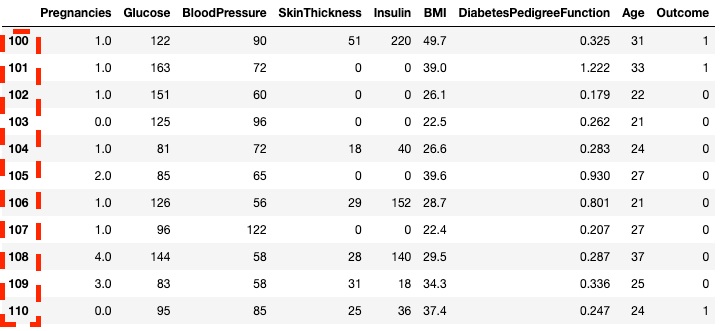
Isolando linhas no pandas com .loc[]
df2.iloc[100:110]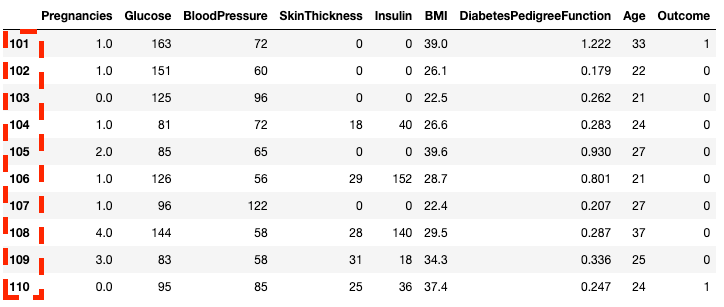
Isolando linhas no pandas com .iloc[]
Você também pode criar subconjuntos com .loc[] e .iloc[] usando uma lista em vez de intervalo.
df2.loc[[100, 200, 300]]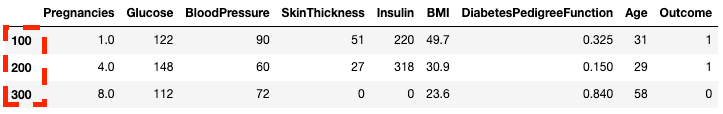
Isolando linhas com lista no .loc[]
df2.iloc[[100, 200, 300]]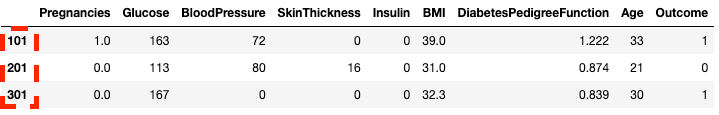
Isolando linhas com lista no .iloc[]
Você também pode selecionar colunas específicas junto com linhas. Aqui .iloc[] difere de .loc[] — ele exige posição das colunas, não rótulos.
df2.loc[100:110, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
100 1.0 122 90
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85df2.iloc[100:110, :3] Pregnancies Glucose BloodPressure
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85Para fluxos mais rápidos, você pode passar o índice inicial de uma linha como intervalo.
df2.loc[760:, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
760 6.0 190 92
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70df2.iloc[760:, :3] Pregnancies Glucose BloodPressure
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70Você pode atualizar valores combinando .loc[] com o operador de atribuição =. Construa a condição a partir do mesmo DataFrame que você está atualizando: uma condição construída a partir de df não se alinha mais com o novo índice de df2, e o pandas gera um erro.
df2.loc[df2["Age"] == 81, "Age"] = 80Filtrando linhas com condições
pandas permite filtrar dados com condições sobre valores de linhas/colunas. Por exemplo, o código abaixo seleciona a linha onde Blood Pressure é exatamente 122. Aqui estamos isolando linhas com colchetes [ ] como nas seções anteriores. Porém, em vez de indices de linhas ou nomes de colunas, passamos uma condição onde a coluna BloodPressure é igual a 122. Denotamos essa condição com df.BloodPressure == 122.
df[df.BloodPressure == 122]
Isolando linhas com base em uma condição no pandas
O exemplo abaixo busca todas as linhas onde Outcome é 1. Aqui df.Outcome seleciona essa coluna, df.Outcome == 1 retorna uma Series booleana indicando quais Outcome são iguais a 1 e, então, [] pega o subconjunto de df onde essa Series é True.
df[df.Outcome == 1]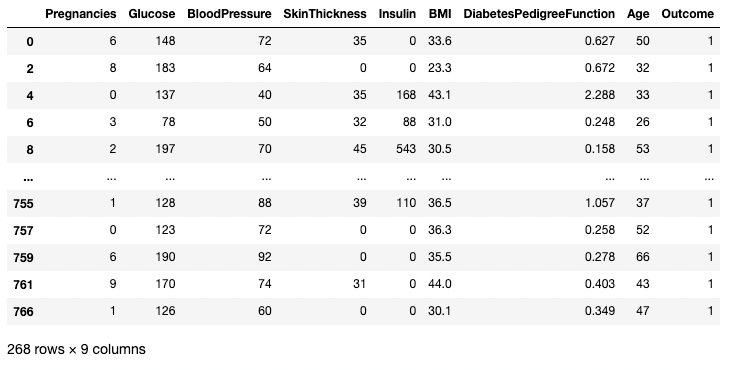
Isolando linhas com base em uma condição no pandas
Você pode usar o operador > para comparações. O código abaixo busca Pregnancies, Glucose e BloodPressure para todos os registros com BloodPressure maior que 100.
df.loc[df['BloodPressure'] > 100, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
43 9 171 110
84 5 137 108
106 1 96 122
177 0 129 110
207 5 162 104
362 5 103 108
369 1 133 102
440 0 189 104
549 4 189 110
658 11 127 106
662 8 167 106
672 10 68 106
691 13 158 114Limpando dados no pandas
Limpeza de dados é uma das tarefas mais comuns em ciência de dados. O pandas permite pré-processar dados para qualquer uso, incluindo o treinamento de modelos de machine learning e deep learning. Vamos usar o DataFrame df2 de antes, com quatro valores ausentes, para ilustrar alguns casos. Relembrando, veja como contar quantos valores ausentes há em um DataFrame.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Técnica #1 para lidar com ausências: remover valores ausentes
Uma forma é descartar os ausentes. Isso é útil quando você tem muitos dados e perder uma pequena parte não impacta a análise. Use .dropna() como abaixo. Aqui, salvamos o resultado em df3.
df3 = df2.copy()
df3 = df3.dropna()
df3.shape(764, 9) # são 4 linhas a menos que df2O argumento axis permite escolher se você remove linhas ou colunas com ausências. O padrão remove linhas que contêm NaNs. Use axis = 1 para remover colunas com um ou mais NaN. Como em todo exemplo deste tutorial, reatribuímos o resultado em vez de passar inplace=True, que o pandas 3.1 descontinuou para .dropna().
df3 = df2.dropna(axis=1)
list(df3.columns)['Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DiabetesPedigreeFunction', 'Age', 'Outcome']Por padrão, .dropna() remove a linha se qualquer um de seus valores estiver ausente. Defina how como 'all' para remover apenas linhas onde todos os valores estejam ausentes. Nenhuma linha em df2 está completamente vazia, então nada é removido:
df3 = df2.dropna(how="all")
df3.shape(768, 9)Técnica #2 para lidar com ausências: substituir valores ausentes
Em vez de remover, você pode substituir por uma estatística-resumo ou um valor fixo. Por exemplo, se faltar um dia em uma semana de leituras de temperatura, preencher com a média da semana mantém a linha e perde pouca informação. O código abaixo preenche os ausentes de Pregnancies com a média da coluna.
df3 = df2.copy()
# Média de Pregnancies
mean_value = df3["Pregnancies"].mean()
# Preenche apenas os ausentes dessa coluna
df3["Pregnancies"] = df3["Pregnancies"].fillna(mean_value)
df3["Pregnancies"].head(7)1 6.000000
2 1.000000
3 3.846859
4 3.846859
5 3.846859
6 3.846859
7 3.000000
Name: Pregnancies, dtype: float64Lidando com dados duplicados
Vamos adicionar duplicatas aos dados originais para aprender como eliminá-las. Aqui, usamos pd.concat() para concatenar as linhas de df2 com o próprio df2, adicionando duplicatas perfeitas de cada linha.
df3 = pd.concat([df2, df2])
df3.shape(1536, 9)Você pode remover todas as linhas duplicadas (padrão) do DataFrame usando .drop_duplicates().
df3 = df3.drop_duplicates()
df3.shape(768, 9)Renomeando colunas
Uma tarefa comum de limpeza é renomear colunas. Passe ao método .rename() um dicionário em columns mapeando nomes antigos para novos:
df3 = df3.rename(columns={"DiabetesPedigreeFunction": "DPF"})
df3[["Glucose", "BMI", "DPF", "Age"]].head() Glucose BMI DPF Age
1 148 33.6 0.627 50
2 85 26.6 0.351 31
3 183 23.3 0.672 32
4 89 28.1 0.167 21
5 137 43.1 2.288 33Você também pode atribuir uma lista completa de nomes a .columns. A lista deve nomear todas as colunas na ordem atual: o pandas atribui por posição, então uma lista fora de ordem rotula seus dados de forma equivocada sem aviso.
df3.columns = ["Pregnancies", "Glucose", "BloodPressure", "SkinThickness", "Insulin", "BMI", "DPF", "Age", "Outcome"]
list(df3.columns)['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DPF', 'Age', 'Outcome']Para mais sobre limpeza de dados e para fluxos mais fáceis e previsíveis, confira este checklist, que traz um conjunto abrangente de tarefas comuns de data cleaning.
Combinando DataFrames no pandas
pandas combina DataFrames de duas formas: .merge() faz junções por colunas-chave compartilhadas, como um join em SQL, e pd.concat() empilha tabelas em cima ou lado a lado.
Mesclando DataFrames com .merge()
Use .merge() quando duas tabelas compartilham uma coluna-chave. Suponha que uma segunda tabela mapeie cada código Outcome para um rótulo legível. Um left merge em Outcome adiciona esse rótulo a cada linha de paciente:
outcome_labels = pd.DataFrame({"Outcome": [0, 1], "Diagnosis": ["Non-diabetic", "Diabetic"]})
df_labeled = df.merge(outcome_labels, on="Outcome", how="left")
df_labeled[["Glucose", "Outcome", "Diagnosis"]].head(3) Glucose Outcome Diagnosis
0 148 1 Diabetic
1 85 0 Non-diabetic
2 183 1 DiabeticO argumento how define o tipo de junção: "left" mantém todas as linhas de df, "inner" mantém apenas as que têm correspondência nas duas tabelas e "outer" mantém todas as linhas de ambas. Nosso tutorial sobre como juntar DataFrames no pandas cobre .join() e todos os tipos em detalhe.
Concatenando DataFrames com pd.concat()
Use pd.concat() quando as tabelas têm as mesmas colunas e você quer empilhar as linhas — por exemplo, registros de pacientes que chegam em dois lotes. Defina ignore_index=True para obter um índice novo começando em 0, em vez de manter os rótulos de cada lote:
batch_1 = df.iloc[:500]
batch_2 = df.iloc[500:]
df_combined = pd.concat([batch_1, batch_2], ignore_index=True)
df_combined.shape(768, 9)Com axis=1, pd.concat() coloca as tabelas lado a lado, casando as linhas pelos rótulos do índice:
measurements = df[["Glucose", "BMI"]]
outcomes = df[["Outcome"]]
pd.concat([measurements, outcomes], axis=1).head(3) Glucose BMI Outcome
0 148 33.6 1
1 85 26.6 0
2 183 23.3 1Para praticar na mão as duas abordagens, experimente nosso curso Joining Data with pandas.
Análise de dados no pandas
O grande valor do pandas está na velocidade para analisar dados. Nesta seção, vamos focar em um conjunto de técnicas de análise que você pode usar no pandas.
Operadores de resumo (média, moda, mediana)
Como você viu antes, dá para obter a média de cada coluna com o método .mean().
df.mean()Pregnancies 3.845052
Glucose 120.894531
BloodPressure 69.105469
SkinThickness 20.536458
Insulin 79.799479
BMI 31.992578
DiabetesPedigreeFunction 0.471876
Age 33.240885
Outcome 0.348958
dtype: float64A moda pode ser calculada de forma semelhante com .mode().
df.mode()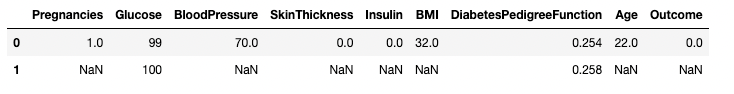
Imprimindo a moda das colunas no pandas
Da mesma forma, a mediana de cada coluna é calculada com .median()
df.median()Pregnancies 3.0000
Glucose 117.0000
BloodPressure 72.0000
SkinThickness 23.0000
Insulin 30.5000
BMI 32.0000
DiabetesPedigreeFunction 0.3725
Age 29.0000
Outcome 0.0000
dtype: float64Criar novas colunas a partir de colunas existentes
O pandas fornece computação rápida e eficiente ao combinar colunas como variáveis escalares. O código abaixo divide cada valor da coluna Glucose pelo valor correspondente em Insulin para criar a coluna Glucose_Insulin_Ratio.
df2['Glucose_Insulin_Ratio'] = df2['Glucose']/df2['Insulin']
df2.head()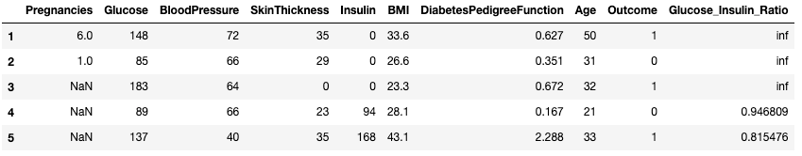
Criar uma nova coluna a partir de colunas existentes no pandas
Linhas onde Insulin é 0 mostram inf, pois dividir por zero dá infinito. Neste conjunto, 0 em Insulin indica medição ausente (374 das 768 linhas), então trate esses zeros como ausentes antes de dividir:
df2["Glucose_Insulin_Ratio"] = df2["Glucose"] / df2["Insulin"].where(df2["Insulin"] > 0)
df2["Glucose_Insulin_Ratio"].head()1 NaN
2 NaN
3 NaN
4 0.946809
5 0.815476
Name: Glucose_Insulin_Ratio, dtype: float64.where() mantém valores que atendem à condição e substitui o restante por NaN, então a razão fica ausente em vez de infinita nessas linhas. Nosso tutorial sobre adicionar colunas no pandas mostra mais formas de derivar novas colunas.
Contagens com .value_counts()
Quando uma coluna guarda categorias, você geralmente quer contar quantas observações caem em cada uma. O método .value_counts() faz isso. Aqui, por exemplo, contamos quantas observações têm Outcome diabético (1) e quantas têm Outcome não diabético (0).
df['Outcome'].value_counts()Outcome
0 500
1 268
Name: count, dtype: int64Adicionar o argumento normalize retorna proporções em vez de contagens absolutas.
df['Outcome'].value_counts(normalize=True)Outcome
0 0.651042
1 0.348958
Name: proportion, dtype: float64
Desative a ordenação automática dos resultados usando o argumento sort (padrão True). O padrão ordena pelas contagens em ordem decrescente.
df['Outcome'].value_counts(sort=False)Outcome
1 268
0 500
Name: count, dtype: int64Você também pode aplicar .value_counts() a um DataFrame e a colunas específicas em vez de apenas a uma coluna. Aqui, por exemplo, aplicamos value_counts() em df com o argumento subset, que recebe uma lista de colunas.
df.value_counts(subset=['Pregnancies', 'Outcome'])Pregnancies Outcome
1 0 106
2 0 84
0 0 73
3 0 48
4 0 45
0 1 38
5 0 36
6 0 34
1 1 29
3 1 27
7 1 25
4 1 23
8 1 22
5 1 21
7 0 20
2 1 19
9 1 18
6 1 16
8 0 16
10 0 14
1 10
9 0 10
11 1 7
13 0 5
1 5
12 0 5
11 0 4
12 1 4
14 1 2
15 1 1
17 1 1
Name: count, dtype: int64Agregando dados com .groupby() no pandas
pandas permite agregar valores agrupando por valores de colunas específicas. Você faz isso combinando .groupby() com um método de resumo à sua escolha. O código abaixo mostra a média de cada coluna numérica agrupada por Outcome.
df.groupby('Outcome').mean()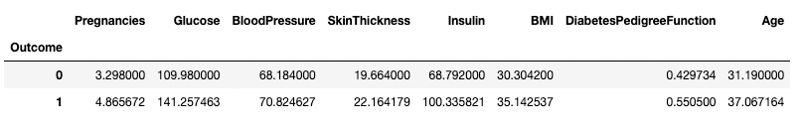
Agregando dados por uma coluna no pandas
.groupby() permite agrupar por mais de uma coluna passando uma lista de nomes, como abaixo.
df.groupby(['Pregnancies', 'Outcome']).mean()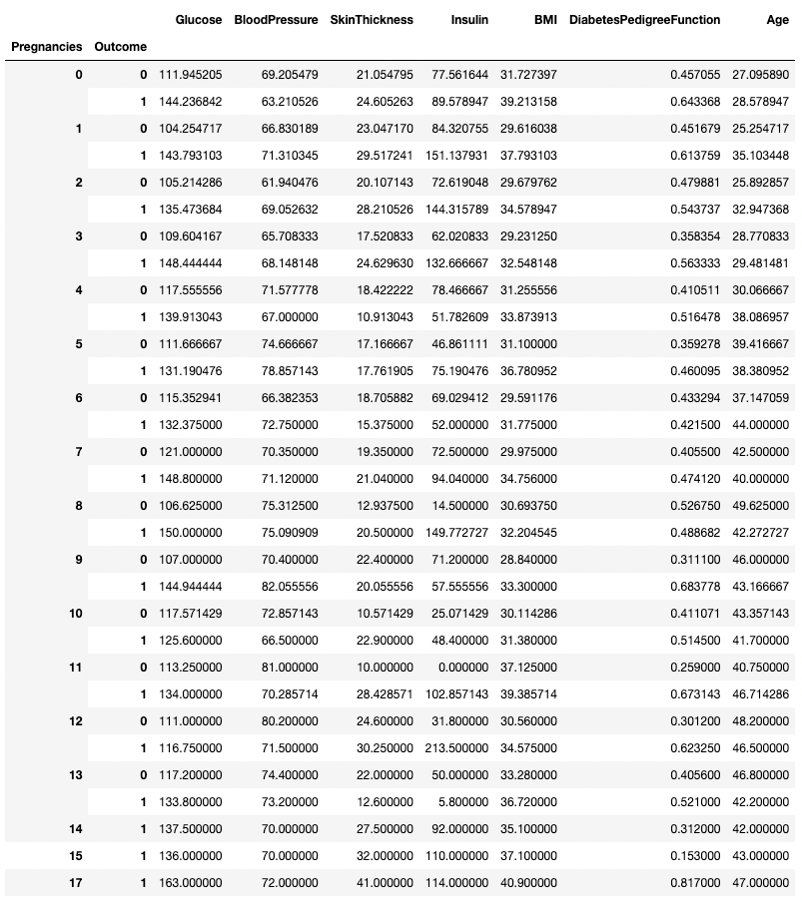
Agregando dados por duas colunas no pandas
Qualquer método de resumo pode ser usado com .groupby(), incluindo .min(), .max(), .mean(), .median(), .sum() e mais. Nosso tutorial de GroupBy no pandas cobre múltiplas agregações com .agg() e outros padrões.
Tabelas dinâmicas (pivot)
pandas também permite calcular estatísticas como tabelas dinâmicas (pivot). Isso facilita tirar conclusões com base na combinação de variáveis. O código abaixo usa as linhas como valores únicos de Pregnancies, as colunas como valores únicos de Outcome, e as células contêm o BMI médio do grupo correspondente.
Por exemplo, para Pregnancies = 5 e Outcome = 0, o BMI médio é 31,1.
pd.pivot_table(df, values="BMI", index='Pregnancies',
columns=['Outcome'], aggfunc='mean')Outcome 0 1
Pregnancies
0 31.727397 39.213158
1 29.616038 37.793103
2 29.679762 34.578947
3 29.231250 32.548148
4 31.255556 33.873913
5 31.100000 36.780952
6 29.591176 31.775000
7 29.975000 34.756000
8 30.693750 32.204545
9 28.840000 33.300000
10 30.114286 31.380000
11 37.125000 39.385714
12 30.560000 34.575000
13 33.280000 36.720000
14 NaN 35.100000
15 NaN 37.100000
17 NaN 40.900000Visualização de dados no pandas
pandas fornece wrappers convenientes para as funções de plotagem do Matplotlib para facilitar a visualização dos seus DataFrames. Abaixo, veja como fazer visualizações comuns com pandas.
Gráficos de linha no pandas
pandas permite traçar relações entre variáveis com gráficos de linha. Abaixo, um gráfico de BMI e Glucose em função do índice das linhas.
df[['BMI', 'Glucose']].plot.line()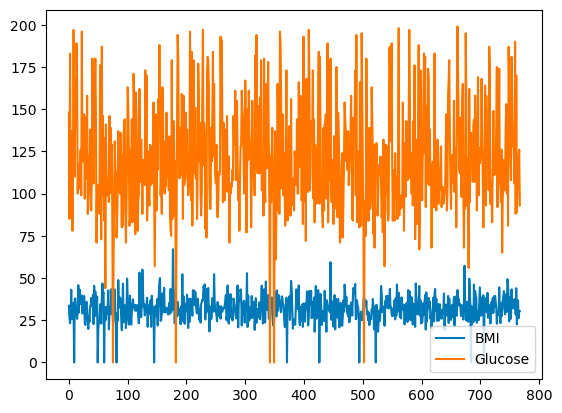
Gráfico de linha básico com pandas
Você pode escolher as cores usando o argumento color.
df[['BMI', 'Glucose']].plot.line(color={"BMI": "red", "Glucose": "blue"})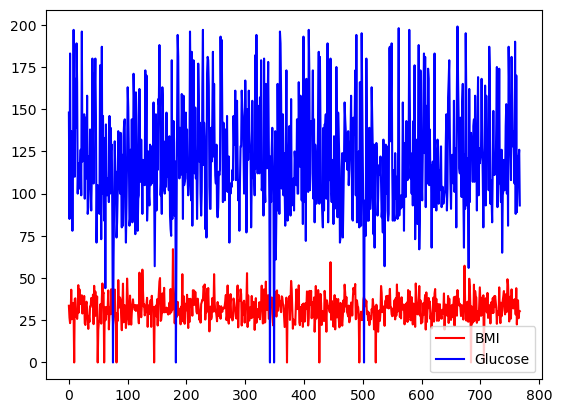
Gráfico de linha básico com cores personalizadas
Todas as colunas de df também podem ser plotadas em escalas e eixos diferentes usando o argumento subplots.
df.plot.line(subplots=True)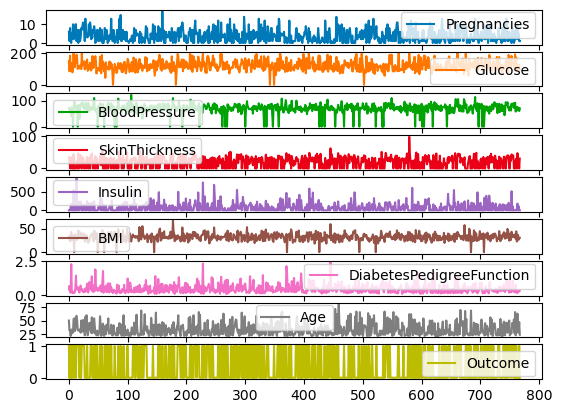
Subplots para gráficos de linha com pandas
Gráficos de barra no pandas
Para colunas discretas, use um gráfico de barras das contagens por categoria para visualizar a distribuição. A variável Outcome, binária, está abaixo.
df['Outcome'].value_counts().plot.bar()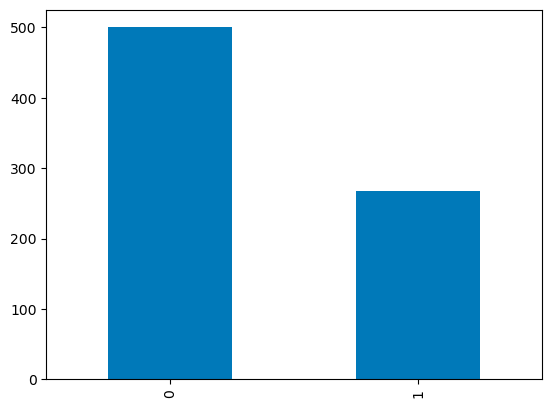
Gráficos de barras no pandas
Box plots no pandas
A distribuição por quartis de variáveis contínuas pode ser visualizada com boxplot. O código abaixo cria um boxplot com pandas.
df.boxplot(column=['BMI'], by='Outcome')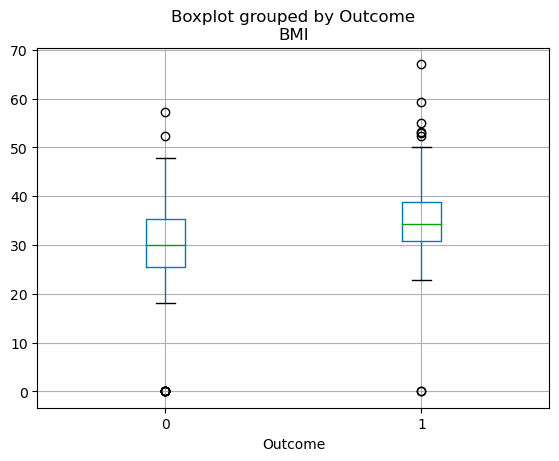
Boxplots no pandas
Considerações finais
Agora você tem o fluxo essencial do pandas: ler um arquivo em um DataFrame, inspecionar com .head(), .info() e .describe(), selecionar linhas com .loc[] e .iloc[], limpar ausências e duplicatas, fazer merge de tabelas e resumir com .groupby() e tabelas dinâmicas.
Se você aprendeu pandas antes de 2026, vale mudar um hábito: reatribuir resultados em vez de passar inplace=True e fazer toda atualização com uma única chamada .loc[]. A forma mais rápida de fixar o restante é repetir o fluxo em um conjunto de dados que você curta. Estes recursos ajudam você a ir além:
- [Cheat sheets] Uma coletânea de cheat sheets de Python e pandas para consultar durante a sua aprendizagem
- [Treinamentos ao vivo] Nossas sessões gratuitas de code-along, muitas usando pandas
- [Cursos] Data Manipulation with pandas e Joining Data with pandas para prática interativa
- [Preparação para entrevistas] Nossas principais perguntas de entrevista sobre pandas para testar seus conhecimentos
- [Mais tutoriais] Explore nossos outros tutoriais sobre pandas e o ecossistema PyData, incluindo como implementar médias móveis no pandas e usar o método .apply() do pandas
pandas: perguntas frequentes
O que é pandas em Python?
pandas é uma biblioteca open source de Python para trabalhar com dados tabulares. Suas duas estruturas centrais, o DataFrame (uma tabela) e a Series (uma única coluna), trazem funções para importar, limpar, remodelar, agregar e plotar dados — por isso é a ferramenta padrão para análise de dados em Python.
Por que devo aprender pandas?
Se você trabalha com dados em Python, aprender pandas é praticamente obrigatório. Ele simplifica o processo de tratar e analisar dados, para você focar em extrair insights e gerar valor. Seja com conjuntos pequenos ou em escala, o pandas facilita sua vida com velocidade, flexibilidade e estruturas fáceis de usar.
Como instalo o pandas?
Execute pip install pandas no seu terminal ou conda install pandas se você usa conda. O pandas 3 requer Python 3.11 ou superior. O Anaconda já inclui pandas por padrão, e o DataLab da DataCamp vem com ele pré-instalado.
Quais são as estruturas básicas de dados no pandas?
As duas estruturas básicas no pandas são a Series e o DataFrame. Uma Series é essencialmente uma coluna, e um DataFrame é uma tabela multidimensional composta por um conjunto de Series. Essas estruturas são flexíveis e podem conter dados de diferentes tipos (por exemplo, inteiro, string, float).
pandas é bom para conjuntos de dados grandes?
pandas lida bem com milhões de linhas, desde que os dados caibam na memória do seu computador. Para dados que não cabem, leia em lotes com o argumento chunksize ou migre para uma ferramenta feita para grandes volumes, como Polars, Dask ou PySpark.
Como importo dados no pandas?
pandas lê dados de vários formatos como CSV, Excel, bancos SQL, JSON e mais. Os comandos pd.read_csv(), pd.read_excel(), pd.read_sql() e pd.read_json() são usados para importar dos respectivos tipos. Todos retornam um DataFrame, que você pode manipular com pandas.
O que mudou no pandas 3.0?
O pandas 3.0, lançado em janeiro de 2026, tornou Copy-on-Write o padrão, então todo subconjunto se comporta como cópia e atribuições encadeadas como df["col"][0] = x não atualizam mais o DataFrame original. Ele também infere colunas de texto como um tipo dedicado str em vez de object e requer Python 3.11 ou superior. Em seguida, o pandas 3.1 descontinuou inplace=True em métodos como dropna() e sort_values().
Qual a diferença entre loc e iloc no pandas?
.loc[] seleciona linhas e colunas por rótulo, e .iloc[] seleciona por posição inteira, começando em 0. Os slices também diferem: .loc[100:110] inclui o rótulo final, enquanto .iloc[100:110] para antes da posição 110. Veja nosso guia de loc vs iloc para mais exemplos.
Como faço merge de dois DataFrames no pandas?
Use df1.merge(df2, on="key", how="left") para juntar dois DataFrames por uma coluna compartilhada, como em um join de SQL. O argumento how escolhe o tipo de junção ("left", "right", "inner" ou "outer"). Para empilhar DataFrames, use pd.concat().

Transformador de dados e estrategista de IA | Palestrante internacional | Ético em IA | Inventor | Mulher de sucesso global | Autor



pandas é o pacote padrão do Python para análise de dados, com mais de 500 milhões de downloads por mês no PyPI. Ele lê e escreve CSV, Excel, JSON, SQL e muitos outros formatos, e suas funções cobrem o trabalho do dia a dia de limpar, remodelar, agregar e visualizar dados tabulares.
Neste tutorial de pandas, vamos percorrer o fluxo completo usando um conjunto de dados real: instalar o pandas, importar e exportar dados, inspecionar um DataFrame, selecionar e filtrar linhas, limpar valores ausentes e duplicatas, combinar tabelas, agregar e plotar. Todos os exemplos rodam no pandas 3.1, a versão atual, e destacamos as mudanças do pandas 3 que quebram códigos de tutoriais antigos.
Você precisa de noções básicas de Python e nenhuma experiência prévia com pandas. Para um plano de estudos mais longo, veja nosso post sobre como aprender pandas e, para praticar de forma interativa, nosso curso Data Manipulation with pandas.
Resumo
pip install pandas; o pandas 3 requer Python 3.11 ou superior..loc[]seleciona por rótulo;.iloc[], por posição..loc[].df = df.dropna()) em vez de usar oinplace=True, que foi descontinuado.O que é o pandas?
pandas é um pacote de manipulação de dados em Python para dados tabulares — ou seja, dados em linhas e colunas, também conhecidos como DataFrames. Intuitivamente, você pode pensar em um DataFrame como uma planilha do Excel.
Os recursos do pandas incluem transformações, como ordenar linhas e criar subconjuntos, cálculo de estatísticas descritivas como média, remodelagem de DataFrames e junções entre DataFrames. O pandas funciona muito bem com outros pacotes populares do ecossistema de ciência de dados em Python (PyData), incluindo
Para que serve o pandas?
pandas é usado em todo o fluxo de análise de dados. Com pandas, você pode:
O pandas também traz funcionalidades para séries temporais e análise de texto.
Principais benefícios do pandas
pandas tem cinco vantagens práticas para o trabalho diário com dados:
Como instalar o pandas
Antes de usar o pandas, você precisa instalá-lo. Você pode pular essa etapa criando uma conta gratuita na DataCamp e usando o DataLab, um IDE na nuvem que já vem com o pandas (e os principais pacotes de data science em Python) pré-instalados.