course
Înțelegerea Inteligenței Artificiale
2 oră
421.1K
Învățarea prin consolidare tradițională nu prea funcționează când mediul devine prea mare ca să-l urmărești manual. Motivul este că fiecare stare are nevoie de propria intrare într-un tabel, iar fiecare acțiune din fiecare stare are nevoie de propria valoare.
De exemplu, ecranul unui joc produce milioane de combinații de pixeli, care pur și simplu nu încap într-un tabel prin care să poți itera. Agentul trebuie să ghicească valoarea unei stări pe care n-a mai văzut-o, pe baza unor stări care arată similar.
Învățarea prin consolidare profundă rezolvă asta înlocuind tabelul cu o rețea neuronală care estimează valoarea unei stări sau cea mai bună acțiune de făcut, chiar și pentru situații pe care nu le-a întâlnit direct. Asta le permite agenților să stăpânească Go și să piloteze drone simulate, ambele fiind sarcini care ar năuci orice algoritm RL clasic.
În acest articol, te ghidez prin conceptele de bază ale RL-ului profund, principalele familii de algoritmi precum DQN și PPO și locurile unde apar în lumea reală.
Dacă ești nou în învățarea prin consolidaret, înscrie-te la traseul nostru Reinforcement Learning in Python ca să-ți pui la punct fundamentele într-un weekend.
Învățarea prin consolidare profundă este învățare prin consolidare în care o rețea neuronală ține locul tabelului de căutare.
Învățarea prin consolidare îți oferă deja bucla de bază în care un agent încearcă o acțiune, observă ce se întâmplă și se ajustează pe baza recompensei. Învățarea profundă adaugă o rețea care poate transforma intrările brute în ceva pe care agentul îl poate folosi. Combinate, agentul învață ce acțiuni funcționează cel mai bine direct din date brute, fără ca cineva să scrie manual ce înseamnă fiecare stare.
Imaginează-ți că antrenezi un agent să joace un joc ca Breakout. Agentul nu primește o listă curată de „poziția mingii” sau „poziția paletei” - primește pixeli brute de pe ecran. O metodă tabulară ar avea nevoie de un rând separat pentru fiecare posibilă combinație de pixeli, iar acel număr este imposibil de gestionat. O rețea neuronală se uită direct la pixeli și produce ce acțiune să ia sau cât de bună pare fiecare acțiune, fără să fi văzut vreodată exact acel ecran înainte.
Pe scurt, metodele tabulare memorează, iar rețelele generalizează.
Asta face ca RL-ul profund să funcționeze în medii prea mari sau prea dezordonate pentru un tabel.
Fiecare sistem RL profund rulează aceeași buclă, indiferent ce algoritm stă la bază.
Iată cum decurge:
Diagrama de mai jos arată această buclă în mișcare:
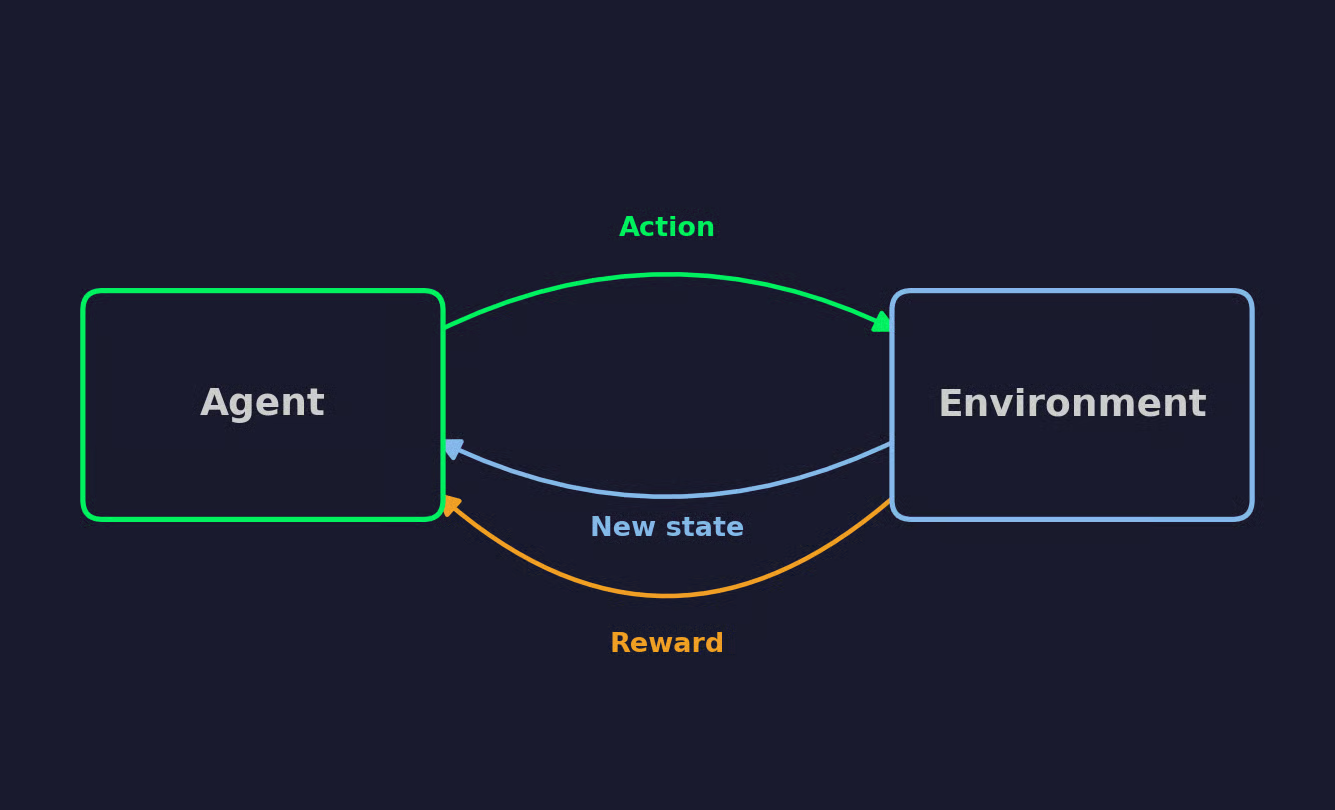
Buclă de învățare prin consolidare
Dacă repeți această buclă suficient de des, comportamentul agentului se va orienta către acele acțiuni care maximizează recompensa.
Fiecare algoritm RL profund se bazează pe aceleași șapte idei. Ar trebui să te familiarizezi cu ele, iar restul articolului va fi mult mai clar.
Imaginează-ți un aspirator robot care învață să curețe o cameră. Voi folosi acest exemplu pentru fiecare termen de mai jos.
Agentul este decidentul - aspiratorul robot, în exemplul nostru. Mediul este tot ceea ce interacționează cu el, cum ar fi camera, mobilierul, murdăria, pereții de care se poate lovi.
Agentul nu controlează mediul, dar alege acțiuni, iar mediul decide ce se întâmplă mai departe.
Starea descrie condiția completă a mediului la un moment dat, precum poziția exactă a fiecărei pete de murdărie și locația aspiratorului. Agenții reali rareori au acces la asta cu certitudine.
În schimb, acționează pe baza unei observații, adică ce poate vedea efectiv agentul, cum ar fi un flux de la cameră sau un set de senzori de proximitate.
În medii simple, observația și starea sunt practic același lucru. În cele mai complexe, agentul lucrează cu informații parțiale și trebuie să umple golurile.
Acțiunile sunt mișcările disponibile agentului la un moment dat. Pentru aspirator, asta ar putea însemna să înainteze, să vireze la stânga, să vireze la dreapta sau să pornească aspirația.
Acțiunile pot fi discrete, unde agentul alege dintr-o listă fixă, sau continue, unde agentul alege o valoare de-a lungul unui interval, precum un unghi de direcție. Această distincție contează mult când ajungi la diferitele familii de algoritmi mai târziu în articol.
O recompensă este feedback-ul numeric pe care agentul îl primește după ce face o acțiune. Dacă aspiratorul curăță o zonă nouă de podea, ar putea primi o recompensă de +1. Dar când se izbește de un perete, ar putea primi -1.
Întregul scop al agentului este să maximizeze recompensa totală acumulată în timp, nu doar recompensa de la următoarea acțiune.
O politică este strategia agentului de a mapa stările, sau observațiile, la acțiuni. Este manualul de reguli pe care îl urmează agentul ca să decidă ce face în continuare.
O politică poate fi deterministă, alegând mereu aceeași acțiune pentru o stare dată, sau stocastică, alegând acțiuni pe baza unei distribuții de probabilitate. Algoritmii RL profund folosesc adesea o rețea neuronală pentru a reprezenta această politică.
O funcție de valoare estimează câtă recompensă viitoare se poate aștepta agentul să acumuleze dintr-o stare dată, dacă continuă să urmeze politica curentă.
O funcție Q-valoare face același lucru pentru o pereche stare-acțiune. Ea estimează recompensa viitoare de la a lua o acțiune specifică într-o stare specifică, apoi a urma politica ulterior.
Acesta este tipul de funcție pe care o rețea neuronală îl aproximează bine. Este aceeași idee descrisă când am înlocuit tabelul de căutare mai devreme în articol.
Un episod este o rulare completă a agentului prin mediu, de la starea inițială până la o condiție de final. Pentru aspirator, asta ar putea însemna că încăperea e complet curată sau bateria se descarcă.
După ce un episod se termină, mediul se resetează și începe unul nou.
Un agent care repetă doar ce a funcționat deja nu va găsi niciodată ceva mai bun.
Imaginează-ți din nou aspiratorul. Dă peste un traseu care curăță o parte bună din cameră și îl repetă de fiecare dată. Nu verifică niciodată colțul din spatele canapelei. Asta este dilema din centrul învățării prin consolidare:
O modalitate comună de a le echilibra este explorarea epsilon-greedy. La fiecare pas, agentul alege o acțiune aleatorie cu probabilitatea epsilon, un număr mic precum 0,1, și altfel alege orice acțiune crede el că e cea mai bună. Multe algoritmi decaiesc epsilon în timp, caz în care agentul explorează intens la început, apoi se bazează mai mult pe exploatare când a învățat suficient cât să-și aibă încredere în propriile judecăți.
Nu există un epsilon fix care să funcționeze pentru orice mediu.
Prea multă explorare irosește timp pe acțiuni care eșuează constant. Prea puțină explorare înseamnă că agentul se mulțumește cu o strategie decentă în timp ce una mai bună e chiar lângă el, nedescoperită. Găsirea echilibrului devine și mai grea pe măsură ce mediul se complică, mai ales când o acțiune proastă de la început nu își arată adevăratul cost decât multe pasuri mai târziu.
Fiecare algoritm RL profund intră într-una din trei familii, în funcție de ceea ce învață efectiv: o funcție de valoare, o politică sau ambele deodată.
DQN ia funcția Q-valoare menționată mai devreme și înlocuiește tabelul de căutare cu o rețea neuronală. Rețeaua primește o stare ca intrare și produce o Q-valoare pentru fiecare acțiune posibilă, învățând la fel cum învață orice rețea neuronală standard.
Antrenarea directă a acelei rețele nu este recomandată. Experiențele consecutive sunt corelate, caz în care rețeaua supraînvață pe ceea ce tocmai a văzut, iar ținta pe care o urmărește se schimbă de fiecare dată când rețeaua se actualizează.
DQN rezolvă ambele probleme:
DQN a fost important deoarece a fost primul algoritm care a învățat politici de control direct din pixeli brut pe o gamă largă de jocuri Atari, folosind aceeași arhitectură și aceiași hiperparametri pentru fiecare. Când DeepMind l-a publicat în 2015, a demonstrat că învățarea profundă și învățarea prin consolidare pot funcționa împreună la scară, fără caracteristici construite manual pentru fiecare joc.
În loc să învețe o funcție de valoare și să aleagă acțiuni pe baza ei, metodele cu gradient de politică învață politica. Rețeaua primește o stare și produce probabilități pentru acțiuni, iar agentul eșantionează o acțiune din acea distribuție.
Această abordare se potrivește acțiunilor continue sau stocastice.
O metodă bazată pe valoare trebuie să verifice fiecare acțiune posibilă pentru a o găsi pe cea mai bună, ceea ce se strică în momentul în care spațiul acțiunilor devine continuu - nu poți itera printr-un interval infinit de unghiuri de direcție. O metodă cu gradient de politică pur și simplu eșantionează din distribuție, indiferent câte acțiuni există.
REINFORCE este algoritmul de bază aici. Rulează un episod complet, apoi mărește probabilitatea acțiunilor care au dus la o recompensă totală mare și o scade pentru acțiunile care au dus la o recompensă totală mică. Problema e că actualizează doar după ce episodul se încheie și se bazează pe returul complet, ceea ce face ca actualizările sale să fie zgomotoase și inconsistente de la un episod la altul.
Metodele actor-critic rezolvă problema de zgomot a lui REINFORCE adăugând o a doua rețea.
Actorul este politica - alege acțiuni la fel ca o metodă cu gradient de politică. Criticul este o funcție de valoare care judecă fiecare acțiune imediat după ce se întâmplă, în loc să aștepte finalul episodului.
Aceasta este colaborarea dintre abordările bazate pe valoare și cele bazate pe politică. Actorul tot învață o politică, dar se actualizează pe baza judecății criticului pentru fiecare acțiune, nu pe returul întârziat și zgomotos de care depinde REINFORCE.
A2C și A3C sunt exemplele standard. A2C rulează câteva copii ale mediului în paralel și actualizează actorul și criticul împreună după ce se termină fiecare lot. A3C rulează acele copii asincron, caz în care fiecare își actualizează rețeaua partajată pe propriul program în loc să le aștepte pe celelalte.
Actualizările cu gradient de politică pot da greș dacă le lași prea mari. O actualizare suficient de mare poate strica o politică ce funcționa bine, și nu există o modalitate de a o anula odată ce s-a întâmplat.
PPO limitează dimensiunea fiecărei actualizări pentru a evita asta. Iată obiectivul decupat pe care îl optimizează:
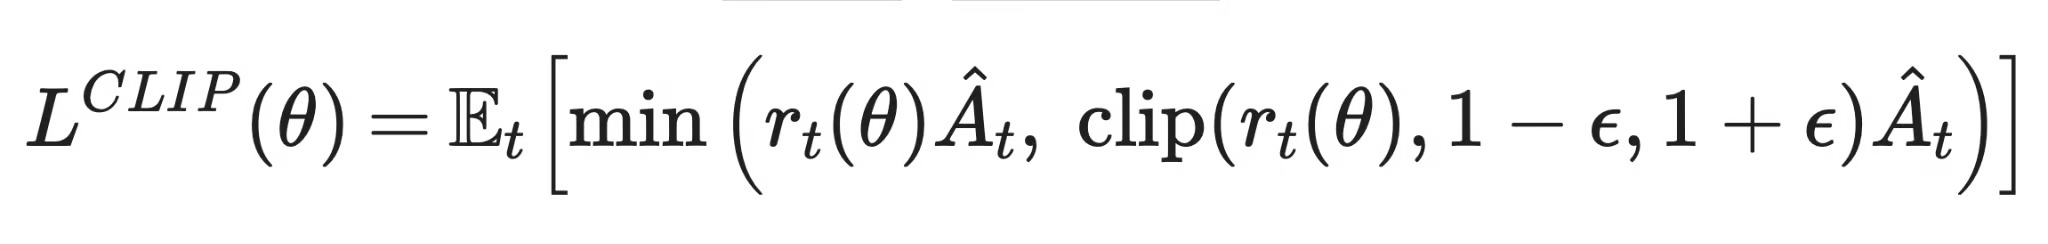
Optimizare de politică proximală
r_t(θ) este raportul dintre probabilitatea unei acțiuni sub noua politică și probabilitatea aceleiași acțiuni sub vechea politică. Â_t este avantajul, adică cât de mult s-a dovedit acea acțiune mai bună față de așteptarea de bază a criticului. Funcția clip() ține raportul într-o bandă îngustă în jurul lui 1, astfel încât politica să nu se poată deplasa prea mult într-un singur pas. Apoi min() alege estimarea mai conservatoare dintre cele două, astfel încât o estimare neobișnuit de mare a avantajului să nu poată împinge actualizarea mai departe decât permite decuparea.
OpenAI a introdus PPO în 2017, și a devenit aproape instant alegerea implicită. Este mai ușor de implementat și reglat decât metodele cu regiuni de încredere care l-au precedat și rezistă bine într-un set larg de medii fără prea multe ajustări per sarcină.
DDPG și Soft Actor-Critic (SAC) vizează ambele probleme de control continuu, precum unghiurile articulațiilor robotice sau valorile de direcție, în care agentul trebuie să emită un număr specific în loc să aleagă dintr-o distribuție.
DDPG este o metodă actor-critic al cărei actor produce o acțiune deterministă unică în loc de o distribuție și împrumută rejucarea experienței și rețelele țintă de la DQN.
SAC se bazează pe aceeași idee, dar adaugă un termen de entropie care răsplătește politica pentru a rămâne oarecum aleatoare, ceea ce menține agentul în explorare mai mult și tinde să facă antrenarea mai stabilă decât la DDPG.
Metodele bazate pe valoare, precum DQN, învață o funcție Q-valoare și aleg orice acțiune pe care acea funcție o evaluează cel mai sus. Asta merge bine pentru spații de acțiuni discrete și obține o eficiență bună a eșantioanelor datorită rejucării, dar nu se extinde la acțiuni continue fără muncă suplimentară.
Metodele bazate pe politică precum REINFORCE învață direct politica, eșantionând acțiuni dintr-o distribuție de probabilitate. Asta le face să funcționeze cu acțiuni continue și stocastice, dar actualizările simple cu gradient de politică sunt zgomotoase și au nevoie de date proaspete pentru fiecare actualizare.
Metodele actor-critic, inclusiv A2C/A3C, PPO, DDPG și SAC, combină ambele idei. Feedback-ul rapid al criticului stabilizează actualizările actorului, motiv pentru care majoritatea algoritmilor folosiți în practică azi intră în această categorie.
Iată o comparație mai vizuală:
| Ce se învață | Cum sunt selectate acțiunile | Discret vs. continuu | Stabilitate | Eficiența eșantioanelor | Algoritmi reprezentativi | |
|---|---|---|---|---|---|---|
| Bazate pe valoare | Funcție Q-valoare | Acțiunea cu cel mai mare scor | Discrete | Necesită rețele țintă și rejucare pentru a rămâne stabile | Bună, datorită rejucării experienței | DQN |
| Bazate pe politică | Politică | Eșantionată din distribuția politicii | Ambele, cel mai bine cu continue | Actualizări zgomotoase, cu varianță mare | Slabă, are nevoie de date noi pentru fiecare actualizare | REINFORCE |
| Actor-critic | Politică și funcție de valoare | Eșantionate de la actor, ghidate de critic | Ambele | Mai stabile decât metodele pur bazate pe politică | Mai bună decât metodele pur bazate pe politică | A2C/A3C, PPO, DDPG, SAC |
Metode de învățare prin consolidare profundă comparate
Învățarea supravegheată primește un răspuns etichetat pentru fiecare exemplu. RL-ul profund trebuie să își dea seama ce a funcționat dintr-un semnal de recompensă care apare târziu, se amestecă cu acțiunile de dinainte și uneori nici nu apare într-un mod util.
Agenții RL profunzi au adesea nevoie de milioane de pași în mediu înainte să învețe ceva util, mai ales comparativ cu cât de puține date îi trebuie unui model supravegheat pentru a atinge o acuratețe similară pe un set fix de date.
Motivul este că agentul trebuie să-și genereze propriile date de antrenare prin acțiune, iar majoritatea acțiunilor la început sunt aproape aleatorii. Un model supravegheat poate refolosi același set etichetat la nesfârșit. Un agent RL trebuie să continue să exploreze un mediu pe care abia îl înțelege, pas cu pas.
Antrenarea RL este adesea instabilă.
O parte din problemă e că funcțiile de valoare se „auto-susțin”, caz în care ținta Q-valoare de azi depinde de estimarea Q-valoare de ieri. Dacă acea estimare e greșită, eroarea se compune în loc să se corecteze. Pe deasupra, politica agentului se schimbă pe măsură ce învață, astfel încât datele pe care le colectează se schimbă și ele.
Cu alte cuvinte, rețeaua urmărește o țintă în mișcare pe două fronturi simultan.
Unele medii oferă o recompensă doar la final, precum un semnal de victorie sau eșec după un joc lung. Agentul trebuie să deducă înapoi din acel singur număr și să-și dea seama care dintre zecile de acțiuni întreprinse au contat de fapt.
Aceasta se numește problema atribuirii meritului (credit assignment) și se agravează cu cât întârzierea dintre o acțiune și consecința ei e mai mare.
Proiectarea recompensei pare ușoară până când încerci.
Iată un exemplu celebru. Un agent de curse cu bărci antrenat de OpenAI era recompensat pentru atingerea punctelor de control, așa că a găsit o lagună cu power-up-uri care reapăreau și a făcut bucla prin ea la nesfârșit, adunând scor fără să termine cursa. Funcția de recompensă a făcut exact ce i s-a cerut - agentului doar nu i s-a spus ce înseamnă de fapt „a câștiga”. Această diferență dintre ce răsplătești și ce vrei de fapt se numește hacking al recompensei și apare, într-o formă sau alta, în aproape fiecare funcție de recompensă pe care o scrii.
Același algoritm, rulat cu o altă sămânță aleatoare, poate produce rezultate diferite.
Rezultatele publicate sunt greu de reprodus fără exact același cod, aceiași hiperparametri și aceleași semințe pe care le-au folosit cercetătorii originali. Detalii mici de implementare, precum cum se normalizează observațiile sau cum se initializează bufferul de rejucare, pot influența performanța mai mult decât o face alegerea algoritmului.
Un simulator îi permite unui agent să eșueze iar și iar, de câte ori e nevoie. Lumea reală nu funcționează așa.
De exemplu, o politică de conducere autonomă care explorează o acțiune proastă pe autostradă pune oamenii în pericol. Simulatoarele nu surprind niciodată lumea reală perfect, iar cazurile-limită pe care simulatorul nu le-a modelat apar exact când politica părăsește laboratorul. O politică ce arată excelent în simulare poate eșua în moduri pe care nimeni nu le-a prezis odată ce întâlnește un mediu real, motiv pentru care implementarea RL profund în afara jocurilor și simulatoarelor cere mult mai multă prudență decât sugerează cifrele de benchmark.
În continuare, evidențiez diferențele dintre învățarea prin consolidare profundă și abordările mai tradiționale.
Învățarea supravegheată se antrenează pe exemple etichetate, în care fiecare intrare are deja un răspuns corect. RL-ul profund nu primește asta niciodată - primește o recompensă doar după ce acționează și trebuie să-și dea seama singur ce acțiuni au dus la acea recompensă.
Învățarea prin imitație antrenează o politică să copieze demonstrațiile unui expert, fără să folosească vreodată un semnal de recompensă. RL-ul profund descoperă comportamentul prin încercare și eroare.
Învățarea prin imitație pornește rapid o politică, dar este limitată de cât de bune sunt demonstrațiile și se împotmolește în momentul în care agentul ajunge într-o situație pe care expertul nu i-a arătat-o. RL-ul profund poate, teoretic, să depășească performanța oricărui profesor, dar are nevoie de mult mai multă interacțiune și de o funcție de recompensă care să indice cu adevărat comportamentul dorit.
Algoritmii evolutivi optimizează o politică prin mutarea unei populații de candidați și păstrarea celor care performează cel mai bine, fără a calcula deloc gradientul. RL-ul profund calculează gradienți din semnalul de recompensă și actualizează o singură politică.
Metodele evolutive se paralelizează bine, deoarece fiecare candidat din populație poate rula independent. Dar, de obicei, au nevoie de mult mai multe interacțiuni totale cu mediul decât RL-ul profund bazat pe gradient pentru a atinge același nivel de performanță.
RL-ul profund pedepsește scurtăturile mai mult decât alte domenii. Ținând cont de asta, iată câteva bune practici pentru următorul tău proiect:
Învățarea prin consolidare profundă ia bucla de încercare-și-eroare din miezul RL și o combină cu o rețea neuronală care poate gestiona stări pe care niciun tabel nu le-ar putea cuprinde.
Fiecare algoritm din acest articol intră într-una din trei familii. Metodele bazate pe valoare, precum DQN, învață o funcție Q-valoare și aleg acțiunea cu cel mai mare scor. Metodele bazate pe politică, precum REINFORCE, învață direct o politică. Metodele actor-critic, inclusiv PPO, le combină pe ambele, iar această combinație este ceea ce folosesc majoritatea algoritmilor astăzi.
Doar ține minte că nimic din toate astea nu e gratuit.
Stabilitatea antrenării, eficiența eșantioanelor, proiectarea recompensei și reproductibilitatea devin toate mai dificile în momentul în care treci de la un tabel la o rețea. Dacă vrei să aprofundezi, Q-learning și învățarea prin consolidare acoperă fundamentele pe care se bazează acest articol, iar DQN și PPO sunt pași buni următori pentru algoritmii în sine.
Învață cu DataCamp
course
course
track