course
Wprowadzenie do sztucznej inteligencji
2 godz.
421.1K
Tradycyjne uczenie ze wzmocnieniem przestaje działać, gdy środowisko robi się zbyt duże, by śledzić je ręcznie. Powód jest prosty: każdy stan potrzebuje własnego wpisu w tabeli, a każda akcja z każdego stanu — własnej wartości.
Na przykład ekran gry generuje miliony kombinacji pikseli, których nie da się upchnąć w tabeli, przez którą można by przejść pętlą. Agent musi oszacować wartość stanu, którego nigdy nie widział, na podstawie stanów, które wyglądają podobnie.
Głębokie uczenie ze wzmocnieniem rozwiązuje ten problem, zamieniając tabelę na sieć neuronową, która szacuje wartość stanu lub najlepszą akcję do podjęcia — nawet w sytuacjach, z którymi nigdy bezpośrednio się nie zetknęła. Dzięki temu agenci potrafią opanować Go czy sterować symulowanymi dronami — zadania, które rozsadziłyby każdy klasyczny algorytm RL.
W tym artykule przeprowadzę cię przez kluczowe pojęcia deep RL, główne rodziny algorytmów, takie jak DQN i PPO, oraz pokażę, gdzie spotkasz je w praktyce.
Jeśli dopiero zaczynasz przygodę z uczeniem ze wzmocnieniemt learning, zapisz się na naszą ścieżkę Reinforcement Learning in Python, by ogarnąć podstawy w jeden weekend.
Głębokie uczenie ze wzmocnieniem to uczenie ze wzmocnieniem, w którym sieć neuronowa zastępuje tabelę wyszukiwania.
Uczenie ze wzmocnieniem daje ci pętlę, w której agent próbuje akcji, obserwuje, co się dzieje, i dostosowuje się na podstawie nagrody. Deep learning dodaje sieć, która potrafi zamienić surowe dane wejściowe w coś, na czym agent może działać. Razem pozwala to agentowi uczyć się, które akcje działają najlepiej, wprost z surowych danych — bez ręcznego kodowania znaczenia każdego stanu.
Wyobraź sobie, że trenujesz agenta do gry w Breakout. Agent nie dostaje czystej listy „pozycja piłki” czy „pozycja paletki” — dostaje surowe piksele z ekranu. Metoda tabelaryczna potrzebowałaby osobnego wiersza dla każdej możliwej kombinacji pikseli, a ta liczba jest nie do ogarnięcia. Sieć neuronowa patrzy bezpośrednio na piksele i zwraca, jaką akcję podjąć lub jak dobra jest każda akcja — mimo że nigdy wcześniej nie widziała dokładnie tego ekranu.
Krótko mówiąc: metody tabelaryczne zapamiętują, a sieci uogólniają.
To właśnie sprawia, że deep RL działa w środowiskach zbyt dużych lub zbyt chaotycznych, by poradziła sobie z nimi tabela.
Każdy system deep RL wykonuje tę samą pętlę, niezależnie od użytego algorytmu.
Wygląda to tak:
Poniższy diagram pokazuje tę pętlę w działaniu:
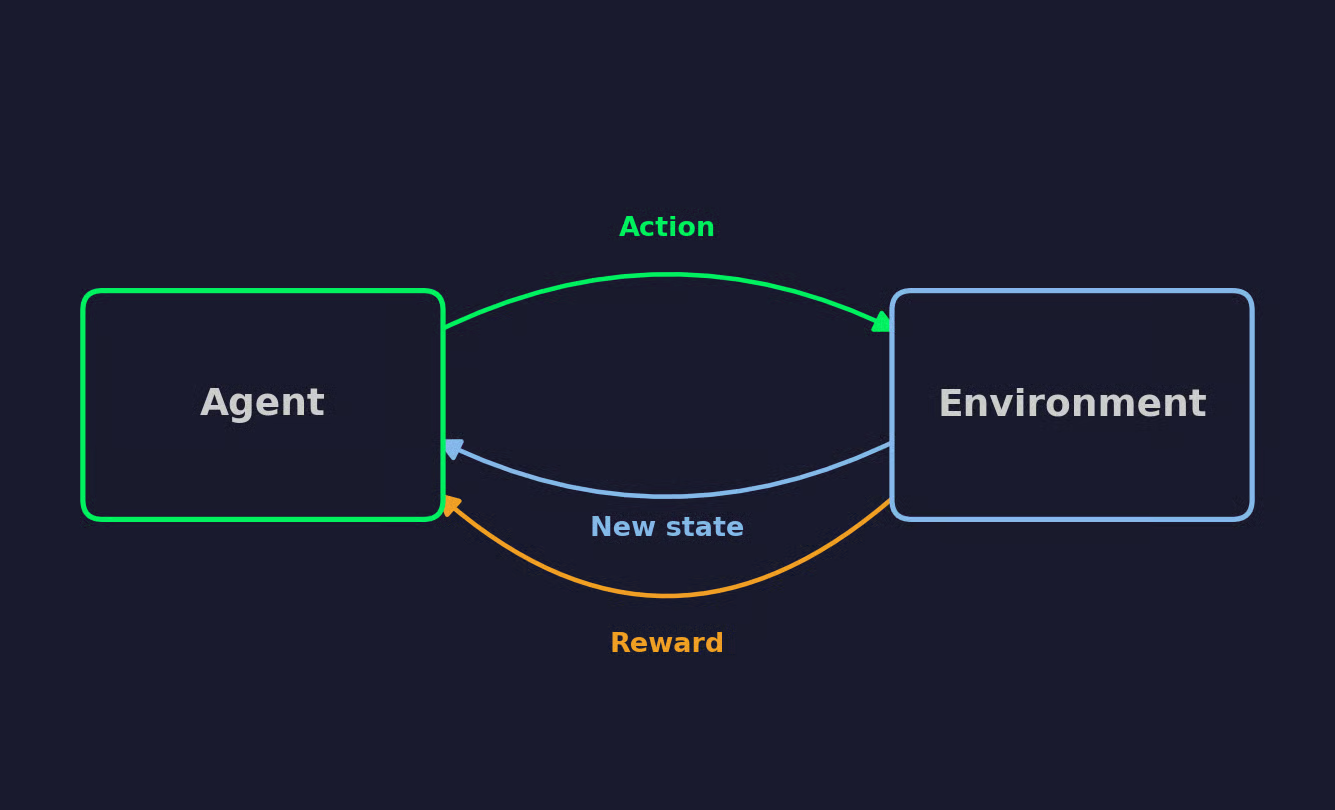
Pętla uczenia ze wzmocnieniem
Jeśli powtórzysz tę pętlę wystarczająco wiele razy, zachowanie agenta przesunie się w stronę takich akcji, które maksymalizują nagrodę.
Każdy algorytm deep RL bazuje na tych samych siedmiu ideach. Warto je oswoić, a reszta artykułu stanie się dużo bardziej zrozumiała.
Wyobraź sobie robota-odkurzacza uczącego się sprzątania pokoju. Tego przykładu użyję w każdym z poniższych terminów.
Agent to decydent — w naszym przykładzie robot-odkurzacz. Środowisko to wszystko, z czym wchodzi w interakcję, np. pokój, meble, kurz, ściany, w które może uderzyć.
Agent nie kontroluje środowiska, ale wybiera akcje, a środowisko decyduje, co stanie się dalej.
Stan opisuje pełny warunek środowiska w danym momencie, np. dokładne położenie każdej plamki kurzu i lokalizację odkurzacza. Prawdziwi agenci rzadko mają do tego pewny dostęp.
Zamiast tego działają na podstawie obserwacji — tego, co agent faktycznie widzi, np. obrazu z kamery czy zestawu czujników zbliżeniowych.
W prostych środowiskach obserwacja i stan to w zasadzie to samo. W bardziej złożonych agent działa na niepełnych informacjach i musi wypełniać luki.
Akcje to ruchy dostępne agentowi w danej chwili. Dla odkurzacza może to być jazda do przodu, skręt w lewo, skręt w prawo lub włączenie ssania.
Akcje mogą być dyskretne — agent wybiera z ustalonej listy — albo ciągłe — agent wybiera wartość z zakresu, np. kąt skrętu. To rozróżnienie ma duże znaczenie przy omawianych później rodzinach algorytmów.
Nagroda to numeryczna informacja zwrotna, którą agent dostaje po wykonaniu akcji. Jeśli odkurzacz oczyści nową część podłogi, może dostać nagrodę +1. Gdy wpadnie na ścianę — może dostać -1.
Celem agenta jest maksymalizacja łącznej nagrody w czasie, a nie tylko najbliższej pojedynczej nagrody.
Polityka to strategia agenta mapująca stany lub obserwacje na akcje. To zestaw reguł, według których agent decyduje, co zrobić dalej.
Polityka może być deterministyczna — zawsze wybiera tę samą akcję w danym stanie — lub stochastyczna — wybiera akcje na podstawie rozkładu prawdopodobieństwa. Algorytmy deep RL często reprezentują politykę za pomocą sieci neuronowej.
Funkcja wartości szacuje, jaką przyszłą nagrodę agent może zebrać, startując z danego stanu i podążając dalej obecną polityką.
Funkcja Q-wartości robi to samo dla pary stan–akcja. Szacuje przyszłą nagrodę po podjęciu konkretnej akcji w konkretnym stanie, a następnie podążaniu polityką.
Tego typu funkcje sieć neuronowa dobrze aproksymuje. To ten sam pomysł, o którym była mowa przy zamianie tabeli na sieć na początku artykułu.
Epizod to pełne przejście agenta przez środowisko — od stanu początkowego do warunku zakończenia. Dla odkurzacza może to oznaczać, że pokój jest w pełni czysty albo że wyczerpała się bateria.
Gdy epizod się kończy, środowisko się resetuje i zaczyna się nowy.
Agent, który powtarza tylko to, co już zadziałało, nigdy nie znajdzie czegoś lepszego.
Wyobraź sobie znowu odkurzacz. Trafia na trasę, która czyści sporą część pokoju, i odtąd jeździ nią w kółko. Nigdy nie sprawdza zakamarka za kanapą. To właśnie sedno kompromisu w RL:
Popularnym sposobem równoważenia obu podejść jest eksploracja epsilon-zachłanna. Na każdym kroku agent wybiera losową akcję z prawdopodobieństwem epsilon (mała liczba, np. 0,1), a w przeciwnym razie wybiera akcję, którą obecnie uważa za najlepszą. Wiele algorytmów zmniejsza epsilon w czasie — agent intensywnie eksploruje na początku, a potem coraz bardziej polega na eksploatacji, gdy już może ufać własnym ocenom.
Nie ma jednej wartości epsilon dobrej dla każdego środowiska.
Zbyt wiele eksploracji marnuje czas na akcje, które ciągle zawodzą. Zbyt mało — sprawia, że agent zadowala się niezłą strategią, podczas gdy tuż obok leży lepsza, nieodkryta. Wyważenie tego kompromisu tylko trudnieje wraz ze wzrostem złożoności środowiska, zwłaszcza gdy zła wczesna akcja ujawnia koszt dopiero wiele kroków później.
Każdy algorytm deep RL wpada do jednej z trzech rodzin — w zależności od tego, czego się uczy: funkcji wartości, polityki lub obu naraz.
DQN bierze funkcję Q-wartości opisaną wcześniej i zamienia tabelę na sieć neuronową. Sieć przyjmuje stan jako wejście i zwraca Q-wartość dla każdej możliwej akcji, ucząc się tak jak standardowa sieć neuronowa.
Trenowanie tej sieci wprost nie jest zalecane. Kolejne doświadczenia są skorelowane, przez co sieć nadmiernie dopasowuje się do tego, co właśnie widziała, a cel, do którego dąży, zmienia się przy każdej aktualizacji sieci.
DQN rozwiązuje oba problemy:
DQN było przełomowe, bo pierwszy raz nauczyło polityk sterowania bezpośrednio z surowych pikseli w szerokim zestawie gier Atari, używając tej samej architektury i hiperparametrów dla każdej. Gdy DeepMind opublikował je w 2015 r., dowiodło, że deep learning i uczenie ze wzmocnieniem mogą realnie współdziałać na dużą skalę bez ręcznie projektowanych cech dla każdej gry.
Zamiast uczyć się funkcji wartości i wybierać na jej podstawie akcje, metody gradientu polityki uczą się samej polityki. Sieć przyjmuje stan i zwraca rozkład prawdopodobieństwa akcji, a agent próbuje akcji wylosowanej z tego rozkładu.
To podejście pasuje do akcji ciągłych lub stochastycznych.
Metoda oparta na wartości musi sprawdzić każdą możliwą akcję, by znaleźć najlepszą, co się sypie, gdy przestrzeń akcji jest ciągła — nie da się przejść pętlą po nieskończonym zakresie kątów skrętu. Metoda gradientu polityki po prostu próbuje próbkę z rozkładu, niezależnie od tego, ile akcji istnieje.
REINFORCE to algorytm podstawowy. Uruchamia pełny epizod, a następnie zwiększa prawdopodobieństwo akcji, które dały wysoką łączną nagrodę, i zmniejsza dla tych, które dały niską. Haczyk polega na tym, że aktualizacje następują dopiero po zakończeniu epizodu i opierają się na pełnym zwrocie, co czyni je głośnymi i niespójnymi między epizodami.
Metody aktor–krytyk rozwiązują problem hałaśliwości REINFORCE, dodając drugą sieć.
Aktor to polityka — wybiera akcje tak jak metoda gradientu polityki. Krytyk to funkcja wartości, która ocenia każdą akcję zaraz po jej wykonaniu, zamiast czekać do końca epizodu.
To połączenie podejść opartych na wartości i na polityce. Aktor nadal uczy się polityki, ale aktualizuje się na podstawie oceny krytyka dla każdej akcji, a nie opóźnionego, hałaśliwego zwrotu, na którym polega REINFORCE.
Standardowe przykłady to A2C i A3C. A2C uruchamia kilka kopii środowiska równolegle i aktualizuje aktora i krytyka wspólnie po każdej partii. A3C uruchamia kopie asynchronicznie — każda z nich aktualizuje współdzieloną sieć we własnym rytmie, nie czekając na pozostałe.
Aktualizacje gradientu polityki mogą wymknąć się spod kontroli, jeśli pozwolisz im być zbyt dużymi. Wystarczająco duża aktualizacja może zrujnować dobrze działającą politykę — i nie ma jak cofnąć takiej zmiany.
PPO ogranicza rozmiar każdej aktualizacji, by temu zapobiec. Oto klipowany cel, który optymalizuje:
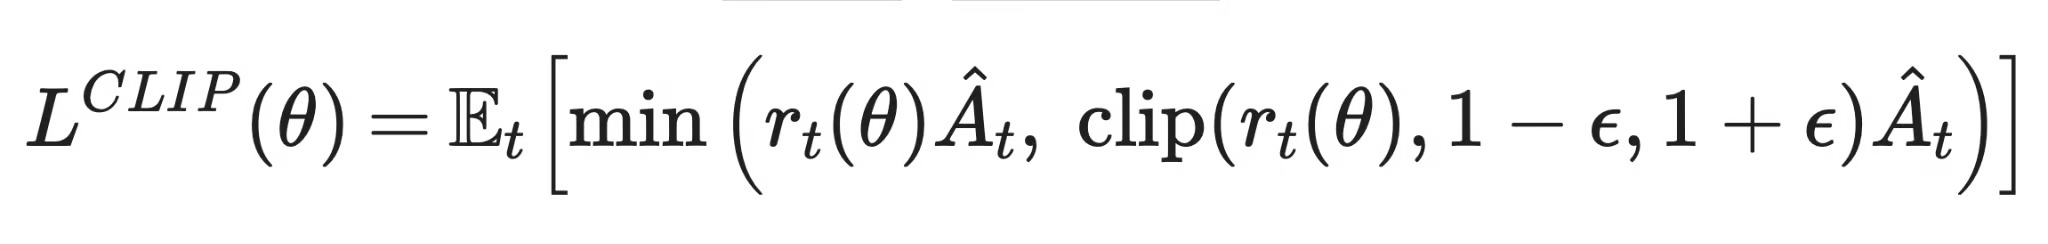
Proximal policy optimization
r_t(θ) to stosunek prawdopodobieństwa danej akcji w nowej polityce do prawdopodobieństwa tej samej akcji w starej polityce. Â_t to przewaga (advantage), czyli o ile ta akcja okazała się lepsza względem bazowej oceny krytyka. Funkcja clip() utrzymuje stosunek w wąskim paśmie wokół 1, więc polityka nie może zbyt daleko przesunąć się w jednym kroku. Następnie min() wybiera bardziej zachowawczą z dwóch estymat, dzięki czemu wyjątkowo duża estymata przewagi nie przepchnie aktualizacji dalej, niż pozwala klip.
OpenAI wprowadziło PPO w 2017 r. i niemal od razu stało się domyślnym wyborem. Jest prostsze we wdrożeniu i strojeniu niż wcześniejsze metody z regionem zaufania, a do tego sprawdza się w wielu środowiskach bez dużego dostrajania pod zadanie.
DDPG i Soft Actor-Critic (SAC) celują w problemy sterowania ciągłego, jak kąty przegubów robotów czy wartości skrętu, gdzie agent musi zwrócić konkretną liczbę zamiast wybierać z rozkładu.
DDPG to metoda aktor–krytyk, w której aktor zwraca pojedynczą deterministyczną akcję zamiast rozkładu, a do tego zapożycza powtórkę doświadczeń i sieci docelowe z DQN.
SAC rozwija ten sam pomysł, ale dodaje składnik entropii, który nagradza politykę za utrzymanie pewnej losowości — to podtrzymuje eksplorację i zwykle czyni trening stabilniejszym niż w DDPG.
Metody oparte na wartości, jak DQN, uczą się funkcji Q-wartości i wybierają akcję z najwyższą oceną. Dobrze działają w dyskretnych przestrzeniach akcji i efektywnie wykorzystują próbki dzięki powtórce doświadczeń, ale bez dodatkowych zabiegów nie przenoszą się na akcje ciągłe.
Metody oparte na polityce, jak REINFORCE, uczą się bezpośrednio polityki, próbkując akcje z rozkładu. Dzięki temu działają z akcjami ciągłymi i stochastycznymi, ale surowe aktualizacje gradientu polityki są hałaśliwe i wymagają świeżych danych do każdej aktualizacji.
Metody aktor–krytyk, w tym A2C/A3C, PPO, DDPG i SAC, łączą oba podejścia. Szybka informacja zwrotna krytyka stabilizuje aktualizacje aktora — dlatego większość praktycznie używanych algorytmów należy do tej kategorii.
Oto bardziej wizualne porównanie:
| Co jest uczone | Jak wybierane są akcje | Dyskretne vs. ciągłe | Stabilność | Wydajność próbkowania | Przykładowe algorytmy | |
|---|---|---|---|---|---|---|
| Oparte na wartości | Funkcja Q-wartości | Akcja z najwyższą oceną | Dyskretne | Wymaga sieci docelowych i powtórki dla stabilności | Dobra, dzięki powtórce doświadczeń | DQN |
| Oparte na polityce | Polityka | Próbkowane z rozkładu polityki | Obie, najlepiej z ciągłymi | Hałaśliwe, aktualizacje o dużej wariancji | Słaba, potrzebne nowe dane do każdej aktualizacji | REINFORCE |
| Aktor–krytyk | Polityka i funkcja wartości | Próbkowane z aktora, kierowane przez krytyka | Obie | Stabilniejsze niż czyste metody oparte na polityce | Lepsza niż w czystych metodach opartych na polityce | A2C/A3C, PPO, DDPG, SAC |
Porównanie metod głębokiego uczenia ze wzmocnieniem
Uczenie nadzorowane dostaje etykietę dla każdego przykładu. Deep RL musi wywnioskować, co zadziałało, z sygnału nagrody, który pojawia się z opóźnieniem, miesza się z wcześniejszymi akcjami i czasem w ogóle nie pojawia się w użyteczny sposób.
Agenci deep RL często potrzebują milionów kroków środowiska, zanim nauczą się czegoś użytecznego — zwłaszcza w porównaniu z małą ilością danych, jakiej potrzebuje model nadzorowany, by osiągnąć podobną dokładność na stałym zbiorze danych.
Powód jest taki, że agent sam generuje dane treningowe poprzez działanie, a większość wczesnych akcji jest niemal losowa. Model nadzorowany może wielokrotnie używać tego samego oznaczonego zbioru. Agent RL musi wciąż eksplorować środowisko, którego ledwie rozumie — krok po kroku.
Trening RL bywa niestabilny.
Częściowo dlatego, że funkcje wartości „podbierają” (bootstrapują) z własnych estymat — dzisiejszy cel Q-wartości zależy od wczorajszej zgadywanki Q-wartości. Jeśli ta zgadywanka jest chybiona, błąd się kumuluje zamiast korygować. Do tego polityka agenta w trakcie nauki wciąż się zmienia, więc zmieniają się też zbierane dane.
Innymi słowy, sieć goni ruchomy cel na dwóch frontach jednocześnie.
Niektóre środowiska przyznają nagrodę dopiero na samym końcu, jak sygnał wygranej lub przegranej po długiej grze. Agent musi wywnioskować wstecz z tej jednej liczby, które z dziesiątek wykonanych akcji naprawdę miały znaczenie.
To tzw. problem przypisania zasług (credit assignment) — i nasila się wraz z długością opóźnienia między akcją a jej konsekwencją.
Projektowanie nagród brzmi łatwo — dopóki nie spróbujesz.
Oto słynny przykład. Treningowy agent wyścigowy OpenAI dostawał nagrodę za zaliczanie punktów kontrolnych, więc znalazł lagunę z odnawiającymi się power-upami i krążył w kółko w nieskończoność, nabijając wynik bez kończenia wyścigu. Funkcja nagrody zrobiła dokładnie to, co miała — tyle że agentowi nie powiedziano, co właściwie znaczy „wygrać”. Ta różnica między tym, co nagradzasz, a tym, czego naprawdę chcesz, to hacking nagrody (reward hacking) — i w jakiejś formie pojawia się niemal w każdej funkcji nagrody.
Ten sam algorytm, uruchomiony z innym ziarnem losowym, może dawać inne wyniki.
Opublikowane wyniki trudno odtworzyć bez dokładnie tego samego kodu, hiperparametrów i ziaren, których użyli autorzy. Drobne szczegóły implementacyjne, jak normalizacja obserwacji czy inicjalizacja bufora powtórki, mogą wpłynąć na wydajność bardziej niż sam wybór algorytmu.
W symulatorze agent może bezkarnie zawodzić tyle razy, ile trzeba. W prawdziwym świecie tak to nie działa.
Na przykład polityka jazdy autonomicznej, która „eksploruje” złą akcję na autostradzie, naraża ludzi. Symulatory nigdy nie oddają rzeczywistości idealnie — przypadki brzegowe, których nie zamodelowano, wychodzą na jaw od razu po wyjściu polityki z labu. Polityka świetna w symulacji może zawieść w nieprzewidziany sposób w realnym środowisku — dlatego wdrażanie deep RL poza grami i symulatorami wymaga o wiele więcej ostrożności, niż sugerują benchmarki.
Teraz podkreślę różnice między głębokim uczeniem ze wzmocnieniem a bardziej tradycyjnymi podejściami.
Uczenie nadzorowane trenuje na oznakowanych przykładach, gdzie każdy input ma już poprawną odpowiedź. Deep RL tego nigdy nie dostaje — ma tylko nagrodę po działaniu i samo musi rozgryźć, które akcje do niej doprowadziły.
Uczenie przez naśladownictwo trenuje politykę, by kopiowała demonstracje eksperta, bez użycia sygnału nagrody. Deep RL odkrywa zachowanie metodą prób i błędów.
Naśladownictwo szybko uruchamia politykę, ale jest ograniczone jakością demonstracji i ma kłopot, gdy agent trafi w sytuację, której ekspert nie pokazał. Deep RL może teoretycznie przewyższyć każdego nauczyciela, ale potrzebuje znacznie więcej interakcji i funkcji nagrody, która faktycznie wskazuje pożądane zachowanie.
Algorytmy ewolucyjne optymalizują politykę, mutując populację kandydatów i zachowując te najlepiej działające — bez liczenia gradientów. Deep RL wylicza gradienty z sygnału nagrody i aktualizuje pojedynczą politykę.
Metody ewolucyjne świetnie się równoleglą, bo każdy kandydat działa niezależnie. Zwykle jednak potrzebują znacznie więcej interakcji ze środowiskiem niż oparte na gradientach deep RL, by osiągnąć ten sam poziom wydajności.
Deep RL karze skróty bardziej niż większość innych dziedzin. Mając to na uwadze, pamiętaj o tych dobrych praktykach przy następnym projekcie:
Głębokie uczenie ze wzmocnieniem łączy pętlę prób i błędów leżącą u podstaw RL z siecią neuronową, która poradzi sobie ze stanami, jakich żadna tabela nie udźwignie.
Każdy algorytm z tego artykułu należy do jednej z trzech rodzin. Metody oparte na wartości, jak DQN, uczą się funkcji Q-wartości i wybierają akcję z najwyższą oceną. Metody oparte na polityce, jak REINFORCE, uczą się bezpośrednio polityki. Metody aktor–krytyk, w tym PPO, łączą oba podejścia — i to z nich dziś najczęściej się korzysta.
Pamiętaj tylko, że nic z tego nie jest „za darmo”.
Stabilność treningu, wydajność próbkowania, projektowanie nagród i reprodukowalność robią się trudniejsze w momencie przejścia z tabeli na sieć. Jeśli chcesz wejść głębiej, Q-learning i reinforcement learning omawiają fundamenty, na których opiera się ten tekst, a DQN i PPO to dobre kolejne przystanki, jeśli chodzi o same algorytmy.
Ucz się z DataCamp
course
course
Track