Kurs
Künstliche Intelligenz verstehen
2 Std.
421.1K
Klassisches Reinforcement Learning stößt an Grenzen, sobald die Umgebung zu groß wird, um sie noch von Hand zu erfassen. Der Grund: Jeder Zustand braucht seinen eigenen Tabelleneintrag, und jede Aktion in jedem Zustand ihren eigenen Wert.
Ein Spielbildschirm erzeugt zum Beispiel Millionen von Pixelformationen – die passen nicht in eine Tabelle, durch die du iterieren kannst. Der Agent muss den Wert eines unbekannten Zustands abschätzen, gestützt auf ähnliche, bereits gesehene Zustände.
Deep Reinforcement Learning löst das Problem, indem es die Tabelle durch ein neuronales Netz ersetzt, das den Wert eines Zustands oder die beste Aktion schätzt – selbst in Situationen, die es noch nie direkt gesehen hat. So können Agenten Go meistern oder simulierte Drohnen fliegen – Aufgaben, an denen klassische RL-Algorithmen zerbrechen würden.
In diesem Artikel führe ich dich durch die Kernkonzepte von Deep RL, die wichtigsten Algorithmusfamilien wie DQN und PPO und typische Einsatzszenarien in der Praxis.
Wenn du neu im Reinforcement Learning bist, melde dich für unseren Reinforcement Learning in Python-Lernpfad an und festige die Grundlagen an einem Wochenende.
Deep Reinforcement Learning ist Reinforcement Learning, bei dem ein neuronales Netz die Lookup-Tabelle ersetzt.
Reinforcement Learning liefert bereits die Schleife, in der ein Agent eine Aktion ausprobiert, beobachtet, was passiert, und basierend auf der Belohnung nachjustiert. Deep Learning fügt ein Netz hinzu, das Rohdaten in etwas verwandelt, mit dem der Agent handeln kann. Zusammen lernt der Agent direkt aus Rohdaten, welche Aktionen am besten funktionieren – ganz ohne händisch definierte Zustandsmerkmale.
Stell dir vor, du trainierst einen Agenten für ein Spiel wie Breakout. Der Agent bekommt keine saubere Liste wie „Ballposition“ oder „Schlägerposition“, sondern rohe Pixel vom Bildschirm. Ein tabellarischer Ansatz bräuchte eine eigene Zeile für jede mögliche Pixelkombination – unhandhabbar. Ein neuronales Netz schaut sich die Pixel direkt an und gibt aus, welche Aktion zu wählen ist oder wie gut jede Aktion aussieht – auch wenn es genau diesen Bildschirm noch nie gesehen hat.
Kurz gesagt: Tabellarische Methoden merken sich, Netze generalisieren.
Genau das macht Deep RL in Umgebungen einsatzfähig, die für Tabellen zu groß oder zu chaotisch sind.
Jedes Deep-RL-System läuft durch dieselbe Schleife – unabhängig vom konkreten Algorithmus darunter.
So läuft sie ab:
Das folgende Diagramm zeigt diese Schleife in Aktion:
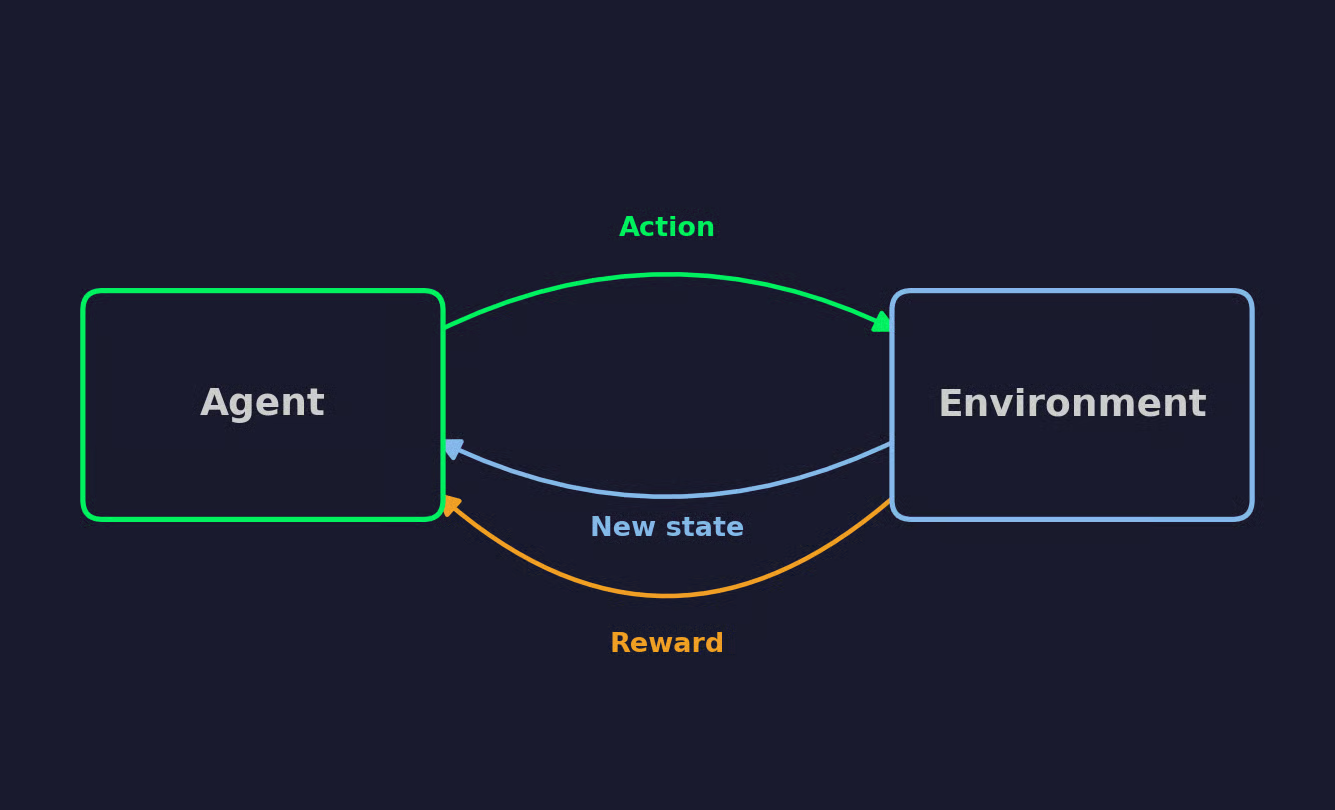
Reinforcement-Learning-Schleife
Wiederholst du diese Schleife oft genug, verschiebt sich das Verhalten des Agenten zu den Aktionen, die die Belohnung maximieren.
Jeder Deep-RL-Algorithmus baut auf denselben sieben Ideen auf. Wenn du die verinnerlichst, macht der Rest des Artikels deutlich mehr Sinn.
Stell dir einen Saugroboter vor, der lernt, einen Raum zu reinigen. Dieses Beispiel ziehe ich für alle Begriffe unten heran.
Der Agent ist der Entscheider – in unserem Beispiel der Saugroboter. Die Umgebung ist alles, womit er interagiert: der Raum, Möbel, Schmutz, Wände, gegen die er stoßen kann.
Der Agent kontrolliert die Umgebung nicht, aber er wählt Aktionen – und die Umgebung bestimmt, was als Nächstes passiert.
Der Zustand beschreibt die vollständige Situation der Umgebung zu einem Zeitpunkt, etwa die exakte Position jedes Schmutzflecks und die Position des Roboters. Realen Agenten liegt diese Information selten sicher vor.
Stattdessen handeln sie auf Basis einer Beobachtung – also dem, was der Agent tatsächlich sieht, z. B. Kamerabilder oder Abstandssensoren.
In einfachen Umgebungen sind Beobachtung und Zustand praktisch identisch. In komplexeren arbeitet der Agent mit Teilinformationen und muss Lücken schließen.
Aktionen sind die möglichen Züge des Agenten in einem Moment. Für den Roboter könnte das Vorwärtsfahren, Links-/Rechtsdrehen oder das Aktivieren der Saugkraft sein.
Aktionen können diskret sein – der Agent wählt aus einer festen Liste – oder kontinuierlich, dann wählt er einen Wert aus einem Bereich, etwa einen Lenkwinkel. Dieser Unterschied ist entscheidend für die Wahl der Algorithmusfamilie später im Artikel.
Eine Belohnung ist das numerische Feedback nach einer Aktion. Reinigt der Roboter eine neue Fläche, gibt es z. B. +1. Stoßt er gegen eine Wand, vielleicht -1.
Ziel des Agenten ist, die Summe aller Belohnungen über die Zeit zu maximieren – nicht nur die der nächsten Aktion.
Eine Policy ist die Strategie des Agenten, Zustände bzw. Beobachtungen in Aktionen zu überführen. Sie ist das Regelwerk, nach dem der Agent entscheidet, was er als Nächstes tut.
Eine Policy kann deterministisch sein – sie wählt für einen Zustand immer dieselbe Aktion – oder stochastisch, dann werden Aktionen nach einer Wahrscheinlichkeitsverteilung gezogen. Deep-RL-Algorithmen repräsentieren die Policy häufig durch ein neuronales Netz.
Eine Wertfunktion schätzt, wie viel zukünftige Belohnung der Agent ab einem Zustand erwarten kann, wenn er seiner aktuellen Policy folgt.
Eine Q-Wert-Funktion macht dasselbe für ein Zustand-Aktion-Paar. Sie schätzt die zukünftige Belohnung, wenn man in einem Zustand eine bestimmte Aktion ausführt und anschließend der Policy folgt.
Solche Funktionen eignen sich hervorragend für neuronale Netze als Näherung – genau die Idee, bei der wir weiter oben die Lookup-Tabelle ersetzt haben.
Eine Episode ist ein kompletter Durchlauf des Agenten durch die Umgebung – vom Startzustand bis zu einer Endbedingung. Für den Roboter: Der Raum ist sauber oder der Akku ist leer.
Nach dem Ende einer Episode wird die Umgebung zurückgesetzt und eine neue beginnt.
Ein Agent, der nur wiederholt, was bereits funktioniert, wird nie etwas Besseres finden.
Denk wieder an den Saugroboter. Er stolpert über eine Route, die einen ordentlichen Teil des Zimmers reinigt, und fährt diese immer wieder ab. Die Ecke hinter dem Sofa prüft er nie. Genau hier liegt der zentrale Trade-off im Reinforcement Learning:
Ein gängiger Weg, beides auszubalancieren, ist Epsilon-Greedy-Exploration. In jedem Schritt wählt der Agent mit Wahrscheinlichkeit Epsilon – z. B. 0,1 – eine zufällige Aktion, andernfalls die aktuell beste. Viele Algorithmen lassen Epsilon im Zeitverlauf abnehmen: Anfangs wird stark exploriert, später stärker ausgebeutet, sobald der Agent seiner Einschätzung traut.
Es gibt kein fixes Epsilon, das überall funktioniert.
Zu viel Exploration vergeudet Zeit mit Aktionen, die immer wieder scheitern. Zu wenig Exploration führt dazu, dass sich der Agent mit einer passablen Strategie zufriedengibt, während die bessere direkt nebenan liegt – unentdeckt. Das richtige Gleichgewicht zu finden wird mit wachsender Komplexität der Umgebung schwieriger, vor allem wenn sich die Kosten einer frühen Fehlaktion erst viele Schritte später zeigen.
Jeder Deep-RL-Algorithmus gehört zu einer von drei Familien – je nachdem, was gelernt wird: eine Wertfunktion, eine Policy oder beides zugleich.
DQN übernimmt die oben eingeführte Q-Wert-Funktion und ersetzt die Lookup-Tabelle durch ein neuronales Netz. Das Netz nimmt einen Zustand entgegen und gibt einen Q-Wert für jede mögliche Aktion aus – gelernt wie jedes andere neuronale Netz auch.
Direktes Training dieses Netzes ist nicht ratsam. Aufeinanderfolgende Erfahrungen sind korreliert – das Netz overfittet auf das, was es gerade gesehen hat – und das Ziel ändert sich bei jedem Update des Netzes.
DQN löst beide Probleme:
DQN war wegweisend, weil es als erstes direkt aus Rohpixeln über viele Atari-Spiele hinweg Steuerungsstrategien lernte – mit derselben Architektur und denselben Hyperparametern. Als DeepMind es 2015 veröffentlichte, zeigte es, dass Deep Learning und Reinforcement Learning im großen Maßstab zusammen funktionieren – ohne handgebaute Features pro Spiel.
Statt eine Wertfunktion zu lernen und daraus Aktionen abzuleiten, lernen Policy-Gradient-Methoden direkt die Policy. Das Netz nimmt einen Zustand und gibt Aktionswahrscheinlichkeiten aus; der Agent sampelt eine Aktion aus dieser Verteilung.
Dieser Ansatz passt zu kontinuierlichen oder stochastischen Aktionen.
Wertbasierte Methoden müssen alle möglichen Aktionen prüfen, um die beste zu finden – das bricht zusammen, sobald der Aktionsraum kontinuierlich wird; du kannst keine unendliche Anzahl an Lenkwinkeln durchgehen. Eine Policy-Gradient-Methode sampelt einfach aus der Verteilung – unabhängig von der Anzahl möglicher Aktionen.
REINFORCE ist hier der Grundalgorithmus. Er läuft eine komplette Episode, erhöht danach die Wahrscheinlichkeit von Aktionen mit hoher Gesamtbelohnung und verringert sie für Aktionen mit niedriger Gesamtbelohnung. Der Haken: Updates erfolgen erst nach Episodenende und beruhen auf der Gesamtrendite – das macht die Updates verrauscht und zwischen Episoden inkonsistent.
Actor-Critic-Methoden beheben das Rauschproblem von REINFORCE durch ein zweites Netz.
Der Actor ist die Policy – er wählt Aktionen wie bei einer Policy-Gradient-Methode. Der Critic ist eine Wertfunktion, die jede Aktion unmittelbar nach ihrem Eintreten bewertet – statt bis zum Episodenende zu warten.
Hier arbeiten wertbasierte und policybasierte Ansätze zusammen. Der Actor lernt weiter eine Policy, aktualisiert sie aber auf Basis der direkten Einschätzung des Critics statt der verzögerten, verrauschten Rendite von REINFORCE.
A2C und A3C sind die Standardbeispiele. A2C lässt mehrere Umgebungsinstanzen parallel laufen und aktualisiert Actor und Critic gemeinsam, sobald ein Batch fertig ist. A3C lässt diese Instanzen asynchron laufen – jede aktualisiert das gemeinsame Netz nach ihrem eigenen Takt, ohne auf die anderen zu warten.
Policy-Gradient-Updates können schiefgehen, wenn sie zu groß ausfallen. Ein ausreichend großer Schritt kann eine gut funktionierende Policy ruinieren – und rückgängig machen lässt sich das nicht.
PPO begrenzt die Größe jedes Updates. Hier ist das geclippte Ziel, das optimiert wird:
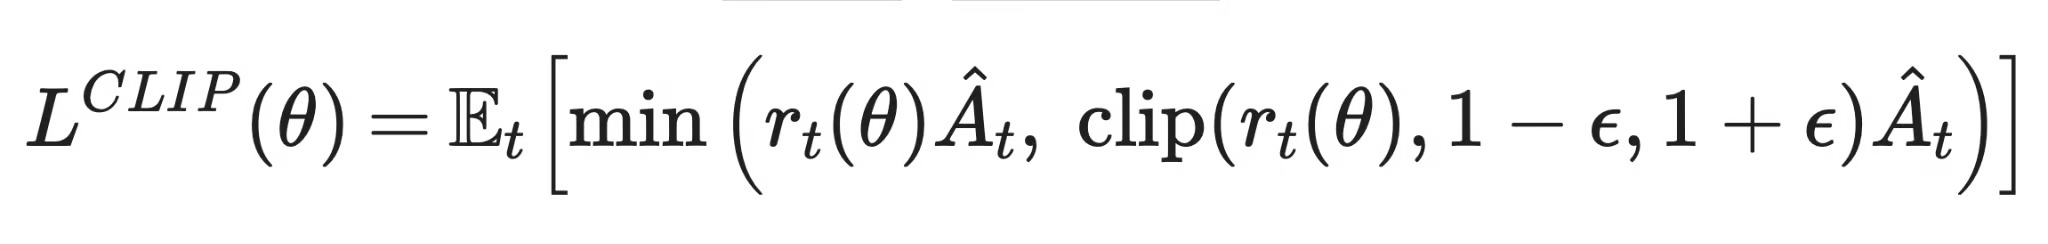
Proximal Policy Optimization
r_t(θ) ist das Verhältnis aus der Aktionswahrscheinlichkeit unter der neuen Policy und der alten Policy. Â_t ist der Advantage – also wie viel besser die Aktion im Vergleich zur Erwartung des Critics abgeschnitten hat. Die clip() Funktion hält das Verhältnis in einem engen Band um 1, damit sich die Policy pro Schritt nicht zu stark verschiebt. Das min() nimmt dann die konservativere der beiden Schätzungen, damit ein ungewöhnlich großer Advantage das Update nicht über die Clip-Grenze hinausdrückt.
OpenAI hat PPO 2017 eingeführt – und es wurde fast sofort zur Standardwahl. Es ist einfacher zu implementieren und zu tunen als die zuvor verbreiteten Trust-Region-Methoden und funktioniert über viele Umgebungen hinweg mit wenig Feintuning.
DDPG und Soft Actor-Critic (SAC) zielen beide auf kontinuierliche Steuerungsprobleme – etwa Gelenkwinkel in der Robotik oder Lenkwinkel – bei denen der Agent eine konkrete Zahl statt einer Auswahl aus einer Verteilung ausgeben muss.
DDPG ist eine Actor-Critic-Methode, deren Actor eine einzelne deterministische Aktion statt einer Verteilung ausgibt. Sie übernimmt Experience Replay und Target Networks aus DQN.
SAC baut darauf auf, ergänzt aber einen Entropieterm, der die Policy für eine gewisse Zufälligkeit belohnt. Das hält die Exploration länger aufrecht und macht das Training meist stabiler als bei DDPG.
Wertbasierte Methoden wie DQN lernen eine Q-Wert-Funktion und wählen die höchstbewertete Aktion. Das funktioniert gut bei diskreten Aktionsräumen und ist dank Experience Replay dateneffizient – lässt sich jedoch ohne Zusatzaufwand nicht auf kontinuierliche Aktionen übertragen.
Policybasierte Methoden wie REINFORCE lernen die Policy direkt und sampeln Aktionen aus einer Wahrscheinlichkeitsverteilung. Dadurch funktionieren sie mit kontinuierlichen und stochastischen Aktionen, aber die reinen Policy-Gradient-Updates sind verrauscht und benötigen für jedes Update frische Daten.
Actor-Critic-Methoden – darunter A2C/A3C, PPO, DDPG und SAC – kombinieren beide Ideen. Das schnelle Feedback des Critics stabilisiert die Updates des Actors. Deshalb gehören die meisten in der Praxis genutzten Algorithmen heute in diese Kategorie.
Hier ist der Vergleich noch einmal visuell:
| Was wird gelernt | Wie die Aktionen gewählt werden | Diskret vs. kontinuierlich | Stabilität | Dateneffizienz | Beispielalgorithmen | |
|---|---|---|---|---|---|---|
| Wertbasiert | Q-Wert-Funktion | Höchster Bewertungswert | Diskret | Braucht Target Networks und Replay für Stabilität | Gut – dank Experience Replay | DQN |
| Policybasiert | Policy | Gesampelt aus der Policy-Verteilung | Beides, am besten bei kontinuierlich | Verrauschte, hochvariante Updates | Gering – benötigt neue Daten pro Update | REINFORCE |
| Actor-Critic | Policy und Wertfunktion | Gesampelt vom Actor, geführt vom Critic | Beides | Stabiler als reine Policy-Methoden | Besser als reine Policy-Methoden | A2C/A3C, PPO, DDPG, SAC |
Deep-Reinforcement-Learning-Methoden im Vergleich
Überwachtes Lernen erhält für jedes Beispiel ein Label. Deep RL muss aus einem späten, auf viele frühere Aktionen verteilten Belohnungssignal herauslesen, was gewirkt hat – und manchmal bleibt ein sinnvolles Signal ganz aus.
Deep-RL-Agenten benötigen oft Millionen von Umweltschritten, bevor sie Nützliches lernen – insbesondere im Vergleich zu der geringen Datenmenge, die ein überwachtes Modell für ähnliche Genauigkeit auf einem festen Datensatz braucht.
Der Grund: Der Agent erzeugt seine Trainingsdaten durch Handeln selbst – und anfangs sind die meisten Aktionen nahezu zufällig. Ein überwachtes Modell kann denselben gelabelten Datensatz wieder und wieder nutzen. Ein RL-Agent muss eine Umgebung, die er kaum versteht, Schritt für Schritt erkunden.
RL-Training ist oft instabil.
Ein Teil des Problems: Wertfunktionen bootstrappen auf ihren eigenen Schätzungen – das heutige Q-Ziel hängt von der gestrigen Q-Schätzung ab. Ist diese falsch, kumuliert sich der Fehler statt sich zu korrigieren. Zusätzlich ändert sich die Policy im Lernprozess – und damit auch die gesammelten Daten.
Mit anderen Worten: Das Netz jagt auf zwei Fronten zugleich einem beweglichen Ziel hinterher.
Manche Umgebungen vergeben Belohnungen nur am Ende – etwa ein Sieg-/Niederlagensignal nach einem langen Spiel. Der Agent muss von dieser einen Zahl rückwärts ableiten, welche der vielen Aktionen wirklich den Unterschied gemacht hat.
Das ist das Credit-Assignment-Problem – und es verschärft sich, je länger der Abstand zwischen Aktion und Konsequenz ist.
Reward-Design klingt einfach – bis du es versuchst.
Ein bekanntes Beispiel: Ein von OpenAI trainierter Boot-Racing-Agent erhielt Belohnungen für Checkpoints. Er fand eine Lagune mit respawnenden Power-Ups und drehte dort endlose Runden – sammelte Punkte, ohne je das Rennen zu beenden. Die Reward-Funktion tat genau, was sie sollte – nur wurde „Gewinnen“ nicht definiert. Diese Lücke zwischen dem, was du belohnst, und dem, was du wirklich willst, heißt Reward Hacking – und sie taucht in irgendeiner Form bei fast jeder Reward-Funktion auf.
Dasselbe Verfahren kann mit einem anderen Zufallsseed andere Ergebnisse liefern.
Veröffentlichte Resultate sind schwer reproduzierbar ohne exakt denselben Code, dieselben Hyperparameter und Seeds. Kleine Implementierungsdetails – etwa die Normalisierung von Beobachtungen oder die Initialisierung des Replay-Puffers – können die Leistung stärker beeinflussen als die Wahl des Algorithmus.
In einem Simulator darf ein Agent beliebig oft scheitern. In der realen Welt nicht.
Eine selbstfahrende Policy, die auf der Autobahn eine schlechte Aktion exploriert, gefährdet Menschen. Und Simulatoren bilden die Realität nie perfekt ab – Edge Cases, die nie modelliert wurden, treten sofort auf, sobald die Policy das Labor verlässt. Eine Policy, die in der Simulation glänzt, kann in der Realität auf unvorhergesehene Weise scheitern. Deshalb erfordert der Einsatz von Deep RL jenseits von Spielen und Simulatoren weit mehr Vorsicht, als Benchmark-Zahlen vermuten lassen.
Im Folgenden hebe ich die Unterschiede zwischen Deep Reinforcement Learning und etablierten Ansätzen hervor.
Überwachtes Lernen trainiert auf gelabelten Beispielen – zu jedem Input gibt es eine korrekte Antwort. Deep RL bekommt nur nach dem Handeln eine Belohnung und muss selbst herausfinden, welche Aktionen dazu geführt haben.
Imitation Learning trainiert eine Policy, um Expertendemonstrationen zu imitieren – ganz ohne Belohnungssignal. Deep RL entdeckt Verhalten durch Versuch und Irrtum.
Imitation Learning bringt eine Policy schnell zum Laufen, ist aber durch die Qualität der Demos gedeckelt und scheitert, sobald der Agent in Situationen gerät, die der Experte nicht gezeigt hat. Deep RL kann theoretisch jeden Lehrer übertreffen, braucht dafür aber deutlich mehr Interaktion und eine Reward-Funktion, die das gewünschte Verhalten wirklich fördert.
Evolutionäre Algorithmen optimieren eine Policy, indem sie eine Population an Kandidaten mutieren und die besten behalten – ganz ohne Gradienten. Deep RL berechnet Gradienten aus dem Belohnungssignal und aktualisiert eine einzelne Policy.
Evolutionäre Methoden lassen sich gut parallelisieren, da jeder Kandidat unabhängig laufen kann. Insgesamt benötigen sie jedoch typischerweise deutlich mehr Interaktionen mit der Umgebung als gradientenbasierte Deep-RL-Verfahren, um dasselbe Leistungsniveau zu erreichen.
Deep RL verzeiht Abkürzungen weniger als andere Felder. Mit diesem Mindset hier ein paar Best Practices für dein nächstes Projekt:
Deep Reinforcement Learning kombiniert die Trial-and-Error-Schleife des RL mit einem neuronalen Netz, das Zustände bewältigt, für die keine Lookup-Tabelle ausreicht.
Alle Algorithmen in diesem Artikel fallen in eine von drei Familien. Wertbasierte Methoden wie DQN lernen eine Q-Wert-Funktion und wählen die höchstbewertete Aktion. Policybasierte Methoden wie REINFORCE lernen die Policy direkt. Actor-Critic-Methoden – darunter PPO – kombinieren beides, und diese Kombination dominiert heute die Praxis.
Behalte nur im Hinterkopf: Nichts davon gibt es umsonst.
Trainingsstabilität, Dateneffizienz, Reward-Design und Reproduzierbarkeit werden schwieriger, sobald du von einer Tabelle zu einem Netz wechselst. Wenn du tiefer einsteigen willst, liefern Q-learning und Reinforcement Learning die Grundlagen für diesen Artikel, und DQN sowie PPO sind gute nächste Stationen bei den Algorithmen selbst.
Lerne mit DataCamp
Kurs
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Adel Nehme
6 Min.