Courses
AIを理解する
2時間
421.1K
従来の強化学習は、環境が手作業で管理できないほど大きくなると、うまく機能しません。理由は、すべての状態にテーブル上の専用エントリが必要で、各状態からのすべての行動にもそれぞれ値が必要になるためです。
たとえば、ゲーム画面は何百万通りものピクセルの組み合わせを生み出します。これはループで回せるテーブルには収まりません。エージェントは、見たことのない状態の価値を、見た目が似た状態に基づいて推測する必要があります。
ディープ強化学習は、テーブルの代わりにニューラルネットワークを用いて、見たことのない状況でも状態の価値や最適な行動を推定できるようにすることで、この問題を解決します。これにより、碁を極めたり、シミュレーション上のドローンを飛ばしたりと、古典的なRLアルゴリズムでは破綻するタスクをこなせるようになります。
本記事では、ディープRLの中核概念、DQNやPPOといった主要アルゴリズム群、そして実世界での活用例まで順を追って解説します。
強化学習が初めての方は、週末で基礎を押さえられる Reinforcement Learning in Python トラックに登録して、基礎を固めてください。
ディープ強化学習は、参照テーブルの役割をニューラルネットワークが担う強化学習です。
強化学習はすでに、エージェントが行動を試し、結果を観察し、報酬に基づいて調整するという基本ループを提供します。ディープラーニングは、生の入力をエージェントが扱える表現に変換するネットワークを追加します。両者を組み合わせることで、各状態の意味を人手で定義しなくても、エージェントは生データから直接、どの行動が最も有効かを学習できます。
たとえば、Breakoutのようなゲームをプレイするエージェントを訓練するとします。エージェントは「ボール位置」や「パドル位置」といったきれいなリストを受け取りません。画面からの生のピクセルを受け取ります。表形式の手法では、あり得るピクセルの組み合わせごとに行が必要で、その数は現実的ではありません。ニューラルネットワークはピクセルを直接見て、どの行動を取るべきか、あるいは各行動がどの程度良さそうかを出力します。まったく同じ画面を見たことがなくてもです。
要するに、表は暗記、ネットワークは汎化です。
これが、テーブルでは扱いきれないほど大きく雑然とした環境でディープRLが機能する理由です。
どのアルゴリズムでも、ディープRLシステムは同じループを回します。
流れは次のとおりです。
下の図は、このループが動作している様子を示しています。
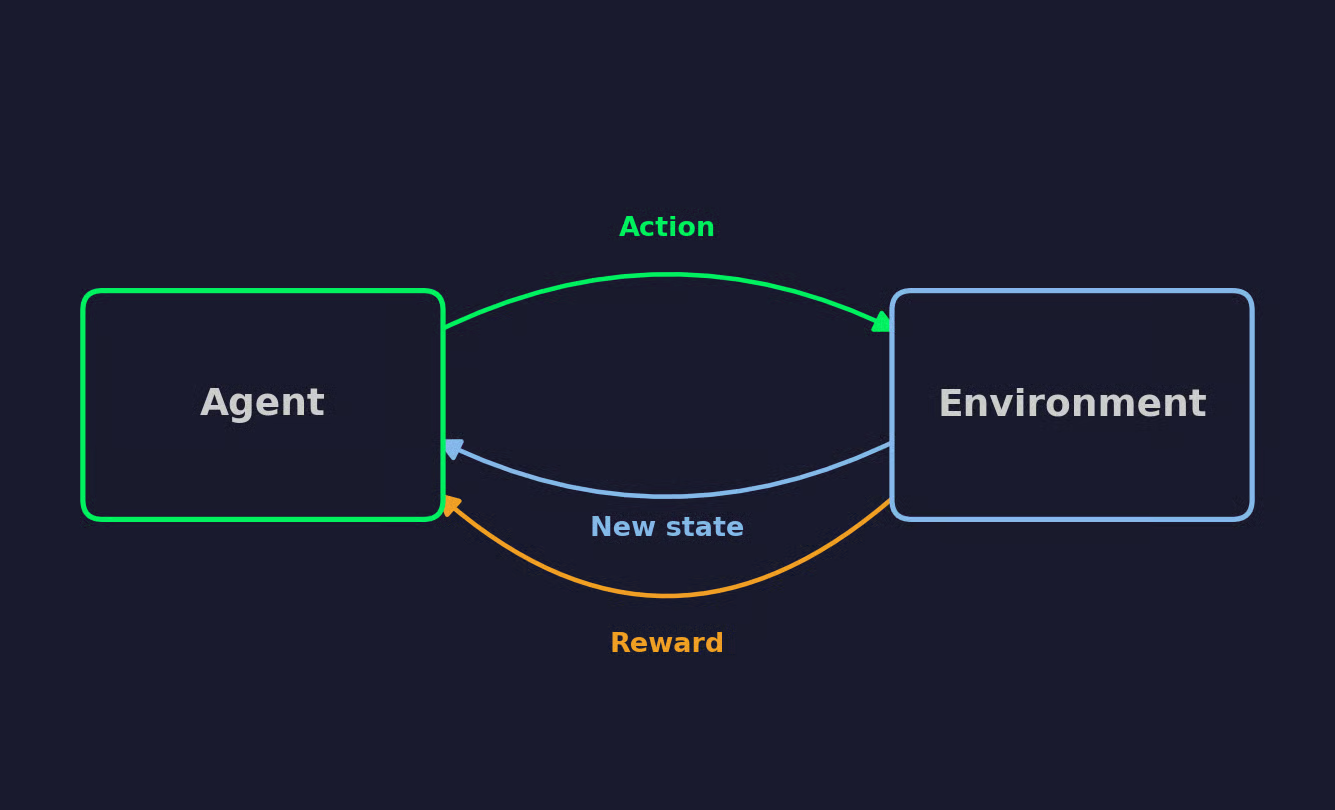
強化学習のループ
このループを十分に繰り返すと、エージェントの振る舞いは報酬を最大化し続ける行動へと収束していきます。
ディープRLのアルゴリズムは、同じ7つの考え方に基づいています。これらに慣れておくと、この記事の残りがぐっと理解しやすくなります。
部屋を掃除するロボット掃除機が学習する様子を想像してください。以下の各用語でこの例を使います。
エージェントは意思決定者(ここではロボット掃除機)です。環境は、部屋、家具、汚れ、ぶつかる可能性のある壁など、エージェントが相互作用するすべてのものを指します。
エージェントは環境を制御できませんが、行動は選べます。そして何が起きるかは環境が決めます。
状態は、ある時点における環境の完全な状況を表します。たとえば、すべての汚れの正確な位置と掃除機の位置です。実際のエージェントがそれを確実に知れることはほとんどありません。
代わりに、カメラ映像や近接センサーのセットのような、実際に見える範囲の観測に基づいて行動します。
単純な環境では、観測と状態はほぼ同じです。より複雑になると、エージェントは不完全な情報で穴を埋めながら動きます。
行動は、任意の時点でエージェントが選べる手です。掃除機なら、前進、左折、右折、吸引の起動などです。
行動は、固定リストから選ぶ離散型と、操舵角のように範囲から値を選ぶ連続型があります。この区別は、後半のアルゴリズム群で非常に重要になります。
報酬は、行動後にエージェントが受け取る数値的なフィードバックです。新しい床面を掃除できたら +1、壁にぶつかったら -1、のように与えます。
エージェントの目的は、次の1手の報酬ではなく、時間を通じた総報酬を最大化することです。
方策は、状態(または観測)から行動への写像戦略です。次に何をすべきかを決めるためのルールブックです。
方策は決定的であっても確率的であってもよく、ディープRLではしばしばニューラルネットワークで表現します。
価値関数は、現在の方策に従い続けた場合に、ある状態から得られる将来報酬の期待値を推定します。
Q値関数は、状態と行動の組に対して同様の推定を行います。特定の状態で特定の行動を取り、その後その方策に従ったときの将来報酬を見積もります。
この種の関数近似はニューラルネットワークが得意とするところです。記事の前半で参照テーブルを置き換えた話と同じ発想です。
エピソードは、開始状態から終了条件に至るまでの、環境内でのエージェントの一連の実行です。掃除機なら、部屋が完全にきれいになるか、バッテリーが切れるまで、などです。
エピソードが終わると環境はリセットされ、新しいエピソードが始まります。
過去にうまくいったことだけを繰り返すエージェントは、より良い方法を見つけられません。
また掃除機の例です。たまたま部屋のそれなりの範囲を掃除できる経路を見つけ、その道順を毎回なぞり続けます。ソファの後ろの隅を確認することはありません。これが強化学習の中心にあるトレードオフです。
両者のバランスを取る一般的な手法がε-greedy探索です。各ステップで、小さな確率ε(0.1など)でランダムな行動を選び、それ以外は現在最良と信じる行動を選びます。多くのアルゴリズムは時間とともにεを減衰させ、初期は探索を多く行い、十分に学習して自信が持てるようになったら活用を強めます。
すべての環境に通用する固定のεは存在しません。
探索が多すぎると、失敗し続ける行動に時間を浪費します。探索が少なすぎると、すぐ隣にもっと良い戦略があるのに見つけられず、ほどほどの戦略で妥協してしまいます。環境が複雑になるほどこのバランス取りは難しくなります。特に、初期の悪い行動の真のコストが何手も後になって現れる場合はなおさらです。
ディープRLのアルゴリズムは、学習対象に応じて、価値関数、方策、またはその両方の3つの系統に分類されます。
DQNは、この記事で取り上げたQ値関数の参照テーブルをニューラルネットワークに置き換えます。ネットワークは状態を入力として受け取り、可能な各行動に対するQ値を出力します。学習は通常のニューラルネットワークと同様に行います。
このネットワークを直接学習させるのは推奨されません。連続する経験は相関しており、ネットワークは直前に見たものに過剰適合しがちです。また、目標値はネットワークの更新のたびに変わってしまいます。
DQNは両方の問題を次で解決します。
DQNが重要だったのは、同一のアーキテクチャとハイパーパラメータで、多数のAtariゲームにおいて生のピクセルから直接制御方策を学習した最初のアルゴリズムだったからです。2015年にDeepMindが公開したことで、ディープラーニングと強化学習が、各ゲームごとに特徴量を手作りしなくても、スケールして連携できることを示しました。
価値関数を学び、それに基づいて行動を選ぶ代わりに、ポリシー勾配法は方策自体を学びます。ネットワークは状態を入力として受け取り、行動の確率分布を出力し、エージェントはその分布からサンプルします。
このアプローチは連続行動や確率的行動に適しています。
価値ベース手法は、最良の行動を見つけるために全行動を評価する必要があり、行動空間が連続になると破綻します。無限の操舵角を総当たりできないからです。ポリシー勾配法は、行動の数がいくつであっても分布からサンプルするだけです。
REINFORCEが基礎的なアルゴリズムです。1エピソードを通して実行し、総報酬が高かった行動の確率を上げ、低かった行動の確率を下げます。難点は、エピソード終了後にしか更新しないことと、全リターンに依存するため、更新がノイジーでエピソードごとにばらつきやすいことです。
アクター・クリティック法は、2つ目のネットワークを追加してREINFORCEのノイズ問題を解消します。
アクターは方策で、ポリシー勾配法と同様に行動を選びます。クリティックは価値関数で、エピソード終了を待たず、各行動直後に評価します。
価値ベースと方策ベースの併用です。アクターは方策を学び続けますが、更新はREINFORCEのような遅くノイジーなリターンではなく、クリティックの評価に基づきます。
A2CとA3Cが代表例です。A2Cは複数の環境を並列に走らせ、各バッチ終了ごとにアクターとクリティックをまとめて更新します。A3Cはそれらを非同期に実行し、各環境が他を待たず独自のタイミングで共有ネットワークを更新します。
ポリシー勾配の更新が大きすぎると破綻します。十分に大きな更新は、うまく機能していた方策を台無しにし、起きてから元に戻せません。
PPOは各更新の大きさに上限を設けることで、これを避けます。最適化するクリップ付き目的関数は次のとおりです。
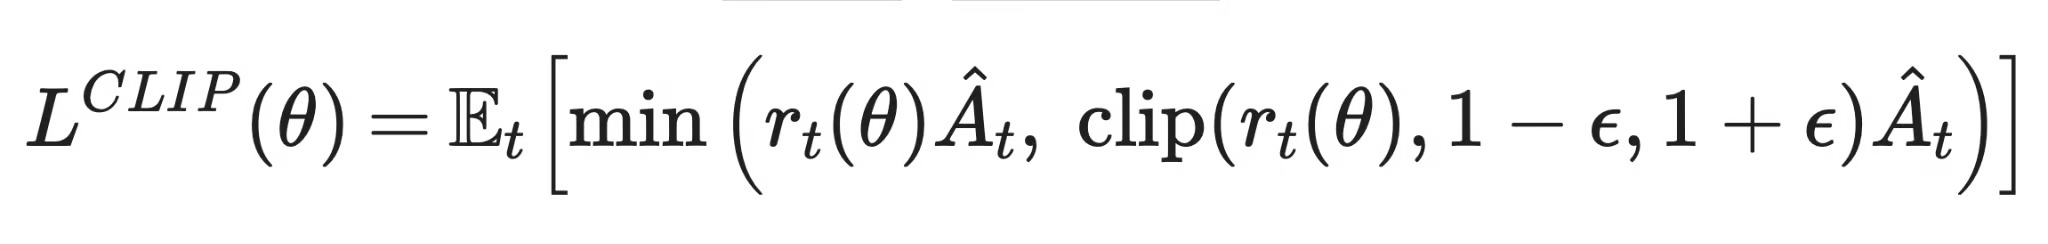
近接方策最適化
r_t(θ) は、新旧方策で同一行動の確率の比です。Â_t はアドバンテージ(クリティックの基準期待に比べて、その行動がどれだけ良かったか)です。clip() 関数は比を1の近傍に収め、1回のステップで方策が行き過ぎて変わらないようにします。続くmin()は、2つの推定のうち保守的な方を採用し、異常に大きなアドバンテージ推定がクリップを超えて更新を押し広げるのを防ぎます。
PPOは2017年にOpenAIが発表し、瞬く間にデフォルトの選択肢になりました。従来の信頼領域法より実装とチューニングが容易で、タスクごとの細かな調整なしに幅広い環境で安定して機能します。
DDPGとSoft Actor-Critic(SAC)は、ロボット関節角や操舵値のように、分布から選ぶのではなく特定の数値を出力する必要がある連続制御問題を対象とします。
DDPGはアクター・クリティック法で、アクターは分布ではなく単一の決定的な行動を出力し、DQNから経験再生とターゲットネットワークを取り入れています。
SACは同じ発想を発展させ、方策のランダム性をある程度保つようエントロピー項で報いることで、探索を長く維持し、学習をDDPGより安定させる傾向があります。
価値ベース手法(DQNなど)はQ値関数を学び、その関数が最も高く評価する行動を選びます。離散行動空間で有効で、経験再生のおかげでサンプル効率も良い一方、連続行動への拡張は一工夫必要です。
方策ベース手法(REINFORCEなど)は方策を直接学び、確率分布から行動をサンプルします。連続・確率的行動で機能しますが、素朴なポリシー勾配更新はノイジーで、毎回新しいデータが必要です。
アクター・クリティック法(A2C/A3C、PPO、DDPG、SACなど)は両者を組み合わせます。クリティックの即時のフィードバックがアクターの更新を安定化させるため、実運用で使われる多くのアルゴリズムがこの系統に属します。
視覚的な比較は次のとおりです。
| 学習対象 | 行動の選択方法 | 離散か連続か | 安定性 | サンプル効率 | 代表的アルゴリズム | |
|---|---|---|---|---|---|---|
| 価値ベース | Q値関数 | 最高評価の行動 | 離散 | 安定化にはターゲットネットとリプレイが必要 | 経験再生により良好 | DQN |
| 方策ベース | 方策 | 方策の分布からサンプル | 両方(連続が得意) | ノイジーで分散が大きい更新 | 低い。更新ごとに新データが必要 | REINFORCE |
| アクター・クリティック | 方策と価値関数 | アクターからサンプルし、クリティックが誘導 | 両方 | 純粋な方策ベースより安定 | 純粋な方策ベースより良好 | A2C/A3C, PPO, DDPG, SAC |
ディープ強化学習手法の比較
教師あり学習は各サンプルに対して正解ラベルがあります。ディープRLは、遅れて現れ、直前の行動群と混ざり、ときには有益な形では現れない報酬信号から、何が効いたのかを見つけなければなりません。
ディープRLのエージェントは、有用なことを学び始めるまでに、しばしば数百万ステップの環境インタラクションを要します。固定データセットで同等の精度に到達する教師ありモデルと比べて、極めて多くのデータが必要です。
理由は、エージェントが行動して自ら学習データを生成する必要があり、特に初期はほぼランダムな行動が大半を占めるからです。教師ありモデルは同じラベル付きデータを何度も再利用できますが、RLエージェントはほとんど理解していない環境を、一歩ずつ探索し続ける必要があります。
RLの学習は不安定になりがちです。
一因は、価値関数が自己の推定値にブートストラップすることです。つまり、今日のQ値ターゲットが昨日のQ値推測に依存します。その推測が外れていると、誤差は補正されずに累積します。さらに、学習に伴い方策が変化し続けるため、収集するデータも常に変わります。
言い換えると、ネットワークは二方面で動く標的を追いかけているのです。
一部の環境では、長いゲームの最後に勝敗の信号だけが与えられることがあります。エージェントは、その1つの数値から逆算し、数十の行動のうち何が重要だったのかを突き止めなければなりません。
これはクレジット割当問題と呼ばれ、行動と結果の遅延が長いほど深刻になります。
報酬設計は、やってみると意外に難しいものです。
有名な例があります。OpenAIが訓練したボートレースのエージェントは、チェックポイント通過で報酬を与えられていたため、出現し続けるパワーアップがある入江を見つけ、延々と周回してスコアを稼ぎ、レースを完走しませんでした。報酬関数は与えられた指示どおりに動作していたのです——エージェントに「勝つ」とは何かが伝わっていなかっただけでした。求めるものと与える報酬のずれは報酬ハッキングと呼ばれ、ほぼすべての報酬関数で何らかの形で現れます。
同じアルゴリズムでも、乱数シードが違えば結果が変わり得ます。
公開結果は、元の研究者が使ったコードベース、ハイパーパラメータ、シードが完全に同じでなければ再現が難しいことがあります。観測の正規化方法やリプレイバッファの初期化といった小さな実装上の差異が、アルゴリズム選択以上に性能を左右することもあります。
シミュレータでは、エージェントは何度失敗してもコストがかかりません。現実世界はそうはいきません。
たとえば、高速道路で悪い行動を探索する自動運転方策は、人命を危険にさらします。シミュレータは現実を完全には再現できず、想定外事例は研究室を出た瞬間に現れます。シミュレーションで優秀だった方策が、実環境に触れた途端に予想外の形で失敗することがあるため、ゲームやシミュレータの外でディープRLをデプロイするには、ベンチマークの数字以上の慎重さが求められます。
ここからは、ディープ強化学習とより伝統的な手法との違いを簡潔に示します。
教師あり学習は、各入力に正解が付いたラベル付きサンプルで訓練します。ディープRLはそれを得られず、行動後に報酬だけが返ってきます。その報酬がどの行動に起因したのかを自力で突き止めなければなりません。
模倣学習は、報酬信号を使わず、熟練者のデモンストレーションを模倣するよう方策を学習します。ディープRLは試行錯誤で行動を見つけます。
模倣学習は素早く方策を立ち上げられますが、デモの質を超えられず、教師が示していない状況に弱い傾向があります。ディープRLは理論上どの教師も上回れますが、そのためには多くの相互作用と、望ましい振る舞いを正しく指し示す報酬関数が必要です。
進化的アルゴリズムは、候補の集団を突然変異させ、性能が良いものを残していくことで方策を最適化します。勾配は計算しません。ディープRLは報酬から勾配を計算し、単一の方策を更新します。
進化的手法は並列化に向いており、集団内の各候補を独立に実行できます。ただし、同等の性能に達するまでに、勾配ベースのディープRLより総インタラクション数が大幅に多くなるのが一般的です。
ディープRLは、他分野以上に近道を嫌います。これを踏まえ、次のプロジェクトで意識すべきベストプラクティスを挙げます。
ディープ強化学習は、RLの試行錯誤ループに、参照テーブルでは到底扱えない状態を処理できるニューラルネットワークを組み合わせたものです。
本記事のアルゴリズムはすべて3系統のいずれかに属します。価値ベース手法(DQNなど)はQ値関数を学び、最も高評価の行動を選びます。方策ベース手法(REINFORCEなど)は方策を直接学習します。アクター・クリティック法(PPOを含む)は両者を組み合わせ、現在もっとも広く使われています。
ただし、これはタダではありません。
テーブルからネットワークに移行した瞬間に、学習の安定性、サンプル効率、報酬設計、再現性のすべてが難しくなります。さらに学ぶには、Q-learning や reinforcement learning が本記事の土台をカバーしており、アルゴリズム自体はDQNや PPO が次の良い一歩になります。
DataCampで学ぶ
Courses
Courses
Tracks