Curso
Entendendo a inteligência artificial
2 h
421.1K
O aprendizado por reforço tradicional não dá conta quando o ambiente fica grande demais para acompanhar manualmente. O motivo é que cada estado precisa da sua própria entrada em uma tabela, e cada ação em cada estado precisa do seu próprio valor.
Por exemplo, a tela de um jogo gera milhões de combinações de pixels, algo impossível de encaixar em uma tabela que você possa percorrer. O agente precisa estimar o valor de um estado que nunca viu, com base em estados semelhantes.
O aprendizado por reforço profundo resolve isso trocando a tabela por uma rede neural que estima o valor de um estado ou a melhor ação a tomar, mesmo em situações que ela nunca encontrou diretamente. É isso que permite a agentes dominarem Go e pilotarem drones simulados — tarefas que fariam qualquer algoritmo clássico de RL explodir em complexidade.
Neste artigo, vou apresentar os conceitos essenciais de RL profundo, as principais famílias de algoritmos como DQN e PPO, e onde eles aparecem no mundo real.
Se você está começando em aprendizado por reforçot learning, inscreva-se na nossa trilha Reinforcement Learning in Python para dominar os fundamentos em um fim de semana.
Aprendizado por reforço profundo é aprendizado por reforço com uma rede neural no lugar da tabela de consulta.
O aprendizado por reforço já oferece o loop básico no qual um agente testa uma ação, observa o que acontece e ajusta com base na recompensa. O deep learning acrescenta uma rede que transforma entrada bruta em algo com que o agente consegue agir. Juntos, o agente aprende quais ações funcionam melhor direto dos dados brutos, sem ninguém codificar manualmente o que cada estado significa.
Imagine que você está treinando um agente para jogar Breakout. Ele não recebe uma lista pronta de "posição da bola" ou "posição da raquete" — ele recebe pixels crus da tela. Um método tabular precisaria de uma linha separada para cada combinação possível de pixels, um número impraticável. Uma rede neural olha diretamente para os pixels e gera qual ação tomar, ou quão boa parece cada ação, mesmo sem ter visto exatamente aquela tela antes.
Em resumo: métodos tabulares memorizam, redes generalizam.
É isso que faz RL profundo funcionar em ambientes grandes demais ou bagunçados demais para uma tabela dar conta.
Todo sistema de RL profundo roda o mesmo loop, não importa qual algoritmo está por baixo.
Funciona assim:
O diagrama abaixo mostra esse loop em ação:
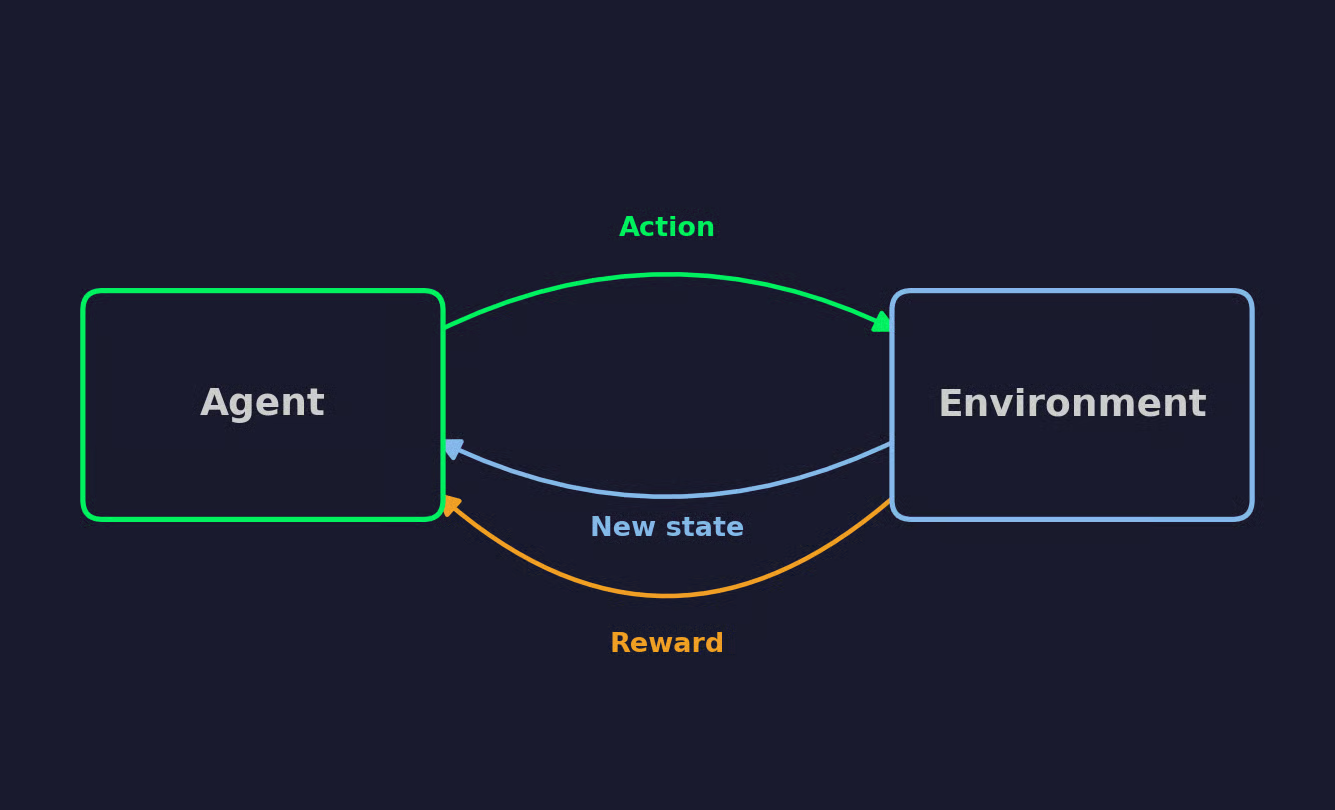
Loop de aprendizado por reforço
Se você repetir esse loop vezes suficientes, o comportamento do agente converge para as ações que maximizam a recompensa.
Todo algoritmo de RL profundo se apoia nas mesmas sete ideias. Fique à vontade com elas e o resto do artigo vai ficar muito mais claro.
Imagine um robô aspirador aprendendo a limpar um cômodo. Vou usar esse exemplo em cada termo abaixo.
O agente é quem decide — no exemplo, o robô aspirador. O ambiente é tudo com o que ele interage: o cômodo, os móveis, a sujeira, as paredes em que pode bater.
O agente não controla o ambiente, mas escolhe ações, e o ambiente decide o que acontece em seguida.
O estado descreve a condição completa do ambiente em um dado momento, como a posição exata de cada mancha de sujeira e a localização do aspirador. Raramente agentes reais têm acesso a isso com certeza.
Em vez disso, eles agem com base em uma observação — aquilo que o agente realmente consegue ver, como um feed de câmera ou sensores de proximidade.
Em ambientes simples, observação e estado são praticamente a mesma coisa. Em ambientes mais complexos, o agente trabalha com informação parcial e precisa completar as lacunas.
Ações são as possibilidades disponíveis ao agente em cada momento. Para o aspirador, pode ser avançar, virar à esquerda, virar à direita ou ativar a sucção.
As ações podem ser discretas, quando o agente escolhe de uma lista fixa, ou contínuas, quando escolhe um valor em um intervalo, como um ângulo de direção. Essa distinção importa bastante quando você chegar às famílias de algoritmos mais adiante.
Recompensa é o feedback numérico que o agente recebe após executar uma ação. Se o aspirador limpa um trecho novo do piso, pode ganhar +1. Se bate na parede, pode receber -1.
O objetivo do agente é maximizar a recompensa total ao longo do tempo, não apenas a recompensa da próxima ação.
Política é a estratégia do agente para mapear estados, ou observações, em ações. É o conjunto de regras que ele segue para decidir o que fazer a seguir.
A política pode ser determinística, sempre escolhendo a mesma ação para um estado, ou estocástica, escolhendo ações com base em uma distribuição de probabilidade. Algoritmos de RL profundo geralmente usam uma rede neural para representar essa política.
A função de valor estima quanta recompensa futura o agente pode esperar coletar a partir de um estado, se continuar seguindo a política atual.
A função Q faz o mesmo para um par estado-ação. Ela estima a recompensa futura de tomar uma ação específica em um estado específico, e depois seguir a política.
Esse é o tipo de função que uma rede neural é boa em aproximar. É a mesma ideia que apresentei quando troquei a tabela de consulta mais acima.
Um episódio é uma execução completa do agente no ambiente, do estado inicial até alguma condição de término. Para o aspirador, pode ser quando o cômodo fica limpo ou a bateria acaba.
Quando o episódio termina, o ambiente é reiniciado e um novo começa.
Um agente que só repete o que já funcionou nunca vai descobrir algo melhor.
Pense no aspirador. Ele encontra um trajeto que limpa uma parte razoável do cômodo e passa a repetir esse caminho sempre. Nunca verifica o canto atrás do sofá. Esse é o trade-off central do aprendizado por reforço:
Uma forma comum de equilibrar os dois é a exploração epsilon-greedy. A cada passo, o agente escolhe uma ação aleatória com probabilidade epsilon, um número pequeno como 0,1, e caso contrário escolhe a ação que acredita ser a melhor. Muitos algoritmos fazem o decaimento de epsilon ao longo do tempo: exploram bastante no início e depois passam a explorar menos quando já aprenderam o suficiente para confiar no próprio julgamento.
Não existe um epsilon fixo que funcione para todo ambiente.
Explorar demais perde tempo em ações que continuam falhando. Explorar de menos faz o agente se contentar com uma estratégia mediana enquanto uma melhor está logo ao lado, não descoberta. Acertar esse equilíbrio fica ainda mais difícil conforme o ambiente se complica, especialmente quando uma ação ruim no começo só mostra seu custo real vários passos depois.
Todo algoritmo de RL profundo cai em uma de três famílias, com base no que ele aprende: uma função de valor, uma política ou ambos ao mesmo tempo.
DQN pega a função Q apresentada antes e troca a tabela por uma rede neural. A rede recebe um estado como entrada e gera um Q-value para cada ação possível, aprendendo como qualquer rede neural padrão aprende.
Treinar essa rede diretamente não é recomendado. Experiências consecutivas são correlacionadas, o que leva a overfitting no que a rede acabou de ver, e o alvo que ela persegue muda a cada atualização da própria rede.
DQN resolve os dois problemas:
DQN foi importante por ser o primeiro algoritmo a aprender políticas de controle diretamente de pixels crus em vários jogos do Atari, usando a mesma arquitetura e hiperparâmetros para todos. Quando a DeepMind publicou em 2015, provou que deep learning e aprendizado por reforço podiam funcionar juntos em escala, sem recursos feitos à mão para cada jogo.
Em vez de aprender uma função de valor e escolher ações com base nela, métodos de gradiente de política aprendem a própria política. A rede recebe um estado e gera probabilidades das ações, e o agente amostra uma ação dessa distribuição.
Essa abordagem se encaixa em ações contínuas ou estocásticas.
Um método baseado em valor precisa checar todas as ações possíveis para achar a melhor, o que quebra assim que o espaço de ação vira contínuo — não dá para percorrer um intervalo infinito de ângulos de direção. Um método de gradiente de política simplesmente amostra da distribuição, não importa quantas ações existam.
REINFORCE é o algoritmo fundamental aqui. Ele roda um episódio completo e então aumenta a probabilidade das ações que levaram a alta recompensa total e diminui a probabilidade das que levaram a baixa recompensa total. O porém é que só atualiza após o fim do episódio e depende do retorno total, o que torna as atualizações ruidosas e inconsistentes de um episódio para outro.
Métodos ator-crítico reduzem o ruído do REINFORCE adicionando uma segunda rede.
O ator é a política — escolhe ações como um método de gradiente de política faria. O crítico é uma função de valor que julga cada ação logo após ela acontecer, em vez de esperar o episódio terminar.
É a junção das abordagens baseada em valor e baseada em política. O ator ainda aprende uma política, mas atualiza com base no julgamento do crítico para cada ação, e não no retorno atrasado e ruidoso de que o REINFORCE depende.
A2C e A3C são os exemplos clássicos. A2C roda algumas cópias do ambiente em paralelo e atualiza ator e crítico juntos a cada lote. A3C roda essas cópias de forma assíncrona, em que cada uma atualiza a rede compartilhada no seu próprio ritmo, sem esperar as outras.
Atualizações de gradiente de política podem dar errado se forem grandes demais. Uma atualização muito grande pode arruinar uma política que estava indo bem — e não há como desfazer depois.
PPO limita o tamanho de cada atualização para evitar isso. Eis o objetivo recortado (clipped) que ele otimiza:
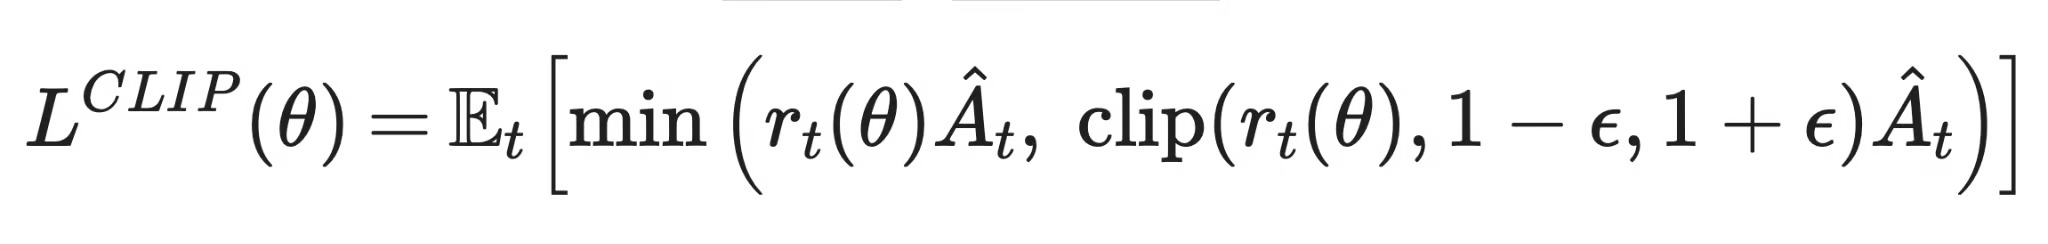
Proximal policy optimization
r_t(θ) é a razão entre a probabilidade da nova política para uma ação e a probabilidade da política antiga para a mesma ação. Â_t é a vantagem (advantage), ou quanto aquela ação se saiu melhor do que a expectativa de base do crítico. A função clip() mantém a razão dentro de uma faixa estreita em torno de 1, para que a política não mude demais em um único passo. O min() escolhe a estimativa mais conservadora, evitando que uma vantagem incomumente grande empurre a atualização além do permitido pelo clip.
A OpenAI apresentou o PPO em 2017, e ele virou escolha padrão rapidamente. É mais simples de implementar e ajustar do que os métodos de região de confiança que vieram antes, e funciona bem em vários ambientes com pouca adaptação por tarefa.
DDPG e Soft Actor-Critic (SAC) focam problemas de controle contínuo, como ângulos de juntas robóticas ou valores de direção, em que o agente precisa gerar um número específico em vez de escolher de uma distribuição.
DDPG é um método ator-crítico cujo ator gera uma ação determinística única em vez de uma distribuição, e ele aproveita replay de experiências e redes-alvo do DQN.
SAC amplia a mesma ideia, mas adiciona um termo de entropia que recompensa a política por se manter um pouco aleatória, o que prolonga a exploração e tende a tornar o treinamento mais estável do que no DDPG.
Métodos baseados em valor, como DQN, aprendem uma função Q e escolhem a ação com maior nota. Funcionam bem para espaços de ação discretos e tiram boa eficiência de amostragem do replay de experiências, mas não se estendem a ações contínuas sem esforço extra.
Métodos baseados em política, como REINFORCE, aprendem a política diretamente, amostrando ações de uma distribuição de probabilidade. É isso que os faz funcionar com ações contínuas e estocásticas, mas atualizações puras de gradiente de política são ruidosas e exigem dados novos a cada atualização.
Métodos ator-crítico, incluindo A2C/A3C, PPO, DDPG e SAC, combinam as duas ideias. O feedback rápido do crítico estabiliza as atualizações do ator — por isso a maioria dos algoritmos usados na prática hoje cai nessa categoria.
Aqui vai uma comparação mais visual:
| O que é aprendido | Como as ações são selecionadas | Discreto vs. contínuo | Estabilidade | Eficiência de amostragem | Algoritmos representativos | |
|---|---|---|---|---|---|---|
| Baseado em valor | Função Q | Ação com maior nota | Discreto | Precisa de redes-alvo e replay para se manter estável | Boa, graças ao replay de experiências | DQN |
| Baseado em política | Política | Amostrada da distribuição da política | Ambos, melhor com contínuo | Atualizações ruidosas, alta variância | Fraca, precisa de dados novos a cada atualização | REINFORCE |
| Ator-crítico | Política e função de valor | Amostrada do ator, guiada pelo crítico | Ambos | Mais estável do que métodos puramente baseados em política | Melhor do que métodos puramente baseados em política | A2C/A3C, PPO, DDPG, SAC |
Comparação de métodos de aprendizado por reforço profundo
Aprendizado supervisionado recebe uma resposta rotulada para cada exemplo. RL profundo precisa descobrir o que funcionou a partir de um sinal de recompensa que chega atrasado, misturado com as ações anteriores, e às vezes nem aparece de forma útil.
Agentes de RL profundo costumam precisar de milhões de passos no ambiente antes de aprenderem algo útil, especialmente se comparados ao pouco dado que um modelo supervisionado precisa para obter precisão semelhante em um dataset fixo.
Isso acontece porque o agente precisa gerar seus próprios dados de treino ao agir — e a maioria dessas ações no começo é quase aleatória. Um modelo supervisionado pode reutilizar o mesmo conjunto de dados rotulados várias vezes. Um agente de RL precisa continuar explorando um ambiente que mal entende, passo a passo.
Treinar RL costuma ser instável.
Parte do problema é que funções de valor se baseiam nas próprias estimativas: o alvo do Q-value de hoje depende do palpite de Q de ontem. Se o palpite estava errado, o erro se acumula em vez de se corrigir. Além disso, a política do agente muda conforme ele aprende, então os dados que coleta também mudam.
Em outras palavras, a rede persegue um alvo móvel em duas frentes ao mesmo tempo.
Alguns ambientes só entregam uma recompensa no final, como um sinal de vitória ou derrota após um jogo longo. O agente precisa trabalhar de trás para frente a partir desse número único e descobrir quais das dezenas de ações realmente importaram.
Isso é o problema de atribuição de crédito, e piora quanto maior o atraso entre a ação e sua consequência.
Parecido com algo simples — até você tentar fazer.
Um exemplo famoso: um agente de corrida de barco treinado pela OpenAI recebia recompensa por passar em checkpoints, então encontrou uma lagoa com power-ups que reapareciam e ficou dando voltas para sempre, acumulando pontos sem nunca terminar a corrida. A função de recompensa fez exatamente o que mandaram — o agente é que não foi instruído sobre o que “vencer” realmente significava. Essa diferença entre o que você recompensa e o que você realmente quer se chama reward hacking e costuma aparecer, de alguma forma, em quase toda função de recompensa que você escreve.
O mesmo algoritmo, com uma semente aleatória diferente, pode produzir resultados diferentes.
Resultados publicados são difíceis de reproduzir sem o código exato, hiperparâmetros e sementes usados pelos pesquisadores originais. Detalhes pequenos de implementação, como a forma de normalizar observações ou inicializar o replay buffer, podem mudar o desempenho mais do que a escolha do algoritmo.
Um simulador permite que o agente falhe à vontade, quantas vezes forem necessárias. O mundo real não é assim.
Por exemplo, uma política de direção autônoma que explora uma ação ruim em uma rodovia coloca pessoas em risco. Simuladores nunca capturam o mundo real com perfeição — casos extremos que não foram modelados aparecem assim que a política sai do laboratório. Uma política que parece ótima na simulação pode falhar de formas inesperadas no ambiente real. Por isso, implantar RL profundo fora de jogos e simuladores exige muito mais cautela do que os números de benchmark sugerem.
Agora vou destacar as diferenças entre aprendizado por reforço profundo e abordagens mais tradicionais.
Aprendizado supervisionado treina com exemplos rotulados, em que cada entrada já tem uma resposta correta. RL profundo nunca recebe isso — só recebe uma recompensa depois de agir e precisa descobrir sozinho quais ações levaram a essa recompensa.
Aprendizado por imitação treina uma política para copiar demonstrações de um especialista, sem usar sinal de recompensa. RL profundo descobre o comportamento por tentativa e erro.
Imitação coloca uma política para rodar rapidamente, mas fica limitada à qualidade das demonstrações e sofre quando o agente cai numa situação que o especialista nunca mostrou. RL profundo pode, em teoria, superar qualquer professor, mas exige muito mais interação e uma função de recompensa que aponte de fato para o comportamento desejado.
Algoritmos evolutivos otimizam uma política mutando uma população de candidatos e mantendo os que se saem melhor, sem computar gradientes. RL profundo computa gradientes a partir do sinal de recompensa e atualiza uma única política.
Métodos evolutivos paralelizam bem, já que cada candidato pode rodar de forma independente. Mas, em geral, precisam de muito mais interações totais com o ambiente do que métodos baseados em gradiente para atingir o mesmo nível de desempenho.
RL profundo pune atalhos mais do que a maioria das áreas. Com isso em mente, aqui vão algumas boas práticas para seu próximo projeto:
O aprendizado por reforço profundo pega o loop de tentativa e erro do RL e combina com uma rede neural que consegue lidar com estados impossíveis para qualquer tabela.
Cada algoritmo deste artigo cai em uma de três famílias. Métodos baseados em valor, como DQN, aprendem uma função Q e escolhem a ação com maior nota. Métodos baseados em política, como REINFORCE, aprendem a política diretamente. Métodos ator-crítico, como PPO, combinam os dois — e essa combinação é o que a maioria dos algoritmos atuais usa.
Só lembre que nada disso é de graça.
Estabilidade de treino, eficiência de amostragem, design de recompensas e reprodutibilidade ficam mais difíceis no momento em que você sai da tabela e vai para a rede. Se quiser se aprofundar, Q-learning e reinforcement learning cobrem as bases em que este artigo se apoia, e DQN e PPO são ótimos próximos passos para estudar os próprios algoritmos.
Aprenda com a DataCamp
Curso
Curso
Programa
blog
Abid Ali Awan
9 min
blog
Yolanda Ferreiro
7 min
Tutorial
Zoumana Keita
14 min
Tutorial
Bharath K
13 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Zoumana Keita
14 min