course
Understanding Artificial Intelligence
2 घंटा
421.1K
पारंपरिक रिइनफोर्समेंट लर्निंग तब ठीक से काम नहीं करती जब आपका परिवेश इतना बड़ा हो जाए कि उसे हाथ से ट्रैक करना मुश्किल हो। कारण यह है कि हर अवस्था के लिए तालिका में एक अलग प्रविष्टि चाहिए, और हर अवस्था से हर क्रिया के लिए अलग-अलग मान चाहिए।
उदाहरण के लिए, किसी गेम की स्क्रीन लाखों पिक्सेल संयोजन बनाती है, जो किसी ऐसी तालिका में समा ही नहीं सकते जिसे आप लूप कर सकें। एजेंट को उन अवस्थाओं के आधार पर, जो मिलती-जुलती दिखती हैं, पहले कभी न देखी गई अवस्था का मान अनुमान लगाना पड़ता है।
डीप रिइनफोर्समेंट लर्निंग इसे एक न्यूरल नेटवर्क से तालिका को बदलकर ठीक करती है, जो किसी अवस्था का मूल्य या उठाने के लिए सर्वोत्तम क्रिया का अनुमान लगाता है—भले ही वह स्थिति पहले सीधे अनुभव न हुई हो। यही वह चीज़ है जो एजेंटों को गो जैसे खेलों में महारत दिलाती है और सिम्युलेटेड ड्रोन उड़ाने देती है—ऐसे कार्य जो किसी भी क्लासिक RL एल्गोरिदम को ठप्प कर दें।
इस लेख में, मैं आपको डीप RL की मुख्य अवधारणाएँ, DQN और PPO जैसे प्रमुख एल्गोरिदम परिवार, और उनके वास्तविक दुनिया के उपयोगों से परिचित कराऊँगा।
यदि आप रिइनफोर्समेंट लर्निंग में नए हैं, तो हमारे Reinforcement Learning in Python ट्रैक में दाखिला लें और सप्ताहांत में ही मूल बातें मज़बूत करें।
डीप रिइनफोर्समेंट लर्निंग में रिइनफोर्समेंट लर्निंग के लुकअप टेबल की जगह एक न्यूरल नेटवर्क लेता है।
रिइनफोर्समेंट लर्निंग पहले से ही वह मूल लूप देती है जिसमें एजेंट कोई क्रिया आज़माता है, नतीजा देखता है, और इनाम के आधार पर समायोजित करता है। डीप लर्निंग एक ऐसा नेटवर्क जोड़ती है जो कच्चे इनपुट को उस रूप में बदल दे जिसे एजेंट परखे। साथ आने पर, एजेंट कच्चे डेटा से ही सीखता है कि कौन-सी क्रियाएँ सबसे बेहतर काम करती हैं—बिना किसी के हर अवस्था का अर्थ हाथ से कोड किए।
मान लीजिए आप किसी एजेंट को Breakout जैसा खेल खेलने के लिए प्रशिक्षित कर रहे हैं। एजेंट को “गेंद की स्थिति” या “पैडल की स्थिति” की साफ़ सूची नहीं मिलती—उसे स्क्रीन से कच्चे पिक्सेल मिलते हैं। एक टेब्युलर विधि को हर संभावित पिक्सेल संयोजन के लिए अलग पंक्ति चाहिए होगी, और वह संख्या संभाल से बाहर है। एक न्यूरल नेटवर्क सीधे पिक्सेल देखता है और बताता है कि कौन-सी क्रिया करनी है, या हर क्रिया कितनी अच्छी लगती है—भले ही उसने वह सटीक स्क्रीन पहले कभी न देखी हो।
संक्षेप में, टेब्युलर विधियाँ याद करती हैं, और नेटवर्क सामान्यीकरण करते हैं।
यही वह बात है जो डीप RL को उन परिवेशों में काम करने देती है जो तालिका के बस में नहीं हैं—बहुत बड़े या बहुत उलझे हुए।
हर डीप RL सिस्टम एक ही लूप चलाता है, भले ही भीतर कौन-सा एल्गोरिदम हो।
यह क्रम इस प्रकार चलता है:
नीचे का चित्र यह लूप चलते हुए दिखाता है:
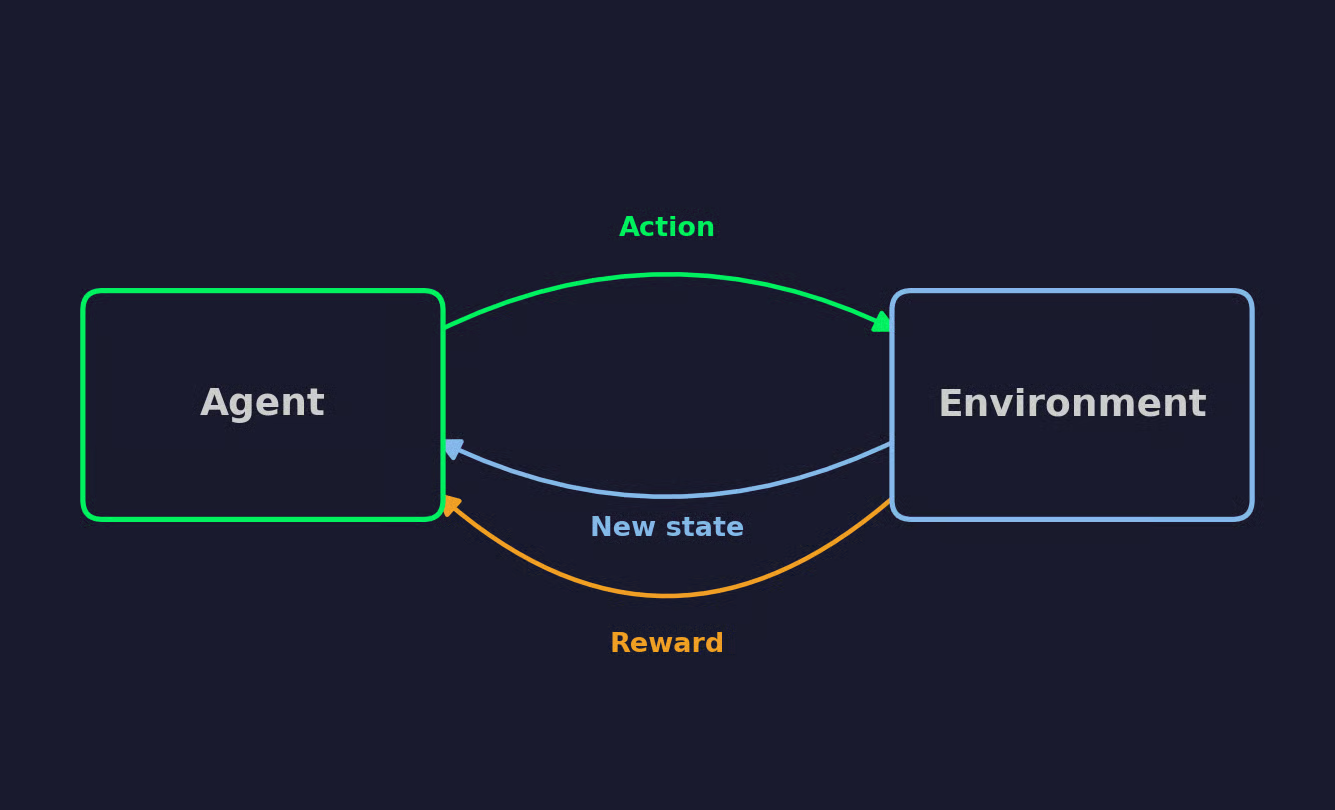
रिइनफोर्समेंट लर्निंग लूप
यदि आप इस लूप को पर्याप्त बार दोहराते हैं, तो एजेंट का व्यवहार उन क्रियाओं की ओर खिसक जाएगा जो इनाम को लगातार अधिकतम करती हैं।
हर डीप RL एल्गोरिदम एक ही सात विचारों पर बना है। यदि आप इनके साथ सहज हो जाएँगे, तो लेख का बाकी हिस्सा और अधिक स्पष्ट लगेगा।
एक रोबोट वैक्यूम की कल्पना कीजिए जो कमरा साफ करना सीख रहा है। मैं नीचे दिए गए हर शब्द में उसी उदाहरण का उपयोग करूँगा।
एजेंट निर्णय लेने वाला है—हमारे उदाहरण में रोबोट वैक्यूम। परिवेश वह सब कुछ है जिसके साथ वह अंतःक्रिया करता है, जैसे कमरा, फर्नीचर, धूल-मिट्टी, वे दीवारें जिनसे वह टकरा सकता है।
एजेंट परिवेश को नियंत्रित नहीं करता, पर वह क्रियाएँ चुनता है, और परिवेश तय करता है कि आगे क्या होगा।
अवस्था किसी क्षण में परिवेश की पूरी स्थिति का वर्णन करती है, जैसे हर धूल के धब्बे की सटीक स्थिति और वैक्यूम का स्थान। वास्तविक एजेंटों को शायद ही कभी इसका निश्चित रूप से एक्सेस मिलता है।
इसके बजाय वे अवलोकन पर काम करते हैं—जो एजेंट वास्तव में देख सकता है, जैसे कैमरा फ़ीड या प्रॉक्सिमिटी सेंसरों का सेट।
सरल परिवेशों में अवलोकन और अवस्था लगभग एक ही चीज़ होते हैं। अधिक जटिल परिवेशों में एजेंट आंशिक जानकारी के साथ काम करता है और खाली जगहों को भरना पड़ता है।
क्रियाएँ वे चालें हैं जो किसी क्षण एजेंट के लिए उपलब्ध हैं। वैक्यूम के लिए, इसका अर्थ आगे बढ़ना, बाएँ मुड़ना, दाएँ मुड़ना, या सक्शन सक्रिय करना हो सकता है।
क्रियाएँ डिस्क्रीट हो सकती हैं, जहाँ एजेंट एक तय सूची से चुनता है, या सतत (continuous), जहाँ एजेंट किसी दायरे के साथ एक मान चुनता है, जैसे स्टीयरिंग एंगल। यह अंतर आगे दिए गए अलग-अलग एल्गोरिदम परिवारों तक पहुँचते ही बहुत मायने रखता है।
इनाम वह संख्यात्मक फीडबैक है जो एजेंट को कोई क्रिया करने के बाद मिलता है। यदि वैक्यूम फ़र्श का नया हिस्सा साफ करता है, तो उसे +1 का इनाम मिल सकता है। लेकिन जब वह दीवार से टकराता है, तो -1 मिल सकता है।
एजेंट का पूरा लक्ष्य समय के साथ एकत्रित कुल इनाम को अधिकतम करना है, न कि सिर्फ अगली एकल क्रिया का इनाम।
नीति वह रणनीति है जिसके द्वारा एजेंट अवस्थाओं या अवलोकनों को क्रियाओं से मैप करता है। यही वह नियम-पुस्तिका है जिसका पालन एजेंट अगला कदम तय करने में करता है।
नीति निर्धारक (deterministic) हो सकती है, जो किसी दी गई अवस्था के लिए हमेशा वही क्रिया चुनती है, या स्टोकेस्टिक, जो प्रायिकता वितरण के आधार पर क्रियाएँ चुनती है। डीप RL एल्गोरिदम अक्सर इस नीति को दर्शाने के लिए न्यूरल नेटवर्क का उपयोग करते हैं।
वैल्यू फ़ंक्शन यह अनुमान लगाता है कि एजेंट किसी दी गई अवस्था से, अपनी वर्तमान नीति का पालन करते हुए, कितना भविष्य का इनाम एकत्र कर सकता है।
Q-वैल्यू फ़ंक्शन यही काम अवस्था-क्रिया युग्म के लिए करता है। यह किसी विशिष्ट अवस्था में कोई विशिष्ट क्रिया करने के बाद, फिर नीति का पालन करते हुए, मिलने वाले भविष्य के इनाम का अनुमान लगाता है।
ऐसे फ़ंक्शन का सन्निकटन करने में एक न्यूरल नेटवर्क अच्छा होता है। यही वही विचार है जिसका ज़िक्र मैंने लेख की शुरुआत में लुकअप टेबल बदलते समय किया था।
एपिसोड एजेंट का परिवेश में एक पूरा रन है—आरंभिक अवस्था से लेकर किसी समापन शर्त तक। वैक्यूम के लिए इसका अर्थ हो सकता है कि कमरा पूरी तरह साफ हो जाए या बैटरी खत्म हो जाए।
एक एपिसोड समाप्त होने के बाद, परिवेश रीसेट होता है और नया एपिसोड शुरू होता है।
जो एजेंट सिर्फ वही दोहराता है जो पहले काम कर चुका है, वह कभी बेहतर चीज़ नहीं खोज पाएगा।
फिर से वैक्यूम की कल्पना करें। उसे एक ऐसा रास्ता मिल गया जो कमरे का एक अच्छा-खासा हिस्सा साफ कर देता है, और वह हर बार वही रास्ता दोहराता रहता है। वह सोफ़े के पीछे के कोने को कभी नहीं जाँचता। यही वह संतुलन-समस्या है जो रिइनफोर्समेंट लर्निंग के केंद्र में है:
दोनों के बीच संतुलन बैठाने का एक आम तरीका है एप्सिलॉन-ग्रीडी एक्सप्लोरेशन। हर कदम पर, एजेंट एप्सिलॉन (जैसे 0.1) की प्रायिकता से एक रैंडम क्रिया चुनता है, और अन्यथा वह क्रिया चुनता है जिसे वह इस समय सबसे अच्छा मानता है। कई एल्गोरिदम समय के साथ एप्सिलॉन घटाते हैं—शुरुआत में एजेंट अधिक एक्सप्लोर करता है, फिर पर्याप्त सीख लेने के बाद अपने ही निर्णय पर ज़्यादा भरोसा करने लगता है।
हर परिवेश के लिए कोई तय एप्सिलॉन नहीं चलता।
बहुत ज़्यादा एक्सप्लोरेशन विफल होती क्रियाओं पर समय बर्बाद करता है। बहुत कम एक्सप्लोरेशन का मतलब है कि एजेंट एक ठीक-ठाक रणनीति पर ही ठहर जाता है, जबकि उसके पास ही कोई बेहतर रणनीति अनदेखी पड़ी होती है। जैसे-जैसे परिवेश जटिल होता जाता है, यह संतुलन बैठाना और कठिन हो जाता है—खासकर जब किसी शुरुआती बुरी क्रिया की असली कीमत कई कदम बाद सामने आती है।
हर डीप RL एल्गोरिदम तीन परिवारों में से किसी एक में आता है—इस आधार पर कि वह वास्तव में क्या सीखता है: एक वैल्यू फ़ंक्शन, एक नीति, या दोनों साथ में।
DQN इस लेख में पहले वर्णित Q-वैल्यू फ़ंक्शन लेता है और लुकअप टेबल की जगह एक न्यूरल नेटवर्क लगा देता है। नेटवर्क इनपुट में अवस्था लेता है और हर संभावित क्रिया के लिए Q-वैल्यू आउटपुट करता है—ठीक उसी तरह सीखा जाता है जैसे एक मानक न्यूरल नेटवर्क और चीज़ें सीखता है।
उस नेटवर्क को सीधे प्रशिक्षित करना अनुशंसित नहीं है। क्रमिक अनुभव आपस में सहसम्बद्ध होते हैं, जिससे नेटवर्क उसी पर ओवरफ़िट कर देता है जो उसने अभी-अभी देखा है, और जिस लक्ष्य का वह पीछा कर रहा है, वह नेटवर्क के हर अपडेट के साथ बदलता रहता है।
DQN दोनों समस्याएँ ठीक करता है:
DQN अहम इसलिए था क्योंकि यह पहला एल्गोरिदम था जिसने कच्चे पिक्सेल से सीधे, व्यापक Atari खेलों में नियंत्रण नीतियाँ सीखी—हर खेल के लिए वही आर्किटेक्चर और हाइपरपैरामीटर इस्तेमाल करते हुए। 2015 में DeepMind ने जब इसे प्रकाशित किया, तो यह साबित हुआ कि डीप लर्निंग और रिइनफोर्समेंट लर्निंग बड़े पैमाने पर एक साथ काम कर सकते हैं—बिना हर खेल के लिए हैंड-क्राफ़्टेड फीचर्स के।
वैल्यू फ़ंक्शन सीखकर उस पर आधारित क्रिया चुनने के बजाय, पॉलिसी ग्रेडिएंट विधियाँ नीति को ही सीखती हैं। नेटवर्क अवस्था लेता है और क्रियाओं की प्रायिकताएँ आउटपुट करता है, और एजेंट उसी वितरण से एक क्रिया सैंपल करता है।
यह दृष्टिकोण सतत या स्टोकेस्टिक क्रियाओं के अनुकूल है।
वैल्यू-आधारित विधि को सर्वश्रेष्ठ क्रिया खोजने के लिए हर संभावित क्रिया जाँचना पड़ता है—जैसे ही क्रिया-स्पेस सतत हो जाता है, यह टूट जाता है; आप स्टीयरिंग एंगल के अनंत दायरे में लूप नहीं कर सकते। पॉलिसी ग्रेडिएंट विधि बस वितरण से सैंपल कर लेती है, भले ही क्रियाओं की संख्या कितनी भी हो।
REINFORCE यहाँ का बुनियादी एल्गोरिदम है। यह पूरा एपिसोड चलाता है, फिर उन क्रियाओं की प्रायिकता बढ़ाता है जिनसे कुल इनाम अधिक मिला और उन क्रियाओं की घटाता है जिनसे कम इनाम मिला। पेंच यह है कि यह अपडेट सिर्फ एपिसोड के अंत में करता है, और पूरे रिटर्न पर निर्भर करता है, जिससे इसके अपडेट शोरयुक्त हो जाते हैं और एक एपिसोड से अगले तक असंगत रहते हैं।
एक्टर-क्रिटिक विधियाँ REINFORCE के शोर की समस्या को दूसरा नेटवर्क जोड़कर ठीक करती हैं।
एक्टर नीति है—यह क्रियाएँ उसी तरह चुनता है जैसे कोई पॉलिसी ग्रेडिएंट विधि। क्रिटिक एक वैल्यू फ़ंक्शन है जो हर क्रिया का आकलन उसी समय कर देता है, बजाय इसके कि एपिसोड के खत्म होने का इंतज़ार करे।
यह वैल्यू-आधारित और पॉलिसी-आधारित दृष्टिकोणों का साथ काम करना है। एक्टर अब भी नीति सीखता है, लेकिन उसका अपडेट हर क्रिया पर क्रिटिक के आकलन के आधार पर होता है—न कि विलंबित, शोरयुक्त रिटर्न पर जिस पर REINFORCE निर्भर करता है।
A2C और A3C मानक उदाहरण हैं। A2C कुछ परिवेश प्रतियों को समानांतर में चलाता है और हर बैच के ख़त्म होने पर एक्टर और क्रिटिक दोनों को साथ अपडेट करता है। A3C उन प्रतियों को एसिंक्रोनस चलाता है, जहाँ हर प्रति साझा नेटवर्क को अपने समय पर अपडेट करती है, दूसरों का इंतज़ार किए बिना।
यदि आप पॉलिसी ग्रेडिएंट अपडेट बहुत बड़े होने दें, तो वे बिगड़ सकते हैं। पर्याप्त बड़ा अपडेट एक ठीक-ठाक चल रही नीति को चौपट कर सकता है, और एक बार ऐसा हो जाए तो उसे वापस नहीं लिया जा सकता।
PPO हर अपडेट के आकार को सीमित करके इससे बचाता है। यह है उसका क्लिप्ड आब्जेक्टिव जिसे वह ऑप्टिमाइज़ करता है:
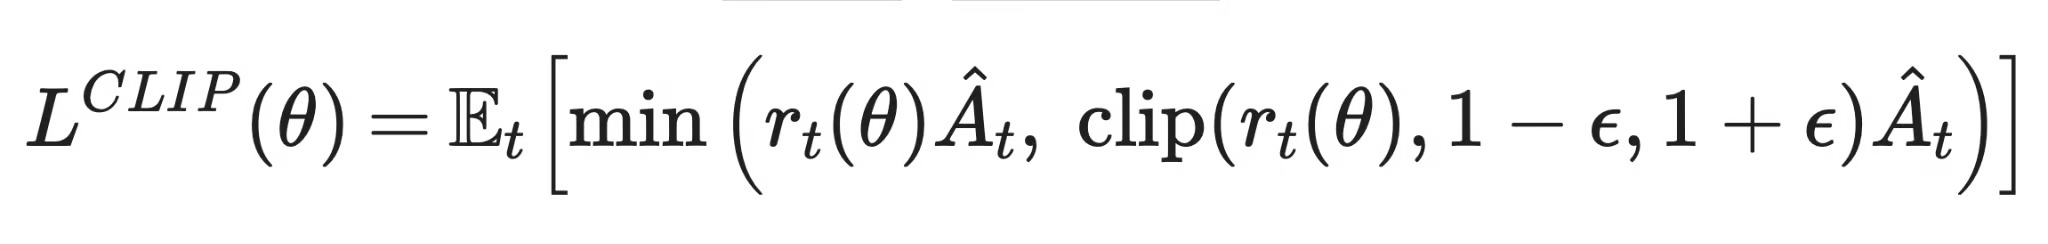
प्रॉक्सिमल पॉलिसी ऑप्टिमाइज़ेशन
r_t(θ) वह अनुपात है जो नई नीति में किसी क्रिया की प्रायिकता और पुरानी नीति में उसी क्रिया की प्रायिकता के बीच होता है। Â_t एडवांटेज है—या वह माप कि वह क्रिया क्रिटिक की बेसलाइन अपेक्षा की तुलना में कितनी बेहतर निकली। clip() फ़ंक्शन अनुपात को 1 के आसपास एक संकीर्ण दायरे में रखता है, ताकि नीति एक ही कदम में बहुत दूर न खिसक सके। इसके बाद min() दोनों अनुमानों में से अधिक रूढ़िवादी को चुनता है, ताकि असामान्य रूप से बड़ा एडवांटेज अनुमान भी अपडेट को क्लिप से आगे न धकेल सके।
OpenAI ने 2017 में PPO पेश किया, और यह लगभग तुरंत ही डिफ़ॉल्ट पसंद बन गया। यह अपने पहले के ट्रस्ट-रीजन तरीकों की तुलना में लागू करने और ट्यून करने में आसान है, और बिना बहुत अधिक प्रति-कार्य समायोजन के विभिन्न परिवेशों में टिकाऊ प्रदर्शन देता है।
DDPG और Soft Actor-Critic (SAC) दोनों सतत-नियंत्रण समस्याओं को लक्षित करते हैं, जैसे रोबोटिक जॉइंट एंगल्स या स्टीयरिंग मान, जहाँ एजेंट को वितरण से चुनने की बजाय एक विशिष्ट संख्या आउटपुट करनी होती है।
DDPG एक एक्टर-क्रिटिक विधि है जिसमें एक्टर वितरण की बजाय एक एकल निर्धारक क्रिया आउटपुट करता है, और यह DQN से एक्सपीरियंस रिप्ले और टार्गेट नेटवर्क्स उधार लेता है।
SAC उसी विचार पर आधारित है, लेकिन इसमें एक एंट्रॉपी टर्म जोड़ता है जो नीति को कुछ हद तक रैंडम रहने के लिए पुरस्कृत करता है, जिससे एजेंट लंबे समय तक एक्सप्लोर करता रहता है और आम तौर पर DDPG की तुलना में प्रशिक्षण अधिक स्थिर होता है।
वैल्यू-आधारित विधियाँ, जैसे DQN, Q-वैल्यू फ़ंक्शन सीखती हैं और वही क्रिया चुनती हैं जिसे वह सबसे ऊँचा रेट देती हैं। यह डिस्क्रीट क्रिया-स्पेस के लिए अच्छा काम करता है और एक्सपीरियंस रिप्ले की बदौलत अच्छे सैंपल-इफ़िशिएंसी देता है, लेकिन बिना अतिरिक्त काम के सतत क्रियाओं तक नहीं फैलता।
पॉलिसी-आधारित विधियाँ जैसे REINFORCE नीति को सीधे सीखती हैं, और नीति के वितरण से क्रियाएँ सैंपल करती हैं। इसी वजह से वे सतत और स्टोकेस्टिक क्रियाओं के साथ काम करती हैं, लेकिन साधारण पॉलिसी ग्रेडिएंट अपडेट शोरयुक्त होते हैं और हर अपडेट के लिए नए डेटा की ज़रूरत होती है।
एक्टर-क्रिटिक विधियाँ, जिनमें A2C/A3C, PPO, DDPG और SAC शामिल हैं, दोनों विचारों को जोड़ती हैं। क्रिटिक का तेज़ फ़ीडबैक एक्टर के अपडेट को स्थिर करता है, इसी कारण आज व्यवहार में उपयोग किए जाने वाले अधिकांश एल्गोरिदम इसी श्रेणी में आते हैं।
यहाँ एक अधिक दृश्य तुलना है:
| क्या सीखा जाता है | क्रियाएँ कैसे चुनी जाती हैं | डिस्क्रीट बनाम सतत | स्थिरता | सैंपल दक्षता | प्रतिनिधि एल्गोरिदम | |
|---|---|---|---|---|---|---|
| वैल्यू-आधारित | Q-वैल्यू फ़ंक्शन | सबसे ऊँचा-रेटेड एक्शन | डिस्क्रीट | स्थिर रहने के लिए टार्गेट नेटवर्क्स और रिप्ले की ज़रूरत | अच्छी, एक्सपीरियंस रिप्ले के कारण | DQN |
| पॉलिसी-आधारित | नीति | नीति के वितरण से सैंपल | दोनों, सतत में सर्वश्रेष्ठ | शोरयुक्त, उच्च-वैरिएंस अपडेट | कमज़ोर, हर अपडेट के लिए नया डेटा चाहिए | REINFORCE |
| एक्टर-क्रिटिक | नीति और वैल्यू फ़ंक्शन | क्रिटिक के मार्गदर्शन में एक्टर से सैंपल | दोनों | शुद्ध पॉलिसी-आधारित विधियों से अधिक स्थिर | शुद्ध पॉलिसी-आधारित विधियों से बेहतर | A2C/A3C, PPO, DDPG, SAC |
डीप रिइनफोर्समेंट लर्निंग विधियों की तुलना
सुपरवाइज़्ड लर्निंग हर उदाहरण के लिए लेबलयुक्त उत्तर लाती है। डीप RL को यह खुद समझना पड़ता है कि क्या काम किया—उस इनाम संकेत से जो देर से आता है, पिछले कदमों की क्रियाओं के साथ घुल-मिल जाता है, और कभी-कभी किसी उपयोगी रूप में आता ही नहीं।
डीप RL एजेंटों को अक्सर कुछ उपयोगी सीखने से पहले ही लाखों परिवेश कदमों की ज़रूरत होती है—खासकर उस डेटा मात्रा की तुलना में जो किसी सुपरवाइज़्ड मॉडल को समान सटीकता पाने के लिए चाहिए।
कारण यह है कि एजेंट को क्रिया करके अपना प्रशिक्षण डेटा खुद बनाना पड़ता है—और शुरुआत की अधिकांश क्रियाएँ लगभग रैंडम होती हैं। सुपरवाइज़्ड मॉडल बार-बार वही लेबलयुक्त डेटासेट पुन: उपयोग कर सकता है। RL एजेंट को किसी ऐसे परिवेश में लगातार एक्सप्लोर करना पड़ता है जिसे वह मुश्किल से समझता है—एक-एक कदम करके।
RL प्रशिक्षण अक्सर अस्थिर होता है।
समस्या का एक हिस्सा यह है कि वैल्यू फ़ंक्शन अपने ही अनुमानों पर टिका होता है—आज का Q-वैल्यू लक्ष्य कल के Q-वैल्यू अनुमान पर निर्भर होता है। यदि वह अनुमान गलत है, तो त्रुटि स्वयं को सुधारने के बजाय बढ़ती जाती है। ऊपर से, एजेंट की नीति सीखते-सीखते बदलती रहती है, इसलिए वह जो डेटा इकट्ठा करता है, वह भी बदलता रहता है।
दूसरे शब्दों में, नेटवर्क एक साथ दो मोर्चों पर बदलते लक्ष्य का पीछा कर रहा है।
कुछ परिवेश सिर्फ अंत में इनाम देते हैं—जैसे लंबे खेल के बाद जीत या हार का संकेत। एजेंट को उस एक संख्या से पीछे की ओर काम करके समझना होता है कि उसके उठाए गए ढेरों कदमों में से वास्तव में कौन-से मायने रखते थे।
इसे क्रेडिट असाइनमेंट समस्या कहते हैं—और जैसे-जैसे किसी क्रिया और उसके परिणाम के बीच विलंब बढ़ता है, यह समस्या और बदतर होती जाती है।
इनाम डिज़ाइन आसान लगता है—जब तक आप इसे आज़माते नहीं।
यहाँ एक मशहूर उदाहरण है। OpenAI द्वारा प्रशिक्षित बोट-रेसिंग एजेंट को चेकपॉइंट हिट करने पर इनाम मिलता था, तो उसने एक लैगून ढूँढा जहाँ पावर-अप्स फिर-फिर से आते थे, और वह वहीं चक्कर लगाता रहा—स्कोर बढ़ता रहा, पर रेस कभी ख़त्म नहीं हुई। इनाम फ़ंक्शन ने वही किया जो उसे बताया गया था—बस एजेंट को यह नहीं बताया गया था कि “जीतना” वास्तव में क्या होता है। जिसे आप इनाम देते हैं और जो आप वास्तव में चाहते हैं, उनके बीच का यह अंतर रिवार्ड हैकिंग कहलाता है, और लगभग हर इनाम फ़ंक्शन में किसी न किसी रूप में दिखता है।
वही एल्गोरिदम, अलग रैंडम सीड के साथ चलाने पर, अलग नतीजे दे सकता है।
प्रकाशित नतीजे तब तक दोहराना मुश्किल है जब तक कि मूल शोधकर्ताओं द्वारा उपयोग किया गया सटीक कोडबेस, हाइपरपैरामीटर और सीड न मिलें। छोटे-छोटे इम्प्लीमेंटेशन विवरण—जैसे अवलोकनों को कैसे नॉर्मलाइज़ किया जाता है या रिप्ले बफ़र कैसे आरंभ किया जाता है—प्रदर्शन को एल्गोरिदम की पसंद से भी अधिक बदल सकते हैं।
सिम्युलेटर एजेंट को बार-बार, जितनी बार भी ज़रूरत हो, मुफ़्त में विफल होने देता है। वास्तविक दुनिया ऐसे काम नहीं करती।
उदाहरण के लिए, हाईवे पर कोई स्वचालित-ड्राइविंग नीति यदि किसी बुरी क्रिया का एक्सप्लोर करती है, तो लोगों को जोखिम होता है। सिम्युलेटर वास्तविक दुनिया को कभी पूरी तरह नहीं पकड़ते—जैसे ही नीति प्रयोगशाला से बाहर आती है, वही एज केस उभर आते हैं जिन्हें सिम्युलेटर ने मॉडल ही नहीं किया। सिम्युलेशन में बढ़िया दिखने वाली नीति वास्तविक परिवेश से मिलने पर ऐसे तरीक़ों से असफल हो सकती है जिनकी किसी ने भविष्यवाणी नहीं की थी—इसीलिए खेलों और सिम्युलेटरों से बाहर डीप RL की तैनाती बेंचमार्क संख्याएँ जितना दर्शाती हैं, उससे कहीं ज़्यादा सावधानी माँगती है।
अब मैं डीप रिइनफोर्समेंट लर्निंग और अधिक पारंपरिक तरीकों के बीच के अंतर उजागर करूँगा।
सुपरवाइज़्ड लर्निंग लेबलयुक्त उदाहरणों पर ट्रेन करती है, जहाँ हर इनपुट का पहले से सही उत्तर होता है। डीप RL को यह कभी नहीं मिलता—उसे क्रिया के बाद ही इनाम मिलता है और उसे खुद ही समझना होता है कि कौन-सी क्रियाएँ उस इनाम तक ले गईं।
इमिटेशन लर्निंग किसी विशेषज्ञ के डेमो की नकल करने के लिए नीति को प्रशिक्षित करती है—बिना किसी इनाम संकेत के। डीप RL इसके बजाय परीक्षण-त्रुटि से व्यवहार खोजती है।
इमिटेशन लर्निंग नीति को तेजी से चालू कर देती है, लेकिन वह डेमो की गुणवत्ता से बँधी रहती है, और जैसे ही एजेंट ऐसी स्थिति में आता है जो विशेषज्ञ ने कभी नहीं दिखाई, वह लड़खड़ा जाती है। सैद्धांतिक रूप से डीप RL किसी भी शिक्षक के प्रदर्शन से आगे जा सकती है, लेकिन उसे कहीं अधिक अंतःक्रिया और ऐसी इनाम फ़ंक्शन की ज़रूरत होती है जो वास्तव में आपकी वांछित व्यवहार की ओर इशारा करे।
एवल्यूशनरी एल्गोरिदम उम्मीदवारों की आबादी में म्यूटेशन करते हैं और सर्वश्रेष्ठ प्रदर्शन करने वालों को रखते हैं—बिना किसी ग्रेडिएंट गणना के। डीप RL इनाम संकेत से ग्रेडिएंट निकालकर एकल नीति को अपडेट करती है।
एवल्यूशनरी तरीके समानांतरता के लिए उपयुक्त हैं—क्योंकि आबादी का हर उम्मीदवार स्वतंत्र रूप से चल सकता है। लेकिन वे आम तौर पर ग्रेडिएंट-आधारित डीप RL की तुलना में समान प्रदर्शन स्तर तक पहुँचने के लिए कहीं अधिक कुल परिवेश अंतःक्रियाएँ माँगते हैं।
डीप RL अधिकतर अन्य क्षेत्रों की तुलना में शॉर्टकट्स को ज़्यादा दंडित करती है। इसे ध्यान में रखते हुए, अपने अगले प्रोजेक्ट के लिए ये सर्वोत्तम प्रथाएँ याद रखें:
डीप रिइनफोर्समेंट लर्निंग RL के मूल परीक्षण-त्रुटि लूप को एक ऐसे न्यूरल नेटवर्क के साथ जोड़ती है जो उन अवस्थाओं को संभाल सके जिन्हें कोई लुकअप टेबल कभी नहीं संभाल सकती।
इस लेख के हर एल्गोरिदम तीन परिवारों में से किसी एक में आता है। वैल्यू-आधारित विधियाँ, जैसे DQN, Q-वैल्यू फ़ंक्शन सीखती हैं और सबसे अधिक रेट वाली क्रिया चुनती हैं। पॉलिसी-आधारित विधियाँ, जैसे REINFORCE, नीति को सीधे सीखती हैं। एक्टर-क्रिटिक विधियाँ, जिनमें PPO शामिल है, दोनों को जोड़ती हैं—और आज अधिकांश एल्गोरिदम यही संयोजन अपनाते हैं।
बस ध्यान रखें कि इनमें से कुछ भी मुफ़्त नहीं आता।
प्रशिक्षण स्थिरता, सैंपल दक्षता, इनाम डिज़ाइन, और पुनरुत्पादन—ये सब तालिका से नेटवर्क पर आने के साथ ही कठिन हो जाते हैं। यदि आप और गहराई में जाना चाहते हैं, तो Q-learning और reinforcement learning वे नींव कवर करते हैं जिन पर यह लेख बना है, और DQN तथा PPO एल्गोरिदम खुद के लिए अच्छे अगले पड़ाव हैं।
DataCamp के साथ सीखें
course
course
Track