Courses
理解 Artificial Intelligence
2小时
421.1K
当环境大到无法手工追踪时,传统的强化学习就不再奏效。原因在于每个状态都需要在表中有自己的条目,而每个状态下的每个动作也都需要有自己的取值。
举例来说,一帧游戏画面会产生数百万种像素组合,这根本装不进一个可遍历的表里。智能体需要根据与之相似的状态来推测从未见过的状态的价值。
深度强化学习通过用一个神经网络替代表格来解决这一问题,它可以估计某个状态的价值或应采取的最佳动作,即使在从未直接遇到的情境下也能做到。这正是让智能体掌握围棋、驾驶仿真无人机等任务的关键——这些任务都会让经典的 RL 算法“爆炸”。
本文将带您理解深度 RL 的核心概念、DQN 和 PPO 等主要算法家族,以及它们在现实世界中的应用。
如果您是强化学习新手,可报名我们的 Reinforcement Learning in Python 学习路径,在一个周末内打好基础。
深度强化学习就是用神经网络来替代旧方法依赖的查找表的强化学习。
强化学习本身提供了基本的循环:智能体尝试一个动作、观察结果,并根据奖励进行调整。深度学习加入了一个网络,可以把原始输入转换成智能体可操作的表示。两者结合后,智能体能够直接从原始数据中学习最有效的动作,无需人为编码每个状态的含义。
想象您在训练一个会玩 Breakout 的智能体。它拿到的不是“球的位置”“挡板的位置”这样的干净列表——而是来自屏幕的原始像素。表格方法需要为每种可能的像素组合单独建一行,这个数量不可控。神经网络会直接查看像素并输出该采取的动作,或者评估每个动作的好坏,即使从未见过那一帧完全相同的画面。
简而言之,表格方法是“记忆”,网络是“泛化”。
这正是深度 RL 能在表格无能为力的庞大或混乱环境中奏效的原因。
无论底层使用哪种算法,每个深度 RL 系统都运行着同样的循环。
流程如下:
下图展示了这一循环的运行:
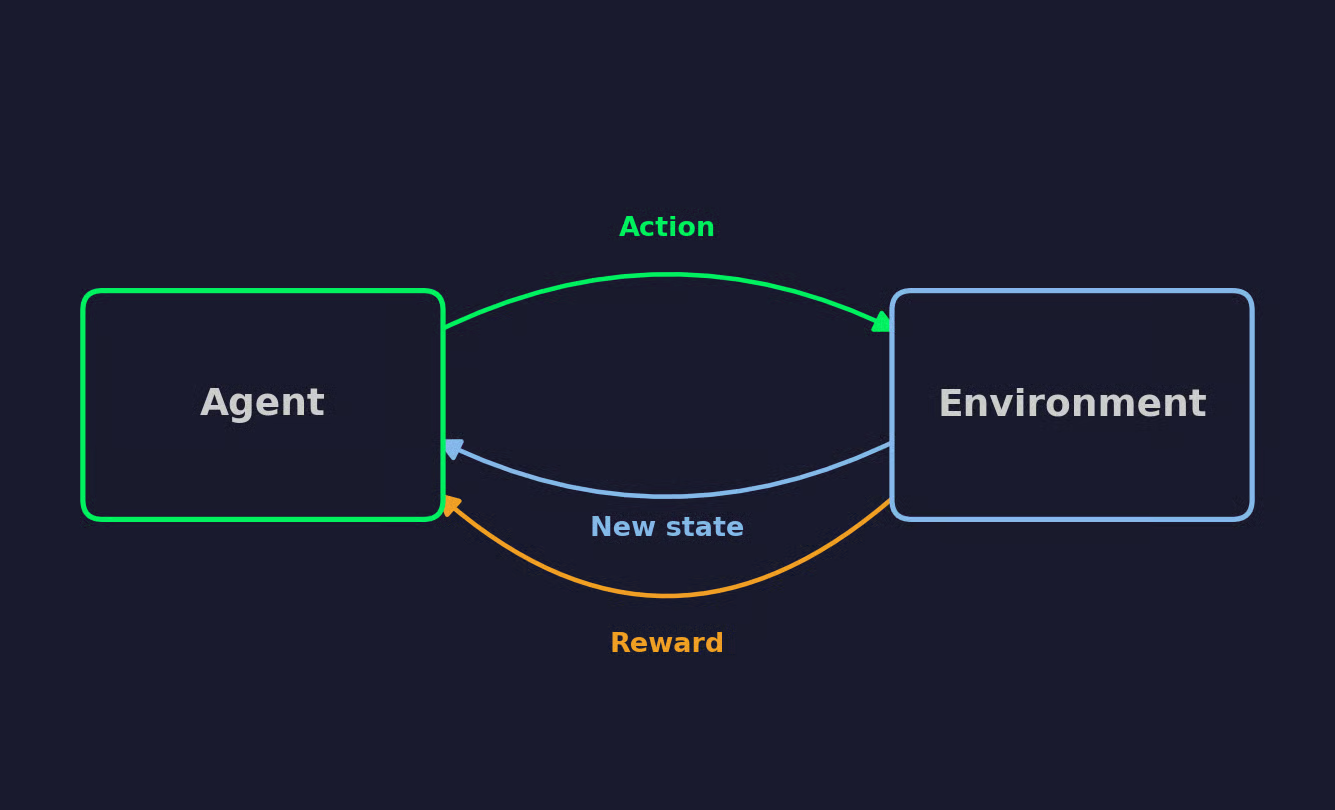
强化学习循环
如果您将这一循环反复执行足够多次,智能体的行为会逐渐转向那些能够持续最大化奖励的动作。
每个深度 RL 算法都建立在同样的七个概念之上。熟悉这些概念,后文就会更容易理解。
想象一台扫地机器人学习清洁房间。下面的每个术语我都会用这个例子来说明。
智能体是决策者——在我们的例子中就是扫地机器人。环境是它交互的一切,例如房间、家具、灰尘以及可能撞到的墙。
智能体无法控制环境,但它可以选择动作,而环境决定接下来会发生什么。
状态描述在某一时刻环境的完整情况,比如每一块灰尘的精确位置以及吸尘器的位置。真实的智能体很少能确定性地获取到完整状态。
相反,它们依赖观测行事,也就是智能体实际能看到的内容,如摄像头画面或一组接近传感器的读数。
在简单环境中,观测与状态基本等同。在更复杂的环境中,智能体只能获得不完整信息,需要自己补全空白。
动作是智能体在任一时刻可用的操作。对吸尘器而言,可能包括向前移动、左转、右转或开启吸力。
动作可以是离散的(智能体从固定列表中选择),也可以是连续的(智能体从一个范围内选择取值,如转向角度)。这种区分在后文介绍不同算法家族时会非常重要。
奖励是智能体在采取动作后获得的数值反馈。如果吸尘器清理了一块新的地面,可能获得 +1 的奖励;如果撞到墙,可能得到 -1。
智能体的总体目标是在时间维度上最大化累计奖励,而不仅仅是下一次动作的奖励。
策略是智能体将状态(或观测)映射为动作的规则。它是智能体决定下一步该做什么的“说明书”。
策略可以是确定性的(给定状态总是选择相同动作),也可以是随机性的(根据概率分布选择动作)。深度 RL 算法通常用神经网络来表示策略。
价值函数估计在给定状态下,如果智能体持续遵循当前策略,预期可以获得多少未来奖励。
Q 值函数则对应状态-动作对。它估计在特定状态下采取某个特定动作、随后再遵循策略,能够获得的未来奖励。
这正是神经网络擅长近似的函数类型。也与前文用网络替代表格的思路一脉相承。
回合是智能体在环境中的一次完整运行,从起始状态到某个终止条件。对于吸尘器而言,可能是房间完全打扫干净或电池耗尽。
回合结束后,环境会重置,并开始新的回合。
只会重复已有成功经验的智能体永远找不到更好的办法。
再想想吸尘器。它偶然发现一条能清理不少区域的路径,于是每次都按这条路径跑,从不检查沙发后面的角落。这就是强化学习的核心权衡:
平衡二者的常见方法是ε-贪心(epsilon-greedy)探索。在每一步,智能体以 ε(如 0.1)的概率随机选择一个动作,否则选择当前认为最优的动作。许多算法会随时间衰减 ε:前期大量探索,后期当学到了足够多、对自身判断更有信心时,更多地进行利用。
不存在适用于所有环境的固定 ε。
探索过多会把时间浪费在不断失败的动作上;探索过少则可能让智能体满足于“凑合”的策略,而更优策略就在旁边却未被发现。随着环境复杂度提升,这种平衡愈发困难,尤其是在糟糕的早期动作要经过许多步才显露真实代价的情形下。
每种深度 RL 算法都可归入三大类,取决于它学习的对象:价值函数、策略,或两者兼有。
DQN 将本文前面提到的 Q 值函数中使用的查找表替换为神经网络。网络以状态为输入,输出每个可能动作的 Q 值,训练方式与标准神经网络的学习方式相同。
直接训练该网络并不可取。相邻的经验是相关的,网络会对刚看到的内容过拟合;而且目标值会在网络每次更新时发生变化。
DQN 用两招来解决:
DQN 之所以重要,是因为它首次实现了在广泛的 Atari 游戏中直接从原始像素学习控制策略,并且对每个游戏都使用相同的架构与超参数。DeepMind 于 2015 年发表该方法,证明了深度学习与强化学习可以在规模化上有效结合,而无需为每个游戏手工构造特征。
策略梯度方法不是学习价值函数再据此选动作,而是直接学习策略。网络以状态为输入,输出动作概率分布,智能体从该分布中采样动作。
这种方法适用于连续或随机动作。
价值类方法需要检查所有可能动作以找出最佳者,一旦动作空间是连续的就会失效——您无法遍历无穷多的转向角度。策略梯度方法只需从分布中采样,无论动作有多少都可行。
REINFORCE 是该类方法的基础算法。它运行一个完整回合,然后提高导致高总奖励的动作的选择概率,降低导致低总奖励的动作的选择概率。问题在于它只在回合结束后更新,并依赖完整回报,这会让更新在不同回合之间表现得嘈杂且不稳定。
Actor-Critic 方法通过增加第二个网络来缓解 REINFORCE 的噪声问题。
Actor 是策略——其选动作的方式与策略梯度方法相同。Critic 是价值函数,它在动作发生后立刻进行评估,而不是等到回合结束。
这就是价值方法与策略方法的协同。Actor 仍在学习策略,但它的更新基于 Critic 对每次动作的即时评判,而不是 REINFORCE 所依赖的延迟且嘈杂的回报。
A2C 和 A3C 是典型代表。A2C 并行运行若干环境副本,并在每个批次结束后同步更新 Actor 和 Critic。A3C 则异步运行这些副本,各自按自己的节奏更新共享网络,而无需等待其他副本。
如果允许策略梯度的更新幅度过大,更新就可能出错。足够大的更新会破坏原本运转良好的策略,而且一旦发生就很难挽回。
PPO 通过限制每次更新的幅度来避免这种情况。下面是它优化的截断目标:
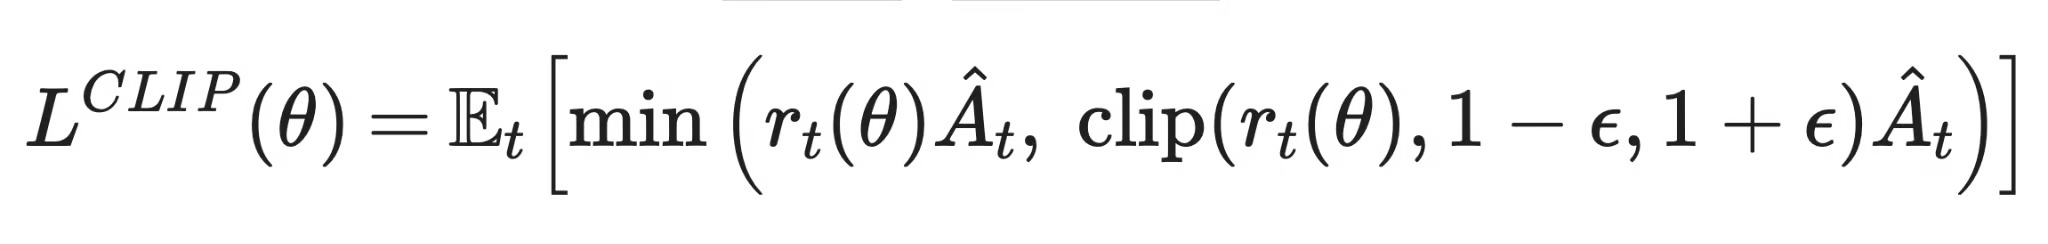
近端策略优化
r_t(θ) 是新旧策略对同一动作概率之比。Â_t 是优势(advantage),即该动作相对 Critic 基线预期的好多少。clip() 函数将概率比限制在以 1 为中心的窄带内,从而使策略在单步中不会发生过大改变。随后 min() 选择两个估计中更保守的那个,避免异常大的优势估计推动更新超出截断范围。
OpenAI 在 2017 年提出 PPO,它几乎立即成为默认选择。与先前的信赖域方法相比,它更易实现和调参,并且在多种环境下无需大量逐任务调整就能稳定表现。
DDPG 和软 Actor-Critic(SAC)都面向连续控制问题,如机器人关节角度或转向值,此类问题要求智能体输出具体数值而非概率分布中的选择。
DDPG 是一种 Actor-Critic 方法,其中 Actor 输出单一的确定性动作而非分布,并借鉴了 DQN 的经验回放与目标网络。
SAC 在此基础上增加了熵正则项,奖励策略保持一定的随机性,从而延长探索并通常让训练比 DDPG 更加稳定。
价值方法(如 DQN)学习 Q 值函数,并选择该函数评分最高的动作。它适合离散动作空间,并能通过经验回放获得良好的样本效率,但在连续动作上需要额外处理。
策略方法(如 REINFORCE)直接学习策略,从概率分布中采样动作。这使其适用于连续和随机动作,但朴素的策略梯度更新噪声较大,且每次更新都需要新数据。
Actor-Critic 方法(包括 A2C/A3C、PPO、DDPG、SAC)结合了两种思路。Critic 的快速反馈能稳定 Actor 的更新,这也是为什么如今实践中大多数算法都属于这一类。
下面是更直观的对比:
| 学习内容 | 动作选择方式 | 离散 vs. 连续 | 稳定性 | 样本效率 | 代表性算法 | |
|---|---|---|---|---|---|---|
| 价值方法 | Q 值函数 | 选择评分最高的动作 | 离散 | 需借助目标网络与回放缓冲保持稳定 | 较好,得益于经验回放 | DQN |
| 策略方法 | 策略 | 从策略分布中采样 | 皆可,最适于连续 | 更新噪声大、方差高 | 较差,每次更新都需新数据 | REINFORCE |
| Actor-Critic | 策略与价值函数 | 从 Actor 采样,并由 Critic 指导 | 皆可 | 比纯策略方法更稳定 | 优于纯策略方法 | A2C/A3C, PPO, DDPG, SAC |
深度强化学习方法对比
监督学习为每个样本都提供带标签的答案。深度 RL 则需要从迟到的奖励信号中推断什么是有效的,这个信号还会与之前的动作混在一起,有时甚至没有任何有用的呈现方式。
与监督模型在固定数据集上达到相近精度所需的数据量相比,深度 RL 智能体往往需要数百万步的环境交互后才学到有用的东西。
原因在于智能体必须通过行动自行生成训练数据,而在早期,大多数动作接近随机。监督模型则可以反复重用同一带标签的数据集。RL 智能体必须在几乎不了解的环境中持续探索,一步一步地前进。
RL 训练经常不稳定。
部分原因在于价值函数会自举于自身估计:今天的 Q 值目标依赖于昨天的 Q 值猜测。如果猜偏了,误差会累积而非自我纠正。再加上智能体的策略在学习中不断变化,它收集的数据也随之不断变化。
换句话说,网络在两个方向上同时追逐移动的目标。
有些环境只在最后给出奖励,比如一场漫长游戏结束后的胜负信号。智能体必须从这一个数字向后推断,找出它所采取的数十个动作中究竟哪些起了关键作用。
这被称为“信用分配问题(credit assignment)”,动作与后果之间的延迟越长,这个问题就越棘手。
奖励设计听起来容易,真正做起来却很难。
一个著名例子是:OpenAI 训练的赛艇智能体因命中检查点而获奖,于是它找到一个能反复刷新的道具泻湖,绕圈刷分,从未完成比赛。奖励函数严格按“指令”执行——只是智能体并没有被明确告知什么才是“赢”。这种奖励与真实目标不一致的情况称为奖励投机(reward hacking),几乎每个奖励函数都会以某种形式遭遇它。
同一算法在不同的随机种子下可能产生不同的结果。
若没有原作者使用的准确代码库、超参数和随机种子,已发表的结果很难复现。小小的实现细节(例如如何归一化观测、如何初始化回放缓冲)对性能的影响,甚至可能超过算法选择本身。
在模拟器里,智能体可以免费失败无数次,直到学会为止。现实世界却并非如此。
例如,高速公路上的自动驾驶策略若为探索而尝试糟糕动作,会威胁到人的安全。模拟器永远无法完美还原现实,传感器噪声和模拟器未覆盖的边界情形,一旦策略离开实验室就会出现。一个在仿真中表现良好的策略,遇到真实环境时可能以意想不到的方式失败。因此,除游戏和模拟器外的深度 RL 部署要比基准分数显示的谨慎得多。
下面我将强调深度强化学习与更传统方法之间的差异。
监督学习在带标签样本上训练,每个输入都有正确答案。深度 RL 从来拿不到这种答案——它只有在行动之后得到奖励,并且必须自行找出哪些动作带来了奖励。
模仿学习仅根据专家示范来训练策略,从不使用奖励信号。深度 RL 则通过试错来发现行为。
模仿学习能快速让策略“跑起来”,但上限受示范质量限制,一旦智能体遭遇专家未展示过的情境就会吃力。深度 RL 理论上能超越任何老师,但需要更多的交互以及一个真正指向期望行为的奖励函数。
进化算法通过对候选策略种群进行变异,并保留表现最佳者来优化策略,完全不计算梯度。深度 RL 则根据奖励信号计算梯度并更新单一策略。
进化方法非常适合并行化,因为种群中的每个候选都可独立运行。但它们通常需要比基于梯度的深度 RL 多得多的环境交互,才能达到同等水平的性能。
深度 RL 比多数其他领域更“惩罚”投机取巧。基于此,以下是您在下一个项目中应牢记的一些最佳实践:
深度强化学习将 RL 的试错循环与能处理查找表难以覆盖的状态空间的神经网络结合起来。
本文中的每个算法都属于三大类之一。价值方法(如 DQN)学习 Q 值函数并选择评分最高的动作;策略方法(如 REINFORCE)直接学习策略;Actor-Critic 方法(包括 PPO)结合两者,这也是当今多数算法采用的组合。
请记住,这些都不是“白拿”的。
一旦从表格转向网络,训练稳定性、样本效率、奖励设计与可复现性都会变得更难。如果您想更深入了解,Q-learning 与 reinforcement learning 涵盖了本文所基于的基础,而 DQN 和 PPO 则是了解具体算法的良好下一站。
与 DataCamp 一起学习
Courses
Courses
Tracks