
Courses
Hiểu về Trí tuệ Nhân tạo
2 giờ
421.1K
Học tăng cường truyền thống không thực sự hiệu quả khi môi trường trở nên quá lớn để theo dõi thủ công. Lý do là vì mỗi trạng thái cần một mục riêng trong bảng, và mỗi hành động từ mỗi trạng thái cần một giá trị riêng.
Ví dụ, màn hình trò chơi tạo ra hàng triệu tổ hợp điểm ảnh, vốn không thể nhét vào một bảng để bạn có thể duyệt qua. Tác tử cần đoán giá trị của một trạng thái mà nó chưa từng thấy, dựa trên các trạng thái trông tương tự.
Học tăng cường sâu khắc phục điều này bằng cách thay bảng tra cứu bằng một mạng nơ-ron ước lượng giá trị của một trạng thái hoặc hành động tốt nhất cần thực hiện, ngay cả với những tình huống mà nó chưa từng gặp trực tiếp. Đây là điều cho phép tác tử làm chủ cờ vây và điều khiển drone mô phỏng, đều là những tác vụ có thể khiến mọi thuật toán RL cổ điển “vỡ tung”.
Trong bài viết này, tôi sẽ hướng dẫn bạn qua các khái niệm cốt lõi của deep RL, các họ thuật toán lớn như DQN và PPO, và nơi chúng xuất hiện trong thế giới thực.
Nếu bạn mới bắt đầu với học tăng cườngt learning, hãy đăng ký lộ trình Reinforcement Learning in Python của chúng tôi để nắm vững những điều cơ bản chỉ trong một cuối tuần.
Học tăng cường sâu là học tăng cường với một mạng nơ-ron thay thế cho bảng tra cứu.
Học tăng cường vốn đã cung cấp vòng lặp cơ bản trong đó tác tử thử một hành động, quan sát điều xảy ra và điều chỉnh dựa trên phần thưởng. Học sâu bổ sung một mạng có thể biến đầu vào thô thành thứ mà tác tử có thể hành động. Khi kết hợp, tác tử học được hành động nào hiệu quả nhất trực tiếp từ dữ liệu thô, mà không cần ai đó mã hóa thủ công ý nghĩa của từng trạng thái.
Hãy tưởng tượng bạn đang huấn luyện một tác tử chơi trò Breakout. Tác tử không nhận được danh sách rõ ràng như "vị trí bóng" hay "vị trí thanh trượt" - nó nhận các điểm ảnh thô từ màn hình. Phương pháp dạng bảng sẽ cần một hàng riêng cho mọi tổ hợp điểm ảnh có thể có, và con số đó là không thể quản lý. Một mạng nơ-ron nhìn trực tiếp vào các điểm ảnh và xuất ra hành động cần thực hiện, hoặc mức độ tốt của từng hành động, mà không cần từng thấy chính xác màn hình đó trước đây.
Tóm lại, phương pháp dạng bảng thì ghi nhớ, còn mạng thì khái quát hóa.
Đó là điều khiến deep RL hoạt động được trong các môi trường quá lớn hoặc quá lộn xộn để một bảng có thể xử lý.
Mọi hệ thống deep RL đều chạy cùng một vòng lặp, bất kể bên dưới là thuật toán nào.
Trình tự như sau:
Sơ đồ dưới đây cho thấy vòng lặp này đang hoạt động:
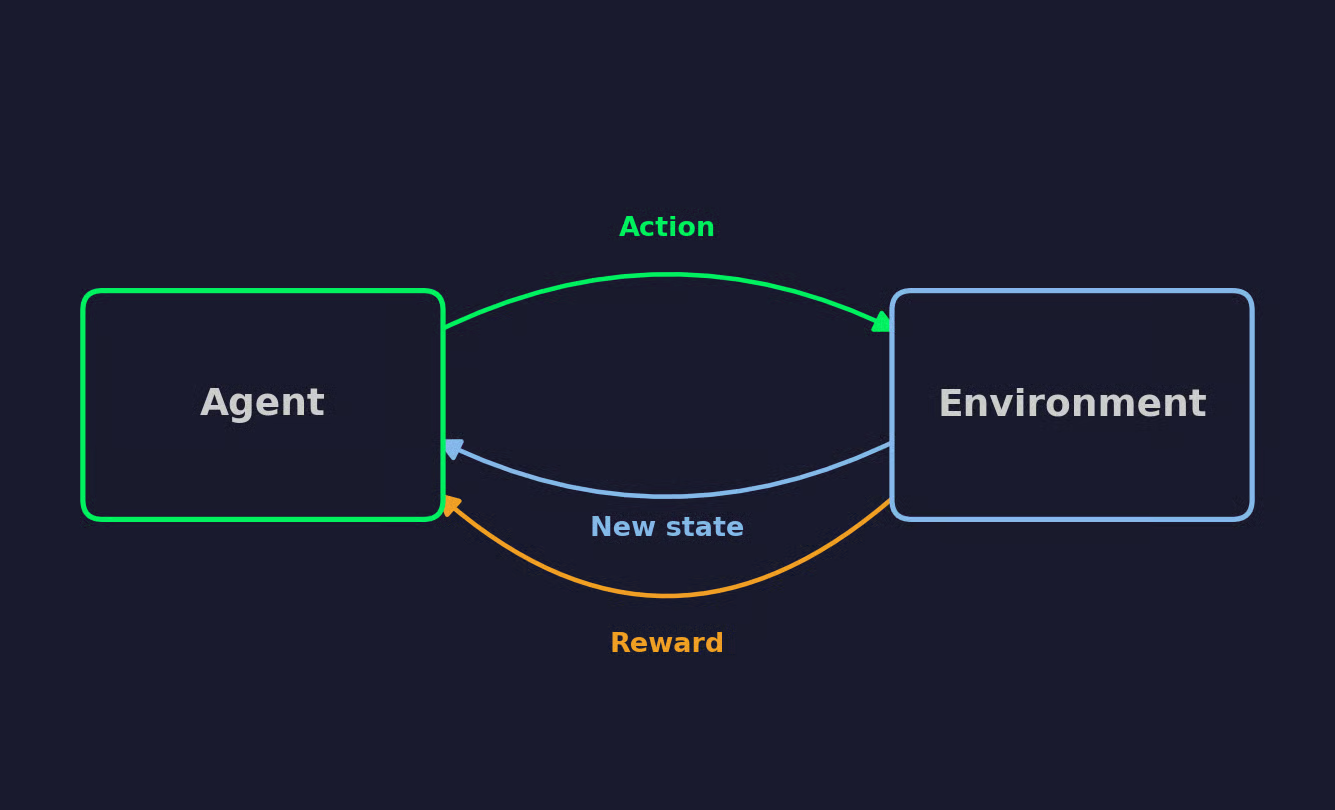
Vòng lặp học tăng cường
Nếu bạn lặp lại vòng lặp này đủ lâu, hành vi của tác tử sẽ chuyển dần về phía những hành động tối đa hóa phần thưởng.
Mọi thuật toán deep RL đều xây dựng trên cùng bảy ý tưởng. Bạn nên làm quen với chúng, phần còn lại của bài viết sẽ dễ hiểu hơn nhiều.
Hãy tưởng tượng một robot hút bụi học cách làm sạch một căn phòng. Tôi sẽ dùng ví dụ đó xuyên suốt các thuật ngữ dưới đây.
Tác tử là bên ra quyết định - trong ví dụ của chúng ta là robot hút bụi. Môi trường là mọi thứ nó tương tác, như căn phòng, nội thất, bụi bẩn, những bức tường mà nó có thể va vào.
Tác tử không kiểm soát môi trường, nhưng nó chọn hành động, và môi trường quyết định điều gì xảy ra tiếp theo.
Trạng thái mô tả điều kiện đầy đủ của môi trường tại một thời điểm, như vị trí chính xác của từng mảng bụi và vị trí của robot hút bụi. Tác tử ngoài đời hiếm khi có quyền truy cập chắc chắn vào điều đó.
Thay vào đó, chúng hành động dựa trên quan sát, tức những gì tác tử thực sự có thể nhìn thấy, như luồng camera hoặc tập cảm biến tiệm cận.
Trong môi trường đơn giản, quan sát và trạng thái gần như giống nhau. Trong môi trường phức tạp hơn, tác tử làm việc với thông tin không đầy đủ và phải tự lấp đầy các khoảng trống.
Hành động là những động tác khả dụng cho tác tử tại bất kỳ thời điểm nào. Với robot hút bụi, có thể là tiến lên, rẽ trái, rẽ phải hoặc kích hoạt hút bụi.
Hành động có thể là rời rạc, khi tác tử chọn từ một danh sách cố định, hoặc liên tục, khi tác tử chọn một giá trị theo một khoảng, như góc lái. Sự phân biệt này rất quan trọng khi bạn đi đến các họ thuật toán khác nhau ở phần sau của bài viết.
Phần thưởng là phản hồi dạng số mà tác tử nhận được sau khi thực hiện một hành động. Nếu robot hút bụi làm sạch một mảng sàn mới, nó có thể nhận phần thưởng +1. Nhưng khi nó đâm vào tường, có thể nhận -1.
Mục tiêu toàn bộ của tác tử là tối đa hóa tổng phần thưởng tích lũy theo thời gian, không chỉ phần thưởng của hành động kế tiếp.
Chính sách là chiến lược của tác tử để ánh xạ các trạng thái, hoặc quan sát, sang hành động. Đó là bộ quy tắc tác tử tuân theo để quyết định làm gì tiếp theo.
Chính sách có thể là tất định, luôn chọn cùng một hành động cho một trạng thái nhất định, hoặc ngẫu nhiên, chọn hành động dựa trên một phân phối xác suất. Các thuật toán deep RL thường dùng mạng nơ-ron để biểu diễn chính sách này.
Hàm giá trị ước lượng lượng phần thưởng tương lai mà tác tử có thể kỳ vọng thu được từ một trạng thái nhất định, nếu nó tiếp tục theo chính sách hiện tại.
Hàm Q-value làm điều tương tự cho một cặp trạng thái-hành động. Nó ước lượng phần thưởng tương lai từ việc thực hiện một hành động cụ thể trong một trạng thái cụ thể, rồi sau đó tiếp tục theo chính sách.
Đây là loại hàm mà một mạng nơ-ron giỏi trong việc xấp xỉ. Đó là cùng ý tưởng tôi đã đề cập khi thay thế bảng tra cứu ở phần trước của bài.
Một tập là một lần chạy đầy đủ của tác tử qua môi trường, từ trạng thái bắt đầu đến một điều kiện kết thúc nào đó. Với robot hút bụi, có thể là phòng đã sạch hoàn toàn hoặc hết pin.
Khi một tập kết thúc, môi trường được đặt lại, và một tập mới bắt đầu.
Một tác tử chỉ lặp lại những gì đã hiệu quả sẽ không bao giờ tìm thấy thứ tốt hơn.
Hãy hình dung lại robot hút bụi. Nó tình cờ tìm được một lộ trình làm sạch một phần khá lớn của phòng, và cứ chạy lộ trình đó mỗi lần. Nó không bao giờ kiểm tra góc phía sau ghế sofa. Đó là sự đánh đổi ở trung tâm của học tăng cường:
Một cách phổ biến để cân bằng hai yếu tố là epsilon-greedy. Ở mỗi bước, tác tử chọn một hành động ngẫu nhiên với xác suất epsilon, một số nhỏ như 0.1, và ngược lại sẽ chọn hành động mà nó tin là tốt nhất hiện tại. Nhiều thuật toán làm giảm epsilon theo thời gian, trong đó tác tử khám phá nhiều ở giai đoạn đầu, rồi nghiêng về khai thác nhiều hơn khi nó đã học đủ để tin vào đánh giá của chính mình.
Không có một epsilon cố định phù hợp với mọi môi trường.
Quá nhiều khám phá sẽ lãng phí thời gian vào các hành động liên tục thất bại. Quá ít khám phá khiến tác tử chấp nhận một chiến lược tạm ổn trong khi một chiến lược tốt hơn ở ngay bên cạnh nhưng chưa được phát hiện. Đạt cân bằng đúng chỉ càng khó hơn khi môi trường trở nên phức tạp, đặc biệt khi một hành động tệ ban đầu không bộc lộ chi phí thực cho đến nhiều bước sau.
Mỗi thuật toán deep RL thuộc một trong ba họ, dựa trên thứ nó học: một hàm giá trị, một chính sách, hoặc cả hai cùng lúc.
DQN lấy hàm Q-value từ phần trước và thay bảng tra cứu bằng một mạng nơ-ron. Mạng nhận trạng thái làm đầu vào và xuất ra một Q-value cho mọi hành động có thể, được học theo cùng cách một mạng nơ-ron chuẩn học mọi thứ khác.
Huấn luyện trực tiếp mạng đó là điều không khuyến nghị. Các trải nghiệm liên tiếp có tương quan, khiến mạng khớp quá mức với những gì nó vừa thấy, và mục tiêu nó theo đuổi thay đổi mỗi lần mạng cập nhật.
DQN khắc phục cả hai vấn đề:
DQN quan trọng vì nó là thuật toán đầu tiên học chính sách điều khiển trực tiếp từ điểm ảnh thô trên nhiều trò Atari, dùng cùng kiến trúc và siêu tham số cho mỗi trò. Khi DeepMind công bố năm 2015, nó chứng minh học sâu và học tăng cường thực sự có thể phối hợp hiệu quả ở quy mô lớn, mà không cần đặc trưng dựng tay cho từng trò.
Thay vì học một hàm giá trị và chọn hành động dựa trên nó, phương pháp gradient chính sách học chính sách. Mạng nhận trạng thái và xuất ra các xác suất hành động, và tác tử lấy mẫu hành động từ phân phối đó.
Cách tiếp cận này phù hợp với hành động liên tục hoặc ngẫu nhiên.
Một phương pháp dựa trên giá trị cần kiểm tra mọi hành động có thể để tìm cái tốt nhất, điều này sụp đổ ngay khi không gian hành động trở nên liên tục - bạn không thể duyệt qua một dải góc lái vô hạn. Một phương pháp gradient chính sách chỉ việc lấy mẫu từ phân phối, bất kể có bao nhiêu hành động tồn tại.
REINFORCE là thuật toán nền tảng ở đây. Nó chạy toàn bộ một tập, rồi tăng xác suất của những hành động dẫn đến tổng phần thưởng cao và giảm xác suất của những hành động dẫn đến tổng phần thưởng thấp. Điểm khó là nó chỉ cập nhật sau khi tập kết thúc, và dựa vào tổng lợi tức, khiến các cập nhật nhiễu và không nhất quán giữa các tập.
Phương pháp actor-critic khắc phục vấn đề nhiễu của REINFORCE bằng cách thêm một mạng thứ hai.
Actor là chính sách - nó chọn hành động giống cách một phương pháp gradient chính sách sẽ làm. Critic là một hàm giá trị đánh giá từng hành động ngay sau khi nó xảy ra, thay vì chờ đến khi tập kết thúc.
Đây là sự kết hợp giữa cách tiếp cận dựa trên giá trị và dựa trên chính sách. Actor vẫn học một chính sách, nhưng cập nhật dựa trên phán đoán của critic cho từng hành động, không phải lợi tức trễ và nhiễu mà REINFORCE phụ thuộc.
A2C và A3C là những ví dụ tiêu biểu. A2C chạy một vài bản sao môi trường song song và cập nhật actor và critic cùng nhau khi mỗi lô kết thúc. A3C chạy các bản sao đó bất đồng bộ, trong đó mỗi bản sao tự cập nhật mạng chia sẻ theo lịch riêng thay vì chờ các bản sao khác.
Các cập nhật gradient chính sách có thể đi chệch nếu để chúng quá lớn. Một cập nhật đủ lớn có thể làm hỏng một chính sách vốn đang hoạt động tốt, và không có cách nào hoàn tác khi điều đó đã xảy ra.
PPO giới hạn kích thước của mỗi cập nhật để tránh điều đó. Đây là hàm mục tiêu dạng cắt (clipped objective) mà nó tối ưu:
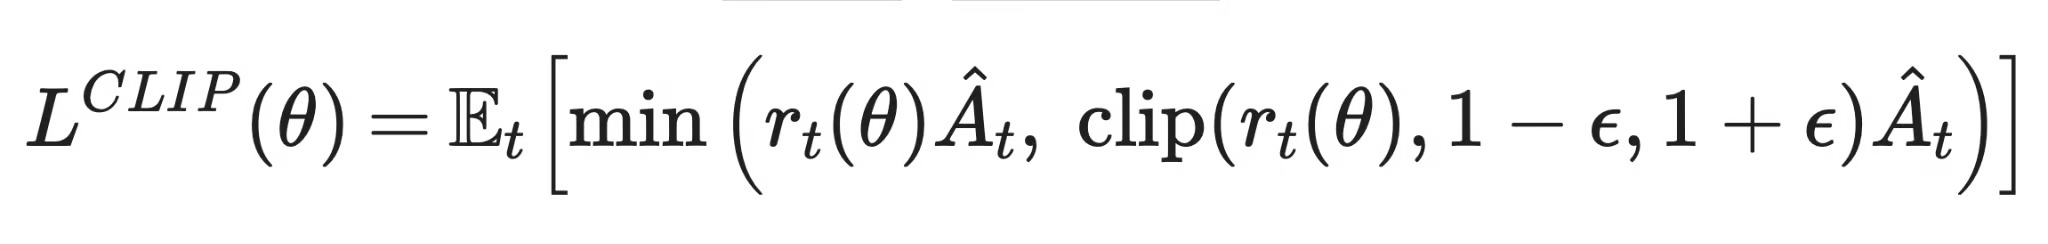
Tối ưu hóa chính sách lân cận
r_t(θ) là tỷ lệ giữa xác suất của hành động theo chính sách mới và xác suất của cùng hành động đó theo chính sách cũ. Â_t là lợi thế (advantage), tức hành động đó tốt hơn mức kỳ vọng chuẩn của critic bao nhiêu. Hàm clip() giữ tỷ lệ trong một khoảng hẹp quanh 1, để chính sách không thể dịch chuyển quá xa trong một bước. Sau đó min() chọn ước lượng thận trọng hơn trong hai ước lượng, để một giá trị lợi thế bất thường lớn không thể đẩy cập nhật đi xa hơn mức clip cho phép.
OpenAI giới thiệu PPO năm 2017, và nó gần như trở thành lựa chọn mặc định ngay lập tức. Nó dễ triển khai và tinh chỉnh hơn so với các phương pháp vùng tin cậy (trust-region) trước đó, và hoạt động tốt trên nhiều môi trường mà không cần điều chỉnh nhiều theo từng tác vụ.
DDPG và Soft Actor-Critic (SAC) đều nhắm tới các bài toán điều khiển liên tục, như góc khớp robot hoặc giá trị lái, nơi tác tử cần xuất ra một con số cụ thể thay vì chọn từ một phân phối.
DDPG là một phương pháp actor-critic mà actor xuất ra một hành động tất định duy nhất thay vì một phân phối, và nó mượn phát lại kinh nghiệm và mạng mục tiêu từ DQN.
SAC xây dựng trên cùng ý tưởng đó nhưng thêm một hạng tử entropy thưởng cho chính sách duy trì sự ngẫu nhiên ở mức nhất định, giúp tác tử khám phá lâu hơn và có xu hướng khiến quá trình huấn luyện ổn định hơn DDPG.
Các phương pháp dựa trên giá trị, như DQN, học một hàm Q-value và chọn bất kỳ hành động nào được hàm đó đánh giá cao nhất. Điều này hiệu quả với không gian hành động rời rạc và tận dụng tốt dữ liệu nhờ phát lại kinh nghiệm, nhưng không mở rộng được sang hành động liên tục nếu không có công việc bổ sung.
Các phương pháp dựa trên chính sách như REINFORCE học trực tiếp chính sách, lấy mẫu hành động từ một phân phối xác suất. Đó là điều giúp chúng làm việc với hành động liên tục và ngẫu nhiên, nhưng các cập nhật gradient chính sách thuần thường nhiễu và cần dữ liệu mới cho mỗi lần cập nhật.
Các phương pháp actor-critic, bao gồm A2C/A3C, PPO, DDPG và SAC, kết hợp cả hai ý tưởng. Phản hồi nhanh của critic giúp ổn định các cập nhật của actor, đó là lý do phần lớn thuật toán dùng trong thực tế ngày nay thuộc nhóm này.
Dưới đây là so sánh trực quan hơn:
| Học được gì | Cách chọn hành động | Rời rạc vs. liên tục | Ổn định | Hiệu quả mẫu | Thuật toán đại diện | |
|---|---|---|---|---|---|---|
| Dựa trên giá trị | Hàm Q-value | Hành động được đánh giá cao nhất | Rời rạc | Cần mạng mục tiêu và phát lại để ổn định | Tốt, nhờ phát lại kinh nghiệm | DQN |
| Dựa trên chính sách | Chính sách | Lấy mẫu từ phân phối của chính sách | Cả hai, tốt nhất với liên tục | Nhiễu, phương sai cao | Kém, cần dữ liệu mới cho mỗi cập nhật | REINFORCE |
| Actor-critic | Chính sách và hàm giá trị | Lấy mẫu từ actor, được critic dẫn dắt | Cả hai | Ổn định hơn phương pháp dựa trên chính sách thuần | Tốt hơn phương pháp dựa trên chính sách thuần | A2C/A3C, PPO, DDPG, SAC |
So sánh các phương pháp học tăng cường sâu
Học có giám sát nhận được đáp án gán nhãn cho mọi ví dụ. Deep RL phải tự tìm ra điều gì hiệu quả từ tín hiệu phần thưởng xuất hiện muộn, được trộn lẫn với các hành động trước đó, và đôi khi không xuất hiện theo cách hữu ích nào cả.
Các tác tử deep RL thường cần hàng triệu bước trong môi trường trước khi học được điều gì đó hữu ích, đặc biệt nếu so với lượng dữ liệu ít ỏi mà một mô hình có giám sát cần để đạt độ chính xác tương tự trên một tập dữ liệu cố định.
Lý do là vì tác tử phải tự tạo dữ liệu huấn luyện bằng cách hành động, và hầu hết những hành động ban đầu gần như ngẫu nhiên. Một mô hình có giám sát có thể tái sử dụng cùng tập dữ liệu gán nhãn lặp đi lặp lại. Một tác tử RL phải tiếp tục khám phá một môi trường mà nó hầu như không hiểu, từng bước một.
Huấn luyện RL thường không ổn định.
Một phần vấn đề là các hàm giá trị tự “chống” trên các ước lượng của chính chúng, trong đó mục tiêu Q-value hôm nay phụ thuộc vào phỏng đoán Q-value hôm qua. Nếu phỏng đoán đó sai, sai số tích lũy thay vì tự điều chỉnh. Thêm vào đó, chính sách của tác tử thay đổi khi nó học, nên dữ liệu nó thu thập cũng liên tục dịch chuyển.
Nói cách khác, mạng đang đuổi theo một mục tiêu di động trên hai mặt trận cùng lúc.
Một số môi trường chỉ trao phần thưởng ở cuối cùng, như tín hiệu thắng hoặc thua sau một ván dài. Tác tử phải lần ngược từ con số đơn lẻ đó và tìm ra hành động nào trong số hàng chục hành động nó đã thực hiện thực sự quan trọng.
Đây được gọi là bài toán gán công lao (credit assignment), và nó trở nên tệ hơn khi độ trễ giữa một hành động và hệ quả của nó kéo dài.
Nghe thì dễ nhưng làm mới khó.
Đây là một ví dụ nổi tiếng. Một tác tử đua thuyền do OpenAI huấn luyện được thưởng khi qua checkpoint, nên nó tìm một đầm phá có vật phẩm tăng lực xuất hiện lại và lặp qua đó vô tận, tích điểm mà không bao giờ về đích. Hàm phần thưởng làm đúng theo những gì được giao - chỉ là tác tử không được nói “chiến thắng” thực sự nghĩa là gì. Sự khác biệt giữa những gì bạn thưởng và những gì bạn thực sự muốn gọi là “hack phần thưởng”, và nó xuất hiện ở dạng nào đó trong hầu hết các hàm phần thưởng bạn viết.
Cùng một thuật toán, chạy với hạt giống ngẫu nhiên khác, có thể cho kết quả khác.
Các kết quả đã công bố khó tái tạo nếu không có đúng mã nguồn, siêu tham số và hạt giống mà nhóm nghiên cứu gốc dùng. Những chi tiết cài đặt nhỏ, như cách chuẩn hóa quan sát hoặc cách khởi tạo bộ đệm phát lại, có thể làm lệch hiệu năng nhiều hơn cả lựa chọn thuật toán.
Trình mô phỏng cho phép tác tử thất bại lặp lại vô tư, bao nhiêu lần cũng được. Thế giới thực thì không như vậy.
Ví dụ, một chính sách tự lái thử một hành động tệ trên cao tốc sẽ đặt con người vào rủi ro. Trình mô phỏng không bao giờ nắm bắt hoàn hảo thế giới thực; các trường hợp biên mà mô phỏng không mô hình hóa sẽ xuất hiện ngay khi chính sách rời phòng thí nghiệm. Một chính sách trông tuyệt trong mô phỏng có thể thất bại theo cách không ai lường trước khi gặp môi trường thực, đó là lý do triển khai deep RL ngoài game và mô phỏng đòi hỏi thận trọng hơn nhiều so với những con số benchmark gợi ý.
Giờ tôi sẽ nhấn mạnh những khác biệt giữa học tăng cường sâu và các cách tiếp cận truyền thống hơn.
Học có giám sát được huấn luyện trên các ví dụ gán nhãn, nơi mỗi đầu vào đã có đáp án đúng. Deep RL không bao giờ có điều đó - nó chỉ nhận phần thưởng sau khi hành động, và phải tự tìm ra hành động nào dẫn đến phần thưởng ấy.
Học bắt chước huấn luyện một chính sách để sao chép các bản trình diễn của chuyên gia, mà không bao giờ dùng tín hiệu phần thưởng. Deep RL khám phá hành vi thông qua thử và sai thay vào đó.
Học bắt chước giúp một chính sách chạy được nhanh, nhưng bị giới hạn bởi chất lượng bản trình diễn, và gặp khó ngay khi tác tử rơi vào tình huống mà chuyên gia chưa từng cho thấy. Về lý thuyết, deep RL có thể vượt hiệu năng của bất kỳ người dạy nào, nhưng nó cần nhiều tương tác hơn và một hàm phần thưởng thực sự hướng đến hành vi bạn muốn.
Thuật toán tiến hóa tối ưu một chính sách bằng cách đột biến một quần thể ứng viên và giữ lại những cái hoạt động tốt nhất, hoàn toàn không tính gradient. Deep RL tính gradient từ tín hiệu phần thưởng và cập nhật một chính sách duy nhất.
Phương pháp tiến hóa dễ song song hóa, vì mỗi ứng viên trong quần thể có thể chạy độc lập. Nhưng chúng thường cần nhiều tương tác với môi trường hơn đáng kể so với deep RL dựa trên gradient để đạt cùng mức hiệu năng.
Deep RL “phạt” các lối tắt nhiều hơn hầu hết lĩnh vực khác. Với điều đó trong đầu, dưới đây là một số thực hành tốt nên ghi nhớ cho dự án tiếp theo của bạn:
Học tăng cường sâu lấy vòng lặp thử-sai ở cốt lõi của RL và kết hợp với một mạng nơ-ron có thể xử lý các trạng thái mà không bảng tra cứu nào có thể.
Mỗi thuật toán trong bài viết này thuộc một trong ba họ. Phương pháp dựa trên giá trị, như DQN, học một hàm Q-value và chọn bất kỳ hành động nào được đánh giá cao nhất. Phương pháp dựa trên chính sách, như REINFORCE, học trực tiếp một chính sách. Phương pháp actor-critic, bao gồm PPO, kết hợp cả hai, và sự kết hợp đó là điều mà hầu hết thuật toán ngày nay sử dụng.
Hãy nhớ rằng chẳng có gì là miễn phí.
Tính ổn định khi huấn luyện, hiệu quả mẫu, thiết kế phần thưởng và khả năng tái lập đều trở nên khó hơn ngay khi bạn chuyển từ bảng sang mạng. Nếu bạn muốn đi sâu hơn, Q-learning và reinforcement learning bao quát các nền tảng mà bài viết này xây dựng dựa trên, và DQN cùng PPO là những điểm dừng tiếp theo tốt cho chính các thuật toán.
Học với DataCamp
Courses
Courses
Tracks
blogs
Matt Crabtree
10 phút
