Corso
Comprendere l'intelligenza artificiale
2 h
421.1K
L'apprendimento per rinforzo tradizionale non funziona davvero quando l'ambiente diventa troppo grande per essere gestito a mano. Il motivo è che ogni stato necessita di una propria voce in una tabella e ogni azione da ogni stato richiede un proprio valore.
Per esempio, lo schermo di un gioco produce milioni di combinazioni di pixel, che semplicemente non entrano in una tabella scorribile. L'agente deve stimare il valore di uno stato che non ha mai visto, basandosi su stati che gli somigliano.
Il deep reinforcement learning risolve questo problema sostituendo la tabella con una rete neurale che stima il valore di uno stato o la migliore azione da intraprendere, anche in situazioni mai incontrate direttamente. È ciò che consente agli agenti di padroneggiare Go e pilotare droni simulati, due compiti che manderebbero in crisi qualsiasi algoritmo RL classico.
In questo articolo, ti guiderò attraverso i concetti chiave del deep RL, le principali famiglie di algoritmi come DQN e PPO e dove trovano applicazione nel mondo reale.
Se sei alle prime armi con l'apprendimento per rinforzo, iscriviti al nostro percorso Reinforcement Learning in Python per fissare le basi in un weekend.
Il deep reinforcement learning è apprendimento per rinforzo con una rete neurale al posto della tabella di lookup.
L'apprendimento per rinforzo fornisce già il ciclo di base in cui un agente prova un'azione, osserva cosa accade e si adatta in base alla ricompensa. Il deep learning aggiunge una rete che può trasformare input grezzi in qualcosa su cui l'agente può agire. Insieme, l'agente impara quali azioni funzionano meglio direttamente dai dati grezzi, senza che nessuno debba codificare a mano cosa significhi ogni stato.
Immagina di addestrare un agente a giocare a Breakout. L'agente non riceve un elenco ordinato di "posizione della palla" o "posizione della racchetta" - ottiene pixel grezzi dallo schermo. Un metodo tabellare avrebbe bisogno di una riga separata per ogni possibile combinazione di pixel, e quel numero è ingestibile. Una rete neurale guarda direttamente i pixel e decide quale azione intraprendere, o quanto sia promettente ciascuna azione, senza aver mai visto esattamente quello schermo prima.
In breve, i metodi tabellari memorizzano, le reti generalizzano.
È questo che rende il deep RL efficace in ambienti troppo grandi o troppo disordinati perché una tabella possa gestirli.
Ogni sistema di deep RL esegue lo stesso ciclo, indipendentemente dall'algoritmo sottostante.
Ecco come procede:
Il diagramma sotto mostra questo ciclo in azione:
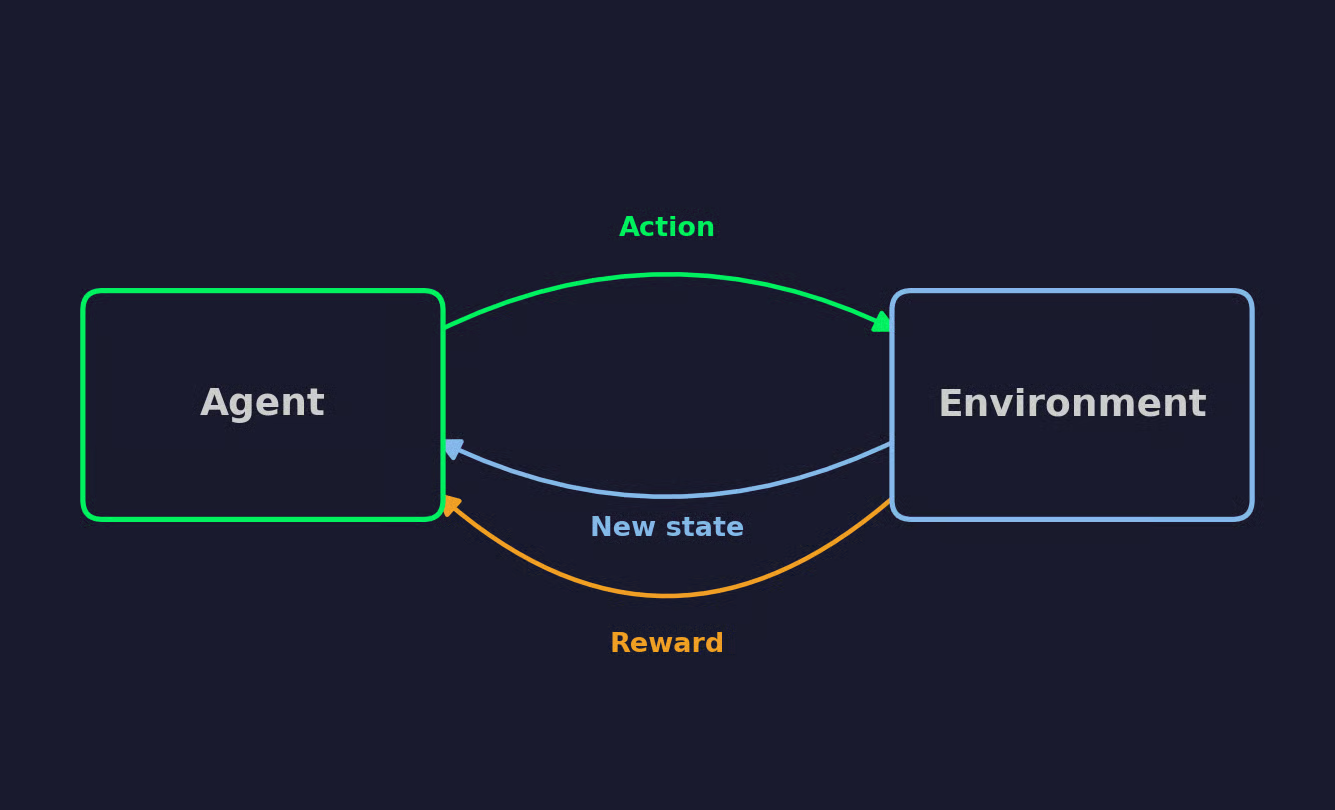
Ciclo dell'apprendimento per rinforzo
Se ripeti questo ciclo abbastanza volte, il comportamento dell'agente tenderà verso le azioni che massimizzano la ricompensa.
Ogni algoritmo di deep RL si basa sugli stessi sette concetti. Familiarizza con questi, e il resto dell'articolo sarà molto più chiaro.
Immagina un robot aspirapolvere che impara a pulire una stanza. Userò questo esempio per tutti i termini seguenti.
L'agente è il decisore - nel nostro esempio, l'aspirapolvere robot. L'ambiente è tutto ciò con cui interagisce, come la stanza, i mobili, lo sporco, i muri contro cui può urtare.
L'agente non controlla l'ambiente, ma sceglie le azioni, e l'ambiente decide cosa succede dopo.
Lo stato descrive la condizione completa dell'ambiente in un dato momento, come la posizione esatta di ogni chiazza di sporco e la posizione dell'aspirapolvere. Nella pratica, gli agenti raramente hanno accesso certo a queste informazioni.
Invece, agiscono su un'osservazione, cioè su ciò che possono effettivamente vedere, come un feed di una telecamera o un set di sensori di prossimità.
In ambienti semplici, osservazione e stato sono praticamente la stessa cosa. In quelli più complessi, l'agente lavora con informazioni parziali e deve colmare le lacune.
Le azioni sono le mosse disponibili all'agente in un dato momento. Per l'aspirapolvere, potrebbero essere avanzare, girare a sinistra, girare a destra o attivare l'aspirazione.
Le azioni possono essere discrete, con l'agente che sceglie da un elenco fisso, o continue, con l'agente che sceglie un valore lungo un intervallo, come un angolo di sterzata. Questa distinzione conta molto quando si arriva alle diverse famiglie di algoritmi più avanti nell'articolo.
Una ricompensa è il feedback numerico che l'agente riceve dopo aver intrapreso un'azione. Se l'aspirapolvere pulisce una nuova porzione di pavimento, potrebbe ricevere una ricompensa di +1. Ma se urta un muro, potrebbe ricevere -1.
L'obiettivo dell'agente è massimizzare la ricompensa totale raccolta nel tempo, non solo quella della prossima singola azione.
Una policy è la strategia dell'agente per mappare stati, o osservazioni, in azioni. È il regolamento che l'agente segue per decidere cosa fare dopo.
Una policy può essere deterministica, scegliendo sempre la stessa azione per un dato stato, o stocastica, scegliendo azioni in base a una distribuzione di probabilità. Gli algoritmi di deep RL spesso rappresentano questa policy con una rete neurale.
Una funzione valore stima quanta ricompensa futura l'agente si può aspettare di raccogliere a partire da un dato stato, se continua a seguire la policy corrente.
Una funzione Q-value fa la stessa cosa per una coppia stato-azione. Stima la ricompensa futura dal compiere una specifica azione in uno specifico stato, e poi seguire la policy.
Questo è il tipo di funzione che una rete neurale approssima bene. È la stessa idea che ho introdotto quando ho sostituito la tabella di lookup all'inizio dell'articolo.
Un episodio è un'esecuzione completa dell'agente nell'ambiente, dallo stato iniziale fino a una condizione di termine. Per l'aspirapolvere, potrebbe essere quando la stanza è completamente pulita o quando la batteria si esaurisce.
Una volta terminato un episodio, l'ambiente si resetta e ne inizia uno nuovo.
Un agente che ripete solo ciò che ha già funzionato non troverà mai qualcosa di migliore.
Immagina di nuovo l'aspirapolvere. Incappa in un percorso che pulisce una buona parte della stanza e continua a seguire sempre quello. Non controlla mai l'angolo dietro il divano. Questo è il trade-off al centro dell'apprendimento per rinforzo:
Un modo comune per bilanciare le due è l'esplorazione epsilon-greedy. A ogni passo, l'agente sceglie un'azione casuale con probabilità epsilon, un numero piccolo come 0,1, e altrimenti sceglie l'azione che al momento ritiene migliore. Molti algoritmi fanno decadere epsilon nel tempo: l'agente esplora molto all'inizio, poi punta di più sull'exploit quando ha imparato abbastanza da fidarsi del proprio giudizio.
Non esiste un epsilon fisso che funzioni per ogni ambiente.
Troppa esplorazione fa perdere tempo in azioni che continuano a fallire. Troppa poca esplorazione porta l'agente ad accontentarsi di una strategia discreta mentre una migliore è lì vicino, non scoperta. Trovare il giusto equilibrio diventa ancora più difficile via via che l'ambiente si fa più complesso, soprattutto quando un'azione sbagliata all'inizio non rivela il suo vero costo fino a molti passi dopo.
Ogni algoritmo di deep RL rientra in una di tre famiglie, in base a ciò che apprende realmente: una funzione valore, una policy o entrambe insieme.
DQN prende la funzione Q-value menzionata prima e sostituisce la tabella di lookup con una rete neurale. La rete prende uno stato in input e produce un Q-value per ogni possibile azione, imparando come una normale rete neurale impara qualsiasi altra cosa.
Addestrare direttamente quella rete non è consigliato. Le esperienze consecutive sono correlate, il che porta la rete a sovra-adattarsi a ciò che ha appena visto, e il target a cui mira cambia ogni volta che la rete si aggiorna.
DQN risolve entrambi i problemi:
DQN è stato importante perché è stato il primo algoritmo a imparare policy di controllo direttamente dai pixel grezzi su un'ampia gamma di giochi Atari, usando la stessa architettura e gli stessi iperparametri per ciascuno. Quando DeepMind lo ha pubblicato nel 2015, ha dimostrato che deep learning e apprendimento per rinforzo potevano davvero funzionare insieme su larga scala, senza feature costruite a mano per ogni gioco.
Invece di apprendere una funzione valore e scegliere le azioni in base ad essa, i metodi a gradiente di policy apprendono direttamente la policy. La rete prende uno stato e produce probabilità per le azioni, e l'agente campiona un'azione da quella distribuzione.
Questo approccio si adatta ad azioni continue o stocastiche.
Un metodo basato sul valore deve verificare ogni possibile azione per trovare la migliore, cosa che va in crisi non appena lo spazio delle azioni diventa continuo: non puoi scorrere un intervallo infinito di angoli di sterzata. Un metodo a gradiente di policy semplicemente campiona dalla distribuzione, a prescindere da quante azioni esistano.
REINFORCE è l'algoritmo fondativo qui. Esegue un episodio completo, poi aumenta la probabilità delle azioni che hanno portato a un'alta ricompensa totale e diminuisce la probabilità delle azioni che hanno portato a una ricompensa bassa. Il problema è che aggiorna solo dopo la fine dell'episodio e si basa sul ritorno completo, il che rende gli aggiornamenti rumorosi e incoerenti da un episodio all'altro.
I metodi actor-critic risolvono il problema del rumore di REINFORCE aggiungendo una seconda rete.
L'actor è la policy - sceglie le azioni come farebbe un metodo a gradiente di policy. Il critic è una funzione valore che giudica ciascuna azione subito dopo che avviene, invece di aspettare la fine dell'episodio.
Qui lavorano insieme gli approcci basati sul valore e sulla policy. L'actor continua a imparare una policy, ma si aggiorna in base al giudizio del critic su ogni azione, non sul ritorno ritardato e rumoroso su cui si basa REINFORCE.
A2C e A3C sono gli esempi standard. A2C esegue alcune copie dell'ambiente in parallelo e aggiorna actor e critic insieme alla fine di ogni batch. A3C esegue quelle copie in modo asincrono, con ognuna che aggiorna la rete condivisa secondo la propria tempistica invece di aspettare le altre.
Gli aggiornamenti del gradiente di policy possono andare male se li lasci diventare troppo grandi. Un aggiornamento abbastanza ampio può rovinare una policy che funzionava bene, e non c'è modo di annullarlo una volta accaduto.
PPO limita l'ampiezza di ogni aggiornamento per evitarlo. Ecco l'obiettivo troncato che ottimizza:
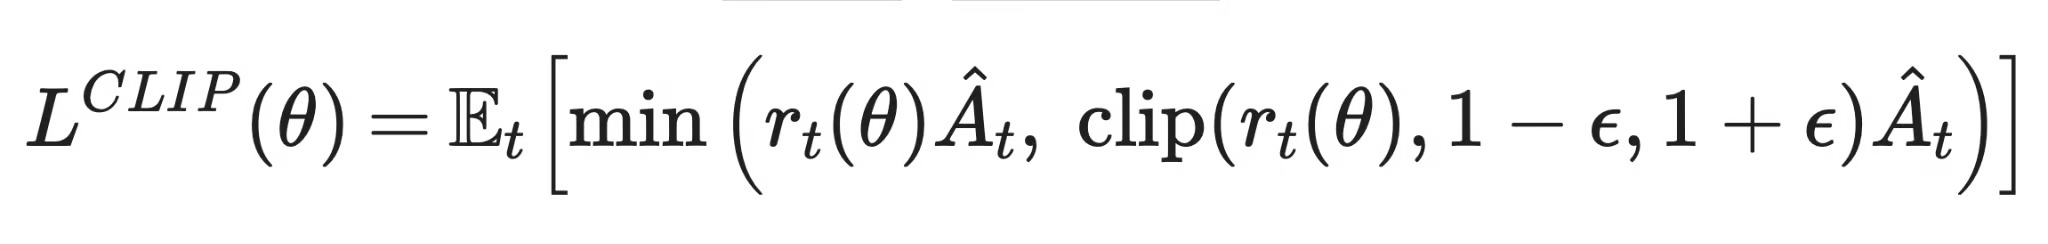
Proximal policy optimization
r_t(θ) è il rapporto tra la probabilità di un'azione secondo la nuova policy e la probabilità della stessa azione secondo la policy vecchia. Â_t è il vantaggio, ovvero quanto meglio è andata quell'azione rispetto alle aspettative di base del critic. La funzione clip() mantiene il rapporto entro una stretta banda attorno a 1, così la policy non può cambiare troppo in un singolo passo. Poi min() sceglie la stima più conservativa tra le due, in modo che un vantaggio insolitamente grande non spinga l'aggiornamento oltre quanto consentito dal clipping.
OpenAI ha introdotto PPO nel 2017, e quasi subito è diventato una scelta di default. È più semplice da implementare e tarare rispetto ai metodi a regione di fiducia che lo hanno preceduto, e regge bene su molti ambienti senza troppi aggiustamenti specifici per compito.
DDPG e Soft Actor-Critic (SAC) si rivolgono entrambi a problemi di controllo continuo, come gli angoli delle articolazioni robotiche o i valori di sterzata, dove l'agente deve emettere un numero specifico invece di scegliere da una distribuzione.
DDPG è un metodo actor-critic in cui l'actor produce una singola azione deterministica piuttosto che una distribuzione, e prende in prestito l'experience replay e le reti target da DQN.
SAC si basa sulla stessa idea ma aggiunge un termine di entropia che premia la policy per restare un po' casuale, mantenendo l'agente in esplorazione più a lungo e rendendo l'addestramento in genere più stabile rispetto a DDPG.
I metodi value-based, come DQN, apprendono una funzione Q-value e scelgono l'azione con valutazione più alta. Funzionano bene per spazi di azione discreti e sono efficienti in termini di campioni grazie all'experience replay, ma non si estendono alle azioni continue senza lavoro extra.
I metodi policy-based, come REINFORCE, apprendono direttamente la policy, campionando le azioni da una distribuzione di probabilità. È ciò che li rende adatti ad azioni continue e stocastiche, ma i semplici aggiornamenti a gradiente di policy sono rumorosi e richiedono dati nuovi per ogni aggiornamento.
I metodi actor-critic, tra cui A2C/A3C, PPO, DDPG e SAC, combinano entrambe le idee. Il feedback rapido del critic stabilizza gli aggiornamenti dell'actor, motivo per cui la maggior parte degli algoritmi usati oggi in pratica rientra in questa categoria.
Ecco un confronto più visivo:
| Cosa si apprende | Come si selezionano le azioni | Discreto vs continuo | Stabilità | Efficienza in termini di campioni | Algoritmi rappresentativi | |
|---|---|---|---|---|---|---|
| Value-based | Funzione Q-value | Azione con punteggio più alto | Discreto | Richiede reti target e replay per restare stabile | Buona, grazie all'experience replay | DQN |
| Policy-based | Policy | Campionata dalla distribuzione della policy | Entrambi, migliore con il continuo | Aggiornamenti rumorosi, ad alta varianza | Scarsa, richiede dati nuovi per ogni aggiornamento | REINFORCE |
| Actor-critic | Policy e funzione valore | Campionata dall'actor, guidata dal critic | Entrambi | Più stabile dei metodi puramente policy-based | Migliore dei metodi puramente policy-based | A2C/A3C, PPO, DDPG, SAC |
Confronto tra metodi di deep reinforcement learning
Nel supervised learning ogni esempio ha una risposta etichettata. Nel deep RL bisogna capire cosa ha funzionato da un segnale di ricompensa che arriva in ritardo, si mescola con le azioni precedenti e talvolta non si manifesta affatto in modo utile.
Gli agenti di deep RL spesso hanno bisogno di milioni di passi d'ambiente prima di imparare qualcosa di utile, soprattutto rispetto alla poca quantità di dati che basta a un modello supervisionato per raggiungere un'accuratezza simile su un dataset fisso.
Il motivo è che l'agente deve generare i propri dati di training agendo, e molte di quelle azioni all'inizio sono quasi casuali. Un modello supervisionato può riutilizzare lo stesso dataset etichettato all'infinito. Un agente RL deve continuare a esplorare un ambiente che capisce a malapena, un passo alla volta.
L'addestramento RL è spesso instabile.
Parte del problema è che le funzioni valore fanno bootstrap sulle proprie stime, per cui il target del Q-value di oggi dipende dalla stima del Q-value di ieri. Se quella stima è sbagliata, l'errore si accumula invece di correggersi. Inoltre, la policy dell'agente cambia man mano che impara, quindi anche i dati che raccoglie cambiano continuamente.
In altre parole, la rete insegue un bersaglio in movimento su due fronti contemporaneamente.
Alcuni ambienti distribuiscono una ricompensa solo alla fine, come un segnale di vittoria o sconfitta dopo una lunga partita. L'agente deve risalire a ritroso da quel singolo numero e capire quali tra le decine di azioni compiute hanno davvero contato.
Questo è chiamato problema dell'assegnazione del credito, e peggiora quanto più lungo è il ritardo tra un'azione e la sua conseguenza.
Progettare le ricompense sembra facile finché non ci provi.
Ecco un esempio famoso. Un agente di gare in barca addestrato da OpenAI veniva ricompensato per colpire i checkpoint, quindi ha trovato una laguna con power-up che ricomparivano e ci ha girato in tondo all'infinito, accumulando punti senza mai finire la gara. La funzione di ricompensa ha fatto esattamente ciò per cui era stata scritta - semplicemente all'agente non era stato detto cosa significasse davvero "vincere". Questa differenza tra ciò che ricompensi e ciò che in realtà vuoi è chiamata reward hacking, e si presenta in qualche forma in quasi ogni funzione di ricompensa che scrivi.
Lo stesso algoritmo, eseguito con un seed casuale diverso, può produrre risultati differenti.
Risultati pubblicati sono difficili da riprodurre senza l'esatto codice, gli iperparametri e i seed usati dai ricercatori originali. Piccoli dettagli implementativi, come come vengono normalizzate le osservazioni o come viene inizializzato il buffer di replay, possono influenzare le prestazioni più della scelta dell'algoritmo.
Un simulatore consente a un agente di fallire all'infinito, tutte le volte necessarie. Il mondo reale non funziona così.
Per esempio, una policy di guida autonoma che esplora un'azione sbagliata in autostrada mette a rischio le persone. I simulatori non catturano mai il mondo reale in modo perfetto: i casi limite che il simulatore non ha modellato compaiono non appena la policy esce dal laboratorio. Una policy che in simulazione sembra ottima può fallire in modi imprevedibili quando incontra un ambiente reale, ecco perché distribuire il deep RL fuori da giochi e simulatori richiede molta più cautela di quanto suggeriscano i numeri di benchmark.
Ora evidenzierò le differenze tra deep reinforcement learning e approcci più tradizionali.
Il supervised learning si addestra su esempi etichettati, dove ogni input ha già una risposta corretta. Il deep RL non lo ottiene mai: riceve solo una ricompensa dopo aver agito e deve capire da solo quali azioni hanno portato a quella ricompensa.
L'imitation learning addestra una policy a copiare le dimostrazioni di un esperto, senza usare alcun segnale di ricompensa. Il deep RL scopre il comportamento tramite tentativi ed errori.
L'imitation learning mette in piedi una policy rapidamente, ma è limitato dalla qualità delle dimostrazioni e fatica nel momento in cui l'agente si trova in una situazione che l'esperto non ha mai mostrato. Il deep RL può, in teoria, superare le prestazioni di qualsiasi insegnante, ma richiede molte più interazioni e una funzione di ricompensa che effettivamente indirizzi verso il comportamento desiderato.
Gli algoritmi evolutivi ottimizzano una policy mutando una popolazione di candidati e mantenendo quelli con prestazioni migliori, senza alcun calcolo di gradienti. Il deep RL calcola gradienti dal segnale di ricompensa e aggiorna una singola policy.
I metodi evolutivi si parallelizzano bene, poiché ogni candidato nella popolazione può essere eseguito indipendentemente. Ma in genere richiedono molte più interazioni totali con l'ambiente rispetto al deep RL basato su gradienti per raggiungere lo stesso livello di prestazioni.
Il deep RL punisce le scorciatoie più di molti altri campi. Tenendo questo a mente, ecco alcune best practice da ricordare per il tuo prossimo progetto:
Il deep reinforcement learning prende il ciclo di tentativi ed errori alla base dell'RL e lo combina con una rete neurale in grado di gestire stati che nessuna tabella potrebbe mai contenere.
Ogni algoritmo in questo articolo rientra in una delle tre famiglie. I metodi value-based, come DQN, apprendono una funzione Q-value e scelgono l'azione con punteggio più alto. I metodi policy-based, come REINFORCE, apprendono direttamente una policy. I metodi actor-critic, incluso PPO, combinano entrambi, e questa combinazione è ciò che la maggior parte degli algoritmi usa oggi.
Tieni solo presente che nulla di tutto questo è gratuito.
Stabilità dell'addestramento, efficienza in termini di campioni, progettazione della ricompensa e riproducibilità diventano tutti più difficili nel momento in cui passi da una tabella a una rete. Se vuoi approfondire, Q-learning e apprendimento per rinforzo coprono le basi su cui si fonda questo articolo, e DQN e PPO sono ottime prossime tappe per gli algoritmi stessi.
Impara con DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min