Cursus
Artificial Intelligence begrijpen
2 Hr
421.1K
Traditioneel reinforcement learning werkt niet echt meer zodra je omgeving te groot wordt om handmatig bij te houden. De reden is dat elke toestand een eigen regel in een tabel nodig heeft, en elke actie vanuit elke toestand een eigen waarde.
Een gamescherm levert bijvoorbeeld miljoenen pixelcombinaties op, die simpelweg niet in een tabel passen waar je doorheen kunt lopen. De agent moet de waarde raden van een toestand die hij nog nooit heeft gezien, op basis van toestanden die erop lijken.
Deep reinforcement learning lost dit op door de tabel te vervangen door een neuraal netwerk dat de waarde van een toestand of de beste te nemen actie inschat, zelfs voor situaties die het nog niet direct is tegengekomen. Dat is wat agents Go laat beheersen en gesimuleerde drones laat vliegen — taken waarbij klassieke RL-algoritmen zouden vastlopen.
In dit artikel neem ik je mee langs de kernconcepten van deep RL, de belangrijkste algoritmefamilies zoals DQN en PPO, en waar je ze in de echte wereld tegenkomt.
Als je nieuw bent met reinforcement learning, schrijf je dan in voor onze Reinforcement Learning in Python-track om in een weekend de basis onder de knie te krijgen.
Deep reinforcement learning is reinforcement learning met een neuraal netwerk in plaats van de opzoektabel.
Reinforcement learning geeft je al de basislus waarin een agent een actie probeert, kijkt wat er gebeurt en bijstuurt op basis van de beloning. Deep learning voegt een netwerk toe dat ruwe input kan omzetten in iets waar de agent op kan handelen. In combinatie leert de agent welke acties het beste werken direct uit ruwe data, zonder dat iemand vooraf codeert wat elke toestand betekent.
Stel je voor dat je een agent traint om een spel als Breakout te spelen. De agent krijgt geen nette lijst met "balpositie" of "paddle-positie" — hij krijgt ruwe pixels van het scherm. Een tabellaire methode zou een aparte rij nodig hebben voor elke mogelijke pixelcombinatie, en dat aantal is onhandelbaar. Een neuraal netwerk kijkt rechtstreeks naar de pixels en geeft aan welke actie te nemen, of hoe goed elke actie lijkt, zonder dat het dat exacte scherm eerder heeft gezien.
Kort gezegd: tabellaire methoden memoriseren, netwerken generaliseren.
Dat is wat deep RL laat werken in omgevingen die te groot of te rommelig zijn voor een tabel.
Elk deep-RL-systeem doorloopt dezelfde lus, ongeacht welk algoritme eronder ligt.
Zo gaat het:
Het schema hieronder laat deze lus in actie zien:
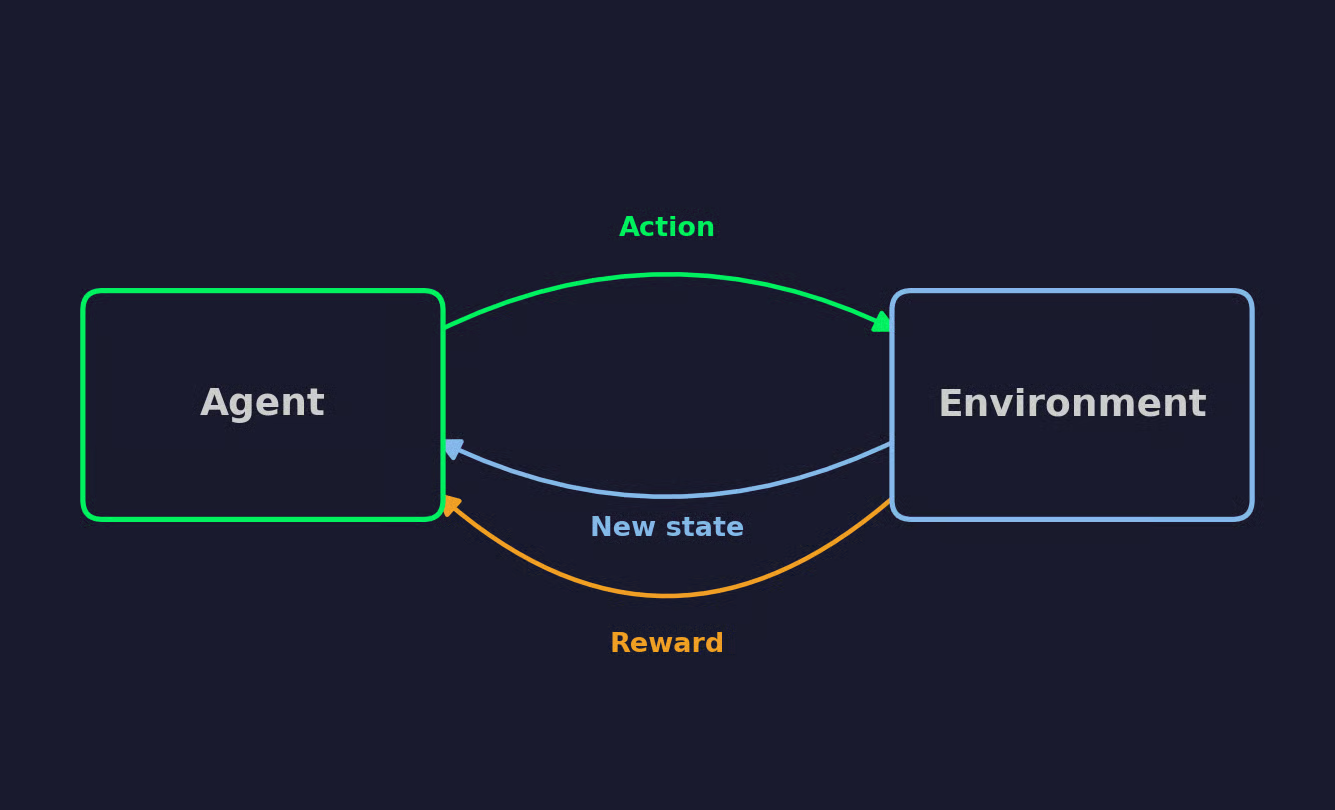
Reinforcement-learninglus
Als je deze lus vaak genoeg herhaalt, verschuift het gedrag van de agent richting de acties die de beloning maximaal houden.
Elk deep-RL-algoritme bouwt voort op dezelfde zeven ideeën. Als je daar vertrouwd mee raakt, valt de rest van het artikel veel beter op zijn plek.
Stel je een robotstofzuiger voor die leert een kamer schoon te maken. Dat voorbeeld gebruik ik bij alle termen hieronder.
De agent is de beslisser — in ons voorbeeld de robotstofzuiger. De omgeving is alles waarmee hij interageert, zoals de kamer, het meubilair, het vuil, de muren waar hij tegenaan kan botsen.
De agent bestuurt de omgeving niet, maar kiest acties, en de omgeving bepaalt wat er daarna gebeurt.
De toestand beschrijft de volledige stand van de omgeving op een bepaald moment, zoals de exacte positie van elke vuilplek en de locatie van de stofzuiger. Echte agents krijgen daar zelden met zekerheid toegang toe.
In plaats daarvan handelen ze op basis van een observatie: wat de agent daadwerkelijk kan zien, zoals een camerabeeld of een set nabijheidssensoren.
In eenvoudige omgevingen zijn observatie en toestand praktisch hetzelfde. In complexere omgevingen werkt de agent met gedeeltelijke informatie en moet hij de gaten invullen.
Acties zijn de zetten die de agent op een bepaald moment kan doen. Voor de stofzuiger kan dat betekenen: vooruit bewegen, linksaf, rechtsaf, of de zuigkracht activeren.
Acties kunnen discreet zijn, waarbij de agent kiest uit een vaste lijst, of continu, waarbij de agent een waarde langs een bereik kiest, zoals een stuurhoek. Dit onderscheid is later in het artikel belangrijk bij de verschillende algoritmefamilies.
Een beloning is de numerieke feedback die de agent krijgt na een actie. Als de stofzuiger een nieuw stuk vloer schoonmaakt, kan hij een beloning van +1 krijgen. Maar als hij tegen een muur botst, misschien -1.
Het hele doel van de agent is om de totale beloning over de tijd te maximaliseren, niet alleen de beloning van de eerstvolgende actie.
Een policy is de strategie van de agent om toestanden — of observaties — naar acties te mappen. Het is het regelboek dat de agent volgt om te beslissen wat hij hierna doet.
Een policy kan deterministisch zijn, waarbij steeds dezelfde actie voor een gegeven toestand wordt gekozen, of stochastisch, waarbij acties worden gekozen op basis van een kansverdeling. Deep-RL-algoritmen gebruiken vaak een neuraal netwerk om deze policy te representeren.
Een waardefunctie schat hoeveel toekomstige beloning de agent kan verwachten vanuit een gegeven toestand, als hij zijn huidige policy blijft volgen.
Een Q-waardefunctie doet hetzelfde voor een toestand-actie-paar. Ze schat de toekomstige beloning van het nemen van een specifieke actie in een specifieke toestand, en daarna de policy volgen.
Dit is precies het soort functie dat een neuraal netwerk goed kan benaderen. Het is hetzelfde idee als toen ik eerder in het artikel de opzoektabel verving.
Een episode is één volledige run van de agent door de omgeving, van de starttoestand tot een eindconditie. Voor de stofzuiger kan dat betekenen: de kamer is helemaal schoon of de batterij is leeg.
Na het einde van een episode wordt de omgeving gereset en begint er een nieuwe.
Een agent die alleen herhaalt wat al werkte, zal nooit iets beters vinden.
Denk weer aan de stofzuiger. Hij stuit op een route die een aardig deel van de kamer schoonmaakt en blijft diezelfde route elke keer rijden. Hij kijkt nooit achter de bank. Dat is de kerntrade-off in reinforcement learning:
Een veelgebruikte manier om beide te balanceren is epsilon-greedy exploratie. Bij elke stap kiest de agent met kans epsilon, een klein getal zoals 0,1, een willekeurige actie, en anders de actie waarvan hij nu denkt dat die het beste is. Veel algoritmen laten epsilon in de tijd afnemen: de agent verkent in het begin veel en leunt later meer op exploitatie zodra hij genoeg heeft geleerd om zijn eigen oordeel te vertrouwen.
Er is geen vaste epsilon die in elke omgeving werkt.
Te veel exploratie verspilt tijd aan acties die blijven falen. Te weinig exploratie betekent dat de agent genoegen neemt met een aardige strategie terwijl er vlak naast een betere ligt, onontdekt. De juiste balans wordt alleen maar lastiger naarmate de omgeving complexer wordt, zeker als een slechte vroege actie zijn echte kostprijs pas veel stappen later laat zien.
Elk deep-RL-algoritme valt in een van drie families, gebaseerd op wat het daadwerkelijk leert: een waardefunctie, een policy, of allebei tegelijk.
DQN neemt de Q-waardefunctie van eerder in dit artikel en vervangt de opzoektabel door een neuraal netwerk. Het netwerk neemt een toestand als input en geeft een Q-waarde voor elke mogelijke actie als output, geleerd op dezelfde manier als een standaard neuraal netwerk iets leert.
Dat netwerk direct trainen is niet aan te raden. Opeenvolgende ervaringen zijn gecorreleerd, waardoor het netwerk overfit op wat het net zag, en het doel waarnaar het streeft verandert elke keer dat het netwerk wordt bijgewerkt.
DQN lost beide problemen op:
DQN was belangrijk omdat het het eerste algoritme was dat controlepolicies direct leerde uit ruwe pixels over een groot aantal Atari-games, met dezelfde architectuur en hyperparameters voor elk spel. Toen DeepMind het in 2015 publiceerde, bewees het dat deep learning en reinforcement learning op schaal samen konden werken, zonder handgemaakte features voor elk spel.
In plaats van een waardefunctie te leren en daaruit acties te kiezen, leren policy-gradientmethoden de policy zelf. Het netwerk neemt een toestand en geeft actiekansen als output, en de agent samplet een actie uit die verdeling.
Deze aanpak past bij continue of stochastische acties.
Een waardegedreven methode moet elke mogelijke actie controleren om de beste te vinden, wat instort zodra de actieruimte continu wordt — je kunt niet door een oneindig bereik aan stuurhoeken itereren. Een policy-gradientmethode samplet gewoon uit de verdeling, ongeacht hoeveel acties er bestaan.
REINFORCE is hier het basisalgoritme. Het draait een volledige episode en verhoogt dan de kans op acties die tot hoge totale beloning leidden en verlaagt de kans op acties die tot lage totale beloning leidden. Het nadeel is dat het pas bijwerkt na het einde van de episode en vertrouwt op de volledige return, waardoor updates ruisachtig en inconsistent zijn tussen episodes.
Actor-criticmethoden lossen het ruisprobleem van REINFORCE op door een tweede netwerk toe te voegen.
De actor is de policy — hij kiest acties zoals een policy-gradientmethode dat zou doen. De critic is een waardefunctie die elke actie direct na het uitvoeren beoordeelt, in plaats van te wachten tot de episode klaar is.
Dit is de waardegedreven en policy-gedreven benadering die samenwerken. De actor leert nog steeds een policy, maar werkt bij op basis van het oordeel van de critic over elke actie, niet op de vertraagde, ruisachtige return waar REINFORCE op leunt.
A2C en A3C zijn de standaardvoorbeelden. A2C draait een paar kopieën van de omgeving parallel en werkt de actor en critic samen bij zodra elke batch klaar is. A3C draait die kopieën asynchroon, waarbij elke kopie het gedeelde netwerk op zijn eigen tempo bijwerkt in plaats van op de anderen te wachten.
Policy-gradientupdates kunnen misgaan als je ze te groot laat worden. Een grote update kan een policy die prima werkte verknallen, en dat is niet terug te draaien zodra het gebeurd is.
PPO beperkt de grootte van elke update om dat te voorkomen. Dit is de geclipte objective die het optimaliseert:
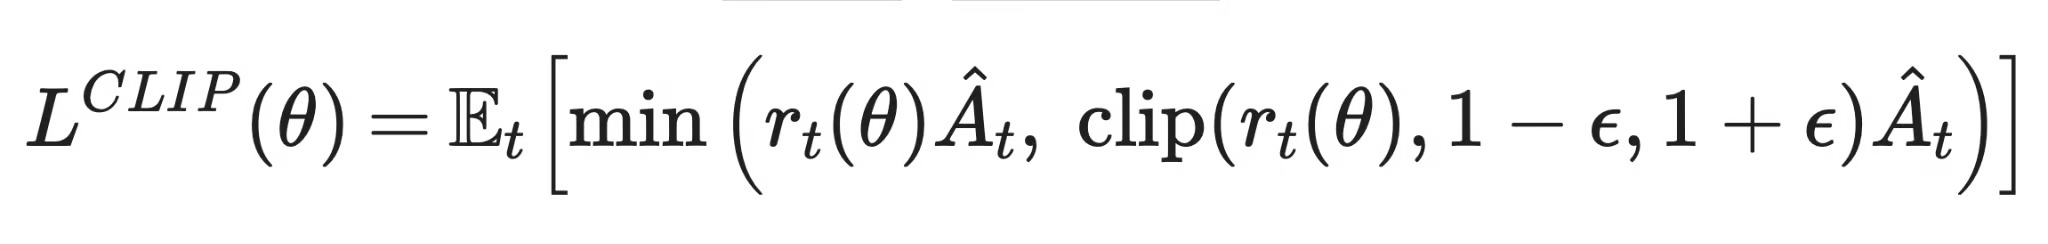
Proximal policy optimization
r_t(θ) is de verhouding tussen de kans van de nieuwe policy op een actie en de kans van de oude policy op diezelfde actie. Â_t is het voordeel (advantage), of hoeveel beter die actie uitpakte ten opzichte van de baselineverwachting van de critic. De clip() functie houdt de ratio binnen een smalle band rond 1, zodat de policy niet te ver kan verschuiven in één stap. De min() kiest vervolgens de meer conservatieve van de twee schattingen, zodat een uitzonderlijk grote advantageschatting de update niet verder kan duwen dan de clip toelaat.
OpenAI introduceerde PPO in 2017, en het werd vrijwel meteen een standaardkeuze. Het is eenvoudiger te implementeren en af te stemmen dan de trust-region-methoden die eraan voorafgingen, en het houdt stand in een brede set omgevingen zonder veel aanpassing per taak.
DDPG en Soft Actor-Critic (SAC) richten zich beide op continue-regelproblemen, zoals robotische gewrichtshoeken of stuurwaarden, waar de agent een specifiek getal moet uitgeven in plaats van te kiezen uit een verdeling.
DDPG is een actor-criticmethode waarvan de actor één deterministische actie uitgeeft in plaats van een verdeling, en het leent experience replay en targetnetwerken van DQN.
SAC bouwt voort op datzelfde idee maar voegt een entropieterm toe die de policy beloont voor enigszins willekeurig blijven, wat de agent langer laat exploreren en de training doorgaans stabieler maakt dan bij DDPG.
Value-based methoden, zoals DQN, leren een Q-waardefunctie en kiezen welke actie die functie het hoogst beoordeelt. Dit werkt goed voor discrete actieruimtes en haalt dankzij experience replay een goede sample-efficiëntie, maar strekt zich niet zonder extra werk uit naar continue acties.
Policy-based methoden zoals REINFORCE leren de policy direct en sampelen acties uit een kansverdeling. Daardoor werken ze met continue en stochastische acties, maar pure policy-gradientupdates zijn ruisachtig en hebben voor elke update nieuwe data nodig.
Actor-criticmethoden, waaronder A2C/A3C, PPO, DDPG en SAC, combineren beide ideeën. De snelle feedback van de critic stabiliseert de updates van de actor, en daarom valt het merendeel van de in de praktijk gebruikte algoritmen vandaag in deze categorie.
Hier is een visuelere vergelijking:
| Wat wordt geleerd | Hoe acties worden gekozen | Discreet vs. continu | Stabiliteit | Sample-efficiëntie | Representatieve algoritmen | |
|---|---|---|---|---|---|---|
| Value-based | Q-waardefunctie | Hoogst beoordeelde actie | Discreet | Heeft targetnetwerken en replay nodig om stabiel te blijven | Goed, dankzij experience replay | DQN |
| Policy-based | Policy | Gesampled uit de verdeling van de policy | Beide, het best bij continu | Ruisachtige, hoge-variantie-updates | Slecht, heeft voor elke update nieuwe data nodig | REINFORCE |
| Actor-critic | Policy en waardefunctie | Gesampled van de actor, geleid door de critic | Beide | Stabieler dan pure policy-based methoden | Beter dan pure policy-based methoden | A2C/A3C, PPO, DDPG, SAC |
Vergelijking van deep-reinforcement-learningmethoden
Supervised learning krijgt een gelabeld antwoord voor elk voorbeeld. Deep RL moet uitzoeken wat werkte op basis van een beloningssignaal dat laat verschijnt, wordt samengevoegd met de acties ervoor, en soms helemaal niet op een nuttige manier opduikt.
Deep-RL-agents hebben vaak miljoenen omgevingsstappen nodig voordat ze iets nuttigs leren, zeker vergeleken met hoeveel minder data een supervised model nodig heeft om vergelijkbare nauwkeurigheid te halen op een vast dataset.
De reden is dat de agent zijn eigen trainingsdata moet genereren door te handelen, en de meeste van die vroege acties zijn bijna willekeurig. Een supervised model mag dezelfde gelabelde dataset keer op keer hergebruiken. Een RL-agent moet een omgeving blijven verkennen die hij amper begrijpt, stap voor stap.
RL-training is vaak instabiel.
Een deel van het probleem is dat waardefuncties op hun eigen schattingen voortbouwen: het Q-waardedoel van vandaag hangt af van de Q-waardeschatting van gisteren. Als die schatting verkeerd is, stapelt de fout zich op in plaats van zichzelf te corrigeren. Bovendien verandert de policy van de agent voortdurend tijdens het leren, dus verschuiven de data die hij verzamelt ook steeds.
Met andere woorden: het netwerk jaagt op twee fronten tegelijk een bewegend doel na.
Sommige omgevingen delen pas aan het eind een beloning uit, zoals een winst- of verlies-signaal na een lang spel. De agent moet vanaf dat ene getal terugredeneren en uitzoeken welke van de tientallen acties die hij nam er echt toe deden.
Dit heet het credit assignment-probleem, en het wordt erger naarmate de vertraging tussen een actie en het gevolg ervan langer is.
Beloningsontwerp klinkt makkelijk tot je het probeert.
Hier is een beroemd voorbeeld. Een door OpenAI getrainde bootrace-agent werd beloond voor het raken van checkpoints, dus vond hij een lagune met respawnende power-ups en reed daar eindeloos rond, scoorde punten zonder ooit de race te finishen. De beloningsfunctie deed precies wat haar was opgedragen — alleen was de agent niet verteld wat "winnen" eigenlijk betekende. Dit verschil tussen wat je beloont en wat je daadwerkelijk wilt, heet reward hacking, en het duikt in een of andere vorm op bij vrijwel elke beloningsfunctie die je schrijft.
Datzelfde algoritme kan met een andere random seed andere resultaten opleveren.
Gepubliceerde resultaten zijn moeilijk te reproduceren zonder precies die codebase, hyperparameters en seeds die de oorspronkelijke onderzoekers gebruikten. Kleine implementatiedetails, zoals hoe observaties worden genormaliseerd of hoe de replaybuffer wordt geïnitialiseerd, kunnen de prestaties meer verschuiven dan de keuze van het algoritme zelf.
In een simulator mag een agent zo vaak gratis falen als nodig. De echte wereld werkt niet zo.
Een zelfrijdende policy die op een snelweg een slechte actie verkent, brengt bijvoorbeeld mensen in gevaar. Simulators vangen de echte wereld nooit perfect; randgevallen die de simulator niet modelleerde, duiken meteen op zodra de policy het lab verlaat. Een policy die er in simulatie geweldig uitziet, kan in de echte omgeving op onvoorziene manieren falen — daarom vergt deep RL buiten games en simulators inzetten veel meer voorzichtigheid dan benchmarkcijfers suggereren.
Ik licht nu de verschillen toe tussen deep reinforcement learning en meer traditionele benaderingen.
Supervised learning traint op gelabelde voorbeelden, waarbij elke input al een correct antwoord heeft. Deep RL krijgt dat nooit — het krijgt pas een beloning na het handelen en moet zelf uitzoeken welke acties tot die beloning leidden.
Imitation learning traint een policy om de demonstraties van een expert te kopiëren, zonder ooit een beloningssignaal te gebruiken. Deep RL ontdekt gedrag in plaats daarvan via trial-and-error.
Imitation learning krijgt snel een policy up-and-running, maar wordt begrensd door de kwaliteit van de demonstraties en worstelt zodra de agent in een situatie komt die de expert nooit liet zien. Deep RL kan in theorie elke leraar overtreffen, maar heeft veel meer interactie nodig en een beloningsfunctie die daadwerkelijk richting het gewenste gedrag wijst.
Evolutionaire algoritmen optimaliseren een policy door een populatie kandidaten te muteren en de best presterenden te behouden, zonder enige gradiëntberekening. Deep RL berekent gradiënten op basis van het beloningssignaal en werkt één enkele policy bij.
Evolutionaire methoden laten zich goed paralleliseren, omdat elke kandidaat in de populatie onafhankelijk kan draaien. Maar ze hebben doorgaans veel meer totale omgevingsinteracties nodig dan gradiëntgebaseerde deep RL om hetzelfde prestatieniveau te bereiken.
Deep RL straft shortcuts meer dan de meeste andere velden. Met dat in het achterhoofd, hier een paar best practices voor je volgende project:
Deep reinforcement learning combineert de trial-and-error-lus in de kern van RL met een neuraal netwerk dat toestanden aankan waar geen enkele opzoektabel tegenop kan.
Elk algoritme in dit artikel valt in een van drie families. Value-based methoden, zoals DQN, leren een Q-waardefunctie en kiezen de actie met de hoogste score. Policy-based methoden, zoals REINFORCE, leren direct een policy. Actor-criticmethoden, waaronder PPO, combineren beide, en die combinatie is wat de meeste algoritmen vandaag gebruiken.
Houd er wel rekening mee dat niets hiervan gratis is.
Trainingsstabiliteit, sample-efficiëntie, beloningsontwerp en reproduceerbaarheid worden allemaal lastiger zodra je van een tabel naar een netwerk gaat. Wil je dieper gaan, dan behandelen Q-learning en reinforcement learning de fundamenten waarop dit artikel voortbouwt, en DQN en PPO zijn goede volgende stappen voor de algoritmen zelf.
Leren met DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min