Curso
Comprender la inteligencia artificial
2 h
421.1K
El aprendizaje por refuerzo tradicional se queda corto cuando el entorno es demasiado grande para llevarlo "a mano". La razón es que cada estado necesita su propia entrada en una tabla y cada acción desde cada estado su propio valor.
Por ejemplo, la pantalla de un juego genera millones de combinaciones de píxeles, que no caben en una tabla que puedas recorrer. El agente tiene que estimar el valor de un estado que nunca ha visto basándose en otros estados similares.
El aprendizaje por refuerzo profundo soluciona esto sustituyendo la tabla por una red neuronal que estima el valor de un estado o la mejor acción a tomar, incluso en situaciones que no ha encontrado directamente. Gracias a esto, los agentes pueden dominar Go o pilotar drones simulados, tareas que harían saltar por los aires cualquier algoritmo clásico de RL.
En este artículo te explico los conceptos clave de RL profundo, las principales familias de algoritmos como DQN y PPO, y dónde se usan en el mundo real.
Si estás empezando con el aprendizaje por refuerzo, apúntate a nuestro itinerario Reinforcement Learning in Python para afianzar los fundamentos en un fin de semana.
El aprendizaje por refuerzo profundo es aprendizaje por refuerzo con una red neuronal en lugar de una tabla de consulta.
El aprendizaje por refuerzo ya define el bucle básico en el que un agente prueba una acción, observa qué ocurre y se ajusta según la recompensa. El deep learning añade una red que convierte la entrada en bruto en algo con lo que el agente puede actuar. Combinados, el agente aprende qué acciones funcionan mejor directamente a partir de datos en bruto, sin que nadie programe a mano qué significa cada estado.
Imagina que entrenas a un agente para jugar a Breakout. El agente no recibe una lista limpia de "posición de la pelota" o "posición de la pala": recibe píxeles en bruto de la pantalla. Un método tabular necesitaría una fila distinta para cada combinación posible de píxeles, una cifra inabordable. Una red neuronal mira directamente los píxeles y devuelve qué acción tomar, o lo buena que parece cada acción, sin haber visto jamás esa pantalla exacta.
En resumen, los métodos tabulares memorizan y las redes generalizan.
Eso es lo que hace que RL profundo funcione en entornos demasiado grandes o caóticos para que una tabla los maneje.
Todo sistema de RL profundo ejecuta el mismo bucle, independientemente del algoritmo que tenga debajo.
Así funciona:
El siguiente diagrama muestra este bucle en acción:
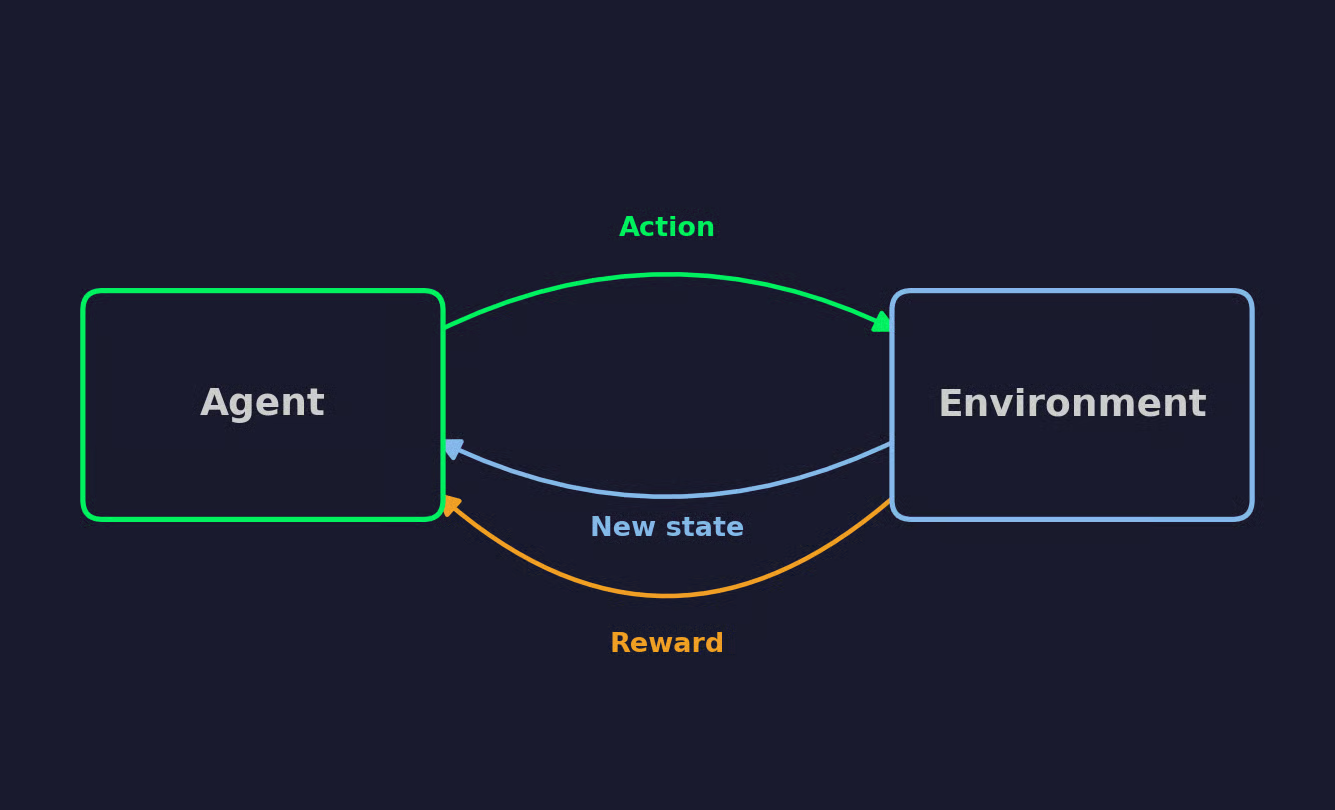
Bucle de aprendizaje por refuerzo
Si repites este bucle suficientes veces, el comportamiento del agente tenderá hacia las acciones que maximizan la recompensa.
Todos los algoritmos de RL profundo se apoyan en siete ideas. Si te familiarizas con ellas, el resto del artículo será mucho más claro.
Imagina un robot aspirador aprendiendo a limpiar una habitación. Usaré ese ejemplo en cada término a continuación.
El agente es quien decide: el robot aspirador, en nuestro ejemplo. El entorno es todo con lo que interactúa, como la habitación, los muebles, el polvo o las paredes con las que puede chocarse.
El agente no controla el entorno, pero sí elige acciones, y el entorno determina qué sucede después.
El estado describe la condición completa del entorno en un momento dado, como la posición exacta de cada mancha de suciedad y la ubicación del aspirador. Los agentes reales rara vez tienen acceso a eso con certeza.
En su lugar, actúan según una observación, es decir, lo que realmente pueden ver: una cámara o un conjunto de sensores de proximidad.
En entornos simples, observación y estado vienen a ser lo mismo. En los complejos, el agente trabaja con información parcial y debe completar lagunas.
Las acciones son los movimientos disponibles para el agente en cada momento. Para el aspirador, podría ser avanzar, girar a la izquierda, girar a la derecha o activar la succión.
Las acciones pueden ser discretas, cuando el agente elige de una lista fija, o continuas, cuando elige un valor dentro de un rango, como un ángulo de giro. Esta diferencia importa mucho cuando llegues a las distintas familias de algoritmos más adelante.
Una recompensa es la retroalimentación numérica que recibe el agente tras ejecutar una acción. Si el aspirador limpia una zona nueva del suelo, podría recibir +1. Si choca contra una pared, podría recibir -1.
El objetivo del agente es maximizar la recompensa total acumulada en el tiempo, no solo la de la siguiente acción.
Una política es la estrategia del agente para mapear estados u observaciones a acciones. Es el libro de reglas que sigue para decidir qué hacer después.
Una política puede ser determinista, eligiendo siempre la misma acción para un estado, o estocástica, eligiendo acciones según una distribución de probabilidad. Los algoritmos de RL profundo suelen representar la política con una red neuronal.
Una función de valor estima cuánta recompensa futura puede esperar el agente desde un estado dado si sigue su política actual.
Una función de Q-valor hace lo mismo para un par estado-acción. Estima la recompensa futura de tomar una acción concreta en un estado concreto y después seguir la política.
Este es el tipo de función que una red neuronal aproxima bien. Es la misma idea que vimos al sustituir la tabla de consulta antes en el artículo.
Un episodio es una ejecución completa del agente en el entorno, desde el estado inicial hasta una condición de fin. Para el aspirador, podría ser cuando la habitación queda limpia o se agota la batería.
Al terminar un episodio, el entorno se reinicia y comienza otro.
Un agente que solo repite lo que ya funcionó nunca encontrará algo mejor.
Imagina de nuevo el aspirador. Da con una ruta que limpia una buena parte de la habitación y la repite siempre. Nunca mira detrás del sofá. Ese es el compromiso central del aprendizaje por refuerzo:
Una forma habitual de equilibrar ambas es la exploración epsilon-greedy. En cada paso, el agente elige una acción aleatoria con probabilidad épsilon, un número pequeño como 0,1, y en caso contrario elige la acción que cree mejor. Muchos algoritmos hacen decaer épsilon con el tiempo: el agente explora mucho al principio y luego explota más cuando ha aprendido lo suficiente como para fiarse de su propio juicio.
No existe un épsilon fijo que funcione en todos los entornos.
Demasiada exploración pierde tiempo en acciones que fallan una y otra vez. Demasiada explotación hace que el agente se conforme con una estrategia decente mientras una mejor se queda sin descubrir a su lado. Encontrar el punto medio es aún más difícil a medida que el entorno se complica, sobre todo cuando una mala acción temprana no revela su coste real hasta muchos pasos después.
Todo algoritmo de RL profundo cae en una de tres familias, según lo que aprende: una función de valor, una política o ambas a la vez.
DQN toma la función de Q-valor mencionada antes y sustituye la tabla por una red neuronal. La red recibe un estado como entrada y devuelve un Q-valor para cada acción posible, aprendiendo igual que cualquier red estándar.
Entrenar esa red directamente no es buena idea. Las experiencias consecutivas están correlacionadas, la red sobreajusta a lo último que vio, y el objetivo que persigue cambia cada vez que la red se actualiza.
DQN soluciona ambos problemas:
DQN fue clave porque fue el primer algoritmo que aprendió políticas de control directamente desde píxeles en bruto en una amplia gama de juegos de Atari, usando la misma arquitectura e hiperparámetros para cada uno. Cuando DeepMind lo publicó en 2015, demostró que deep learning y aprendizaje por refuerzo podían funcionar juntos a escala, sin diseñar a mano características para cada juego.
En lugar de aprender una función de valor y escoger acciones en base a ella, los métodos de gradiente de política aprenden la política. La red recibe un estado y devuelve probabilidades de acción, y el agente muestrea una acción de esa distribución.
Este enfoque encaja con acciones continuas o estocásticas.
Un método basado en valor necesita evaluar todas las acciones posibles para encontrar la mejor, lo que se rompe cuando el espacio de acciones es continuo: no puedes recorrer un rango infinito de ángulos de giro. Un gradiente de política simplemente muestrea de la distribución, sin importar cuántas acciones existan.
REINFORCE es el algoritmo fundacional aquí. Ejecuta un episodio completo y luego aumenta la probabilidad de las acciones que llevaron a una recompensa total alta y disminuye la de las que llevaron a una baja. El problema es que solo actualiza cuando termina el episodio y depende del retorno completo, lo que hace que las actualizaciones sean ruidosas e inconsistentes entre episodios.
Los métodos actor-critic resuelven el problema de ruido de REINFORCE añadiendo una segunda red.
El actor es la política: elige acciones igual que un método de gradiente de política. El crítico es una función de valor que juzga cada acción justo después de ejecutarse, en lugar de esperar al final del episodio.
Es la combinación de enfoques basados en valor y en política. El actor sigue aprendiendo una política, pero se actualiza basándose en el juicio del crítico para cada acción, no en el retorno retrasado y ruidoso del que depende REINFORCE.
A2C y A3C son los ejemplos clásicos. A2C ejecuta varias copias del entorno en paralelo y actualiza actor y crítico juntos cuando termina cada lote. A3C ejecuta esas copias de forma asíncrona, donde cada una actualiza la red compartida a su propio ritmo en lugar de esperar a las demás.
Las actualizaciones de gradiente de política pueden estropearse si las dejas crecer demasiado. Una actualización lo bastante grande puede arruinar una política que iba bien, y no hay forma de deshacerlo una vez sucede.
PPO limita el tamaño de cada actualización para evitarlo. Este es el objetivo recortado que optimiza:
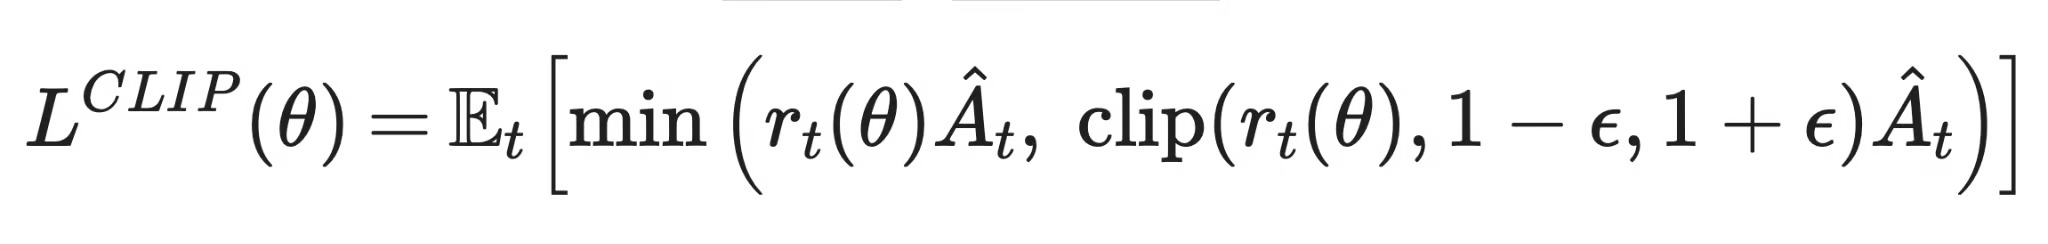
Proximal policy optimization
r_t(θ) es la razón entre la probabilidad de una acción bajo la política nueva y la probabilidad bajo la política antigua. Â_t es la ventaja, es decir, cuánto mejor resultó esa acción respecto a la expectativa base del crítico. La función clip() mantiene la razón dentro de una banda estrecha alrededor de 1, para que la política no cambie demasiado en un solo paso. Luego min() elige la estimación más conservadora, de modo que una ventaja inusualmente grande no empuje la actualización más allá del recorte permitido.
OpenAI presentó PPO en 2017 y se convirtió casi al instante en la opción por defecto. Es más fácil de implementar y ajustar que los métodos de región de confianza anteriores, y se mantiene bien en muchos entornos sin apenas ajuste por tarea.
DDPG y Soft Actor-Critic (SAC) se dirigen a problemas de control continuo, como ángulos de articulaciones robóticas o valores de dirección, donde el agente debe emitir un número específico en lugar de elegir de una distribución.
DDPG es un método actor-critic cuyo actor devuelve una acción determinista única en lugar de una distribución, y toma prestados la repetición de experiencias y las redes objetivo de DQN.
SAC se basa en la misma idea pero añade un término de entropía que recompensa que la política se mantenga algo aleatoria, lo que prolonga la exploración y suele hacer el entrenamiento más estable que con DDPG.
Los métodos basados en valor, como DQN, aprenden una función de Q-valor y eligen la acción con mayor puntuación. Funcionan bien con acciones discretas y son eficientes en muestras gracias a la repetición de experiencias, pero no se extienden a acciones continuas sin trabajo extra.
Los métodos basados en política, como REINFORCE, aprenden directamente la política y muestrean acciones de una distribución de probabilidad. Por eso funcionan con acciones continuas y estocásticas, aunque las actualizaciones de gradiente de política puras son ruidosas y requieren datos nuevos en cada actualización.
Los métodos actor-critic, como A2C/A3C, PPO, DDPG y SAC, combinan ambas ideas. La retroalimentación rápida del crítico estabiliza las actualizaciones del actor, por eso la mayoría de algoritmos usados hoy en la práctica caen en esta categoría.
Aquí tienes una comparación más visual:
| Qué se aprende | Cómo se eligen las acciones | Discreto vs. continuo | Estabilidad | Eficiencia de muestras | Algoritmos representativos | |
|---|---|---|---|---|---|---|
| Basados en valor | Función de Q-valor | Acción con mayor puntuación | Discreto | Necesita redes objetivo y repetición para ser estable | Buena, gracias a la repetición de experiencias | DQN |
| Basados en política | Política | Muestreada de la distribución de la política | Ambos, mejor con continuas | Ruidosa, alta varianza | Pobre, requiere datos nuevos en cada actualización | REINFORCE |
| Actor-critic | Política y función de valor | Muestreada del actor, guiada por el crítico | Ambos | Más estable que los puramente basados en política | Mejor que los puramente basados en política | A2C/A3C, PPO, DDPG, SAC |
Comparativa de métodos de aprendizaje por refuerzo profundo
En aprendizaje supervisado tienes una etiqueta para cada ejemplo. En RL profundo hay que deducir qué funcionó a partir de una señal de recompensa que llega tarde, se mezcla con acciones anteriores y a veces ni siquiera aparece de forma útil.
Los agentes de RL profundo suelen necesitar millones de pasos en el entorno antes de aprender algo útil, sobre todo si los comparas con lo poco que necesita un modelo supervisado para lograr precisión similar en un conjunto fijo.
La razón es que el propio agente genera sus datos de entrenamiento al actuar, y la mayoría de esas acciones al principio son casi aleatorias. Un modelo supervisado reutiliza el mismo conjunto etiquetado una y otra vez. Un agente de RL tiene que seguir explorando un entorno que apenas entiende, paso a paso.
Entrenar en RL suele ser inestable.
Parte del problema es que las funciones de valor se apoyan en sus propias estimaciones: el objetivo de Q-valor de hoy depende de la estimación de ayer. Si esa estimación está mal, el error se amplifica en lugar de corregirse. Además, la política del agente cambia mientras aprende, así que los datos que recoge también cambian.
En otras palabras, la red persigue una diana en movimiento por partida doble.
Algunos entornos solo dan recompensa al final, como una señal de victoria o derrota tras una partida larga. El agente debe deducir a partir de ese único número qué acciones, de entre decenas, fueron las que importaron.
Esto se llama problema de asignación de crédito, y empeora cuanto mayor es el retraso entre una acción y su consecuencia.
Diseñar recompensas parece fácil hasta que te pones a ello.
Un ejemplo famoso: un agente de carreras entrenado por OpenAI era recompensado por pasar por puntos de control, así que encontró una laguna con potenciadores que reaparecían y dio vueltas allí para siempre, acumulando puntos sin terminar la carrera. La función de recompensa hizo justo lo que se le pidió: simplemente al agente no se le dijo qué significaba realmente "ganar". Esta diferencia entre lo que recompensas y lo que de verdad quieres se llama reward hacking, y aparece de una forma u otra en casi cualquier función de recompensa que escribas.
El mismo algoritmo, con una semilla aleatoria distinta, puede producir resultados diferentes.
Los resultados publicados son difíciles de reproducir sin el código exacto, hiperparámetros y semillas que usaron los autores. Detalles pequeños de implementación, como cómo se normalizan las observaciones o cómo se inicializa el búfer de repetición, pueden afectar más al rendimiento que la elección del algoritmo.
En un simulador, un agente puede fallar gratis tantas veces como haga falta. En el mundo real no es así.
Por ejemplo, una política de conducción autónoma que explora una mala acción en la autopista pone a personas en riesgo. Los simuladores nunca capturan la realidad a la perfección: los casos límite que no modelaron aparecen en cuanto la política sale del laboratorio. Una política que luce genial en simulación puede fallar de formas impredecibles en el mundo real, por lo que desplegar RL profundo fuera de juegos y simuladores exige mucha más cautela de lo que sugieren los benchmarks.
Ahora destacaré las diferencias entre el aprendizaje por refuerzo profundo y enfoques más tradicionales.
El aprendizaje supervisado entrena con ejemplos etiquetados, donde cada entrada ya tiene una respuesta correcta. RL profundo nunca recibe eso: solo obtiene una recompensa después de actuar y debe averiguar por sí mismo qué acciones llevaron a esa recompensa.
El aprendizaje por imitación entrena una política para copiar demostraciones de un experto, sin usar señal de recompensa. RL profundo descubre el comportamiento por prueba y error.
La imitación pone una política en marcha rápido, pero queda limitada por la calidad de las demostraciones y sufre en cuanto el agente se enfrenta a una situación que el experto no mostró. RL profundo puede, en teoría, superar a cualquier profesor, pero necesita mucha más interacción y una función de recompensa que realmente apunte al comportamiento deseado.
Los algoritmos evolutivos optimizan una política mutando una población de candidatas y quedándose con las que mejor funcionan, sin calcular gradientes. RL profundo calcula gradientes a partir de la señal de recompensa y actualiza una sola política.
Los métodos evolutivos se paralelizan bien, ya que cada candidata de la población puede ejecutarse de forma independiente. Pero, por lo general, necesitan muchas más interacciones totales con el entorno que RL profundo basado en gradientes para alcanzar el mismo nivel de rendimiento.
RL profundo penaliza atajos más que la mayoría de campos. Con eso en mente, aquí van algunas buenas prácticas para tu próximo proyecto:
El aprendizaje por refuerzo profundo toma el bucle de prueba y error del RL y lo combina con una red neuronal capaz de manejar estados que ninguna tabla podría abarcar.
Cada algoritmo de este artículo entra en una de tres familias. Los basados en valor, como DQN, aprenden una función de Q-valor y eligen la acción con mayor puntuación. Los basados en política, como REINFORCE, aprenden la política directamente. Los actor-critic, como PPO, combinan ambas, y esa combinación es la que domina hoy en día.
Ten en cuenta que nada de esto sale gratis.
La estabilidad del entrenamiento, la eficiencia en muestras, el diseño de recompensas y la reproducibilidad se complican en cuanto pasas de una tabla a una red. Si quieres profundizar, Q-learning y reinforcement learning cubren los fundamentos sobre los que se apoya este artículo, y DQN y PPO son buenos siguientes pasos para los propios algoritmos.
Aprende con DataCamp
Curso
Curso
programa
blog
Javier Canales Luna
9 min
Tutorial
Bharath K
13 min
Tutorial
Tutorial
Abid Ali Awan
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
14 min