Courses
ทำความเข้าใจปัญญาประดิษฐ์
2 ชม.
421.1K
Reinforcement learning แบบดั้งเดิมทำงานได้ไม่ดีนักเมื่อสภาพแวดล้อมมีขนาดใหญ่เกินกว่าจะติดตามด้วยมือได้ เหตุผลคือทุกสถานะต้องมีระเบียนของตัวเองในตาราง และทุกการกระทำจากทุกสถานะก็ต้องมีค่าของตัวเอง
ตัวอย่างเช่น หน้าจอเกมให้ค่าพิกเซลได้เป็นล้านรูปแบบ ซึ่งไม่อาจใส่ลงในตารางเพื่อวนลูปดูได้ เอเจนต์จำเป็นต้องเดาค่าของสถานะที่ไม่เคยเห็นมาก่อน โดยอาศัยสถานะที่มีลักษณะคล้ายกันเป็นฐาน
Deep reinforcement learning แก้ปัญหานี้ด้วยการเปลี่ยนตารางเป็นโครงข่ายประสาทเทียมที่ประเมินค่าของสถานะหรือการกระทำที่ดีที่สุด แม้ในสถานการณ์ที่ไม่เคยพบเจอโดยตรง นี่คือสิ่งที่ทำให้เอเจนต์เชี่ยวชาญเกมโกะและบังคับโดรนจำลอง ซึ่งล้วนเป็นงานที่อัลกอริทึม RL แบบคลาสสิกไปไม่รอด
ในบทความนี้ จะพาไปรู้จักแนวคิดหลักของ deep RL ตระกูลอัลกอริทึมสำคัญอย่าง DQN และ PPO ตลอดจนกรณีใช้งานจริง
หากเป็นมือใหม่ด้าน reinforcement learning ลงทะเบียนในแทร็ก Reinforcement Learning in Python เพื่อปรับพื้นฐานให้แน่นภายในสุดสัปดาห์เดียว
Deep reinforcement learning คือ reinforcement learning ที่ใช้โครงข่ายประสาทเทียมแทนตารางค้นหา
Reinforcement learning ให้ลูปพื้นฐานที่เอเจนต์ลองทำสิ่งหนึ่ง ดูผลลัพธ์ และปรับตามรางวัลที่ได้รับ Deep learning เพิ่มเครือข่ายที่แปลงอินพุตดิบให้เป็นสัญญาณที่เอเจนต์นำไปใช้ตัดสินใจได้ เมื่อนำมารวมกัน เอเจนต์จะเรียนรู้ว่าการกระทำใดได้ผลดีที่สุดจากข้อมูลดิบโดยตรง โดยไม่ต้องเขียนมือว่าทุกสถานะหมายถึงอะไร
ลองนึกภาพกำลังฝึกเอเจนต์ให้เล่นเกม Breakout เอเจนต์ไม่ได้รับรายการ "ตำแหน่งลูกบอล" หรือ "ตำแหน่งไม้" ที่สะอาดตา แต่ได้รับพิกเซลดิบจากหน้าจอ วิธีแบบตารางจะต้องมีแถวแยกสำหรับทุกชุดพิกเซลที่เป็นไปได้ ซึ่งจำนวนมากเกินจัดการ โครงข่ายประสาทจะมองพิกเซลโดยตรงและส่งออกว่าควรทำการกระทำใด หรือคุณภาพของแต่ละการกระทำเป็นอย่างไร โดยไม่จำเป็นต้องเคยเห็นหน้าจอนั้นมาก่อน
สรุปคือ วิธีแบบตารางเน้นท่องจำ ส่วนเครือข่ายเน้นการเหมารวม
นี่คือเหตุผลที่ deep RL ใช้งานได้ในสภาพแวดล้อมที่ใหญ่หรือยุ่งเหยิงเกินกว่าตารางจะรับมือไหว
ทุกระบบ deep RL จะรันลูปเดียวกัน ไม่ว่าอัลกอริทึมที่อยู่ข้างใต้จะเป็นอะไร
ขั้นตอนมีดังนี้:
ไดอะแกรมด้านล่างแสดงลูปนี้ขณะทำงาน:
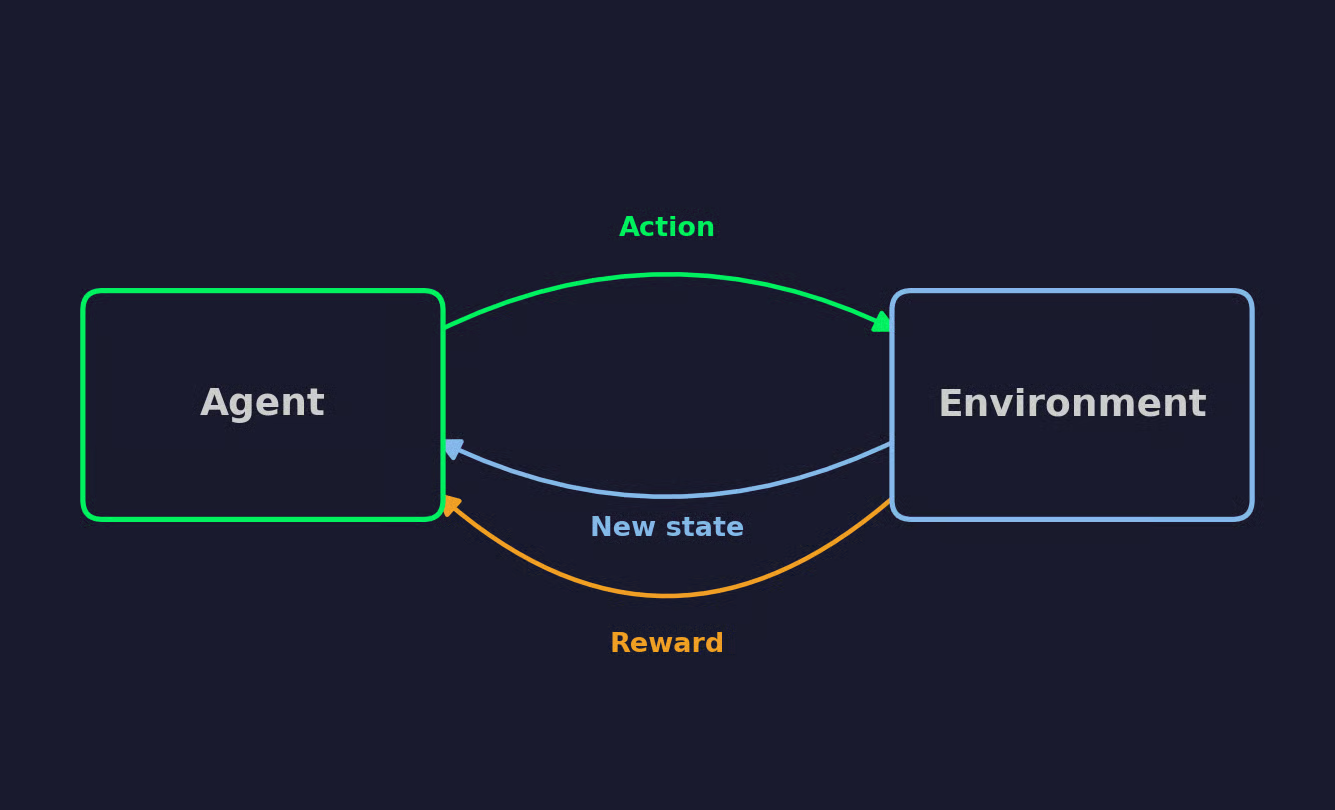
ลูป reinforcement learning
หากทำซ้ำลูปนี้มากพอ พฤติกรรมของเอเจนต์จะค่อยๆ เปลี่ยนไปสู่การกระทำที่เพิ่มรางวัลรวมให้สูงสุด
ทุกอัลกอริทึม deep RL สร้างบน 7 แนวคิดเดียวกัน ควรทำความคุ้นเคยกับสิ่งเหล่านี้ แล้วส่วนที่เหลือของบทความจะเข้าใจง่ายขึ้นมาก
ลองจินตนาการถึงหุ่นยนต์ดูดฝุ่นที่เรียนรู้การทำความสะอาดห้อง จะใช้ตัวอย่างนี้ประกอบทุกคำต่อไป
เอเจนต์คือผู้ตัดสินใจ — ในตัวอย่างนี้คือหุ่นยนต์ดูดฝุ่น สภาพแวดล้อมคือทุกสิ่งที่มันโต้ตอบด้วย เช่น ห้อง เฟอร์นิเจอร์ ฝุ่นผง และผนังที่มันอาจชน
เอเจนต์ไม่ควบคุมสภาพแวดล้อม แต่เลือกการกระทำได้ และสภาพแวดล้อมเป็นผู้กำหนดว่าอะไรจะเกิดขึ้นต่อไป
สถานะอธิบายสภาพของสภาพแวดล้อมทั้งหมดในช่วงเวลาหนึ่งๆ เช่น ตำแหน่งที่แน่นอนของทุกจุดฝุ่นและตำแหน่งของเครื่องดูดฝุ่น เอเจนต์จริงแทบไม่เคยเข้าถึงข้อมูลนั้นอย่างแน่นอน
แทนที่จะเป็นเช่นนั้น เอเจนต์จะใช้การสังเกต ซึ่งคือสิ่งที่มันมองเห็นจริง เช่น ฟีดจากกล้องหรือชุดเซ็นเซอร์วัดระยะ
ในสภาพแวดล้อมง่ายๆ การสังเกตและสถานะเกือบเป็นสิ่งเดียวกัน แต่ในสภาพแวดล้อมซับซ้อน เอเจนต์ทำงานด้วยข้อมูลบางส่วนและต้องเดาข้อมูลที่ขาดหาย
การกระทำคือทางเลือกที่มีให้เอเจนต์ในขณะหนึ่งๆ สำหรับเครื่องดูดฝุ่นอาจหมายถึงการเคลื่อนไปข้างหน้า เลี้ยวซ้าย เลี้ยวขวา หรือเปิดการดูด
การกระทำอาจเป็นแบบไม่ต่อเนื่อง ซึ่งเอเจนต์เลือกจากรายการคงที่ หรือแบบต่อเนื่อง ซึ่งเอเจนต์เลือกค่าบนช่วง เช่น มุมเลี้ยว ความแตกต่างนี้สำคัญมากเมื่อพูดถึงตระกูลอัลกอริทึมต่างๆ ในช่วงท้ายบทความ
รางวัลคือผลตอบแทนเชิงตัวเลขที่เอเจนต์ได้รับหลังจากทำการกระทำ หากเครื่องดูดฝุ่นทำความสะอาดพื้นที่ใหม่ได้ อาจได้รางวัล +1 แต่ถ้าชนผนังอาจได้ -1
เป้าหมายทั้งหมดของเอเจนต์คือเพิ่มรางวัลรวมที่ได้รับตลอดเวลา ไม่ใช่แค่รางวัลจากการกระทำถัดไปเพียงครั้งเดียว
นโยบายคือกลยุทธ์ของเอเจนต์ในการแมปสถานะหรือการสังเกตไปสู่การกระทำ เป็นกฎที่เอเจนต์ใช้ตัดสินใจว่าจะทำอะไรต่อไป
นโยบายอาจเป็นแบบกำหนดแน่นอน เลือกการกระทำเดิมเสมอสำหรับสถานะหนึ่งๆ หรือแบบสุ่ม เลือกการกระทำตามการกระจายความน่าจะเป็น อัลกอริทึม deep RL มักใช้โครงข่ายประสาทเทียมแทนตัวนโยบายนี้
ฟังก์ชันค่าประเมินว่าจากสถานะหนึ่งๆ หากยังคงปฏิบัติตามนโยบายปัจจุบันต่อไป เอเจนต์คาดว่าจะได้รับรางวัลในอนาคตมากเพียงใด
ฟังก์ชัน Q-value ทำสิ่งเดียวกันสำหรับคู่สถานะ–การกระทำ มันประเมินรางวัลในอนาคตจากการทำการกระทำเฉพาะในสถานะเฉพาะ แล้วจึงปฏิบัติตามนโยบายต่อไป
นี่คือฟังก์ชันประเภทที่โครงข่ายประสาทเทียมเหมาะกับการประมาณค่า เป็นแนวคิดเดียวกับตอนที่เปลี่ยนจากตารางค้นหาไปใช้เครือข่ายก่อนหน้านี้
เอพิโซดคือการวิ่งหนึ่งรอบเต็มของเอเจนต์ในสภาพแวดล้อม ตั้งแต่สถานะเริ่มต้นจนถึงเงื่อนไขสิ้นสุด สำหรับเครื่องดูดฝุ่นอาจหมายถึงห้องสะอาดหมดแล้วหรือแบตเตอรี่หมด
เมื่อเอพิโซดสิ้นสุด สภาพแวดล้อมจะถูกรีเซ็ตและเริ่มเอพิโซดใหม่
เอเจนต์ที่ทำซ้ำเพียงสิ่งที่เคยเวิร์กจะไม่มีวันค้นพบสิ่งที่ดีกว่า
นึกถึงเครื่องดูดฝุ่นอีกครั้ง มันบังเอิญเจอเส้นทางที่ทำความสะอาดได้พอใช้ แล้วก็วิ่งเส้นทางเดิมทุกครั้ง ไม่เคยตรวจดูมุมหลังโซฟา นั่นแหละคือข้อแลกเปลี่ยนแก่นกลางของ reinforcement learning:
วิธีสมดุลที่พบบ่อยคือการสำรวจแบบepsilon-greedy ในแต่ละก้าว เอเจนต์จะเลือกการกระทำแบบสุ่มด้วยความน่าจะเป็น epsilon ซึ่งเป็นค่าจำนวนน้อยอย่าง 0.1 และในกรณีอื่นจะเลือกการกระทำที่เชื่อว่าดีที่สุดในตอนนั้น หลายอัลกอริทึมจะลดค่า epsilon ลงตามเวลา โดยเอเจนต์จะสำรวจมากในช่วงแรก แล้วค่อยพึ่งการใช้ประโยชน์มากขึ้นเมื่อเรียนรู้พอที่จะไว้ใจการตัดสินใจของตัวเอง
ไม่มีค่า epsilon ตายตัวที่ใช้ได้กับทุกสภาพแวดล้อม
การสำรวจมากเกินไปทำให้เสียเวลากับการกระทำที่ล้มเหลวซ้ำๆ การสำรวจน้อยเกินไปทำให้เอเจนต์ยอมรับกลยุทธ์ที่พอใช้ ทั้งที่มีกลยุทธ์ที่ดีกว่าอยู่ใกล้ๆ แต่ไม่เคยค้นพบ การหาสมดุลที่เหมาะสมยิ่งยากขึ้นเมื่อสภาพแวดล้อมซับซ้อน โดยเฉพาะเมื่อการกระทำที่แย่ในช่วงแรกเผยให้เห็นต้นทุนที่แท้จริงหลังจากนั้นอีกหลายก้าว
ทุกอัลกอริทึม deep RL จัดอยู่ในสามตระกูล ขึ้นกับสิ่งที่มันเรียนรู้จริงๆ: ฟังก์ชันค่า นโยบาย หรือทั้งสองอย่างพร้อมกัน
DQN นำฟังก์ชัน Q-value จากตอนก่อนหน้าและเปลี่ยนตารางค้นหาเป็นโครงข่ายประสาท เครือข่ายรับสถานะเป็นอินพุตและให้ค่า Q สำหรับทุกการกระทำที่เป็นไปได้ โดยเรียนรู้แบบเดียวกับโครงข่ายประสาทมาตรฐานทั่วไป
ไม่แนะนำให้ฝึกเครือข่ายนั้นโดยตรง เพราะประสบการณ์ที่ต่อเนื่องกันมีความสัมพันธ์กัน ทำให้เครือข่ายฟิตกับสิ่งที่เพิ่งเห็น และเป้าหมายที่ไล่ตามก็เปลี่ยนทุกครั้งที่เครือข่ายอัปเดต
DQN แก้ทั้งสองปัญหา:
DQN มีความสำคัญเพราะเป็นอัลกอริทึมแรกที่เรียนรู้นโยบายควบคุมจากพิกเซลดิบโดยตรงในเกม Atari หลากหลายเกม โดยใช้องค์ประกอบสถาปัตยกรรมและไฮเปอร์พารามิเตอร์เดียวกันทั้งหมด เมื่อ DeepMind เผยแพร่ในปี 2015 มันพิสูจน์ว่า deep learning และ reinforcement learning ทำงานร่วมกันในสเกลใหญ่ได้จริง โดยไม่ต้องสร้างฟีเจอร์เฉพาะเกมด้วยมือ
แทนที่จะเรียนรู้ฟังก์ชันค่าและเลือกการกระทำจากมัน วิธีเชิงไล่นโยบายจะเรียนรู้นโยบายโดยตรง เครือข่ายรับสถานะและให้ความน่าจะเป็นของการกระทำ แล้วเอเจนต์สุ่มตัวอย่างการกระทำนั้นจากการกระจาย
วิธีนี้เหมาะกับการกระทำแบบต่อเนื่องหรือแบบสุ่ม
วิธีแบบค่า (value-based) ต้องตรวจทุกการกระทำเพื่อหาสิ่งที่ดีที่สุด ซึ่งพังทันทีที่พื้นที่การกระทำเป็นแบบต่อเนื่อง — ไม่อาจวนลูปผ่านช่วงมุมเลี้ยวที่เป็นอนันต์ได้ วิธีเชิงไล่นโยบายเพียงสุ่มจากการกระจาย ไม่ว่าจำนวนการกระทำจะมีเท่าใดก็ตาม
REINFORCE คืออัลกอริทึมรากฐาน รันทั้งเอพิโซด แล้วเพิ่มความน่าจะเป็นของการกระทำที่นำไปสู่รางวัลรวมสูง และลดความน่าจะเป็นของการกระทำที่นำไปสู่รางวัลรวมต่ำ ข้อเสียคืออัปเดตหลังจบเอพิโซดเท่านั้น และพึ่งพาผลตอบแทนรวม ทำให้การอัปเดตมีนอยส์และไม่สม่ำเสมอระหว่างเอพิโซด
วิธีแบบ actor-critic แก้ปัญหานอยส์ของ REINFORCE ด้วยการเพิ่มเครือข่ายตัวที่สอง
Actor คือนโยบาย — เลือกการกระทำแบบเดียวกับวิธีเชิงไล่นโยบาย ส่วน critic คือฟังก์ชันค่าที่ตัดสินการกระทำแต่ละครั้งทันทีหลังเกิดขึ้น แทนการรอให้เอพิโซดจบ
นี่คือการทำงานร่วมกันของวิธีแบบค่าและแบบนโยบาย Actor ยังคงเรียนรู้นโยบาย แต่จะอัปเดตตามการตัดสินของ critic ต่อการกระทำแต่ละครั้ง ไม่ใช่ผลตอบแทนรวมที่ล่าช้าและมีนอยส์แบบ REINFORCE
A2C และ A3C เป็นตัวอย่างมาตรฐาน A2C รันสภาพแวดล้อมหลายสำเนาควบคู่กันและอัปเดต actor และ critic พร้อมกันเมื่อแต่ละแบทช์เสร็จ A3C รันสำเนาเหล่านั้นแบบอะซิงโครนัส โดยแต่ละสำเนาอัปเดตเครือข่ายร่วมตามจังหวะของตัวเองแทนที่จะรอผู้อื่น
การอัปเดตแบบเชิงไล่นโยบายอาจผิดพลาดหากปล่อยให้มีขนาดใหญ่เกินไป การอัปเดตที่ใหญ่พอสามารถทำลายนโยบายที่ทำงานได้ดีอยู่แล้ว และไม่อาจย้อนคืนได้เมื่อเกิดขึ้น
PPO จำกัดขนาดของการอัปเดตทุกครั้งเพื่อหลีกเลี่ยงปัญหานั้น นี่คือวัตถุประสงค์แบบ clipped ที่มันเพิ่มประสิทธิภาพ:
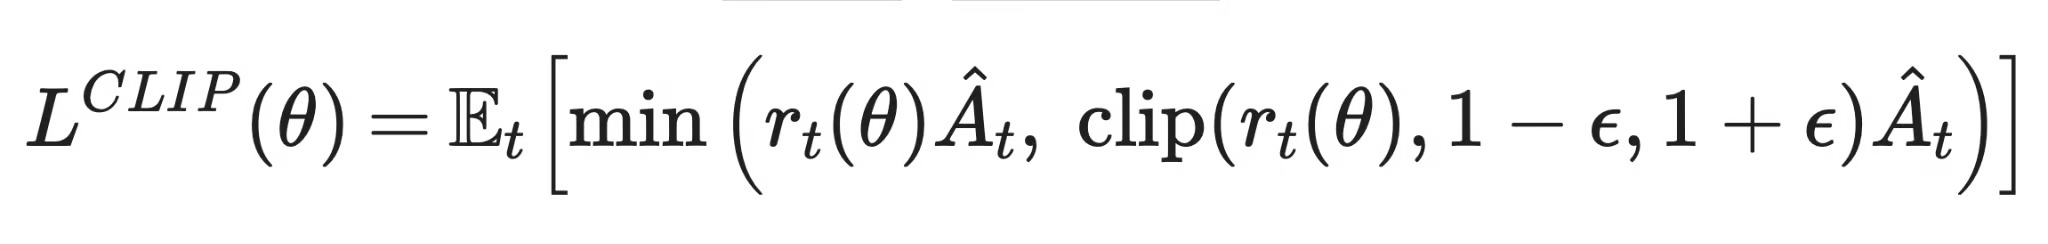
Proximal policy optimization
r_t(θ) คืออัตราส่วนระหว่างความน่าจะเป็นของนโยบายใหม่ต่อการกระทำหนึ่งกับความน่าจะเป็นของนโยบายเก่าต่อการกระทำเดียวกัน Â_t คือค่า advantage หรือความเหนือกว่าที่การกระทำนั้นมีเมื่อเทียบกับความคาดหวังพื้นฐานของ critic ฟังก์ชัน clip() จะบีบอัตราส่วนให้อยู่ในช่วงแคบๆ รอบค่า 1 เพื่อไม่ให้นโยบายเปลี่ยนมากเกินไปในก้าวเดียว จากนั้น min() จะเลือกค่าประมาณที่ระมัดระวังกว่า เพื่อไม่ให้ค่า advantage ที่สูงผิดปกติดันการอัปเดตเกินขอบเขตที่ clip ไว้
OpenAI นำเสนอ PPO ในปี 2017 และกลายเป็นตัวเลือกมาตรฐานแทบจะในทันที เพราะใช้งานและปรับแต่งง่ายกว่าวิธีแบบ trust-region ที่มาก่อน และยังคงประสิทธิภาพได้ดีในหลายสภาพแวดล้อมโดยไม่ต้องจูนเฉพาะงานมากนัก
DDPG และ Soft Actor-Critic (SAC) ต่างมุ่งเป้าปัญหาควบคุมแบบต่อเนื่อง เช่น มุมข้อต่อหุ่นยนต์หรือค่าการบังคับเลี้ยว ที่เอเจนต์ต้องส่งออกเป็นค่าตัวเลขเฉพาะ แทนการเลือกจากการกระจาย
DDPG เป็นวิธี actor-critic ที่ actor ส่งออกการกระทำแบบกำหนดแน่นอนเพียงค่าเดียวแทนการกระจาย และยืมแนวคิด experience replay กับ target networks มาจาก DQN
SAC สร้างต่อยอดแนวคิดเดียวกันแต่เพิ่มเทอมเอนโทรปีที่ให้รางวัลแก่นโยบายในการคงความสุ่มอยู่บ้าง ทำให้เอเจนต์สำรวจนานขึ้นและโดยทั่วไปฝึกได้เสถียรกว่า DDPG
วิธีแบบค่าอย่าง DQN เรียนรู้ฟังก์ชัน Q-value และเลือกการกระทำที่ได้คะแนนสูงสุด วิธีนี้เหมาะกับพื้นที่การกระทำแบบไม่ต่อเนื่องและใช้ข้อมูลอย่างมีประสิทธิภาพด้วย experience replay แต่ไม่ขยายไปสู่การกระทำแบบต่อเนื่องได้โดยไม่ต้องทำงานเพิ่ม
วิธีแบบนโยบายอย่าง REINFORCE เรียนรู้นโยบายโดยตรง สุ่มตัวอย่างการกระทำจากการกระจายความน่าจะเป็นของนโยบาย นี่คือสิ่งที่ทำให้ใช้งานกับการกระทำแบบต่อเนื่องและแบบสุ่มได้ แต่การอัปเดตแบบไล่นโยบายล้วนมีนอยส์และต้องใช้ข้อมูลใหม่ทุกครั้งที่อัปเดต
วิธีแบบ actor-critic รวมถึง A2C/A3C, PPO, DDPG และ SAC ผสานทั้งสองแนวคิดเข้าด้วยกัน การป้อนกลับที่รวดเร็วของ critic ช่วยทำให้การอัปเดตของ actor เสถียรขึ้น ซึ่งเป็นเหตุผลที่อัลกอริทึมส่วนใหญ่ที่ใช้งานจริงในปัจจุบันอยู่ในหมวดนี้
ต่อไปนี้คือการเปรียบเทียบแบบเห็นภาพมากขึ้น:
| สิ่งที่เรียนรู้ | วิธีเลือกการกระทำ | ไม่ต่อเนื่อง vs ต่อเนื่อง | เสถียรภาพ | ประสิทธิภาพการใช้ตัวอย่าง | อัลกอริทึมตัวแทน | |
|---|---|---|---|---|---|---|
| แบบค่า | ฟังก์ชัน Q-value | การกระทำที่ได้คะแนนสูงสุด | ไม่ต่อเนื่อง | ต้องใช้เครือข่ายเป้าหมายและการเล่นซ้ำเพื่อคงเสถียรภาพ | ดี ด้วยความช่วยเหลือของ experience replay | DQN |
| แบบนโยบาย | นโยบาย | สุ่มจากการกระจายของนโยบาย | ได้ทั้งสอง แบบต่อเนื่องจะเด่น | นอยส์สูง อัปเดตมีความแปรปรวนมาก | ต่ำ ต้องใช้ข้อมูลใหม่ทุกครั้งที่อัปเดต | REINFORCE |
| actor-critic | นโยบายและฟังก์ชันค่า | สุ่มจาก actor โดยมี critic ชี้นำ | ทั้งสอง | เสถียรกว่าวิธีแบบนโยบายล้วน | ดีกว่าวิธีแบบนโยบายล้วน | A2C/A3C, PPO, DDPG, SAC |
การเปรียบเทียบวิธี deep reinforcement learning
การเรียนรู้แบบกำกับมีคำตอบติดป้ายกำกับสำหรับทุกตัวอย่าง แต่ deep RL ต้องหาว่าอะไรเวิร์กจากสัญญาณรางวัลที่มาช้า ถูกผสมกับการกระทำก่อนหน้า และบางทีก็ไม่ปรากฏในแบบที่มีประโยชน์เลย
เอเจนต์ deep RL มักต้องการก้าวของสภาพแวดล้อมนับล้านก่อนจะเรียนรู้อะไรที่มีประโยชน์ โดยเฉพาะเมื่อเทียบกับข้อมูลเพียงเล็กน้อยที่โมเดลกำกับต้องการเพื่อให้ได้ความแม่นยำใกล้เคียงบนชุดข้อมูลคงที่
เหตุผลคือเอเจนต์ต้องสร้างข้อมูลฝึกของตัวเองจากการลงมือทำ และส่วนใหญ่ในช่วงแรกแทบเป็นการสุ่ม โมเดลกำกับสามารถใช้ชุดข้อมูลติดป้ายชุดเดิมซ้ำแล้วซ้ำเล่า แต่เอเจนต์ RL ต้องสำรวจสภาพแวดล้อมที่ยังไม่เข้าใจทีละก้าว
การฝึก RL มักไม่เสถียร
ส่วนหนึ่งเพราะฟังก์ชันค่าพึ่งพาค่าประมาณของตัวเอง โดยเป้าหมาย Q-value วันนี้ขึ้นอยู่กับค่าคาดเดาเมื่อวาน หากเดาผิด ข้อผิดพลาดจะทบซ้อนแทนที่จะแก้ไข นอกจากนี้นโยบายของเอเจนต์ยังเปลี่ยนไปขณะเรียนรู้ ทำให้ข้อมูลที่เก็บมาก็เปลี่ยนตามไปด้วย
กล่าวอีกนัยหนึ่ง เครือข่ายกำลังไล่ตามเป้าหมายที่ขยับอยู่สองด้านพร้อมกัน
บางสภาพแวดล้อมให้รางวัลเฉพาะตอนจบ เช่น สัญญาณชนะหรือแพ้หลังเกมยาว เอเจนต์ต้องไล่ย้อนจากตัวเลขเดียวและหาว่าจากการกระทำหลายสิบครั้ง อะไรที่มีผลจริง
นี่เรียกว่าปัญหาการกำหนดเครดิต (credit assignment) และจะยิ่งแย่ลงเมื่อความล่าช้าระหว่างการกระทำกับผลกระทบยาวนานขึ้น
การออกแบบรางวัลดูเหมือนง่ายจนกว่าจะลองทำจริง
ตัวอย่างดังมีอยู่ว่า เอเจนต์แข่งเรือที่ OpenAI ฝึกได้รับรางวัลจากการชนเช็กพอยต์ จึงหาลากูนที่มีพาวเวอร์อัปเกิดซ้ำได้และวนอยู่ที่นั่นไม่รู้จบ กวาดคะแนนโดยไม่เคยเข้าเส้นชัย ฟังก์ชันรางวัลทำตามที่ถูกสั่งเป๊ะ — เพียงแต่เอเจนต์ไม่ได้ถูกบอกว่า "ชนะ" หมายถึงอะไร ความต่างระหว่างสิ่งที่ให้รางวัลกับสิ่งที่ต้องการจริงเรียกว่า reward hacking และมักโผล่มาในรูปแบบใดรูปแบบหนึ่งแทบทุกฟังก์ชันรางวัลที่เขียน
อัลกอริทึมเดียวกัน เมื่อเปลี่ยนค่า seed แบบสุ่ม อาจให้ผลลัพธ์ต่างกัน
ผลลัพธ์ที่ตีพิมพ์ทำซ้ำได้ยากหากไม่มีโค้ดเบส ไฮเปอร์พารามิเตอร์ และ seed แบบเดียวกับงานต้นฉบับ รายละเอียดการติดตั้งเล็กๆ เช่น วิธีทำ normalization การสังเกต หรือวิธีเริ่มต้นบัฟเฟอร์ replay อาจเปลี่ยนประสิทธิภาพมากกว่าตัวเลือกอัลกอริทึมเสียอีก
ซิมูเลเตอร์ปล่อยให้เอเจนต์ล้มเหลวซ้ำแล้วซ้ำเล่าได้ตามต้องการ แต่โลกจริงไม่เป็นเช่นนั้น
ตัวอย่างเช่น นโยบายขับขี่อัตโนมัติที่ลองการกระทำที่แย่บนทางด่วนทำให้ผู้คนเสี่ยงอันตราย ซิมูเลเตอร์ไม่มีวันจับโลกจริงได้ครบถ้วน กรณีขอบ (edge case) ที่ไม่เคยถูกจำลองจะโผล่ทันทีที่นโยบายออกจากห้องแล็บ นโยบายที่ดูดีในซิมูเลชันอาจล้มเหลวแบบที่ไม่มีใครคาดเมื่อเจอสภาพแวดล้อมจริง ซึ่งเป็นเหตุผลที่การนำ deep RL ออกใช้นอกเกมและซิมูเลเตอร์ต้องระมัดระวังมากกว่าตัวเลขบนเบนช์มาร์กบอกไว้มาก
ต่อไปจะชี้ให้เห็นความแตกต่างระหว่าง deep reinforcement learning กับแนวทางดั้งเดิมมากกว่า
การเรียนรู้แบบกำกับฝึกจากตัวอย่างติดป้ายกำกับที่ทุกอินพุตมีคำตอบถูกต้องอยู่แล้ว Deep RL ไม่ได้รับสิ่งนั้น — มันได้รับรางวัลหลังจากลงมือทำเท่านั้น และต้องหาด้วยตัวเองว่าการกระทำใดนำไปสู่รางวัลนั้น
การเรียนรู้จากการเลียนแบบฝึกนโยบายให้ลอกการสาธิตของผู้เชี่ยวชาญ โดยไม่ใช้สัญญาณรางวัลเลย Deep RL ค้นพบพฤติกรรมด้วยการลองผิดลองถูกแทน
การเลียนแบบทำให้นโยบายเริ่มทำงานได้เร็ว แต่ถูกจำกัดด้วยคุณภาพของการสาธิต และสะดุดทันทีที่เอเจนต์เจอสถานการณ์ที่ผู้เชี่ยวชาญไม่เคยสาธิตให้ดู Deep RL ตามทฤษฎีสามารถทำได้ดีกว่าครูใดๆ แต่ต้องการปฏิสัมพันธ์มากกว่ามาก และต้องมีฟังก์ชันรางวัลที่ชี้ไปยังพฤติกรรมที่ต้องการจริง
อัลกอริทึมเชิงวิวัฒนาการเพิ่มประสิทธิภาพนโยบายด้วยการกลายพันธุ์ประชากรของตัวเลือกและเก็บเฉพาะตัวที่ทำผลงานดีที่สุด โดยไม่คำนวณกราเดียนต์เลย Deep RL คำนวณกราเดียนต์จากสัญญาณรางวัลและอัปเดตนโยบายเดียว
วิธีเชิงวิวัฒนาการขนานงานได้ดี เพราะผู้สมัครแต่ละตัวในประชากรสามารถรันอย่างอิสระ แต่โดยทั่วไปต้องใช้ปฏิสัมพันธ์กับสภาพแวดล้อมรวมมากกว่าวิธี deep RL แบบกราเดียนต์จึงจะได้ระดับประสิทธิภาพเดียวกัน
Deep RL ลงโทษทางลัดมากกว่าสายอื่นๆ ด้วยเหตุนี้ ต่อไปนี้คือแนวปฏิบัติที่ควรคำนึงถึงสำหรับโปรเจ็กต์ถัดไป:
Deep reinforcement learning นำลูปลองผิดลองถูกซึ่งเป็นแก่นของ RL มาผสานกับโครงข่ายประสาทเทียมที่รับมือสถานะซึ่งตารางไม่มีทางทำได้
ทุกอัลกอริทึมในบทความนี้จัดอยู่ในสามตระกูล วิธีแบบค่าอย่าง DQN เรียนรู้ฟังก์ชัน Q-value และเลือกการกระทำที่ได้คะแนนสูงสุด วิธีแบบนโยบายอย่าง REINFORCE เรียนรู้นโยบายโดยตรง วิธีแบบ actor-critic รวมถึง PPO ผสานทั้งสองเข้าด้วยกัน ซึ่งเป็นแนวทางที่อัลกอริทึมส่วนใหญ่ในปัจจุบันใช้
แต่อย่าลืมว่าสิ่งเหล่านี้ไม่ได้ได้มาฟรี
ความเสถียรในการฝึก ประสิทธิภาพการใช้ตัวอย่าง การออกแบบรางวัล และการทำซ้ำผลลัพธ์ ล้วนยากขึ้นทันทีที่ย้ายจากตารางมาเป็นเครือข่าย หากต้องการลงลึกต่อไป Q-learning และ reinforcement learning ครอบคลุมพื้นฐานที่บทความนี้ต่อยอดจากมัน และ DQN กับ PPO คือจุดแวะต่อที่ดีสำหรับตัวอัลกอริทึมเอง
เรียนกับ DataCamp
Courses
Courses
Tracks