course
Förstå artificiell intelligens
2 timmar
421.1K
Traditionell förstärkningsinlärning fungerar inte särskilt bra när din miljö blir för stor för att kunna följas manuellt. Anledningen är att varje tillstånd behöver en egen post i en tabell, och varje åtgärd från varje tillstånd behöver ett eget värde.
Till exempel genererar en spelskärm miljontals pixelkombinationer, vilket helt enkelt inte får plats i en tabell du kan loopa igenom. Agenten måste kunna uppskatta värdet av ett tillstånd den aldrig sett, baserat på tillstånd som ser liknande ut.
Fördjupad förstärkningsinlärning löser detta genom att byta ut tabellen mot ett neuralt nätverk som uppskattar värdet av ett tillstånd eller den bästa åtgärden att ta, även i situationer det aldrig stött på direkt. Det är detta som låter agenter bemästra Go och flyga simulerade drönare – båda uppgifter som skulle få alla klassiska RL-algoritmer att fallera.
I den här artikeln guidar jag dig genom kärnkoncepten inom fördjupad RL, de stora algoritmfamiljerna som DQN och PPO, och var de dyker upp i verkligheten.
Om du är ny på förstärkningsinlärning, gå vår Reinforcement Learning in Python-track för att befästa grunderna under en helg.
Fördjupad förstärkningsinlärning är förstärkningsinlärning där ett neuralt nätverk ersätter uppslagstabellen.
Förstärkningsinlärning ger dig redan den grundläggande loopen där en agent provar en åtgärd, ser vad som händer och justerar utifrån belöningen. Djupinlärning tillför ett nätverk som kan omvandla rå indata till något agenten kan agera på. Tillsammans lär sig agenten vilka åtgärder som fungerar bäst direkt från rådata, utan att någon handkodat vad varje tillstånd betyder.
Föreställ dig att du tränar en agent att spela ett spel som Breakout. Agenten får inte en prydlig lista med ”bollposition” eller ”paddelposition” – den får råa pixlar från skärmen. En tabellmetod skulle behöva en separat rad för varje möjlig pixelkombination, och det antalet är ohanterligt. Ett neuralt nätverk tittar direkt på pixlarna och ger ut vilken åtgärd som ska tas, eller hur bra varje åtgärd ser ut, utan att någonsin ha sett just den skärmen tidigare.
Kort sagt: tabellmetoder memorerar, nätverk generaliserar.
Det är därför fördjupad RL fungerar i miljöer som är för stora eller för röriga för att en tabell ska räcka till.
Varje fördjupat RL-system kör samma loop, oavsett vilken algoritm som ligger under.
Så här går det till:
Diagrammet nedan visar loopen i rörelse:
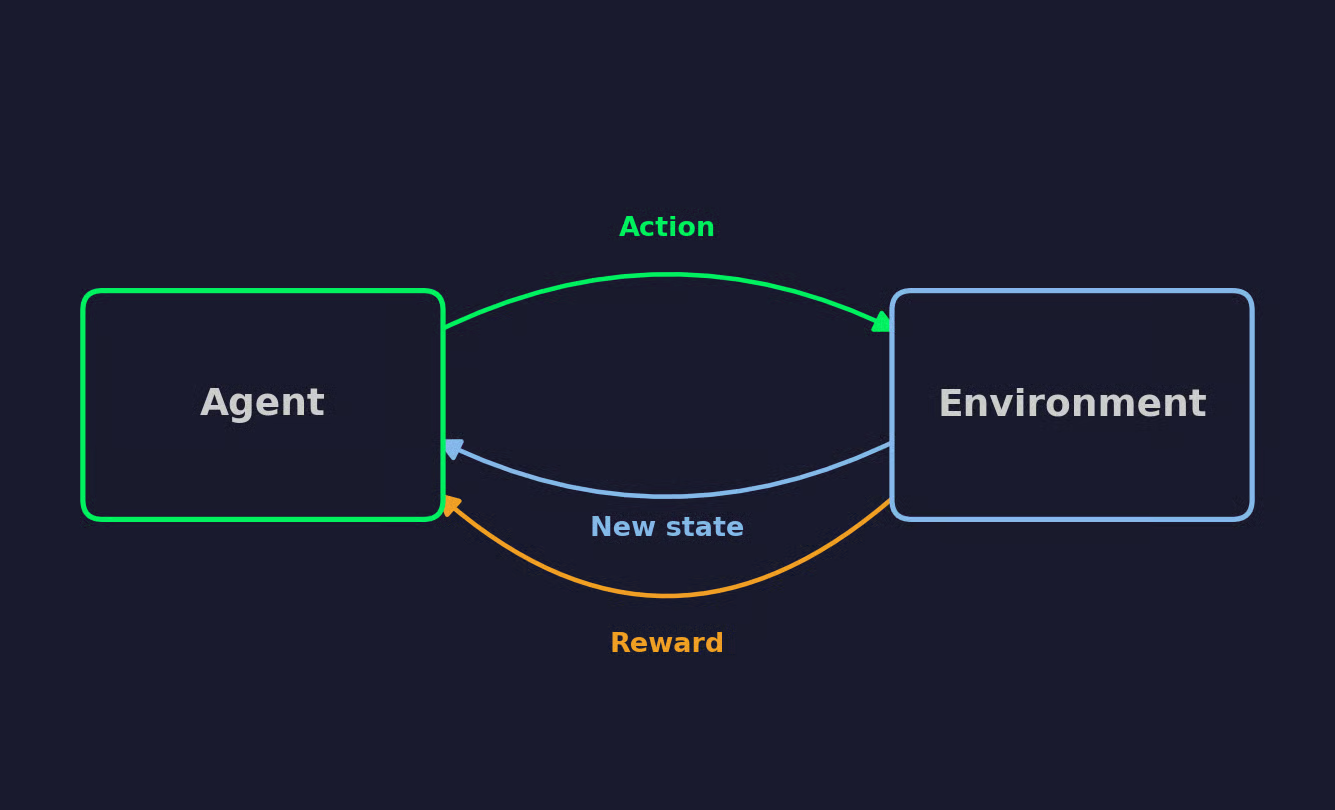
Förstärkningsinlärningens loop
Om du upprepar den här loopen tillräckligt många gånger kommer agentens beteende att skifta mot de åtgärder som maximerar belöningen.
Varje fördjupad RL-algoritm bygger på samma sju idéer. Bekanta dig med dem så blir resten av artikeln betydligt tydligare.
Föreställ dig en robotdammsugare som lär sig städa ett rum. Jag använder det exemplet för alla termer nedan.
Agenten är den som fattar beslut – robotdammsugaren i vårt exempel. Miljön är allt den interagerar med, såsom rummet, möblerna, smutsen och väggarna den kan stöta emot.
Agenten kontrollerar inte miljön, men den väljer åtgärder, och miljön avgör vad som händer härnäst.
Tillståndet beskriver miljöns fullständiga läge vid en given tidpunkt, såsom exakt position för varje smutsfläck och dammsugarens placering. Verkliga agenter får sällan tillgång till det med säkerhet.
I stället agerar de utifrån en observation – det agenten faktiskt kan se, som en kameramatning eller en uppsättning närhetssensorer.
I enkla miljöer är observationen och tillståndet i princip samma sak. I mer komplexa får agenten partiell information och måste fylla i luckorna.
Åtgärder är de drag som finns tillgängliga för agenten i varje ögonblick. För dammsugaren kan det betyda att åka framåt, svänga vänster, svänga höger eller slå på suget.
Åtgärder kan vara diskreta, där agenten väljer från en fast lista, eller kontinuerliga, där agenten väljer ett värde längs ett intervall, som en styrvinkel. Denna skillnad spelar stor roll när du kommer till de olika algoritmfamiljerna senare i artikeln.
En belöning är den numeriska återkoppling agenten får efter att ha utfört en åtgärd. Om dammsugaren rengör en ny yta kan den få en belöning på +1. Men om den kör in i en vägg kan den få -1.
Agentens hela mål är att maximera den totala belöningen över tid, inte bara belöningen från nästa enskilda åtgärd.
En policy är agentens strategi för att mappa tillstånd, eller observationer, till åtgärder. Det är regelboken agenten följer för att bestämma vad den ska göra härnäst.
En policy kan vara deterministisk, där samma åtgärd alltid väljs för ett givet tillstånd, eller stokastisk, där åtgärder väljs baserat på en sannolikhetsfördelning. Fördjupade RL-algoritmer använder ofta ett neuralt nätverk för att representera policyn.
En värdefunktion uppskattar hur mycket framtida belöning agenten kan förvänta sig att samla från ett givet tillstånd, om den fortsätter att följa sin nuvarande policy.
En Q-värdesfunktion gör samma sak för ett tillstånd–åtgärds-par. Den uppskattar framtida belöning från att ta en specifik åtgärd i ett specifikt tillstånd, och sedan följa policyn därefter.
Detta är den typ av funktion som ett neuralt nätverk är bra på att approximera. Det är samma idé som när jag bytte ut uppslagstabellen tidigare i artikeln.
En episod är ett helt genomlopp av agenten i miljön, från starttillståndet till en viss slutbetingelse. För dammsugaren kan det betyda att rummet är helt rent eller att batteriet tar slut.
När en episod avslutas återställs miljön och en ny börjar.
En agent som bara upprepar det som redan fungerat kommer aldrig att hitta något bättre.
Tänk på dammsugaren igen. Den hittar en bana som städar en hyfsad del av rummet och kör samma bana varje gång. Den kollar aldrig hörnet bakom soffan. Det är avvägningen i centrum av förstärkningsinlärning:
Ett vanligt sätt att balansera de två är epsilon-girig utforskning. Vid varje steg väljer agenten en slumpmässig åtgärd med sannolikheten epsilon, ett litet tal som 0,1, och väljer annars den åtgärd den för närvarande tror är bäst. Många algoritmer låter epsilon avta över tid, där agenten utforskar mycket i början och sedan lutar mer åt utnyttjande när den lärt sig tillräckligt för att lita på sitt omdöme.
Det finns ingen fast epsilon som fungerar i varje miljö.
För mycket utforskning slösar tid på åtgärder som fortsätter att misslyckas. För lite utforskning gör att agenten nöjer sig med en hyfsad strategi medan en bättre finns precis bredvid, oupptäckt. Att hitta rätt balans blir bara svårare när miljön blir mer komplex, särskilt när en dålig tidig åtgärd inte avslöjar sin verkliga kostnad förrän många steg senare.
Varje fördjupad RL-algoritm faller in i en av tre familjer, baserat på vad den faktiskt lär sig: en värdefunktion, en policy eller båda samtidigt.
DQN tar Q-värdesfunktionen från tidigare i artikeln och byter uppslagstabellen mot ett neuralt nätverk. Nätverket tar ett tillstånd som indata och ger ett Q-värde för varje möjlig åtgärd, inlärt på samma sätt som ett standardnätverk lär sig annat.
Att träna det nätverket direkt rekommenderas inte. Efterföljande erfarenheter är korrelerade, vilket gör att nätverket överanpassar till det det just såg, och målet det jagar ändras varje gång nätverket uppdateras.
DQN löser båda problemen:
DQN var betydelsefullt eftersom det var den första algoritmen som lärde sig styrpolicys direkt från råa pixlar över ett brett spektrum av Atari-spel, med samma arkitektur och hyperparametrar för varje spel. När DeepMind publicerade det 2015 visade det att djupinlärning och förstärkningsinlärning faktiskt kunde fungera tillsammans i stor skala, utan handbyggda funktioner för varje spel.
I stället för att lära sig en värdefunktion och välja åtgärder baserat på den, lär policygradientmetoder sig policyn. Nätverket tar ett tillstånd och ger sannolikheter för åtgärder, och agenten samplar en åtgärd från den fördelningen.
Detta angreppssätt passar kontinuerliga eller stokastiska åtgärder.
En värdebaserad metod behöver kontrollera varje möjlig åtgärd för att hitta den bästa, vilket bryter samman i samma ögonblick som åtgärdsrymden blir kontinuerlig – du kan inte loopa igenom ett oändligt intervall av styrvinklar. En policygradientmetod samplar bara från fördelningen, oavsett hur många åtgärder som finns.
REINFORCE är den grundläggande algoritmen här. Den kör en hel episod och ökar sedan sannolikheten för åtgärder som ledde till hög total belöning och minskar sannolikheten för åtgärder som ledde till låg total belöning. Haken är att den bara uppdaterar efter att episoden avslutats och att den bygger på den fulla avkastningen, vilket gör uppdateringarna brusiga och inkonsekventa mellan episoder.
Actor–critic-metoder löser REINFORCE:s brusproblem genom att lägga till ett andra nätverk.
Aktören är policyn – den väljer åtgärder på samma sätt som en policygradientmetod skulle. Kritikern är en värdefunktion som bedömer varje åtgärd direkt efter att den hänt, i stället för att vänta tills episoden är klar.
Detta är de värdebaserade och policybaserade angreppssätten som arbetar tillsammans. Aktören lär sig fortfarande en policy, men uppdaterar baserat på kritikerns bedömning av varje åtgärd, inte den fördröjda, brusiga avkastning som REINFORCE förlitar sig på.
A2C och A3C är standardexemplen. A2C kör några kopior av miljön parallellt och uppdaterar aktör och kritiker tillsammans när varje batch är klar. A3C kör dessa kopior asynkront, där var och en uppdaterar det delade nätverket enligt sin egen tidsplan i stället för att vänta på de andra.
Policygradientuppdateringar kan gå fel om du låter dem bli för stora. En tillräckligt stor uppdatering kan förstöra en policy som fungerade bra, och det går inte att ångra när det väl hänt.
PPO begränsar storleken på varje uppdatering för att undvika det. Här är det klippta målet det optimerar:
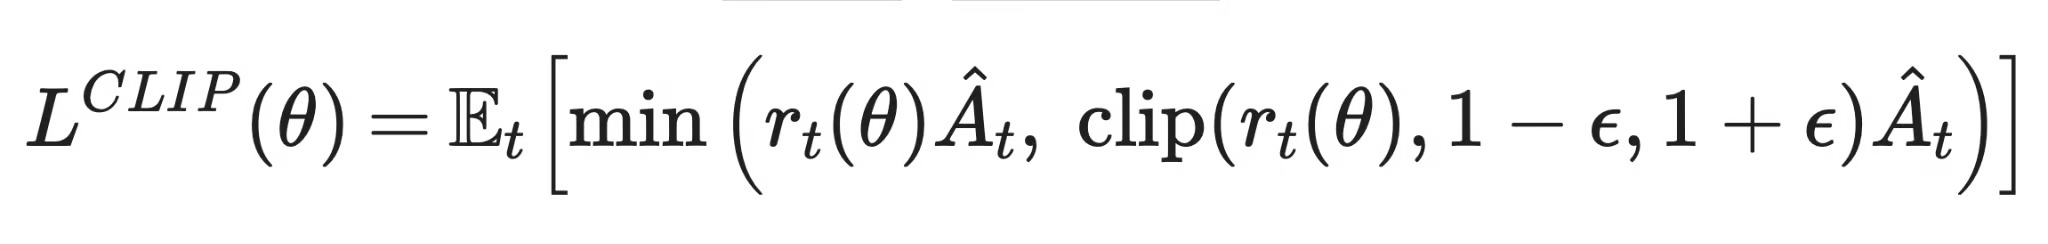
Proximal policy optimization
r_t(θ) är kvoten mellan den nya policyns sannolikhet för en åtgärd och den gamla policyns sannolikhet för samma åtgärd. Â_t är fördelen, dvs. hur mycket bättre den åtgärden utföll jämfört med kritikerns baslinjeförväntan. Funktionen clip() håller kvoten inom ett smalt band runt 1, så att policyn inte kan flytta sig för långt i ett enda steg. min() väljer sedan den mer konservativa av de två uppskattningarna, så att en ovanligt stor fördelsuppskattning inte kan pressa uppdateringen längre än vad klippningen tillåter.
OpenAI introducerade PPO 2017, och det blev nästan omedelbart ett standardval. Det är enklare att implementera och ställa in än trust-region-metoderna som kom före, och det står sig väl i många olika miljöer utan mycket uppgiftsspecifik justering.
DDPG och Soft Actor–Critic (SAC) riktar sig båda mot kontinuerlig styrning, som robotledvinklar eller styrvärden, där agenten behöver ge ut ett specifikt tal i stället för att välja från en fördelning.
DDPG är en actor–critic-metod vars aktör ger en enskild deterministisk åtgärd i stället för en fördelning, och den lånar erfarenhetsåterspelning och målnätverk från DQN.
SAC bygger på samma idé men lägger till en entriterm som belönar policyn för att förbli något slumpmässig, vilket gör att agenten fortsätter utforska längre och tenderar att göra träningen mer stabil än DDPG:s.
Värdebaserade metoder, som DQN, lär sig en Q-värdesfunktion och väljer den åtgärd som den funktionen ger högst betyg. Detta fungerar bra för diskreta åtgärdsrymder och får god sample-effektivitet från erfarenhetsåterspelning, men det utökas inte till kontinuerliga åtgärder utan extra arbete.
Policybaserade metoder som REINFORCE lär sig policyn direkt och samplar åtgärder från en sannolikhetsfördelning. Det är därför de fungerar med kontinuerliga och stokastiska åtgärder, men rena policygradientuppdateringar är brusiga och kräver färska data för varje uppdatering.
Actor–critic-metoder, inklusive A2C/A3C, PPO, DDPG och SAC, kombinerar båda idéerna. Kritikerns snabba återkoppling stabiliserar aktörens uppdateringar, vilket är anledningen till att de flesta algoritmer som används i praktiken i dag faller i denna kategori.
Här är en mer visuell jämförelse:
| Vad som lärs | Hur åtgärder väljs | Diskret vs. kontinuerlig | Stabilitet | Sample-effektivitet | Representativa algoritmer | |
|---|---|---|---|---|---|---|
| Värdebaserad | Q-värdesfunktion | Högst betygsatt åtgärd | Diskret | Behöver målnätverk och återspelning för att vara stabil | God, tack vare erfarenhetsåterspelning | DQN |
| Policybaserad | Policy | Samplerad från policyns fördelning | Båda, bäst med kontinuerlig | Brusiga uppdateringar med hög varians | Svag, kräver nya data för varje uppdatering | REINFORCE |
| Actor–critic | Policy och värdefunktion | Samplerad från aktören, guidad av kritikern | Båda | Stabilare än rena policybaserade metoder | Bättre än rena policybaserade metoder | A2C/A3C, PPO, DDPG, SAC |
Metoder inom fördjupad förstärkningsinlärning jämförda
I övervakad inlärning får man ett märkt svar för varje exempel. Fördjupad RL måste lista ut vad som fungerade utifrån en belöningssignal som dyker upp sent, blandas med åtgärderna innan och ibland inte visar sig på något användbart sätt alls.
Fördjupade RL-agenter behöver ofta miljontals miljösteg innan de lär sig något användbart, särskilt jämfört med hur lite data en övervakad modell behöver för att nå liknande noggrannhet på ett fast dataset.
Anledningen är att agenten måste generera sina egna träningsdata genom att agera, och de flesta åtgärderna i början är nära slumpmässiga. En övervakad modell kan återanvända samma märkta dataset om och om igen. En RL-agent måste fortsätta utforska en miljö den knappt förstår, ett steg i taget.
RL-träning är ofta instabil.
En del av problemet är att värdefunktioner bootstrappas från sina egna uppskattningar, där dagens Q-värdesmål beror på gårdagens Q-värdesgissning. Om den gissningen är felaktig byggs felet på i stället för att rätta till sig. Dessutom ändras agentens policy medan den lär sig, så datan den samlar in skiftar också.
Med andra ord jagar nätverket ett rörligt mål på två fronter samtidigt.
Vissa miljöer delar bara ut en belöning i slutet, som en vinst- eller förlustsignal efter ett långt spel. Agenten måste arbeta baklänges från det enda talet och lista ut vilka av dussintals åtgärder som faktiskt spelade roll.
Detta kallas kreditallokeringsproblemet, och det blir värre ju längre fördröjningen är mellan en åtgärd och dess konsekvens.
Belöningsdesign låter lätt tills du försöker.
Här är ett känt exempel. En båtspelsagent tränad av OpenAI belönades för att passera kontrollpunkter, så den hittade en lagun med återuppdykande power-ups och loopade där för alltid, samlade poäng utan att någonsin avsluta loppet. Belöningsfunktionen gjorde exakt vad den blev tillsagd – agenten fick bara aldrig veta vad ”vinna” faktiskt betydde. Denna skillnad mellan vad du belönar och vad du faktiskt vill ha kallas reward hacking, och den dyker upp i någon form i nästan varje belöningsfunktion du skriver.
Samma algoritm, körd med ett annat slumpfrö, kan ge olika resultat.
Publicerade resultat är svåra att reproducera utan exakt kodbas, hyperparametrar och frön som de ursprungliga forskarna använde. Små implementationsdetaljer, som hur observationer normaliseras eller hur återspelningsbufferten initieras, kan påverka prestanda mer än själva algoritmvalet.
I en simulator kan en agent misslyckas om och om igen, hur många gånger som helst. Verkligheten fungerar inte så.
Till exempel utsätter en självkörningspolicy som utforskar en dålig åtgärd på en motorväg människor för risk. Simulatorer fångar aldrig verkligheten perfekt; kantfall som simulatorn aldrig modellerade dyker upp så fort policyn lämnar labbet. En policy som ser utmärkt ut i simulering kan fallera på oförutsedda sätt när den möter en verklig miljö, vilket är varför driftsättning av fördjupad RL utanför spel och simulatorer kräver betydligt mer försiktighet än vad benchmark-siffror antyder.
Nu lyfter jag fram skillnaderna mellan fördjupad förstärkningsinlärning och mer traditionella angreppssätt.
Övervakad inlärning tränas på märkta exempel, där varje indata redan har ett korrekt svar. Fördjupad RL får aldrig det – den får bara en belöning efter att ha agerat och måste själv lista ut vilka åtgärder som ledde till den belöningen.
Imitation learning tränar en policy att kopiera en experts demonstrationer, utan att någonsin använda en belöningssignal. Fördjupad RL upptäcker beteende genom trial and error i stället.
Imitation learning får snabbt igång en policy, men den begränsas av hur bra demonstrationerna är och har det svårt så fort agenten hamnar i en situation som experten aldrig visade. Fördjupad RL kan i teorin överträffa alla lärare, men den kräver mycket mer interaktion och en belöningsfunktion som faktiskt pekar mot det beteende du vill ha.
Evolutionsalgoritmer optimerar en policy genom att mutera en population av kandidater och behålla dem som presterar bäst, utan någon gradientberäkning alls. Fördjupad RL beräknar gradienter från belöningssignalen och uppdaterar en enda policy.
Evolutionära metoder kan parallelliseras väl, eftersom varje kandidat i populationen kan köras oberoende. Men de kräver vanligtvis betydligt fler totala miljöinteraktioner än gradientbaserad fördjupad RL för att nå samma prestandanivå.
Fördjupad RL bestraffar genvägar mer än de flesta andra områden. Med det i åtanke följer här några rekommenderade arbetssätt för ditt nästa projekt:
Fördjupad förstärkningsinlärning tar trial-and-error-loopen i kärnan av RL och kombinerar den med ett neuralt nätverk som kan hantera tillstånd som ingen uppslagstabell någonsin skulle klara.
Varje algoritm i den här artikeln tillhör en av tre familjer. Värdebaserade metoder, som DQN, lär sig en Q-värdesfunktion och väljer den åtgärd som får högst betyg. Policybaserade metoder, som REINFORCE, lär sig en policy direkt. Actor–critic-metoder, inklusive PPO, kombinerar båda, och den kombinationen är vad de flesta algoritmer använder i dag.
Kom bara ihåg att inget av detta är gratis.
Träningsstabilitet, sample-effektivitet, belöningsdesign och reproducerbarhet blir alla svårare i samma ögonblick som du går från tabell till nätverk. Om du vill fördjupa dig mer täcker Q-learning och reinforcement learning grunderna som den här artikeln bygger på, och DQN och PPO är bra nästa stopp för själva algoritmerna.
Lär dig med DataCamp
course
course
track