Kursus
Memahami Kecerdasan Buatan
2 Hr
421.1K
Pembelajaran penguatan tradisional tidak benar-benar bekerja ketika lingkungan Anda menjadi terlalu besar untuk dilacak secara manual. Alasannya adalah karena setiap keadaan membutuhkan entri tersendiri dalam sebuah tabel, dan setiap aksi dari setiap keadaan membutuhkan nilainya sendiri.
Sebagai contoh, sebuah layar gim menghasilkan jutaan kombinasi piksel, yang jelas tidak bisa dimasukkan ke dalam tabel yang dapat Anda iterasi. Agen perlu menebak nilai dari suatu keadaan yang belum pernah dilihatnya, berdasarkan keadaan yang terlihat mirip.
Pembelajaran penguatan mendalam mengatasinya dengan mengganti tabel dengan jaringan saraf yang memperkirakan nilai suatu keadaan atau aksi terbaik yang perlu diambil, bahkan untuk situasi yang belum pernah dihadapinya secara langsung. Inilah yang memungkinkan agen menguasai Go dan menerbangkan drone simulasi—keduanya tugas yang akan membuat algoritme RL klasik kewalahan.
Dalam artikel ini, saya akan mengajak Anda memahami konsep inti deep RL, keluarga algoritme utama seperti DQN dan PPO, serta penerapannya di dunia nyata.
Jika Anda baru mengenal pembelajaran penguatan, daftar di jalur Reinforcement Learning in Python kami untuk mematangkan dasar-dasarnya dalam satu akhir pekan.
Pembelajaran penguatan mendalam adalah pembelajaran penguatan dengan jaringan saraf menggantikan tabel pencarian.
Pembelajaran penguatan sudah memberikan loop dasar di mana agen mencoba sebuah aksi, melihat apa yang terjadi, dan menyesuaikan diri berdasarkan penghargaan. Pembelajaran mendalam menambahkan jaringan yang dapat mengubah masukan mentah menjadi sesuatu yang bisa ditindaklanjuti oleh agen. Jika digabungkan, agen belajar aksi mana yang paling efektif langsung dari data mentah, tanpa ada yang mengodekan secara manual makna setiap keadaan.
Bayangkan Anda melatih agen untuk memainkan gim seperti Breakout. Agen tidak mendapatkan daftar rapi seperti "posisi bola" atau "posisi paddle"—ia mendapatkan piksel mentah dari layar. Metode tabular membutuhkan baris terpisah untuk setiap kemungkinan kombinasi piksel, dan jumlahnya tidak terkelola. Jaringan saraf melihat piksel secara langsung dan menghasilkan aksi yang harus diambil, atau seberapa bagus setiap aksi, tanpa pernah melihat layar yang persis sama sebelumnya.
Singkatnya, metode tabular menghafal, dan jaringan melakukan generalisasi.
Itulah yang membuat deep RL bekerja di lingkungan yang terlalu besar atau terlalu berantakan untuk ditangani sebuah tabel.
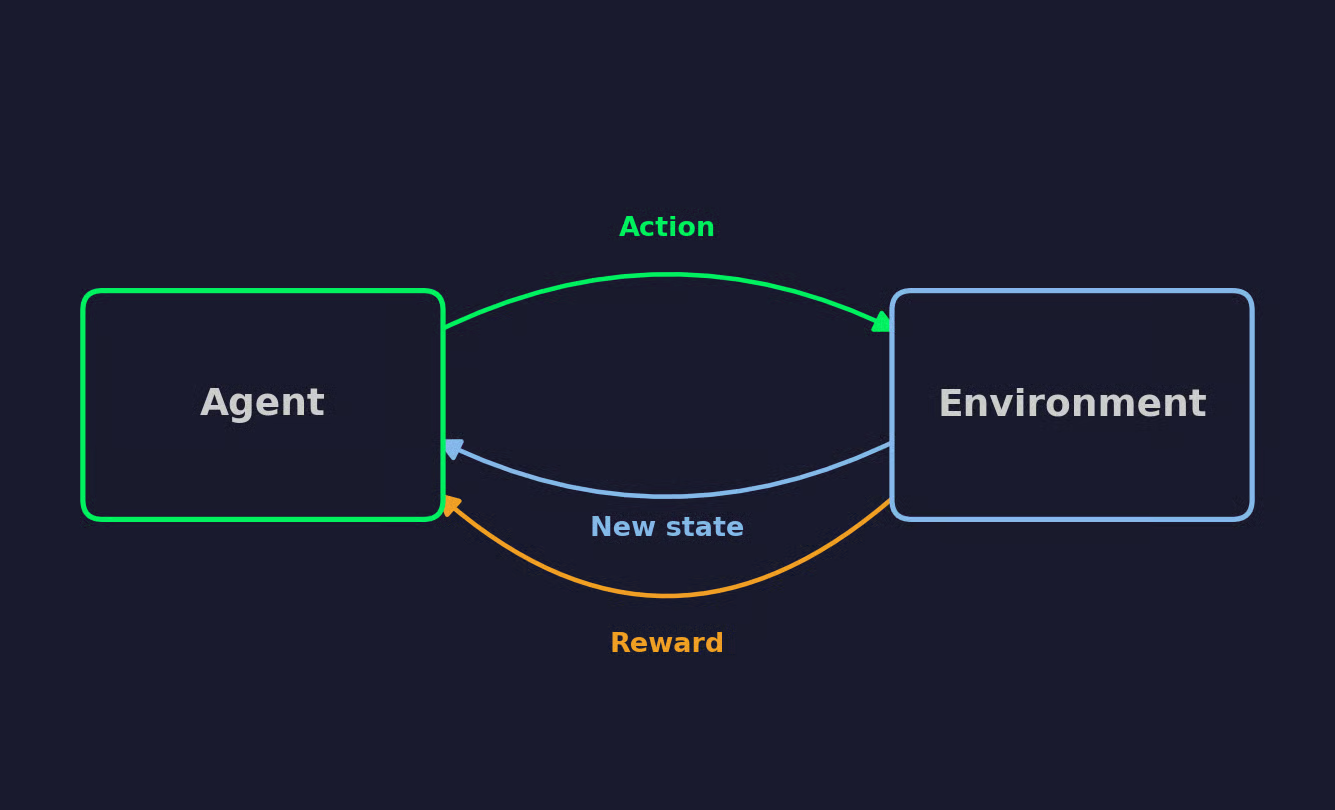
Setiap sistem deep RL menjalankan loop yang sama, apa pun algoritme yang digunakan di bawahnya.
Berikut alurnya:
Diagram di bawah menunjukkan loop ini saat berjalan:
Loop pembelajaran penguatan
Jika Anda mengulangi loop ini cukup sering, perilaku agen akan bergeser menuju aksi-aksi yang terus memaksimalkan penghargaan.
Setiap algoritme deep RL dibangun di atas tujuh gagasan yang sama. Anda sebaiknya memahami ini agar sisa artikel menjadi jauh lebih masuk akal.
Bayangkan robot penyedot debu yang belajar membersihkan ruangan. Saya akan menggunakan contoh itu untuk setiap istilah di bawah.
Agen adalah pengambil keputusan—robot penyedot debu dalam contoh kita. Lingkungan adalah segala sesuatu yang berinteraksi dengannya, seperti ruangan, furnitur, kotoran, dinding yang bisa ditabraknya.
Agen tidak mengontrol lingkungan, tetapi ia memilih aksi, dan lingkungan yang menentukan apa yang terjadi selanjutnya.
Keadaan menggambarkan kondisi penuh lingkungan pada momen tertentu, seperti posisi tepat setiap gumpalan kotoran dan lokasi penyedot debu. Agen nyata jarang mendapatkan akses pasti terhadap hal itu.
Sebagai gantinya, mereka bertindak berdasarkan observasi—apa pun yang sebenarnya bisa dilihat oleh agen, seperti umpan kamera atau serangkaian sensor jarak.
Di lingkungan sederhana, observasi dan keadaan pada dasarnya hal yang sama. Di lingkungan yang lebih kompleks, agen bekerja dengan informasi parsial dan harus mengisi kekurangannya.
Aksi adalah gerakan yang tersedia bagi agen pada momen tertentu. Untuk penyedot debu, itu bisa berarti bergerak maju, berbelok ke kiri, berbelok ke kanan, atau mengaktifkan hisap.
Aksi bisa bersifat diskret, di mana agen memilih dari daftar tetap, atau kontinu, di mana agen memilih nilai sepanjang suatu rentang, seperti sudut kemudi. Perbedaan ini sangat penting ketika Anda sampai pada keluarga algoritme berbeda nanti di artikel.
Penghargaan adalah umpan balik numerik yang diterima agen setelah mengambil sebuah aksi. Jika penyedot debu membersihkan area lantai baru, ia mungkin mendapat penghargaan +1. Namun ketika menabrak dinding, ia mungkin mendapat -1.
Tujuan utama agen adalah memaksimalkan total penghargaan yang dikumpulkan seiring waktu, bukan hanya penghargaan dari aksi berikutnya saja.
Kebijakan adalah strategi agen untuk memetakan keadaan, atau observasi, ke aksi. Ini adalah buku aturan yang diikuti agen untuk memutuskan apa yang harus dilakukan selanjutnya.
Kebijakan bisa deterministik, selalu memilih aksi yang sama untuk suatu keadaan tertentu, atau stokastik, memilih aksi berdasarkan distribusi probabilitas. Algoritme deep RL sering menggunakan jaringan saraf untuk merepresentasikan kebijakan ini.
Fungsi nilai memperkirakan seberapa banyak penghargaan masa depan yang dapat diharapkan agen dari suatu keadaan, jika ia terus mengikuti kebijakannya saat ini.
Fungsi Q-value melakukan hal yang sama untuk pasangan keadaan-aksi. Ia memperkirakan penghargaan masa depan dari mengambil aksi tertentu dalam keadaan tertentu, lalu mengikuti kebijakan sesudahnya.
Inilah jenis fungsi yang bagus diaproksimasi oleh jaringan saraf. Ini adalah gagasan yang sama ketika saya mengganti tabel pencarian sebelumnya di artikel.
Episode adalah satu putaran penuh agen melalui lingkungan, dari keadaan awal hingga kondisi akhir tertentu. Untuk penyedot debu, itu bisa berarti ruangan sudah bersih seluruhnya atau baterai habis.
Setelah sebuah episode berakhir, lingkungan disetel ulang, dan episode baru dimulai.
Agen yang hanya mengulang apa yang sudah berhasil tidak akan pernah menemukan sesuatu yang lebih baik.
Bayangkan lagi penyedot debu. Ia menemukan jalur yang membersihkan sebagian lumayan dari ruangan, dan ia terus menjalankan jalur yang sama setiap waktu. Ia tidak pernah memeriksa sudut di belakang sofa. Itulah trade-off di pusat pembelajaran penguatan:
Salah satu cara umum untuk menyeimbangkan keduanya adalah eksplorasi epsilon-greedy. Pada setiap langkah, agen memilih aksi acak dengan probabilitas epsilon, angka kecil seperti 0,1, dan sebaliknya memilih aksi apa pun yang saat ini diyakininya terbaik. Banyak algoritme mengurangi epsilon seiring waktu, di mana agen banyak mengeksplorasi pada awalnya, lalu lebih mengandalkan eksploitasi setelah cukup belajar untuk memercayai penilaiannya sendiri.
Tidak ada nilai epsilon tetap yang bekerja di setiap lingkungan.
Terlalu banyak eksplorasi membuang waktu pada aksi-aksi yang terus gagal. Terlalu sedikit eksplorasi berarti agen puas dengan strategi yang lumayan sementara strategi yang lebih baik ada tepat di sebelahnya, belum ditemukan. Mendapatkan keseimbangan ini dengan benar menjadi makin sulit saat lingkungan semakin kompleks, terutama ketika aksi buruk di awal tidak mengungkap biaya sebenarnya hingga banyak langkah kemudian.
Setiap algoritme deep RL termasuk dalam salah satu dari tiga keluarga, berdasarkan apa yang sebenarnya dipelajari: fungsi nilai, kebijakan, atau keduanya sekaligus.
DQN mengambil fungsi Q-value dari bagian sebelumnya dan mengganti tabel pencarian dengan jaringan saraf. Jaringan menerima keadaan sebagai masukan dan menghasilkan Q-value untuk setiap aksi yang mungkin, dipelajari dengan cara yang sama seperti jaringan saraf standar mempelajari hal lain.
Melatih jaringan itu secara langsung tidak direkomendasikan. Pengalaman berurutan berkorelasi, yang membuat jaringan overfit pada apa pun yang baru saja dilihatnya, dan target yang dikejarnya berubah setiap kali jaringan diperbarui.
DQN memperbaiki kedua masalah tersebut:
DQN penting karena merupakan algoritme pertama yang mempelajari kebijakan kontrol langsung dari piksel mentah di berbagai gim Atari, menggunakan arsitektur dan hyperparameter yang sama untuk masing-masing. Saat DeepMind menerbitkannya pada 2015, itu membuktikan pembelajaran mendalam dan pembelajaran penguatan benar-benar bisa bekerja bersama dalam skala besar, tanpa fitur buatan tangan untuk setiap gim.
Alih-alih mempelajari fungsi nilai dan memilih aksi berdasarkan itu, metode policy gradient mempelajari kebijakan. Jaringan menerima keadaan dan menghasilkan probabilitas aksi, dan agen mengambil sampel aksi dari distribusi tersebut.
Pendekatan ini cocok untuk aksi kontinu atau stokastik.
Metode berbasis nilai perlu memeriksa setiap aksi yang mungkin untuk menemukan yang terbaik, yang langsung gagal begitu ruang aksi menjadi kontinu—Anda tidak bisa mengiterasi rentang sudut kemudi yang tak terhingga. Metode policy gradient cukup mengambil sampel dari distribusi, berapa pun banyaknya aksi yang ada.
REINFORCE adalah algoritme dasar di sini. Ia menjalankan satu episode penuh, lalu meningkatkan probabilitas aksi yang menghasilkan total penghargaan tinggi dan menurunkan probabilitas aksi yang menghasilkan total penghargaan rendah. Kekurangannya adalah ia hanya memperbarui setelah episode berakhir, dan bergantung pada return penuh, yang membuat pembaruannya berisik dan tidak konsisten dari satu episode ke episode berikutnya.
Metode actor-critic memperbaiki masalah noise REINFORCE dengan menambahkan jaringan kedua.
Aktor adalah kebijakan—ia memilih aksi dengan cara yang sama seperti metode policy gradient. Kritikus adalah fungsi nilai yang menilai setiap aksi tepat setelah aksi itu terjadi, alih-alih menunggu episode selesai.
Ini adalah pendekatan berbasis nilai dan berbasis kebijakan yang bekerja bersama. Aktor tetap mempelajari kebijakan, tetapi ia memperbarui berdasarkan penilaian kritikus atas setiap aksi, bukan return yang tertunda dan berisik yang diandalkan REINFORCE.
A2C dan A3C adalah contoh standarnya. A2C menjalankan beberapa salinan lingkungan secara paralel dan memperbarui aktor serta kritikus bersama-sama setelah setiap batch selesai. A3C menjalankan salinan-salinan itu secara asinkron, di mana masing-masing memperbarui jaringan bersama sesuai jadwalnya sendiri alih-alih menunggu yang lain.
Pembaruan policy gradient bisa bermasalah jika dibiarkan terlalu besar. Pembaruan yang cukup besar dapat merusak kebijakan yang tadinya berjalan baik, dan tidak ada cara untuk membaliknya setelah terjadi.
PPO membatasi besarnya setiap pembaruan untuk menghindarinya. Berikut objektif terklip yang dioptimalkannya:
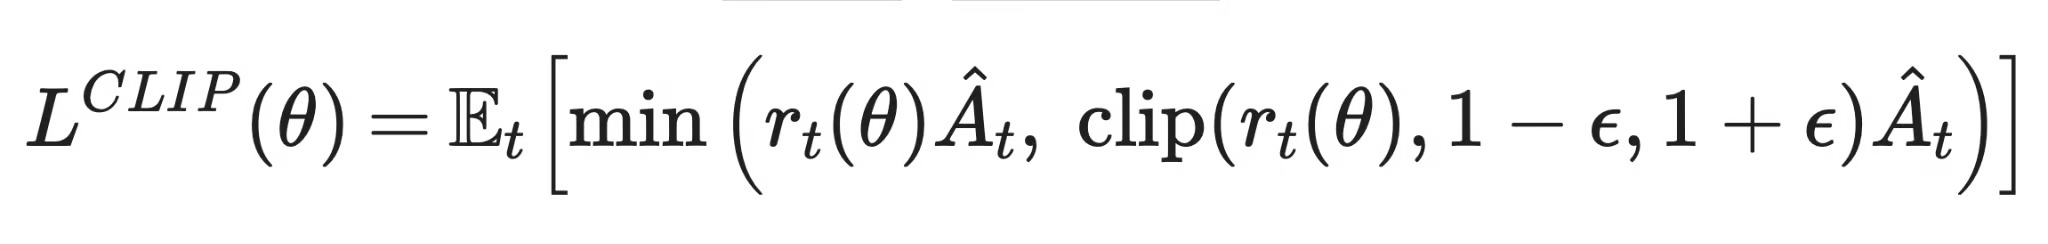
Proximal policy optimization
r_t(θ) adalah rasio antara probabilitas aksi pada kebijakan baru dan probabilitas aksi yang sama pada kebijakan lama. Â_t adalah advantage, atau seberapa jauh aksi tersebut ternyata lebih baik dibandingkan ekspektasi dasar dari kritikus. Fungsi clip() menjaga rasio tetap dalam pita sempit di sekitar 1, sehingga kebijakan tidak bisa bergeser terlalu jauh dalam satu langkah. Lalu min() memilih estimasi yang lebih konservatif dari keduanya, sehingga estimasi advantage yang luar biasa besar tidak mendorong pembaruan melebihi batas klip.
OpenAI memperkenalkan PPO pada 2017, dan hampir seketika menjadi pilihan default. Ini lebih mudah diimplementasikan dan dituning daripada metode trust-region yang mendahuluinya, dan tetap andal di berbagai lingkungan tanpa banyak penyesuaian per tugas.
DDPG dan Soft Actor-Critic (SAC) keduanya menargetkan masalah kontrol kontinu, seperti sudut sendi robot atau nilai kemudi, di mana agen perlu menghasilkan angka spesifik alih-alih memilih dari distribusi.
DDPG adalah metode actor-critic yang aktornya menghasilkan satu aksi deterministik alih-alih distribusi, dan ia meminjam experience replay serta target network dari DQN.
SAC dibangun di atas gagasan yang sama namun menambahkan istilah entropi yang memberi penghargaan pada kebijakan karena tetap agak acak, yang membuat agen mengeksplorasi lebih lama dan cenderung membuat pelatihan lebih stabil daripada DDPG.
Metode berbasis nilai, seperti DQN, mempelajari fungsi Q-value dan memilih aksi apa pun yang diberi nilai tertinggi oleh fungsi tersebut. Ini bekerja baik untuk ruang aksi diskret dan mendapatkan efisiensi sampel yang baik dari experience replay, namun tidak meluas ke aksi kontinu tanpa upaya tambahan.
Metode berbasis kebijakan seperti REINFORCE mempelajari kebijakan secara langsung, mengambil sampel aksi dari distribusi probabilitas. Itulah yang membuatnya bekerja dengan aksi kontinu dan stokastik, tetapi pembaruan policy gradient murni bersifat berisik dan memerlukan data segar untuk setiap pembaruan.
Metode actor-critic, termasuk A2C/A3C, PPO, DDPG, dan SAC, menggabungkan kedua gagasan. Umpan balik cepat dari kritikus menstabilkan pembaruan aktor, itulah sebabnya sebagian besar algoritme yang digunakan dalam praktik saat ini termasuk dalam kategori ini.
Berikut perbandingan yang lebih visual:
| Apa yang dipelajari | Cara pemilihan aksi | Diskret vs. kontinu | Stabilitas | Efisiensi sampel | Algoritme perwakilan | |
|---|---|---|---|---|---|---|
| Berbasis nilai | Fungsi Q-value | Aksi dengan nilai tertinggi | Diskret | Butuh target network dan replay agar tetap stabil | Baik, berkat experience replay | DQN |
| Berbasis kebijakan | Kebijakan | Diambil sampel dari distribusi kebijakan | Keduanya, terbaik untuk kontinu | Pembaruan berisik, varians tinggi | Buruk, butuh data baru untuk setiap pembaruan | REINFORCE |
| Actor-critic | Kebijakan dan fungsi nilai | Diambil sampel dari aktor, dipandu oleh kritikus | Keduanya | Lebih stabil daripada metode berbasis kebijakan murni | Lebih baik daripada metode berbasis kebijakan murni | A2C/A3C, PPO, DDPG, SAC |
Perbandingan metode pembelajaran penguatan mendalam
Pembelajaran terawasi mendapatkan jawaban berlabel untuk setiap contoh. Deep RL harus mencari tahu apa yang berhasil dari sinyal penghargaan yang muncul terlambat, tercampur dengan aksi-aksi sebelumnya, dan terkadang tidak muncul dengan cara yang berguna sama sekali.
Agen deep RL sering membutuhkan jutaan langkah lingkungan sebelum mereka mempelajari sesuatu yang berguna, terutama dibandingkan dengan sedikitnya data yang dibutuhkan model terawasi untuk mencapai akurasi serupa pada dataset tetap.
Alasannya adalah karena agen harus menghasilkan data latihannya sendiri dengan bertindak, dan sebagian besar aksi tersebut di awal hampir acak. Model terawasi dapat menggunakan kembali dataset berlabel yang sama berulang kali. Agen RL harus terus mengeksplorasi lingkungan yang nyaris tidak dipahaminya, selangkah demi selangkah.
Pelatihan RL sering tidak stabil.
Sebagian masalahnya adalah fungsi nilai melakukan bootstrap dari estimasi mereka sendiri, di mana target Q-value hari ini bergantung pada tebakan Q-value kemarin. Jika tebakan itu meleset, kesalahan akan bertambah alih-alih memperbaiki diri. Di atas itu, kebijakan agen terus berubah saat ia belajar, sehingga data yang dikumpulkannya juga terus bergeser.
Dengan kata lain, jaringan mengejar target yang bergerak di dua sisi sekaligus.
Beberapa lingkungan hanya memberikan penghargaan di akhir, seperti sinyal menang atau kalah setelah gim yang panjang. Agen harus menelusuri balik dari satu angka itu dan mencari tahu mana dari puluhan aksi yang diambilnya yang benar-benar berpengaruh.
Ini disebut masalah penetapan kredit (credit assignment), dan menjadi lebih buruk semakin lama jeda antara suatu aksi dan konsekuensinya.
Merancang penghargaan terdengar mudah sampai Anda mencobanya.
Berikut contoh terkenal. Agen balap perahu yang dilatih OpenAI diberi penghargaan untuk melewati pos pemeriksaan, sehingga ia menemukan laguna dengan power-up yang muncul kembali dan berputar di sana tanpa henti, mengumpulkan skor tanpa pernah menyelesaikan balapan. Fungsi penghargaan melakukan persis seperti yang diperintahkan—agen hanya tidak diberi tahu apa arti "menang" sebenarnya. Perbedaan antara apa yang Anda beri penghargaan dan apa yang sebenarnya Anda inginkan disebut peretasan penghargaan (reward hacking), dan itu muncul dalam beberapa bentuk di hampir setiap fungsi penghargaan yang Anda tulis.
Algoritme yang sama, dijalankan dengan seed acak berbeda, dapat menghasilkan hasil yang berbeda.
Hasil yang dipublikasikan sulit direproduksi tanpa basis kode, hyperparameter, dan seed yang persis sama seperti yang digunakan peneliti asli. Detail implementasi kecil, seperti bagaimana observasi dinormalisasi atau bagaimana buffer replay diinisialisasi, dapat menggeser kinerja lebih dari pilihan algoritme itu sendiri.
Simulator memungkinkan agen gagal berulang kali sebanyak yang diperlukan. Dunia nyata tidak seperti itu.
Sebagai contoh, kebijakan mengemudi mandiri yang mengeksplorasi aksi buruk di jalan raya membahayakan orang. Simulator tidak pernah menangkap dunia nyata dengan sempurna, karena kasus tepi yang tidak pernah dimodelkan simulator akan muncul begitu kebijakan keluar dari lab. Kebijakan yang terlihat hebat dalam simulasi dapat gagal dengan cara yang tak terduga saat bertemu lingkungan nyata, itulah mengapa penerapan deep RL di luar gim dan simulator memerlukan kehati-hatian jauh lebih besar daripada yang disiratkan angka tolok ukur.
Sekarang saya akan menyoroti perbedaan antara pembelajaran penguatan mendalam dan pendekatan yang lebih tradisional.
Pembelajaran terawasi dilatih pada contoh berlabel, di mana setiap masukan sudah memiliki jawaban yang benar. Deep RL tidak pernah mendapatkannya—ia hanya mendapatkan penghargaan setelah bertindak, dan harus mencari tahu sendiri aksi mana yang menghasilkan penghargaan tersebut.
Pembelajaran imitasi melatih kebijakan untuk menyalin demonstrasi ahli, tanpa pernah menggunakan sinyal penghargaan. Deep RL menemukan perilaku melalui coba-coba.
Pembelajaran imitasi membuat kebijakan berjalan cepat, tetapi dibatasi oleh seberapa baik demonstrasinya, dan kesulitan begitu agen berada dalam situasi yang tidak pernah ditunjukkan oleh ahli. Deep RL secara teori dapat melampaui kinerja pengajar mana pun, tetapi membutuhkan jauh lebih banyak interaksi dan fungsi penghargaan yang benar-benar mengarah ke perilaku yang Anda inginkan.
Algoritme evolusioner mengoptimalkan kebijakan dengan memutasi populasi kandidat dan mempertahankan mana pun yang berkinerja terbaik, tanpa komputasi gradien sama sekali. Deep RL menghitung gradien dari sinyal penghargaan dan memperbarui satu kebijakan.
Metode evolusioner mudah diparalelkan, karena setiap kandidat dalam populasi dapat berjalan secara independen. Namun mereka biasanya membutuhkan jauh lebih banyak interaksi lingkungan total daripada deep RL berbasis gradien untuk mencapai tingkat kinerja yang sama.
Deep RL lebih menghukum jalan pintas daripada sebagian besar bidang lain. Dengan itu, berikut beberapa praktik terbaik yang perlu diingat untuk proyek Anda berikutnya:
Pembelajaran penguatan mendalam mengambil loop coba-coba di inti RL dan menggabungkannya dengan jaringan saraf yang dapat menangani keadaan yang tidak mungkin ditangani tabel pencarian mana pun.
Setiap algoritme dalam artikel ini termasuk dalam salah satu dari tiga keluarga. Metode berbasis nilai, seperti DQN, mempelajari fungsi Q-value dan memilih aksi apa pun yang nilainya tertinggi. Metode berbasis kebijakan, seperti REINFORCE, mempelajari kebijakan secara langsung. Metode actor-critic, termasuk PPO, menggabungkan keduanya, dan kombinasi itulah yang paling banyak digunakan algoritme saat ini.
Perlu diingat bahwa tidak ada yang gratis di sini.
Stabilitas pelatihan, efisiensi sampel, perancangan penghargaan, dan reproduksibilitas semuanya menjadi lebih sulit begitu Anda berpindah dari tabel ke jaringan. Jika Anda ingin menggali lebih dalam, Q-learning dan pembelajaran penguatan membahas fondasi yang menjadi dasar artikel ini, dan DQN serta PPO adalah tempat lanjut yang baik untuk algoritmenya sendiri.
Belajar bersama DataCamp
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt