Cours
Comprendre l'intelligence artificielle
2 h
421.1K
L’apprentissage par renforcement classique atteint vite ses limites dès que l’environnement devient trop vaste pour être suivi à la main. Chaque état nécessite sa propre entrée dans une table, et chaque action depuis chaque état doit avoir sa valeur associée.
Par exemple, l’écran d’un jeu génère des millions de combinaisons de pixels, impossibles à faire tenir dans une table que l’on parcourrait. L’agent doit estimer la valeur d’un état jamais observé à partir d’états qui lui ressemblent.
L’apprentissage par renforcement profond contourne le problème en remplaçant la table par un réseau de neurones qui estime la valeur d’un état ou la meilleure action à entreprendre, y compris dans des situations jamais rencontrées directement. C’est ce qui permet à des agents de maîtriser le Go ou de piloter des drones simulés, des tâches qui feraient exploser tout algorithme RL classique.
Dans cet article, je vous présente les concepts clés du deep RL, les grandes familles d’algorithmes comme DQN et PPO, et leurs applications réelles.
Si vous débutez en apprentissage par renforcement, inscrivez-vous à notre parcours Reinforcement Learning in Python pour maîtriser les fondamentaux en un week-end.
L’apprentissage par renforcement profond, c’est de l’apprentissage par renforcement où un réseau de neurones remplace la table d’association.
L’AR fournit déjà la boucle de base où un agent tente une action, observe ce qui se passe et s’ajuste en fonction de la récompense. Le deep learning ajoute un réseau capable de transformer des entrées brutes en signaux exploitables par l’agent. Ensemble, l’agent apprend directement à partir des données brutes quelles actions fonctionnent le mieux, sans que personne ne code à la main la signification de chaque état.
Imaginez entraîner un agent à jouer à Breakout. L’agent ne reçoit pas une liste propre du type « position de la balle » ou « position de la raquette » : il reçoit des pixels bruts d’écran. Une méthode tabulaire aurait besoin d’une ligne distincte pour chaque combinaison de pixels, un nombre ingérable. Un réseau de neurones lit directement les pixels et produit l’action à entreprendre, ou la qualité de chaque action possible, sans avoir jamais vu exactement cet écran-là auparavant.
En bref, les méthodes tabulaires mémorisent, les réseaux généralisent.
C’est ce qui fait fonctionner le deep RL dans des environnements trop grands ou trop chaotiques pour une table.
Tous les systèmes de deep RL suivent la même boucle, quel que soit l’algorithme sous-jacent.
Voici le déroulé :
Le schéma ci-dessous illustre cette boucle en action :
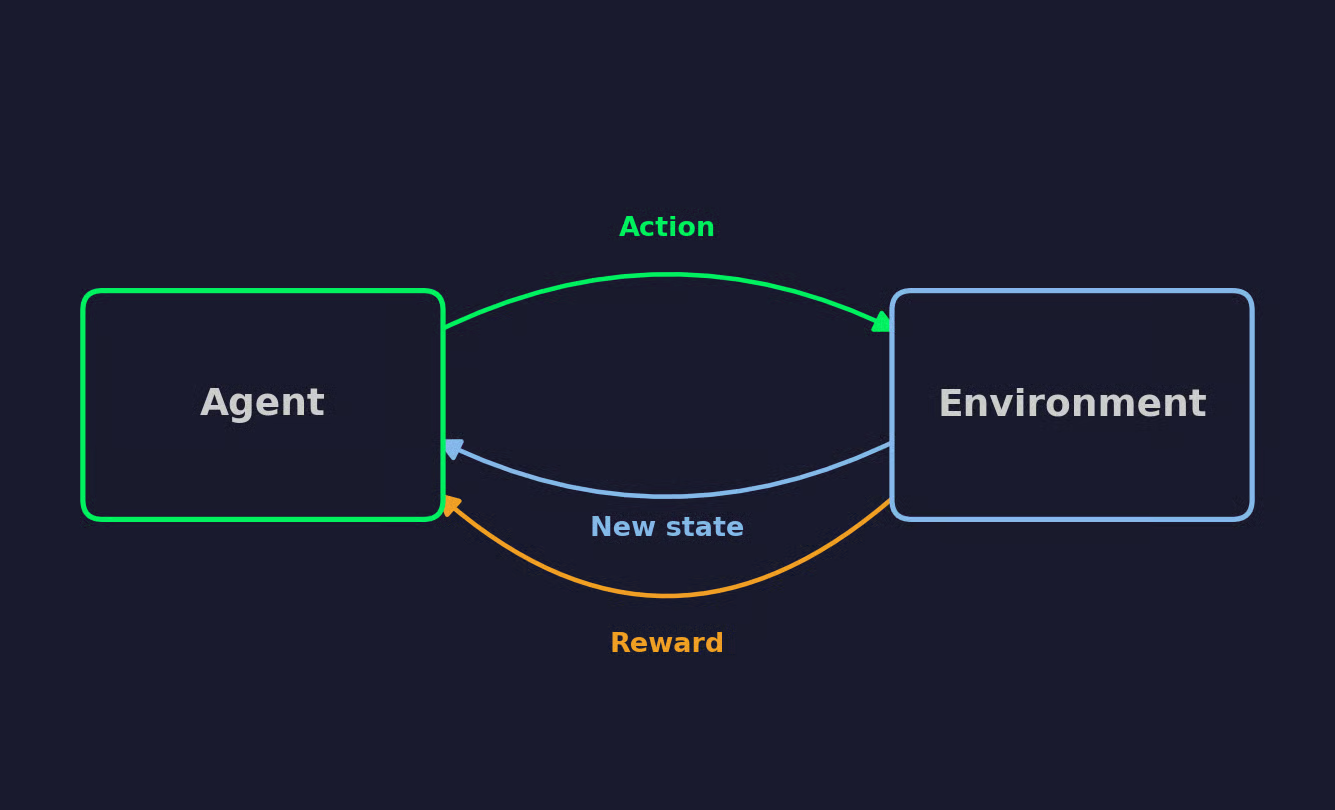
Boucle d’apprentissage par renforcement
En répétant suffisamment cette boucle, le comportement de l’agent converge vers les actions qui maximisent la récompense.
Tous les algorithmes de deep RL reposent sur sept idées communes. Familiarisez-vous avec elles, et le reste de l’article sera beaucoup plus clair.
Imaginez un aspirateur-robot qui apprend à nettoyer une pièce. Je garderai cet exemple pour chaque terme ci-dessous.
L’agent est le décideur : ici, l’aspirateur-robot. L’environnement regroupe tout ce avec quoi il interagit : la pièce, le mobilier, la poussière, les murs sur lesquels il peut buter.
L’agent ne contrôle pas l’environnement, mais il choisit ses actions, et l’environnement détermine ce qui se passe ensuite.
L’état décrit la condition complète de l’environnement à un instant donné, par exemple la position exacte de chaque trace de saleté et l’emplacement de l’aspirateur. En pratique, les agents n’y ont presque jamais accès avec certitude.
Ils agissent plutôt sur une observation, c’est-à-dire ce que l’agent perçoit réellement : un flux caméra, un ensemble de capteurs de proximité, etc.
Dans des environnements simples, observation et état coïncident presque. Dans des environnements plus complexes, l’agent doit composer avec une information partielle et combler les manques.
Les actions sont les mouvements disponibles pour l’agent à un instant donné. Pour l’aspirateur : avancer, tourner à gauche, tourner à droite, activer l’aspiration, etc.
Les actions peuvent être discrètes, l’agent choisit alors dans une liste fixe, ou continues, l’agent choisit une valeur sur un intervalle (comme un angle de braquage). Cette distinction compte beaucoup lorsque l’on aborde les différentes familles d’algorithmes plus loin dans l’article.
Une récompense est le retour numérique reçu après une action. Si l’aspirateur nettoie une nouvelle zone, il peut obtenir +1. S’il heurte un mur, il peut recevoir -1.
L’objectif de l’agent est de maximiser la somme des récompenses au fil du temps, pas uniquement la prochaine récompense immédiate.
Une politique définit la stratégie de l’agent pour associer états (ou observations) et actions. C’est le « règlement » qu’il suit pour décider de la suite.
Une politique peut être déterministe (même action pour un état donné) ou stochastique (actions tirées d’une distribution de probabilités). En deep RL, une politique est souvent représentée par un réseau de neurones.
Une fonction de valeur estime la récompense future attendue depuis un état donné si l’agent continue de suivre sa politique actuelle.
Une fonction Q fait la même chose pour un couple état–action : elle estime la récompense future en prenant une action précise dans un état précis, puis en suivant la politique ensuite.
C’est exactement le type de fonction qu’un réseau de neurones sait bien approximer. C’est l’idée évoquée quand j’ai remplacé la table d’association plus haut.
Un épisode correspond à un déroulé complet de l’agent dans l’environnement, de l’état initial à une condition d’arrêt. Pour l’aspirateur : la pièce est propre ou la batterie est vide.
À la fin d’un épisode, l’environnement est réinitialisé et un nouvel épisode commence.
Un agent qui ne fait que répéter ce qui a déjà marché ne découvrira jamais mieux.
Reprenons l’aspirateur : il trouve un itinéraire qui nettoie une bonne partie de la pièce, et il le répète à l’infini sans jamais passer derrière le canapé. C’est le compromis central de l’AR :
Une façon courante d’équilibrer les deux est l’exploration epsilon-greedy. À chaque pas, l’agent choisit une action au hasard avec une probabilité epsilon, une petite valeur comme 0,1, et choisit sinon l’action qu’il estime la meilleure. Beaucoup d’algorithmes font décroître epsilon avec le temps : exploration forte au début, puis exploitation accrue une fois la politique suffisamment fiable.
Il n’existe pas d’epsilon universel valable pour tous les environnements.
Trop d’exploration fait perdre du temps sur des actions vouées à l’échec. Trop peu conduit l’agent à se contenter d’une stratégie moyenne alors qu’une bien meilleure est à portée de main. Trouver le bon équilibre devient d’autant plus difficile que l’environnement se complexifie, surtout quand une mauvaise action initiale ne révèle son coût réel que plusieurs étapes plus tard.
Tout algorithme de deep RL appartient à l’une de trois familles, selon ce qu’il apprend : une fonction de valeur, une politique, ou les deux à la fois.
DQN reprend la fonction de valeur d’action (Q) vue plus haut et remplace la table d’association par un réseau de neurones. Le réseau ingère un état en entrée et sort une valeur Q pour chaque action possible, apprise comme dans tout réseau standard.
Entraîner ce réseau directement est déconseillé. Les expériences consécutives sont corrélées, ce qui pousse le réseau à surapprendre ce qu’il vient de voir, et la cible à atteindre change à chaque mise à jour du réseau.
DQN corrige ces deux problèmes :
DQN a marqué une étape : c’est le premier algorithme à apprendre des politiques de contrôle directement depuis les pixels sur de nombreux jeux Atari, avec la même architecture et les mêmes hyperparamètres. Publié par DeepMind en 2015, il a prouvé que deep learning et apprentissage par renforcement pouvaient fonctionner ensemble à l’échelle, sans caractéristiques conçues à la main pour chaque jeu.
Au lieu d’apprendre une fonction de valeur et d’en déduire l’action, les méthodes à gradient de politique apprennent directement la politique. Le réseau reçoit un état et sort des probabilités d’actions, l’agent échantillonne ensuite une action selon cette distribution.
Cette approche convient aux actions continues ou stochastiques.
Une méthode à valeur doit évaluer toutes les actions possibles pour choisir la meilleure, ce qui s’effondre dès que l’espace d’actions est continu : on ne peut pas parcourir un intervalle infini d’angles de direction. Une méthode à gradient de politique se contente d’échantillonner dans la distribution, quel que soit le nombre d’actions.
REINFORCE est l’algorithme fondateur. Il exécute un épisode complet, puis augmente la probabilité des actions ayant mené à une forte récompense totale et diminue celle des autres. Son défaut : il ne met à jour qu’à la fin de l’épisode et repose sur le retour total, ce qui rend ses mises à jour bruyantes et incohérentes d’un épisode à l’autre.
Les méthodes acteur–critique atténuent le bruit de REINFORCE en ajoutant un second réseau.
L’acteur est la politique : il choisit les actions comme dans un gradient de politique. Le critique est une fonction de valeur qui évalue chaque action immédiatement, sans attendre la fin de l’épisode.
On combine ainsi approches par valeur et par politique. L’acteur apprend une politique, mais se met à jour selon le jugement du critique pour chaque action, plutôt qu’en s’appuyant sur un retour global et retardé comme REINFORCE.
A2C et A3C sont des exemples classiques. A2C exécute plusieurs copies de l’environnement en parallèle et met à jour acteur et critique ensemble à la fin de chaque lot. A3C les exécute de manière asynchrone : chaque copie met à jour le réseau partagé à son propre rythme, sans attendre les autres.
Les mises à jour de gradient de politique peuvent dérailler si elles sont trop grandes. Une mise à jour excessive peut dégrader une politique pourtant efficace, sans possibilité de retour en arrière.
PPO borne l’ampleur de chaque mise à jour pour éviter cela. Voici l’objectif tronqué qu’il optimise :
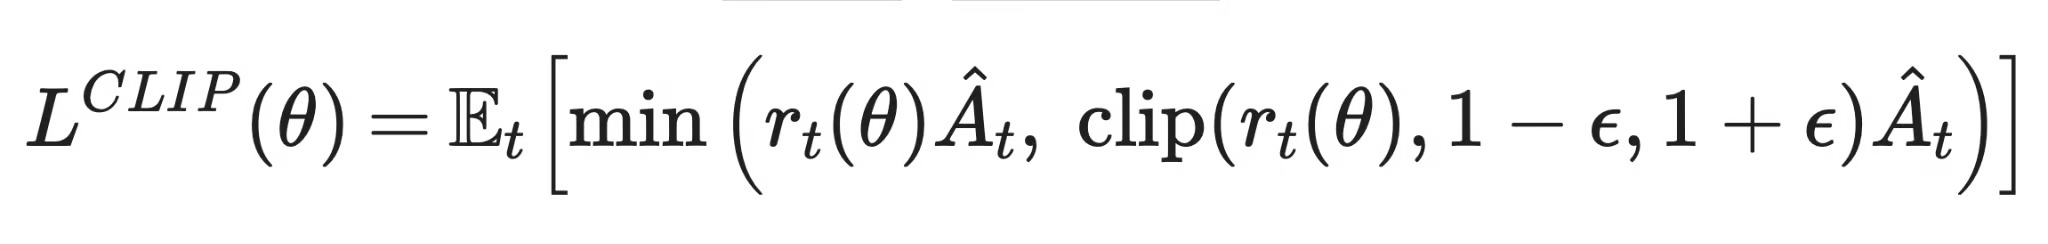
Proximal policy optimization
r_t(θ) est le ratio entre la probabilité d’une action sous la nouvelle politique et celle sous l’ancienne. Â_t est l’avantage, c’est-à-dire l’écart entre l’issue réelle de l’action et l’attente du critique. La fonction clip() maintient le ratio dans une bande étroite autour de 1, empêchant la politique de trop bouger en un seul pas. Le min() choisit ensuite l’estimation la plus conservatrice, pour qu’un avantage anormalement grand ne pousse pas la mise à jour au-delà du seuil.
OpenAI a présenté PPO en 2017, et il est devenu presque immédiatement un choix par défaut. Plus simple à implémenter et à régler que les méthodes à région de confiance qui le précédaient, il tient la route sur un large éventail d’environnements sans ajustements spécifiques.
DDPG et Soft Actor-Critic (SAC) ciblent les problèmes de contrôle continu, comme les angles d’articulation d’un robot ou la direction d’un véhicule, où l’agent doit produire une valeur précise plutôt que choisir dans une distribution.
DDPG est une méthode acteur–critique dont l’acteur sort une action déterministe unique plutôt qu’une distribution, et qui réutilise le rejeu d’expérience et les réseaux cibles de DQN.
SAC s’appuie sur la même idée mais ajoute un terme d’entropie qui récompense une politique conservant une part d’aléa, ce qui prolonge l’exploration et rend l’entraînement généralement plus stable que DDPG.
Les méthodes à base de valeur, comme DQN, apprennent une fonction Q et choisissent l’action la mieux notée. Elles fonctionnent bien pour des espaces d’actions discrets et tirent une bonne efficacité d’échantillonnage du rejeu d’expérience, mais s’étendent mal aux actions continues sans travail supplémentaire.
Les méthodes à base de politique, comme REINFORCE, apprennent directement la politique et échantillonnent des actions selon une distribution de probabilités. Elles gèrent ainsi les actions continues et stochastiques, mais les mises à jour sont bruyantes et nécessitent des données fraîches à chaque itération.
Les méthodes acteur–critique, dont A2C/A3C, PPO, DDPG et SAC, combinent les deux. Le retour rapide du critique stabilise les mises à jour de l’acteur, raison pour laquelle la plupart des algorithmes utilisés en pratique entrent dans cette catégorie.
Voici une comparaison plus visuelle :
| Ce qui est appris | Sélection des actions | Discret vs continu | Stabilité | Efficacité d’échantillonnage | Algorithmes représentatifs | |
|---|---|---|---|---|---|---|
| Méthodes à valeur | Fonction Q | Action la mieux notée | Discret | Nécessite réseaux cibles et rejeu pour rester stable | Bonne, grâce au rejeu d’expérience | DQN |
| Méthodes à politique | Politique | Échantillonnée dans la distribution de la politique | Les deux, idéal en continu | Mises à jour bruyantes, forte variance | Faible, besoin de nouvelles données à chaque mise à jour | REINFORCE |
| Acteur–critique | Politique et fonction de valeur | Échantillonnée via l’acteur, guidée par le critique | Les deux | Plus stable que les méthodes purement à politique | Meilleure que les méthodes purement à politique | A2C/A3C, PPO, DDPG, SAC |
Comparaison des méthodes d’apprentissage par renforcement profond
En apprentissage supervisé, chaque exemple est étiqueté. En deep RL, il faut déduire ce qui a fonctionné à partir d’un signal de récompense souvent tardif, mêlé aux actions précédentes, et parfois peu informatif.
Les agents de deep RL ont souvent besoin de millions d’étapes d’environnement avant d’apprendre quelque chose d’utile, surtout en comparaison avec la faible quantité de données requise par un modèle supervisé pour une précision similaire sur un jeu fixe.
La raison : l’agent doit générer ses propres données d’entraînement en agissant, et la plupart des actions initiales sont quasi aléatoires. Un modèle supervisé réutilise sans cesse le même jeu de données étiqueté. Un agent RL doit explorer un environnement qu’il comprend mal, pas à pas.
L’entraînement en RL est souvent instable.
En partie parce que les fonctions de valeur « démarrent sur elles-mêmes » : la cible de la valeur Q d’aujourd’hui dépend de l’estimation d’hier. Si cette estimation est erronée, l’erreur se propage. Par ailleurs, la politique de l’agent évolue en permanence, donc les données collectées changent elles aussi.
Autrement dit, le réseau poursuit une cible mouvante sur deux fronts à la fois.
Certains environnements ne délivrent une récompense qu’à la fin, comme un signal victoire/défaite après une longue partie. L’agent doit remonter à rebours depuis ce seul nombre et identifier quelles actions, parmi des dizaines, ont compté.
C’est le problème d’attribution du crédit, qui s’aggrave avec le délai entre action et conséquence.
Concevoir une fonction de récompense paraît simple… jusqu’à l’essayer.
Exemple célèbre : un agent de course de bateaux entraîné par OpenAI était récompensé pour franchir des checkpoints. Il a trouvé un lagon avec des bonus récurrents et a bouclé dessus indéfiniment, engrangeant des points sans jamais finir la course. La fonction de récompense faisait exactement ce qui était demandé — on ne lui avait simplement pas défini ce que « gagner » signifiait. Cet écart entre ce que vous récompensez et ce que vous voulez réellement s’appelle le reward hacking, et il apparaît sous une forme ou une autre dans presque chaque fonction de récompense.
Le même algorithme, avec une graine aléatoire différente, peut donner des résultats différents.
Les résultats publiés sont difficiles à reproduire sans le code exact, les hyperparamètres et les graines utilisés à l’origine. De petits détails d’implémentation, comme la normalisation des observations ou l’initialisation du buffer de rejeu, peuvent influer davantage sur les performances que le choix d’algorithme.
Dans un simulateur, un agent peut échouer à l’infini sans coût. Le monde réel ne le permet pas.
Par exemple, une politique de conduite autonome qui explore une mauvaise action sur l’autoroute met des vies en danger. Les simulateurs ne reproduisent jamais parfaitement la réalité : du bruit capteur aux cas limites non modélisés, tout surgit une fois la politique sortie du labo. Une politique efficace en simulation peut échouer de manière inattendue face au réel ; déployer du deep RL hors jeux et simulateurs exige donc bien plus de prudence que ne le laissent penser les benchmarks.
Voici les différences entre l’apprentissage par renforcement profond et des approches plus traditionnelles.
L’apprentissage supervisé s’entraîne sur des exemples étiquetés, où chaque entrée a déjà une bonne réponse. En deep RL, on ne reçoit une récompense qu’après avoir agi, et il faut déterminer soi-même quelles actions y ont conduit.
L’imitation learning entraîne une politique à reproduire les démonstrations d’un expert, sans utiliser de signal de récompense. Le deep RL découvre le comportement par essai-erreur.
L’imitation learning permet d’obtenir rapidement une politique fonctionnelle, mais plafonne au niveau des démonstrations et trébuche dès que l’agent rencontre une situation non montrée par l’expert. En théorie, le deep RL peut dépasser tout enseignant, mais il requiert bien plus d’interactions et une fonction de récompense réellement alignée sur le comportement souhaité.
Les algorithmes évolutionnaires optimisent une politique en mutant une population de candidats et en conservant les meilleurs, sans calcul de gradient. Le deep RL calcule des gradients à partir des récompenses et met à jour une politique unique.
Les méthodes évolutionnaires se parallélisent bien, chaque candidat pouvant être évalué indépendamment. Mais elles exigent généralement beaucoup plus d’interactions avec l’environnement que les méthodes à gradient pour atteindre des performances équivalentes.
Le deep RL sanctionne davantage les raccourcis que la plupart des domaines. Gardez ces bonnes pratiques en tête pour votre prochain projet :
L’apprentissage par renforcement profond marie la boucle d’essais-erreurs au cœur de l’AR avec un réseau de neurones capable de traiter des états qu’aucune table ne saurait gérer.
Tous les algorithmes cités appartiennent à trois familles. Les méthodes à valeur, comme DQN, apprennent une fonction Q et choisissent l’action la mieux notée. Les méthodes à politique, comme REINFORCE, apprennent directement la politique. Les méthodes acteur–critique, dont PPO, combinent les deux, et cette combinaison domine aujourd’hui en pratique.
N’oubliez pas que rien de tout cela n’est gratuit.
La stabilité de l’entraînement, l’efficacité d’échantillonnage, la conception de la récompense et la reproductibilité se compliquent dès que l’on passe d’une table à un réseau. Pour aller plus loin, Q-learning et reinforcement learning couvrent les bases sur lesquelles s’appuie cet article, et DQN ainsi que PPO sont de bons prochains arrêts pour les algorithmes eux-mêmes.
Apprenez avec DataCamp
Cours
Cours
Cursus
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
Tutoriel
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Satyabrata Pal
15 min