Course
Понимание искусственного интеллекта
2 ч
421.1K
Классическое обучение с подкреплением плохо работает, когда среда становится слишком большой, чтобы отслеживать её вручную. Причина в том, что для каждого состояния нужна своя запись в таблице, а для каждого действия из каждого состояния — своё значение.
Например, экран игры даёт миллионы комбинаций пикселей, и их невозможно уместить в таблицу для перебора. Агенту нужно уметь оценивать ценность никогда ранее не встречавшегося состояния по аналогии с похожими.
Глубокое обучение с подкреплением решает проблему, заменяя таблицу нейронной сетью, которая оценивает ценность состояния или подсказывает лучшее действие — даже в ситуациях, с которыми агент напрямую не сталкивался. Именно это позволяет агентам овладевать игрой го и управлять симулируемыми дронами — задачами, от которых классические алгоритмы RL «лопаются».
В этой статье мы разберём ключевые концепции глубокого RL, основные семейства алгоритмов — такие как DQN и PPO — и их применение в реальном мире.
Если вы новичок в обучении с подкреплением, запишитесь на наш трек Reinforcement Learning in Python, чтобы за выходные подтянуть базу.
Глубокое обучение с подкреплением — это обучение с подкреплением, где вместо таблицы используется нейронная сеть.
Обучение с подкреплением даёт базовый цикл: агент пробует действие, наблюдает результат и корректируется по вознаграждению. Глубокое обучение добавляет сеть, которая превращает сырые входные данные в пригодное для действий представление. В итоге агент учится выбирать лучшие действия прямо из «сырого» ввода — без ручного кодирования смысла каждого состояния.
Представьте, что вы обучаете агента играть в Breakout. Агент не получает аккуратный список вроде «позиция мяча» или «позиция платформы» — ему приходят сырые пиксели экрана. Табличному методу понадобилась бы отдельная строка для каждой возможной комбинации пикселей — число неподъёмное. Нейронная сеть смотрит на пиксели напрямую и выдаёт, какое действие выбрать, или насколько хорошим выглядит каждое действие, даже если такого экрана ещё не было.
Если коротко: табличные методы запоминают, сети — обобщают.
Вот почему глубокий RL работает там, где таблица бессильна — в слишком больших или «шумных» средах.
Любая система глубокого RL крутит один и тот же цикл, независимо от выбранного алгоритма.
Схема такая:
На схеме ниже показан этот цикл в действии:
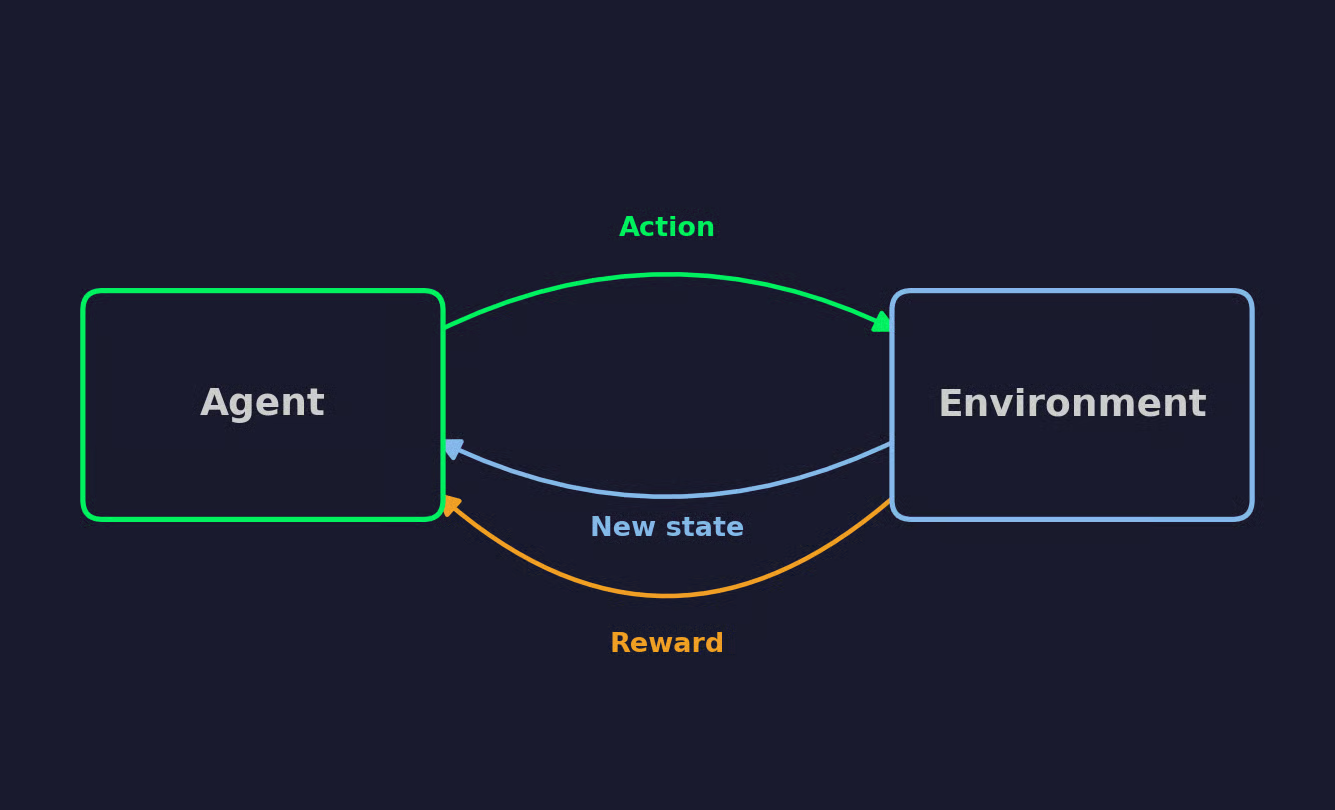
Цикл обучения с подкреплением
Если повторять цикл достаточно долго, поведение агента сместится к действиям, максимизирующим вознаграждение.
Любой алгоритм глубокого RL строится на семи общих идеях. Освойте их — и остальная часть статьи станет гораздо понятнее.
Представьте робот‑пылесос, который учится убирать комнату. Этот пример будет сопровождать все термины ниже.
Агент — это принимающий решения объект, в нашем примере — робот‑пылесос. Среда — всё, с чем он взаимодействует: комната, мебель, мусор, стены, в которые он может врезаться.
Агент не управляет средой, но выбирает действия, а среда определяет, что произойдёт дальше.
Состояние описывает полное положение дел в среде в данный момент — например, точные координаты каждого мусорного пятна и расположение пылесоса. В реальности агенты редко знают это наверняка.
Вместо этого они действуют по наблюдению — тому, что реально видят: поток с камеры или набор датчиков ближности.
В простых средах наблюдение и состояние почти совпадают. В более сложных агент работает с неполной информацией и вынужден достраивать недостающее.
Действия — это доступные агенту ходы в данный момент. Для пылесоса это может быть движение вперёд, поворот налево, направо или включение всасывания.
Действия бывают дискретными — агент выбирает из фиксированного списка — и непрерывными, когда выбирается значение из диапазона, например угол поворота. Это различие становится критичным при выборе семейств алгоритмов далее по тексту.
Вознаграждение — это числовая обратная связь после действия. Если пылесос очистил новый участок пола, он может получить +1. Если врезался в стену — −1.
Цель агента — максимизировать суммарное вознаграждение со временем, а не только следующее по очереди.
Политика — это стратегия сопоставления состояний (или наблюдений) с действиями. Это набор правил, по которым агент решает, что делать дальше.
Политика может быть детерминированной — всегда одно действие для данного состояния — или стохастической, когда действия выбираются по распределению вероятностей. В глубоких RL алгоритмах политику часто представляет нейронная сеть.
Функция ценности оценивает ожидаемое будущие суммарное вознаграждение из данного состояния при следовании текущей политике.
Функция Q-ценности делает то же для пары «состояние–действие»: оценивает будущую награду за конкретное действие в конкретном состоянии с последующим следованием политике.
Именно такие функции хорошо аппроксимируются нейронными сетями — тот же принцип, что и при замене таблицы выше в статье.
Эпизод — это один полный прогон агента по среде от начального состояния до условия завершения. Для пылесоса это может быть полностью убранная комната или разряженная батарея.
После завершения эпизода среда сбрасывается, и начинается новый.
Агент, который лишь повторяет сработавшее однажды, никогда не найдёт лучшее решение.
Снова представьте пылесос. Он набрёл на маршрут, который убирает приличную часть комнаты, и запускает его каждый раз. Угол за диваном он так и не проверил. Это и есть центральный компромисс обучения с подкреплением:
Один из распространённых способов балансировки — исследование epsilon-greedy. На каждом шаге агент с вероятностью эпсилон (например, 0.1) выбирает случайное действие, а иначе — то, которое сейчас считает лучшим. Во многих алгоритмах эпсилон со временем убывает: сначала агент много исследует, а затем, набравшись опыта, всё больше полагается на использование.
Не существует фиксированного эпсилон, подходящего для любой среды.
Чрезмерное исследование тратит время на заведомо провальные действия. Недостаточное — приводит к удовлетворению «любопытной» стратегией, когда рядом скрывается лучшая. Чем сложнее среда, тем труднее баланс, особенно если плохое раннее действие проявляет истинную цену лишь спустя многие шаги.
Каждый алгоритм глубокого RL относится к одному из трёх семейств — в зависимости от того, что он изучает: функцию ценности, политику или обе сразу.
DQN берёт функцию Q-ценности из начала статьи и заменяет таблицу нейронной сетью. Сеть принимает состояние и выдаёт Q-значение для каждого возможного действия — обучаясь так же, как любая нейросеть.
Учить такую сеть напрямую не рекомендуется. Последовательные переживания коррелированы — сеть переобучается на том, что только что видела, — а целевая величина меняется при каждом обновлении сети.
DQN решает обе проблемы:
Значимость DQN в том, что это был первый алгоритм, научившийся управлять напрямую по сырым пикселям во множестве игр Atari, используя одну архитектуру и гиперпараметры для всех. Публикация DeepMind в 2015 году доказала, что глубокое обучение и RL реально масштабируются вместе — без ручных признаков под каждую игру.
Вместо обучения функции ценности и выбора действия на её основе методы градиента политики учат саму политику. Сеть принимает состояние и выдаёт вероятности действий, а агент семплирует действие из этого распределения.
Такой подход подходит для непрерывных или стохастических действий.
Методу на основе ценности нужно перебрать все действия, чтобы выбрать лучшее, что ломается, как только пространство действий становится непрерывным — бесконечный диапазон углов не перебрать. Градиент политики просто семплирует из распределения — независимо от числа действий.
Базовый алгоритм здесь — REINFORCE. Он прогоняет полный эпизод, затем повышает вероятность действий, давших высокий суммарный возврат, и понижает для давших низкий. Минус в том, что обновления лишь после конца эпизода и зависят от полного возврата — они шумные и непоследовательные от эпизода к эпизоду.
Методы «актор–критик» снижают шум REINFORCE, добавляя вторую сеть.
Актор — это политика: он выбирает действия так же, как в градиенте политики. Критик — функция ценности, которая оценивает действие сразу после него, не ожидая окончания эпизода.
Это совместная работа подходов на основе ценности и политики. Актор по-прежнему учит политику, но обновляется по оценке критика каждого действия, а не по задержанному шумному возврату, на который опирается REINFORCE.
Стандартные примеры — A2C и A3C. A2C запускает несколько копий среды параллельно и обновляет актора и критика вместе по завершении каждого батча. A3C запускает их асинхронно: каждая копия обновляет общую сеть по своему расписанию, не дожидаясь остальных.
Обновления градиента политики могут «перекрутиться», если позволить им быть слишком большими. Достаточно крупное обновление способно испортить вполне рабочую политику, и откатить это уже нельзя.
PPO ограничивает размер каждого обновления. Вот оптимизируемая им усечённая цель:
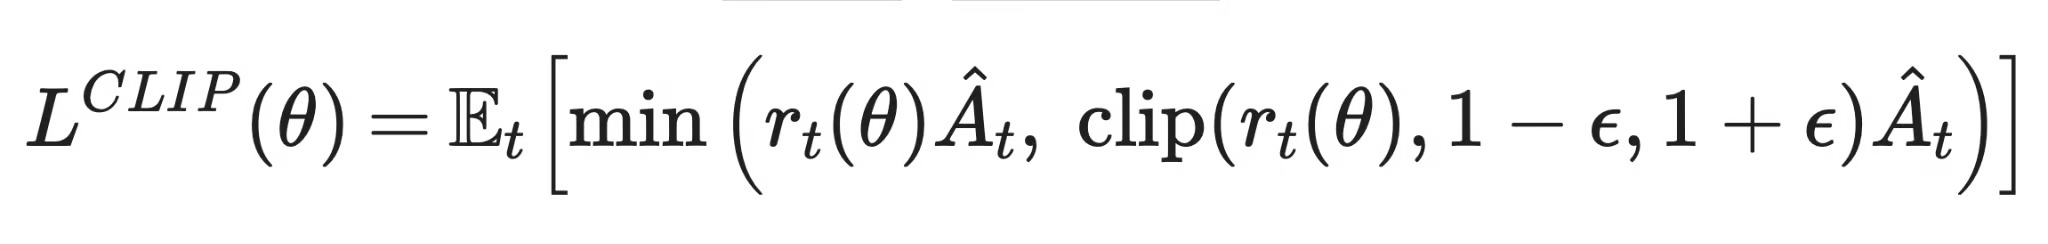
Proximal policy optimization
r_t(θ) — отношение вероятности действия по новой политике к вероятности того же действия по старой политике. Â_t — преимущество (advantage), то есть насколько действие оказалось лучше базовой оценки критика. Функция clip() сдерживает отношение в узкой окрестности 1, чтобы политика не смещалась слишком далеко за один шаг. Затем min() выбирает более консервативную из двух оценок, чтобы необычно большое преимущество не протолкнуло обновление дальше, чем разрешает усечение.
OpenAI представила PPO в 2017 году, и метод почти сразу стал выбором по умолчанию. Он проще в реализации и настройке, чем предшествующие trust-region методы, и стабильно работает в самых разных средах без тонкой подгонки под задачу.
DDPG и Soft Actor-Critic (SAC) нацелены на задачи непрерывного управления — углы роботизированных суставов, значения руления — где агент должен выдавать конкретное число, а не выбирать из распределения.
DDPG — метод «актор–критик», у которого актор выдаёт одно детерминированное действие вместо распределения, и он заимствует повторное проигрывание опыта и целевые сети из DQN.
SAC развивает эту идею, добавляя член энтропии, поощряющий политику за сохранение некоторой случайности — это продлевает исследование и обычно делает обучение стабильнее, чем в DDPG.
Методы на основе ценности, такие как DQN, учат функцию Q-ценности и выбирают действие с наивысшей оценкой. Они хорошо работают в дискретных пространствах действий и эффективно используют повторное проигрывание опыта, но без дополнительных ухищрений не переносятся на непрерывные действия.
Методы на основе политики, как REINFORCE, учат политику напрямую и семплируют действия из распределения. Благодаря этому они подходят для непрерывных и стохастических действий, но «чистые» обновления градиента политики шумные и требуют новых данных на каждое обновление.
Методы «актор–критик» — A2C/A3C, PPO, DDPG, SAC — объединяют оба подхода. Быстрая обратная связь критика стабилизирует обновления актора, поэтому на практике сегодня чаще всего используют именно их.
Вот более наглядное сравнение:
| Что изучается | Как выбираются действия | Дискретные или непрерывные | Стабильность | Эффективность по выборкам | Представительные алгоритмы | |
|---|---|---|---|---|---|---|
| На основе ценности | Функция Q-ценности | Действие с наивысшей оценкой | Дискретные | Нужны целевые сети и повторное проигрывание для стабильности | Хорошая, благодаря replay | DQN |
| На основе политики | Политика | Семплирование из распределения политики | Оба типа, лучше с непрерывными | Шумные, высокодисперсные обновления | Слабая, нужны новые данные на каждое обновление | REINFORCE |
| Актор–критик | Политика и функция ценности | Семплирование у актора с поправкой критика | Оба | Стабильнее «чистых» методов на основе политики | Лучше, чем у «чистых» методов на основе политики | A2C/A3C, PPO, DDPG, SAC |
Сравнение методов глубокого RL
В обучении с учителем у каждого примера есть метка-ответ. В глубоком RL нужно понять, что сработало, по сигналу вознаграждения, который приходит поздно, смешивается с предыдущими действиями и порой вообще толком не проявляется.
Агентам глубокого RL часто требуются миллионы шагов в среде, чтобы выучить что-то полезное — особенно в сравнении с тем, как мало данных нужно модели с учителем для сопоставимой точности на фиксированном наборе.
Причина в том, что агент сам генерирует обучающие данные своими действиями, и на ранних этапах это почти случайность. Модель с учителем многократно переиспользует один и тот же размеченный датасет. Агент RL вынужден всё время исследовать едва понятную ему среду — шаг за шагом.
Обучение в RL часто нестабильно.
Частично проблема в бутстрепинге функций ценности — сегодняшняя цель для Q-значений опирается на вчерашнюю их оценку. Если она ошибочна, ошибка накапливается, а не исправляется. Плюс политика агента меняется по мере обучения — следовательно, меняются и собираемые данные.
Иными словами, сеть гонится за движущейся целью сразу по двум фронтам.
В некоторых средах вознаграждение выдаётся только в самом конце — например, сигнал победы/поражения после длинной игры. Агенту нужно «распутать» этот единичный показатель и понять, какие из десятков действий действительно имели значение.
Это проблема кредитного распределения (credit assignment), и она усугубляется с ростом задержки между действием и его последствиями.
Проектирование функции вознаграждения кажется простым — пока не попробуете.
Вот известный пример. Агент гонок на лодках от OpenAI поощрялся за прохождение чекпоинтов, поэтому он нашёл лагуну с возрождающимися бонусами и бесконечно наматывал круги, набивая очки, но так и не финишируя. Функция вознаграждения делала ровно то, что ей задали — просто агенту не объяснили, что такое «победа». Несоответствие между тем, что вы поощряете, и тем, чего на самом деле хотите, называется взломом вознаграждения (reward hacking), и в какой-то форме оно проявляется почти в каждой функции вознаграждения.
Один и тот же алгоритм с другим случайным зерном может дать разные результаты.
Публикуемые результаты трудно воспроизвести без точного кода, гиперпараметров и зерен случайности оригинальных исследователей. Нюансы реализации — как нормируются наблюдения или инициализируется буфер replay — порой влияют на качество сильнее, чем выбор алгоритма.
В симуляторе агент может терпеть неудачу сколько угодно раз. В реальном мире это не так.
Например, исследование неверного действия автопилотом на трассе ставит людей под угрозу. Симуляторы никогда не отражают реальность полностью: как только политика выходит из лаборатории, всплывают «краевые случаи», не учтённые симулятором. То, что отлично работает в симуляции, может подвести неожиданно в реальной среде — поэтому внедрение глубокого RL за пределами игр и симуляторов требует куда больше осторожности, чем намекают бенчмарки.
Далее — различия между глубоким RL и более традиционными подходами.
Обучение с учителем тренируется на размеченных примерах, где у каждого входа есть правильный ответ. Глубокий RL такого не получает — лишь вознаграждение после действия — и сам должен разобраться, какие действия к нему привели.
Имитационное обучение тренирует политику копировать демонстрации эксперта — без использования сигнала вознаграждения. Глубокий RL открывает поведение методом проб и ошибок.
Имитационное обучение быстро запускает политику, но упирается в качество демонстраций и «теряется», как только агент попадает в ситуацию, не показанную экспертом. Теоретически глубокий RL может превзойти любого учителя, но ему нужны гораздо более длительные взаимодействия и функция вознаграждения, действительно направляющая к нужному поведению.
Эволюционные алгоритмы оптимизируют политику, мутируя популяцию кандидатов и сохраняя лучших — без вычисления градиентов. Глубокий RL вычисляет градиенты по сигналу вознаграждения и обновляет одну политику.
Эволюционные методы хорошо параллелятся, так как каждый кандидат можно запускать независимо. Но обычно им требуется значительно больше взаимодействий со средой, чем градиентному глубокому RL, чтобы достичь того же уровня.
Глубокий RL наказывает за упрощения сильнее многих других областей. Учитывая это, вот несколько рекомендаций для следующего проекта:
Глубокий RL объединяет цикл проб и ошибок из RL с нейросетью, способной работать с состояниями, неподвластными таблицам.
Все алгоритмы в статье попадают в одно из трёх семейств. Методы на основе ценности, как DQN, учат Q-функцию и выбирают действие с наивысшей оценкой. Методы на основе политики, как REINFORCE, учат политику напрямую. «Актор–критик», включая PPO, совмещают оба подхода — и именно этим сегодня чаще всего и пользуются.
Но важно помнить: ничего из этого не даётся даром.
Стабильность обучения, эффективность по выборкам, проектирование вознаграждения и воспроизводимость усложняются, как только вы переходите от таблицы к сети. Если хотите копнуть глубже, материалы по Q-learning и reinforcement learning покрывают фундамент, на котором стоит эта статья, а DQN и PPO — хороши как следующий шаг по алгоритмам.
Учитесь с DataCamp
Course
Course
Track