
Kurs
Yapay Zekayı Anlamak
2 sa
421.1K
Geleneksel pekiştirmeli öğrenme, ortam el yordamıyla takip edilemeyecek kadar büyüdüğünde pek işe yaramaz. Nedeni, her durumun tabloda kendi girişine ihtiyaç duyması ve her durumdan her eylemin kendi değerine sahip olmasıdır.
Örneğin bir oyun ekranı milyonlarca piksel kombinasyonu üretir; bunlar, içinde döngü kurabileceğiniz bir tabloya sığmaz. Aracı, daha önce hiç görmediği bir durumun değerini, benzer görünen durumlardan yola çıkarak tahmin etmelidir.
Derin pekiştirmeli öğrenme, tabloyu bir sinir ağıyla değiştirerek bunu çözer; ağ, bir durumun değerini ya da atılacak en iyi eylemi, doğrudan hiç karşılaşmadığı durumlarda bile tahmin eder. Go oyununda ustalaşmayı ve simülasyonda drone uçurmayı mümkün kılan da budur; her ikisi de klasik RL algoritmalarını patlatacak türden görevlerdir.
Bu yazıda, derin RL'in temel kavramlarını, DQN ve PPO gibi başlıca algoritma ailelerini ve bunların gerçek dünyadaki kullanım alanlarını adım adım anlatacağım.
Pekiştirmeli öğrenmeye yeniyseniz, bir hafta sonunda Python ile Pekiştirmeli Öğrenme eğitim dizimize katılarak temelleri oturtabilirsiniz.
Derin pekiştirmeli öğrenme, arama tablosunun yerine sinir ağının geçtiği pekiştirmeli öğrenmedir.
Pekiştirmeli öğrenme, bir aracının eylem denediği, ne olduğunu izlediği ve ödüle göre ayarladığı temel döngüyü zaten sağlar. Derin öğrenme ise ham girdiyi, aracının üzerinde eylem alabileceği bir şeye dönüştürebilen bir ağı ekler. Birlikte kullanıldığında, aracı herhangi birinin her bir durumu tanımlamak için elle kod yazmasına gerek kalmadan, doğrudan ham veriden hangi eylemlerin en iyi sonuç verdiğini öğrenir.
Breakout gibi bir oyunu oynaması için bir aracı eğittiğinizi düşünün. Aracıya "topun konumu" ya da "paletin konumu" gibi temiz bir liste gelmez - ekrandan ham pikseller gelir. Tablo tabanlı bir yöntem, mümkün olan her piksel kombinasyonu için ayrı bir satır gerektirir ve bu sayı yönetilemez. Bir sinir ağı piksellere doğrudan bakar ve daha önce tam olarak o ekranı hiç görmemiş olsa bile hangi eylemin yapılacağını ya da her eylemin ne kadar iyi göründüğünü çıktılar.
Kısacası, tablo yöntemleri ezberler, ağlar geneller.
Derin RL'i, bir tablonun baş edemeyeceği kadar büyük veya dağınık ortamlarda işe yarar kılan da budur.
Hangi algoritma kullanılırsa kullanılsın, her derin RL sistemi aynı döngüyü çalıştırır.
İşleyiş şöyle:
Aşağıdaki diyagram bu döngünün işleyişini gösteriyor:
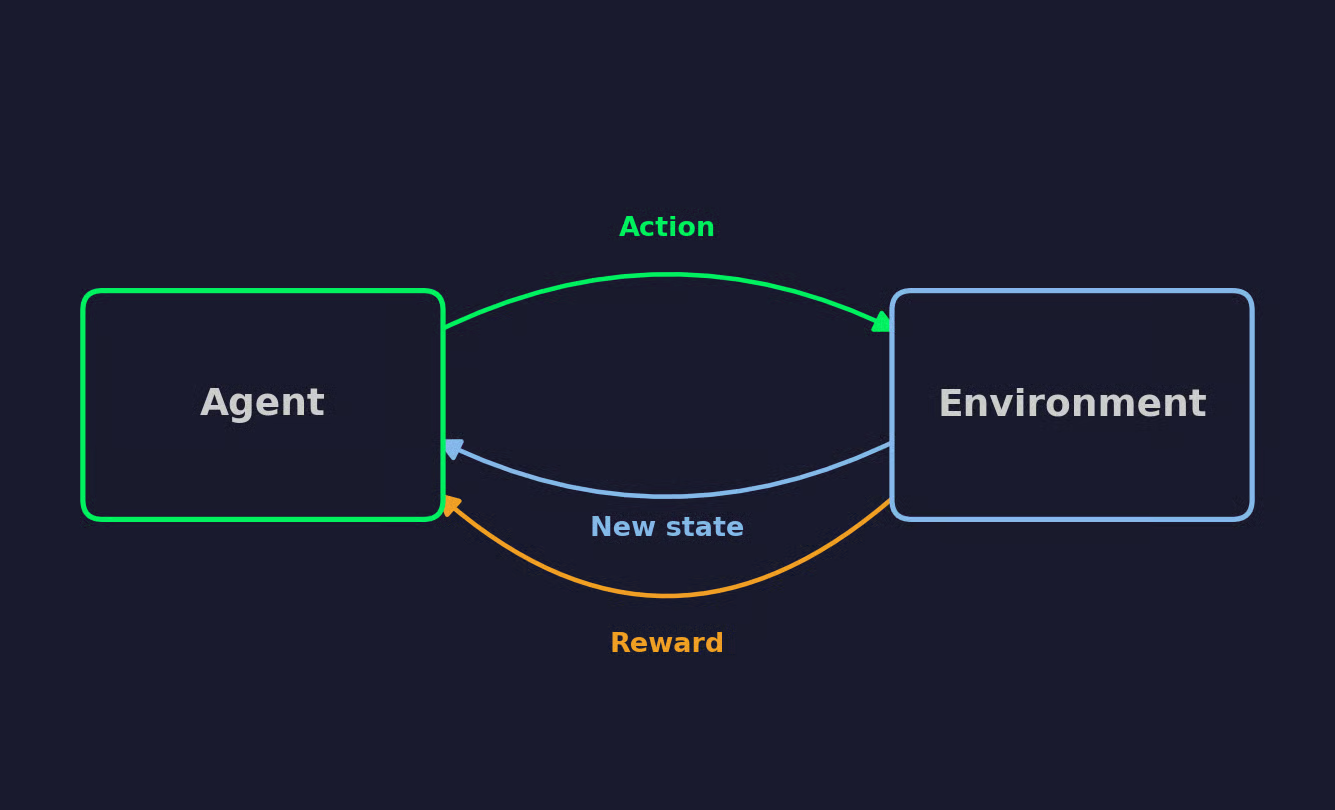
Pekiştirmeli öğrenme döngüsü
Bu döngüyü yeterince tekrarlarsanız, aracının davranışı ödülü en çok artıran eylemlere doğru kayar.
Her derin RL algoritması aynı yedi fikir üzerine kurulur. Bunlara aşina olursanız, yazının geri kalanı çok daha anlamlı gelecektir.
Bir robot süpürgenin bir odayı temizlemeyi öğrenmesini hayal edin. Aşağıdaki her terimde bu örneği kullanacağım.
Aracı karar vericidir - örneğimizde robot süpürge. Ortam ise onun etkileşimde bulunduğu her şeydir; oda, mobilyalar, kir, çarpabileceği duvarlar gibi.
Aracı ortamı kontrol etmez, ancak eylemleri seçer ve sonrasında ne olacağına ortam karar verir.
Durum, belirli bir anda ortamın tam koşulunu tanımlar; örneğin her bir kir parçasının tam konumu ve süpürgenin yeri. Gerçek aracılar buna nadiren kesin olarak erişir.
Bunun yerine, aracı elinde olanla hareket eder; kamera akışı ya da bir dizi yakınlık sensörü gibi gözlemle.
Basit ortamlarda gözlem ile durum temelde aynı şeydir. Daha karmaşık olanlarda ise aracı eksik bilgilerle çalışır ve boşlukları doldurmak zorundadır.
Eylemler, aracının herhangi bir anda kullanabileceği hamlelerdir. Süpürge için bu; ileri gitmek, sola dönmek, sağa dönmek ya da emişi açmak olabilir.
Eylemler ayrık olabilir; bu durumda aracı sabit bir listeden seçer. Ya da sürekli olabilir; bu durumda aracı direksiyon açısı gibi bir aralık üzerinde değer seçer. Bu ayrım, yazının ilerleyen kısımlarında farklı algoritma ailelerine geldiğinizde çok önemlidir.
Ödül, aracı bir eylemden sonra aldığı sayısal geri bildirimdir. Süpürge yeni bir alanı temizlerse +1 ödül alabilir. Duvara çarptığında ise -1 alabilir.
Aracının tüm amacı, yalnızca bir sonraki tek eylemin ödülünü değil, zaman içinde topladığı toplam ödülü en üst düzeye çıkarmaktır.
Politika, durumları ya da gözlemleri eylemlere eşleyen aracının stratejisidir. Aracının sırada ne yapacağına karar verirken izlediği kural kitabıdır.
Bir politika belirleyici olabilir; belirli bir durum için her zaman aynı eylemi seçer. Ya da stokastik olabilir; eylemleri bir olasılık dağılımına göre seçer. Derin RL algoritmaları bu politikayı temsil etmek için sıklıkla bir sinir ağı kullanır.
Bir değer fonksiyonu, aracı mevcut politikasını izlemeye devam ederse, belirli bir durumdan ne kadar gelecekteki ödül bekleyebileceğini tahmin eder.
Bir Q-değer fonksiyonu ise aynı şeyi bir durum-eylem çifti için yapar. Belirli bir durumda belirli bir eylemi alıp, sonrasında politikayı izlediğinde elde edeceği gelecekteki ödülü tahmin eder.
Bir sinir ağının yaklaşık olarak iyi yaptığı fonksiyon türü budur. Yazının başlarında arama tablosunu değiştirirken değindiğim fikrin aynısıdır.
Bir bölüm, aracının ortamda başlangıç durumundan bir bitiş koşuluna kadar tam bir çalıştırmasıdır. Süpürge için bu, odanın tamamen temizlenmesi ya da pilin bitmesi olabilir.
Bölüm bittiğinde ortam sıfırlanır ve yeni bir bölüm başlar.
Yalnızca işe yarayanı tekrar eden bir aracı asla daha iyisini bulamaz.
Süpürgeyi yine düşünün. Odanın hatırı sayılır bir bölümünü temizleyen bir rota buluyor ve her seferinde aynı rotayı çalıştırıyor. Kanepenin arkasındaki köşeye hiç bakmıyor. Pekiştirmeli öğrenmenin merkezindeki denge budur:
Yaygın bir dengeleme yöntemi epsilon-greedy keşiftir. Her adımda, aracı epsilon olasılıkla (0.1 gibi küçük bir sayı) rastgele bir eylem seçer; aksi halde şu anda en iyi olduğuna inandığı eylemi seçer. Birçok algoritma zamanla epsilona azalma uygular; başlangıçta yoğun keşif yapılır, aracı yeterince öğrendikten sonra ise kendi yargısına daha çok güvendiği sömürüye daha çok yaslanır.
Her ortam için işe yarayan sabit bir epsilon yoktur.
Aşırı keşif, sürekli başarısız olan eylemlerle vakit kaybettirir. Yetersiz keşif ise aracıyı yanındaki daha iyi strateji keşfedilmemişken idare eder bir stratejiye razı eder. Bu dengeyi tutturmak, ortam karmaşıklaştıkça daha da zorlaşır; özellikle de kötü bir erken eylemin gerçek maliyeti birçok adım sonra ortaya çıktığında.
Her derin RL algoritması, ne öğrendiğine göre üç aileden birine girer: bir değer fonksiyonu, bir politika ya da her ikisi birden.
DQN, bu yazının önceki kısımlarındaki Q-değer fonksiyonunu alır ve arama tablosunun yerine bir sinir ağı koyar. Ağ, girdi olarak bir durumu alır ve olası her eylem için bir Q-değeri üretir; tıpkı standart bir sinir ağının başka bir şeyi öğrendiği şekilde öğrenilir.
Bu ağı doğrudan eğitmek önerilmez. Art arda gelen deneyimler korelasyonludur; ağ, az önce gördüğüne aşırı uyum sağlar ve peşinden koştuğu hedef, ağ her güncellendiğinde değişir.
DQN her iki sorunu da şöyle çözer:
DQN önemlidir çünkü farklı Atari oyunlarında, her biri için aynı mimari ve hiperparametrelerle, doğrudan ham piksellerden kontrol politikaları öğrenen ilk algoritmaydı. DeepMind bunu 2015'te yayımladığında, derin öğrenme ile pekiştirmeli öğrenmenin, her oyun için elle özellik inşa etmeye gerek kalmadan, ölçekli bir şekilde birlikte çalışabileceğini kanıtladı.
Bir değer fonksiyonu öğrenip ona göre eylem seçmek yerine, politika gradyanı yöntemleri politikayı öğrenir. Ağ, bir durumu alır ve eylem olasılıklarını çıktılar; aracı o dağılımdan bir eylem örnekler.
Bu yaklaşım, sürekli ya da stokastik eylemlere uygundur.
Değer tabanlı bir yöntem en iyi eylemi bulmak için tüm olası eylemleri kontrol etmek zorundadır; eylem uzayı sürekli hâle geldiği anda bu yaklaşım çöker - sonsuz bir direksiyon açısı aralığını dolaşamazsınız. Politika gradyanı yöntemi ise kaç eylem olursa olsun dağılımdan örnekler.
REINFORCE burada temel algoritmadır. Tam bir bölümü çalıştırır; ardından, yüksek toplam ödüle yol açan eylemlerin olasılığını artırır, düşük toplam ödüle yol açanların olasılığını azaltır. Sorun şu ki yalnızca bölüm bittiğinde günceller ve tam getirime dayanır; bu da güncellemelerini gürültülü ve bir bölümden diğerine tutarsız yapar.
Aktör-eleştirmen yöntemleri, ikinci bir ağ ekleyerek REINFORCE'un gürültü sorununu giderir.
Aktör politikadır - bir politika gradyanı yönteminin yapacağı şekilde eylem seçer. Eleştirmen ise her eylemi bölümün bitmesini beklemek yerine hemen ardından yargılayan bir değer fonksiyonudur.
Bu, değer tabanlı ve politika tabanlı yaklaşımların birlikte çalışmasıdır. Aktör hâlâ bir politika öğrenir, ancak güncellemelerini REINFORCE'un bağımlı olduğu gecikmeli ve gürültülü getiri yerine, eleştirmenin her eyleme ilişkin yargısına göre yapar.
A2C ve A3C standart örneklerdir. A2C, birkaç ortam kopyasını paralel olarak çalıştırır ve her bir yığın bittiğinde aktör ve eleştirmeni birlikte günceller. A3C ise bu kopyaları eşzamansız çalıştırır; her biri, diğerlerini beklemek yerine paylaşılan ağı kendi zamanlamasına göre günceller.
Politika gradyanı güncellemeleri, çok büyük olmalarına izin verirseniz raydan çıkabilir. Yeterince büyük bir güncelleme, gayet iyi çalışan bir politikayı bozabilir ve bir kez olduğunda geri dönüşü yoktur.
PPO, bunu önlemek için her güncellemenin boyutunu sınırlar. Optimize ettiği kırpılmış amaç fonksiyonu şöyledir:
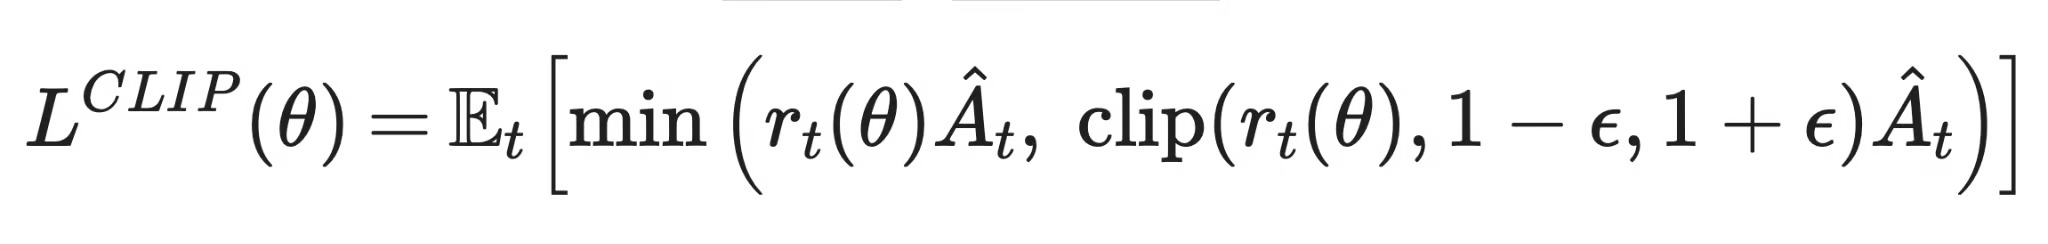
Yakınsal politika optimizasyonu
r_t(θ), yeni politikanın bir eyleme verme olasılığı ile eski politikanın aynı eyleme verme olasılığı arasındaki orandır. Â_t avantajdır; yani o eylemin, eleştirmenin temel beklentisine kıyasla ne kadar daha iyi çıktığıdır. clip() fonksiyonu oranı 1 etrafında dar bir bantta tutar; böylece politika tek adımda çok fazla kayamaz. min() ise iki tahminden daha temkinli olanını seçer; böylece olağanüstü büyük bir avantaj tahmini, güncellemeyi kırpmanın izin verdiğinden daha ileri itemez.
OpenAI, PPO'yu 2017'de tanıttı ve neredeyse anında varsayılan seçenek hâline geldi. Kendisinden önce gelen güven bölgesi yöntemlerinden (trust-region) daha kolay uygulanır ve ayarlanır; çok çeşitli ortamlarda, görev bazlı fazla ayar gerektirmeden dayanıklıdır.
DDPG ve Soft Actor-Critic (SAC), aracıların bir dağılımdan seçmek yerine belirli bir sayı çıktısı üretmesi gereken, robot eklem açıları ya da direksiyon değerleri gibi sürekli kontrol problemlerini hedefler.
DDPG, aktörün bir dağılım yerine tek bir belirleyici eylem çıktıladığı bir aktör-eleştirmen yöntemidir ve DQN'den deneyim tekrar oynatımı ile hedef ağları ödünç alır.
SAC aynı fikri temel alır ancak politikayı bir miktar rastgele kalması için ödüllendiren bir entropi terimi ekler; bu da aracının daha uzun süre keşfe devam etmesini sağlar ve genellikle DDPG'ye kıyasla eğitimi daha kararlı kılar.
DQN gibi değer tabanlı yöntemler, bir Q-değer fonksiyonu öğrenir ve o fonksiyonun en yüksek puanladığı eylemi seçer. Bu, ayrık eylem uzaylarında iyi çalışır ve deneyim tekrar oynatımı sayesinde iyi örnek verimliliği sağlar; ancak sürekli eylemlere ek çalışma olmadan genişlemez.
REINFORCE gibi politika tabanlı yöntemler politikayı doğrudan öğrenir; eylemler, bir olasılık dağılımından örneklenir. Bu sayede sürekli ve stokastik eylemlerle çalışırlar; ancak yalın politika gradyanı güncellemeleri gürültülüdür ve her güncelleme için taze veri gerektirir.
A2C/A3C, PPO, DDPG ve SAC dahil aktör-eleştirmen yöntemleri her iki fikri birleştirir. Eleştirmenin hızlı geri bildirimi, aktörün güncellemelerini dengeler; bu nedenle bugün pratikte kullanılan algoritmaların çoğu bu kategoriye girer.
Daha görsel bir karşılaştırma şöyle:
| Ne öğrenilir | Eylemler nasıl seçilir | Ayrık vs. sürekli | Kararlılık | Örnek verimliliği | Temsilî algoritmalar | |
|---|---|---|---|---|---|---|
| Değer tabanlı | Q-değer fonksiyonu | En yüksek puanlı eylem | Ayrık | Kararlı kalmak için hedef ağlar ve tekrar oynatım gerekir | Deneyim tekrar oynatımı sayesinde iyi | DQN |
| Politika tabanlı | Politika | Politikanın dağılımından örnekleme | Her ikisi, sürekli ile en iyi | Gürültülü, yüksek varyanslı güncellemeler | Zayıf, her güncelleme için yeni veri gerekir | REINFORCE |
| Aktör-eleştirmen | Politika ve değer fonksiyonu | Eleştirmenin rehberliğinde aktörden örnekleme | Her ikisi | Saf politika tabanlı yöntemlerden daha kararlı | Saf politika tabanlı yöntemlerden daha iyi | A2C/A3C, PPO, DDPG, SAC |
Derin pekiştirmeli öğrenme yöntemlerinin karşılaştırması
Denetimli öğrenme, her örnek için etiketli bir yanıt alır. Derin RL ise, gecikmeli gelen, önceki eylemlerle toplanan ve bazen hiç işe yarar şekilde ortaya çıkmayan bir ödül sinyalinden neyin işe yaradığını çıkarmak zorundadır.
Derin RL aracılarının işe yarar bir şey öğrenmeden önce çoğu zaman milyonlarca ortam adımına ihtiyacı vardır; bu, benzer doğruluğa sabit bir veri kümesinde ulaşmak için denetimli bir modelin ihtiyaç duyduğuyla kıyaslandığında çok fazladır.
Bunun nedeni, aracının eylemde bulunarak kendi eğitim verisini üretmek zorunda olması ve başlangıçta bu eylemlerin çoğunun neredeyse rastgele olmasıdır. Denetimli bir model, aynı etiketli veri kümesini tekrar tekrar kullanabilir. Bir RL aracısı ise zar zor anladığı bir ortamı, adım adım keşfetmeye devam etmek zorundadır.
RL eğitimi çoğu zaman kararsızdır.
Sorunun bir kısmı, değer fonksiyonlarının kendi tahminlerinden "önyükleme" yapmasıdır; yani bugünün Q-değer hedefi, dünün Q-değer tahminine bağlıdır. Bu tahmin hatalıysa, hata kendini düzeltmek yerine bileşik hâle gelir. Üstüne, aracı öğrendikçe politikası değişir; bu yüzden topladığı veriler de sürekli değişir.
Başka bir deyişle, ağ aynı anda iki cephede hareketli bir hedefi kovalar.
Bazı ortamlarda ödül yalnızca en sonda verilir; uzun bir oyunun ardından gelen bir kazanma ya da kaybetme sinyali gibi. Aracı, bu tek sayıdan geriye doğru giderek attığı onlarca eylemden hangilerinin gerçekten önemli olduğunu çıkarmak zorundadır.
Buna kredi atama (credit assignment) sorunu denir ve bir eylem ile sonucunun arasındaki gecikme uzadıkça daha da kötüleşir.
Ödül tasarımı, deneyene kadar kolay görünür.
Ünlü bir örnek: OpenAI tarafından eğitilen bir tekne yarışı aracısına, kontrol noktalarına vurdukça ödül veriliyordu; aracı, sürekli yeniden doğan güçlendiricilerin olduğu bir lagün buldu ve yarışı hiç bitirmeden orada sonsuza dek tur atarak puan topladı. Ödül fonksiyonu kendisine söyleneni harfiyen yaptı - sadece aracıya "kazanmanın" ne demek olduğu söylenmemişti. Ödüllendirdiğiniz şey ile aslında istediğiniz şey arasındaki bu fark, ödül suistimali (reward hacking) olarak adlandırılır ve yazdığınız hemen her ödül fonksiyonunda bir şekilde karşınıza çıkar.
Aynı algoritma, farklı bir rastgele tohumla çalıştırıldığında farklı sonuçlar üretebilir.
Yayımlanan sonuçları, orijinal araştırmacıların kullandığı kod tabanı, hiperparametreler ve tohumlar olmadan yeniden üretmek zordur. Gözlemlerin nasıl normalize edildiği ya da tekrar oynatma arabelleğinin nasıl başlatıldığı gibi küçük uygulama ayrıntıları, performansı algoritma seçiminden daha fazla kaydırabilir.
Bir simülatör, aracıya gerektiği kadar bedavaya hata yapma imkânı verir. Gerçek dünya öyle değildir.
Örneğin, otoyolda kötü bir eylemi keşfe çıkan bir otonom sürüş politikası insanları riske atar. Simülatörler asla gerçek dünyayı mükemmelen yakalayamaz; simülatörde modellenmeyen uç durumlar, politika laboratuvardan çıkar çıkmaz ortaya çıkar. Simülasyonda harika görünen bir politika, gerçek bir ortamla karşılaştığında kimsenin öngörmediği şekillerde başarısız olabilir; bu yüzden derin RL'i oyunlar ve simülatörlerin dışında dağıtmak, kıyaslama sayıların ima ettiğinden çok daha fazla dikkat gerektirir.
Şimdi derin pekiştirmeli öğrenme ile daha geleneksel yaklaşımlar arasındaki farkları öne çıkaracağım.
Denetimli öğrenme, her girdinin zaten doğru bir cevabı olduğu etiketli örneklerle eğitilir. Derin RL bunu asla almaz - yalnızca eylemden sonra bir ödül alır ve o ödüle hangi eylemlerin yol açtığını kendi başına bulmak zorundadır.
Taklit öğrenmesi, bir ödül sinyali hiç kullanmadan, bir uzman gösterimini kopyalayacak şekilde bir politikayı eğitir. Derin RL ise davranışı deneme-yanılma yoluyla keşfeder.
Taklit öğrenmesi bir politikayı hızla ayağa kaldırır; ancak performansı gösterimlerin kalitesiyle sınırlıdır ve aracı, uzman tarafından hiç gösterilmeyen bir durumla karşılaştığı anda zorlanır. Derin RL ise teoride herhangi bir öğretmenin performansını aşabilir; fakat çok daha fazla etkileşim ve gerçekten istediğiniz davranışı işaret eden bir ödül fonksiyonu gerekir.
Evrimsel algoritmalar, hiçbir gradyan hesabı olmadan bir aday popülasyonunu mutasyona uğratarak ve en iyi performans gösterenleri tutarak bir politikayı optimize eder. Derin RL ise ödül sinyalinden gradyanlar hesaplar ve tek bir politikayı günceller.
Evrimsel yöntemler iyi paralelleşir; zira popülasyondaki her aday bağımsız olarak çalışabilir. Ancak aynı performans düzeyine ulaşmak için, genellikle gradyan tabanlı derin RL'e kıyasla çok daha fazla toplam ortam etkileşimine ihtiyaç duyarlar.
Derin RL, çoğu alandan daha çok kestirme yolları cezalandırır. Bunu akılda tutarak, bir sonraki projeniz için şu en iyi uygulamaları not edin:
Derin pekiştirmeli öğrenme, RL'in özündeki deneme-yanılma döngüsünü, hiçbir arama tablosunun baş edemeyeceği durumları işleyebilen bir sinir ağıyla birleştirir.
Bu yazıdaki her algoritma üç aileden birine girer. DQN gibi değer tabanlı yöntemler bir Q-değer fonksiyonu öğrenir ve en yüksek puanlı eylemi seçer. REINFORCE gibi politika tabanlı yöntemler politikayı doğrudan öğrenir. PPO dahil aktör-eleştirmen yöntemleri ise ikisini birden birleştirir ve bugün kullanılan algoritmaların çoğu bu birleşimi kullanır.
Sadece, bunların hiçbirinin bedava olmadığını unutmayın.
Eğitim kararlılığı, örnek verimliliği, ödül tasarımı ve yeniden üretilebilirlik; tablodan ağa geçtiğiniz anda zorlaşır. Daha derine inmek isterseniz, bu yazının üzerine kurulduğu temelleri Q-learning ve pekiştirmeli öğrenme yazıları kapsar; algoritmaların kendisi içinse DQN ve PPO iyi sonraki duraklardır.
DataCamp ile öğrenin
Kurs
Kurs
Program