Khóa học
Xây dựng ứng dụng AI với Pinecone
3 giờ
12.2K
Về bản chất, cơ sở dữ liệu vector là một hệ thống được xây dựng chuyên biệt để lưu trữ và truy xuất dữ liệu vector. Trong ngữ cảnh này, một vector là một tập hợp có thứ tự các giá trị số, có thể biểu diễn mọi thứ từ tọa độ không gian đến các thuộc tính đặc trưng, như trong các bài toán machine learning và khoa học dữ liệu, nơi vector thường dùng để biểu diễn đặc trưng của đối tượng. Cơ sở dữ liệu vector có thể lưu trữ và truy xuất hiệu quả các vector đặc trưng này.
Hình ảnh bởi Gary Alway
Vector embedding là quá trình biểu diễn các đối tượng, như từ ngữ, câu, hoặc thực thể, dưới dạng vector trong một không gian vector liên tục. Kỹ thuật này thường được dùng để chuyển đổi dữ liệu có chiều cao và dữ liệu phân loại thành các vector liên tục, có số chiều thấp hơn, giúp các thuật toán machine learning sử dụng hiệu quả hơn. Vector embedding đặc biệt phổ biến trong xử lý ngôn ngữ tự nhiên (NLP), nơi chúng được dùng để biểu diễn từ hoặc cụm từ.
Ý tưởng cốt lõi đằng sau vector embedding là nắm bắt các quan hệ ngữ nghĩa giữa các đối tượng. Chẳng hạn với word embedding, các từ có nghĩa tương tự sẽ được biểu diễn bằng các vector gần nhau trong không gian vector. Điều này cho phép các mô hình machine learning hiểu tốt hơn các mối quan hệ ngữ cảnh và ngữ nghĩa giữa các từ.
Dựa trên khái niệm về vector embedding, các Mô hình Ngôn ngữ Lớn (LLM) tận dụng các biểu diễn số này để xử lý các nhiệm vụ hiểu và sinh ngôn ngữ phức tạp.
Lấy ví dụ cụ thể, kiến trúc nền tảng của mô hình cho chat GTP liên quan đến việc sử dụng vector. Mô hình xử lý đầu vào, như văn bản, bằng cách chuyển đổi chúng thành các vector số.
Các vector này nắm bắt thông tin ngữ nghĩa và ngữ cảnh của đầu vào, cho phép mô hình hiểu và tạo ra các phản hồi mạch lạc, phù hợp với ngữ cảnh. Kiến trúc Transformer, nền tảng của GPT-3.5, sử dụng cơ chế self-attention để đánh trọng số tầm quan trọng của các từ khác nhau trong một chuỗi, từ đó tăng cường khả năng nắm bắt quan hệ và ngữ cảnh của mô hình.
“Self-attention” đề cập đến khả năng của mô hình trong việc gán các mức độ quan trọng khác nhau cho các từ trong chuỗi đầu vào.
Tóm lại, mô hình GPT-3.5 vận hành trên các biểu diễn ngôn ngữ đã được vector hóa để thực hiện nhiều nhiệm vụ hiểu và sinh ngôn ngữ tự nhiên. Cách tiếp cận dựa trên vector này là một yếu tố then chốt tạo nên thành công của mô hình trong nhiều ứng dụng liên quan đến ngôn ngữ.
PG Vector là công cụ tìm kiếm tương đồng vector mã nguồn mở cho Postgres. Hãy bắt đầu ngay và tạo một cơ sở dữ liệu với Docker. Tạo tệp có tên docker-compose.yml rồi tại dòng lệnh chạy lệnh sau: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
Bước tiếp theo là tạo một bảng, và trong ví dụ này, chúng ta sẽ lập danh mục tài nguyên học tập của DataCamp, bao gồm khóa học, blog, hướng dẫn, podcast, cheat sheet, code along và chứng chỉ.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
Cột embedding sẽ được tạo từ một đối tượng JSON dạng chuỗi đại diện cho các thuộc tính của tài nguyên { name, content, slug, type }. Để tạo vector embedding này, chúng ta sẽ sử dụng một mô hình embedding.
Một mô hình như vậy có sẵn trên AWS Bedrock là amazon.titan-embed-text-v1. Cấu hình Bedrock không nằm trong phạm vi bài viết này; đây chỉ là một ví dụ về rất nhiều mô hình embedding có thể đạt được kết quả tương tự. Mục tiêu chính là lấy đầu vào dạng văn bản, dùng mô hình embedding để tạo vector embedding, rồi lưu chúng vào cột embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Khi có khả năng lưu trữ dữ liệu cùng với vector embedding của nó, chúng ta mở khóa sức mạnh của cơ sở dữ liệu vector, cho phép tương tác với dữ liệu theo kiểu hội thoại ngôn ngữ tự nhiên và truy xuất kết quả có ý nghĩa một cách dễ dàng.
Chỉ cần đặt bất kỳ câu hỏi nào bạn muốn “hỏi dữ liệu của mình” và áp dụng cùng một embedding cho đoạn văn bản đó. Câu truy vấn SQL sẽ như sau:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Truy vấn này sử dụng tìm kiếm theo cosine similarity. Tham số $1 đại diện cho kết quả embedding của văn bản câu hỏi đầu vào của bạn, trong khi tham số $2, đóng vai trò là ngưỡng tương đồng, là một biến cần thử nghiệm. Giá trị tối ưu của nó phụ thuộc vào các yếu tố như kích thước tập dữ liệu và mức độ liên quan bạn mong muốn, từ đó quyết định độ chi tiết của thông tin được truy xuất.
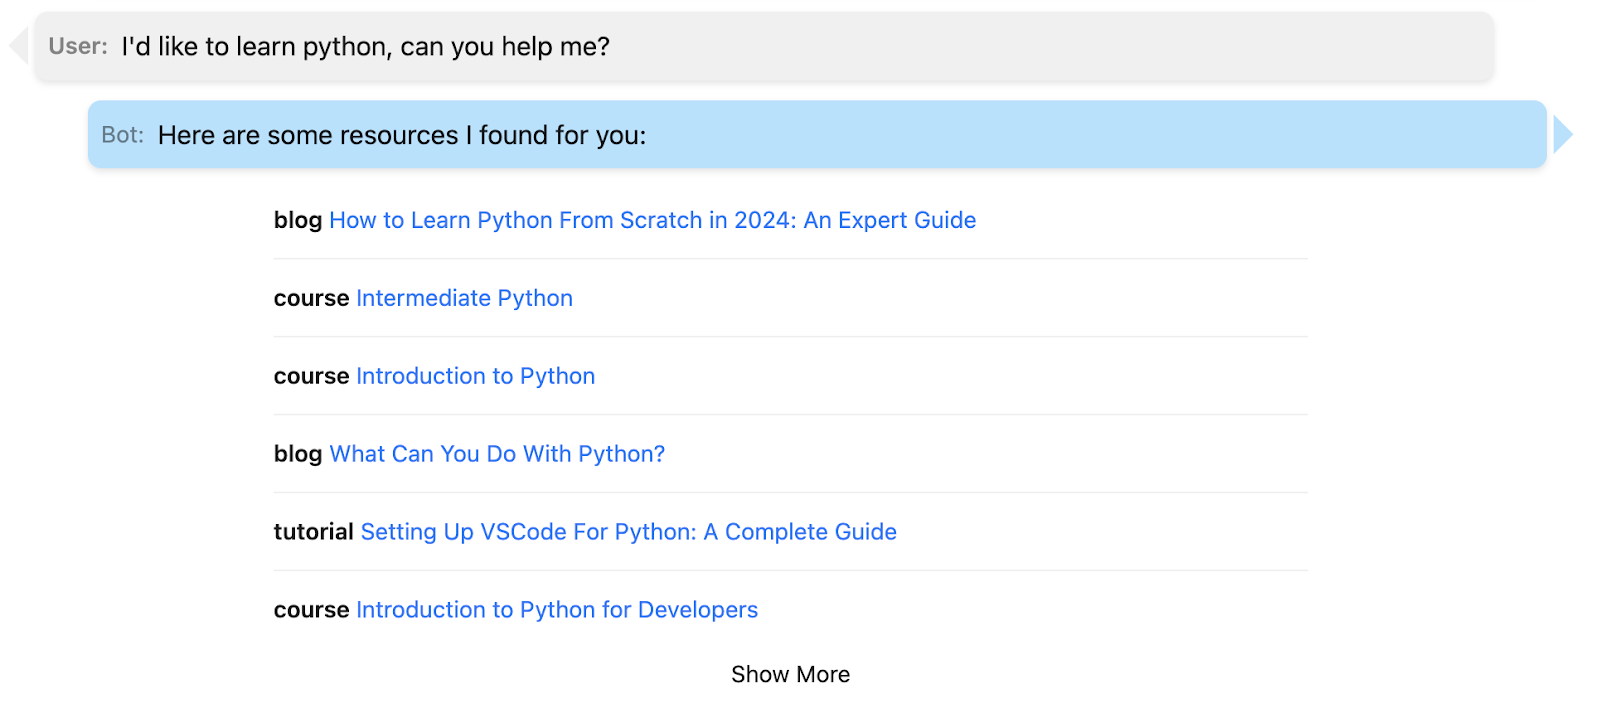
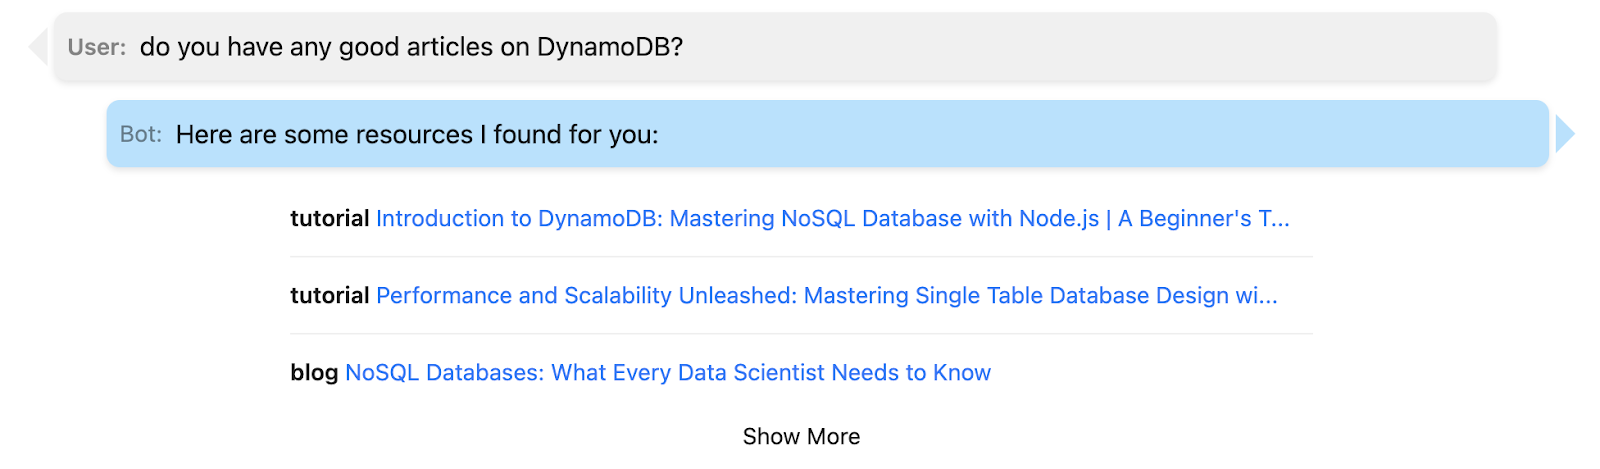
Khi đã có đủ các thành phần này, việc tạo một giao diện trò chuyện trở nên đơn giản. Chi tiết triển khai giao diện như vậy nằm ngoài phạm vi bài viết, nhưng dưới đây là một vài ví dụ dùng bộ dữ liệu DataCamp của tôi, gồm hơn 600 bản ghi:
Trong bài viết này, chúng ta đã khám phá thế giới mạnh mẽ của cơ sở dữ liệu vector, tận dụng PG Vector để nâng cao khả năng lưu trữ và truy xuất dữ liệu. Khi bạn bắt đầu hành trình với vector embedding, còn rất nhiều điều để khám phá và học hỏi. Để tìm hiểu sâu hơn về PG Vector, hãy xem readme của họ, trong đó có giải thích chi tiết hơn và bao gồm liên kết đến các client cho ngôn ngữ lập trình bạn ưa thích.
Một bước phát triển tự nhiên từ việc hiểu vector embedding là Retrieval Augmented Generation (RAG). Đây là quá trình đưa dữ liệu ngữ cảnh vào các mô hình ngôn ngữ lớn (LLM). Bằng cách đó, RAG cung cấp cho mô hình kiến thức nằm ngoài dữ liệu huấn luyện của nó, cho phép tạo ra các phản hồi đầy đủ thông tin và phù hợp với ngữ cảnh hơn.
Bạn cũng có thể tìm thấy nhiều tài nguyên DataCamp đề cập đến các yếu tố khác của cơ sở dữ liệu vector, bao gồm:
Chúc bạn viết code vui vẻ, và mong rằng những nỗ lực dựa trên vector của bạn sẽ vừa sâu sắc vừa nhiều thành quả!
Tiếp tục hành trình với Vector ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
