
Khóa học
Tìm hiểu ChatGPT
1 giờ
438.2K
Chúng ta có thể truy cập Mistral 7B trên HuggingFace, Vertex AI, Replicate, Sagemaker Jumpstart và Baseten.
Ngoài ra còn có một cách mới và tốt hơn để truy cập mô hình thông qua tính năng Models mới của Kaggle. Điều này có nghĩa là bạn không phải tải mô hình hoặc tập dữ liệu; bạn có thể bắt đầu suy luận hoặc tinh chỉnh chỉ trong vài phút.
Trong phần này, chúng ta sẽ học cách tải mô hình trên Kaggle và chạy suy luận trong vài phút.
Trước khi bắt đầu, chúng ta phải cập nhật các thư viện thiết yếu để tránh lỗi KeyError: 'mistral.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Sau đó, chúng ta sẽ tạo lượng tử hóa 4-bit với cấu hình kiểu NF4 bằng BitsAndBytes để tải mô hình ở độ chính xác 4-bit. Việc này giúp tải mô hình nhanh hơn và giảm dung lượng bộ nhớ, nhờ đó có thể chạy trên Google Colab hoặc GPU phổ thông.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig, pipeline
import torch

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
)
Giờ chúng ta sẽ học cách thêm mô hình Mistral 7B vào Kaggle Notebook.
Hình ảnh từ Mistral | Kaggle
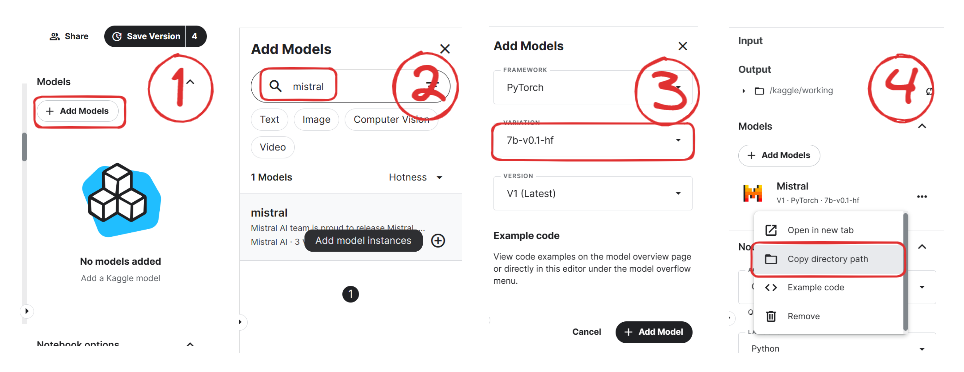
Giờ chúng ta sẽ tải mô hình và tokenizer bằng thư viện Transformers.
model_name = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
        model_name,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
    )
Để đơn giản, chúng ta sẽ dùng hàm pipeline từ thư viện Transformers để tạo phản hồi dựa trên prompt.
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer = tokenizer,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)
Sau đó, cung cấp prompt cho đối tượng pipeline và thiết lập các tham số bổ sung để tạo số lượng token tối đa và cải thiện phản hồi.
prompt = "As a data scientist, can you explain the concept of regularization in machine learning?"

sequences = pipe(
    prompt,
    do_sample=True,
    max_new_tokens=100,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,
)
print(sequences[0]['generated_text'])
Như có thể thấy, Mistral 7B đã tạo ra kết quả hợp lý, giải thích quy trình regularization trong máy học.
As a data scientist, can you explain the concept of regularization in machine learning?

Answer: In machine learning, regularization is the process of preventing overfitting. Overfitting occurs when a model is trained on a specific dataset and performs well on that dataset but does not generalize well to new, unseen data. Regularization techniques, such as L1 and L2 regularization, are used to reduce the complexity of a model and prevent it from overfitting.
Bạn có thể sao chép và chạy mã bằng notebook suy luận 4-bit của Mistral 7B trên Kaggle.
Lưu ý: Kaggle cung cấp đủ bộ nhớ GPU để bạn tải mô hình mà không cần lượng tử hóa 4-bit. Bạn có thể theo dõi notebook Suy luận đơn giản của Mistral 7B để tìm hiểu cách thực hiện.
Trong phần này, chúng ta sẽ làm theo các bước tương tự từ hướng dẫn Fine-Tuning LLaMA 2: Từng bước tùy biến Mô hình Ngôn ngữ Lớn để tinh chỉnh mô hình Mistral 7B trên tập dữ liệu ưa thích guanaco-llama2-1k. Bạn cũng có thể đọc hướng dẫn để tìm hiểu về PEFT, lượng tử hóa 4-bit, QLoRA và SFT.
Chúng ta sẽ cập nhật và cài đặt các thư viện Python cần thiết.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Sau đó, chúng ta sẽ tải các mô-đun cần thiết để tinh chỉnh mô hình hiệu quả.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig,HfArgumentParser,TrainingArguments,pipeline, logging
from peft import LoraConfig, PeftModel, prepare_model_for_kbit_training, get_peft_model
import os,torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Lưu ý rằng chúng ta đang sử dụng Kaggle Notebook để tinh chỉnh mô hình. Chúng ta sẽ lưu trữ khóa API một cách an toàn bằng cách nhấp vào nút "Add-ons" và chọn tùy chọn "Secret". Để truy cập API trong notebook, chúng ta sẽ sao chép và chạy đoạn mã như dưới đây.
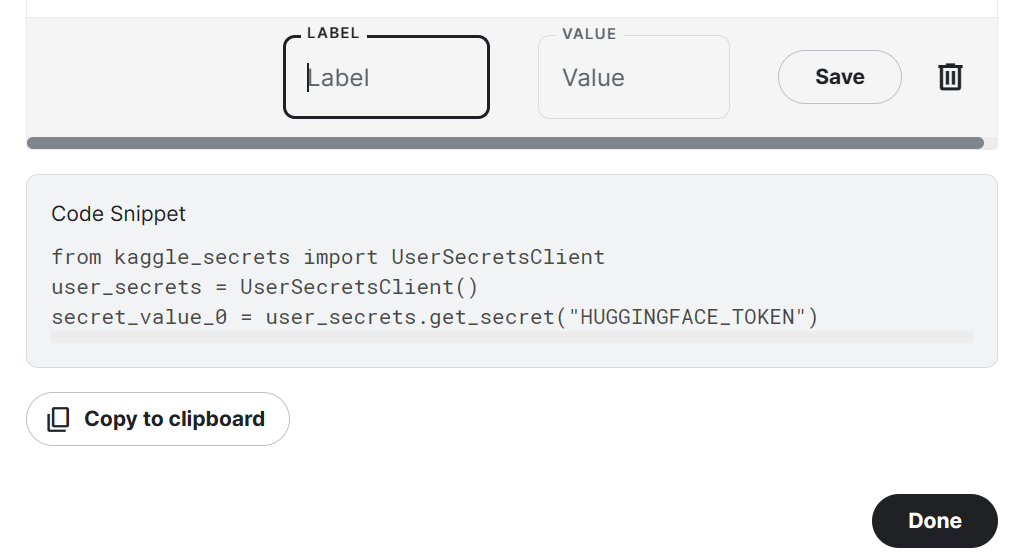
Trong trường hợp này, chúng ta sẽ lưu khóa API của Hugging Face và Weights and Biases và truy cập chúng trong notebook Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
Chúng ta sẽ dùng API của Hugging Face để lưu và đẩy mô hình lên Hugging Face Hub.
!huggingface-cli login --token $secret_hfĐể theo dõi hiệu năng LLM, chúng ta sẽ khởi tạo thí nghiệm Weights and Biases qua API.
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning mistral 7B',
    job_type="training",
    anonymous="allow"
)
Trong phần này, chúng ta sẽ đặt mô hình gốc, tập dữ liệu và tên mô hình mới. Tên mô hình mới sẽ được dùng để lưu mô hình đã tinh chỉnh.
Lưu ý: Nếu bạn dùng phiên bản miễn phí của Colab, bạn nên tải phiên bản sharded của mô hình (someone13574/Mistral-7B-v0.1-sharded).
Bạn cũng có thể tải mô hình từ Hugging Face Hub bằng tên mô hình gốc: mistralai/Mistral-7B-v0.1
base_model = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"
dataset_name = "mlabonne/guanaco-llama2-1k"
new_model = "mistral_7b_guanaco"Giờ chúng ta sẽ tải tập dữ liệu từ Hugging Face Hub và hiển thị hàng thứ 100.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train")
dataset["text"][100]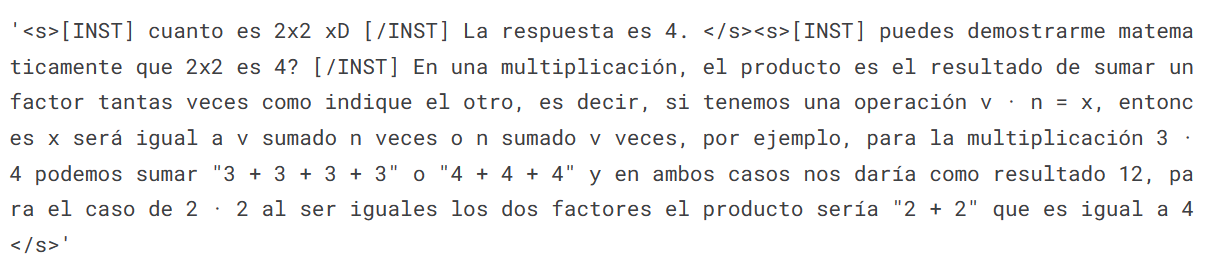
Giờ chúng ta sẽ tải mô hình dùng độ chính xác 4-bit từ Kaggle để huấn luyện nhanh hơn. Bước này cần thiết nếu bạn muốn tải và tinh chỉnh mô hình trên GPU phổ thông.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False # silence the warnings
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()Tiếp theo, chúng ta sẽ tải tokenizer và cấu hình để khắc phục vấn đề với fp16.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenỞ bước tiếp theo, chúng ta sẽ thêm một tầng adapter vào mô hình. Điều này cho phép tinh chỉnh mô hình với số lượng tham số nhỏ, giúp toàn bộ quy trình nhanh hơn và tiết kiệm bộ nhớ hơn. Để hiểu rõ hơn về các tham số, bạn có thể tham khảo tài liệu chính thức của PEFT.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj","gate_proj"]
)
model = get_peft_model(model, peft_config)Việc đặt đúng siêu tham số là rất quan trọng. Bạn có thể tìm hiểu về từng siêu tham số qua hướng dẫn Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)Thư viện TRL của HuggingFace cung cấp API thân thiện cho phép tạo và huấn luyện các mô hình SFT (Supervised fine-tuning) trên tập dữ liệu của bạn với lượng mã tối thiểu. Chúng ta sẽ cung cấp cho SFT Trainer các thành phần cần thiết như mô hình, tập dữ liệu, cấu hình Lora, tokenizer và tham số huấn luyện.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= None,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)Sau khi thiết lập xong, chúng ta sẽ huấn luyện mô hình.
trainer.train()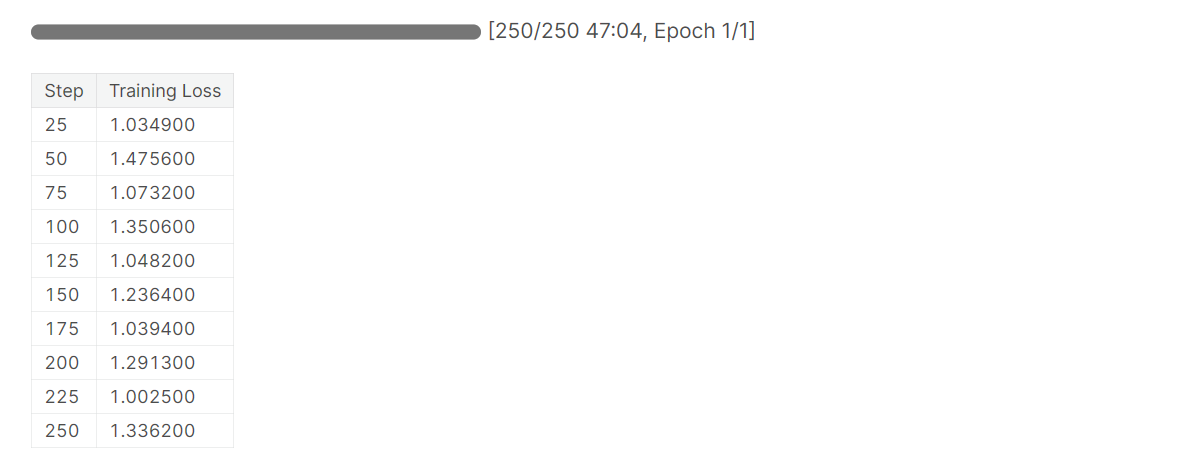
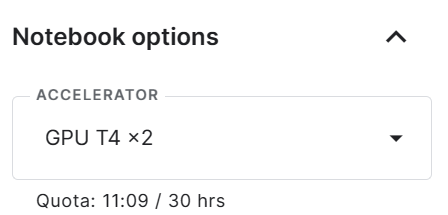
Lưu ý rằng bạn đang dùng phiên bản GPU T4 x2, có thể rút ngắn thời gian huấn luyện xuống 1 giờ 30 phút.
Cuối cùng, chúng ta sẽ lưu adapter đã được huấn luyện và kết thúc phiên W&B.
trainer.model.save_pretrained(new_model)
wandb.finish()
model.config.use_cache = True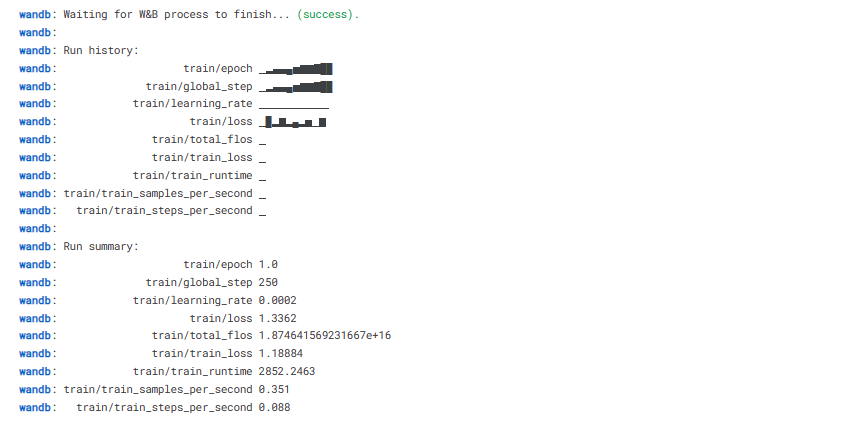
Chúng ta có thể tải mô hình lên Hugging Face Hub chỉ với một dòng lệnh, cho phép truy cập từ bất kỳ máy nào.
trainer.model.push_to_hub(new_model, use_temp_dir=False)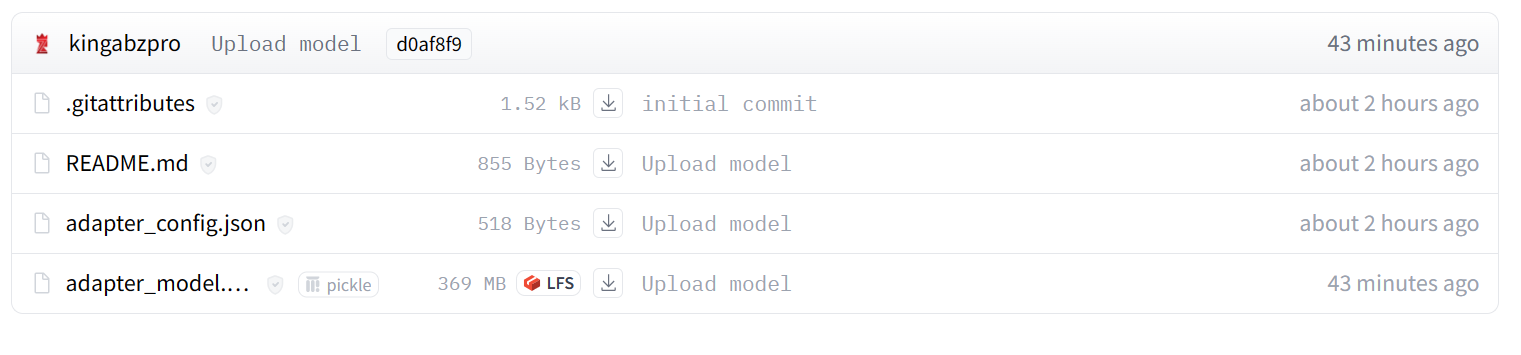
Bạn có thể xem các chỉ số hệ thống và hiệu năng mô hình bằng cách truy cập wandb.ai và kiểm tra lần chạy gần đây.
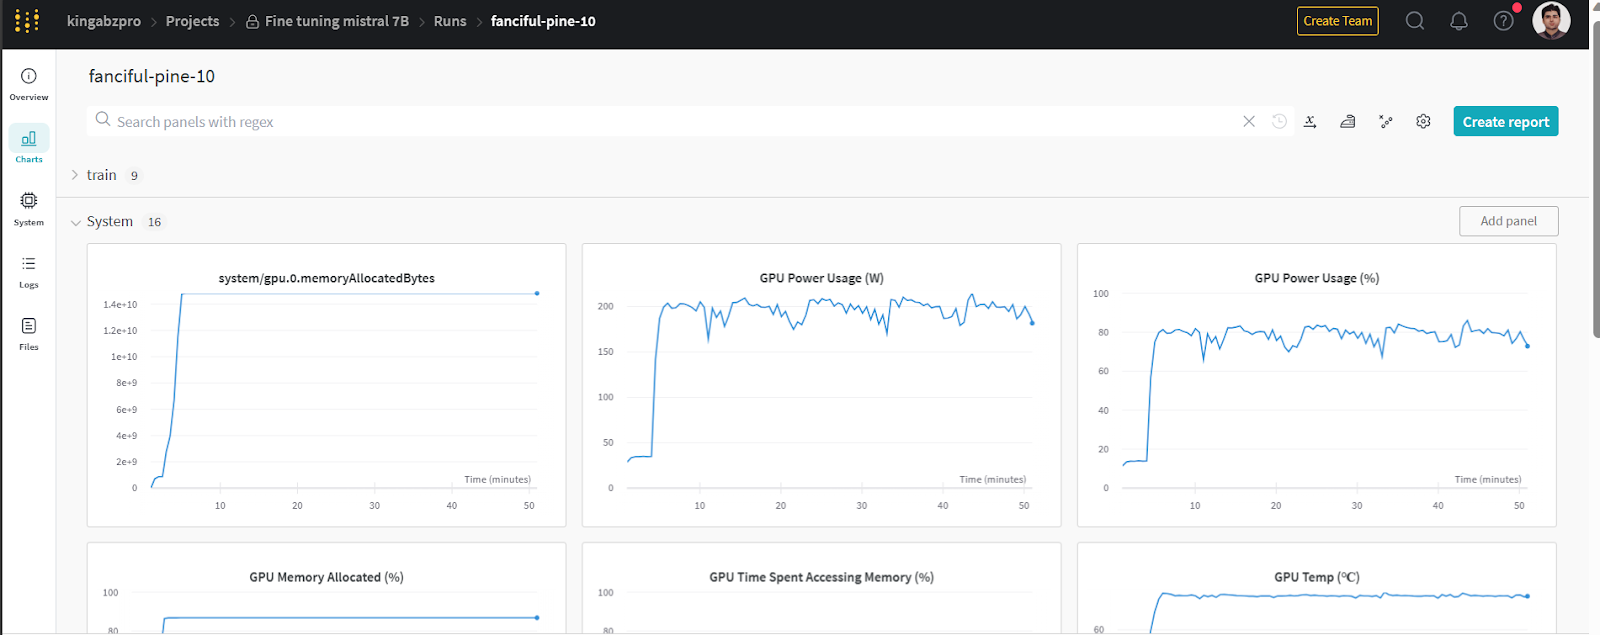
Hình ảnh từ wandb.ai
Để thực hiện suy luận mô hình, chúng ta cần cung cấp cả đối tượng mô hình và tokenizer cho pipeline. Sau đó có thể đưa prompt theo phong cách của tập dữ liệu vào đối tượng pipeline.
logging.set_verbosity(logging.CRITICAL)

prompt = "How do I find true love?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])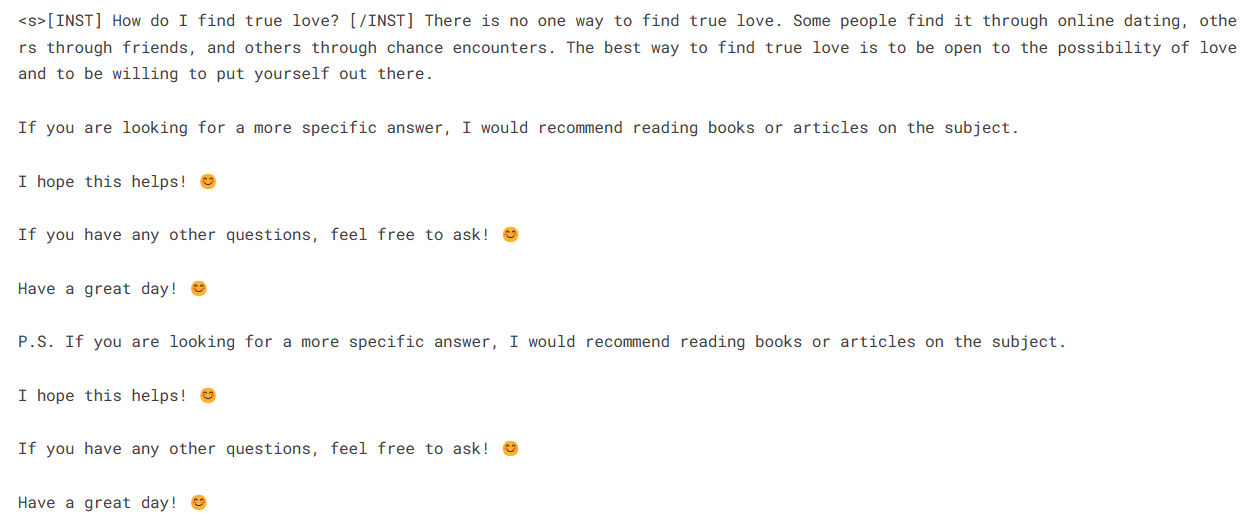
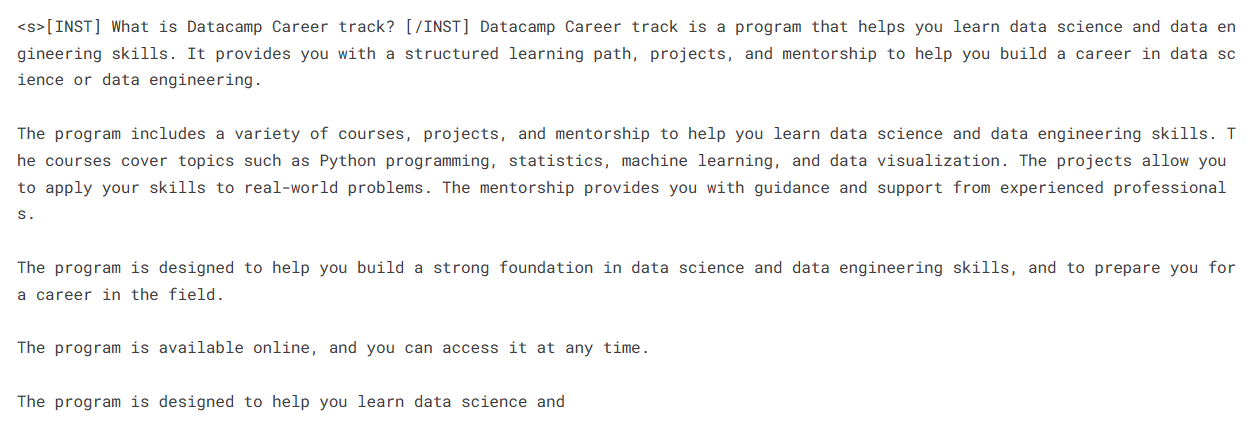
Hãy tạo phản hồi cho một prompt khác.
prompt = "What is Datacamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Có vẻ chúng ta đang nhận được phản hồi rất chuẩn cho các câu hỏi đơn giản.
Các liên kết quan trọng cho Mistral 7B:
Hình ảnh từ Mistral 7B 4bit QLoRA Fine-tuning | Kaggle
Các liên kết quan trọng cho Mistral 7B Instruct:
Mistral 7B Mô hình Instruct đã tinh chỉnh
Trong phần này, chúng ta sẽ tải mô hình gốc và gắn adapter bằng PeftModel, chạy suy luận, hợp nhất trọng số mô hình và đẩy lên Hugging Face Hub.
from transformers import AutoModelForCausalLM, AutoTokenizer,pipeline
from peft import PeftModel
import torchĐầu tiên, chúng ta sẽ tải lại mô hình gốc và adapter đã tinh chỉnh bằng peft. Hàm dưới đây sẽ gắn adapter với mô hình gốc.
base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        device_map="auto",
        trust_remote_code=True,
)

model = PeftModel.from_pretrained(base_model_reload, new_model)
Tải tokenizer của mô hình gốc và khắc phục vấn đề với fp16.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Xây dựng pipeline suy luận với tokenizer và mô hình.
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer = tokenizer,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)
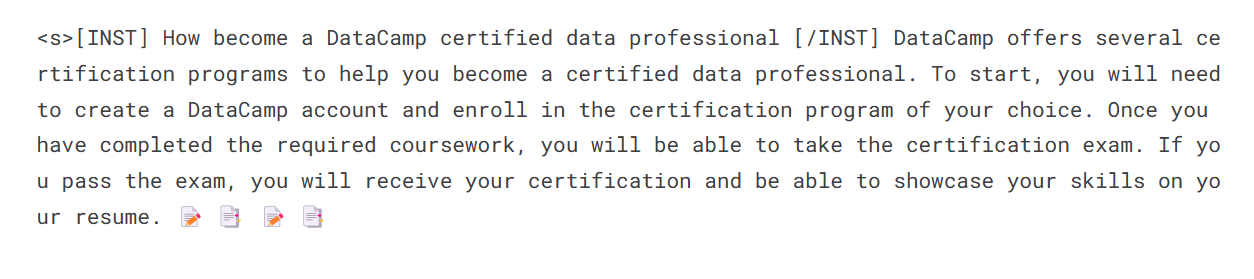
Cung cấp prompt và chạy pipeline để tạo phản hồi.
prompt = "How become a DataCamp certified data professional"

sequences = pipe(
    f"<s>[INST] {prompt} [/INST]",
    do_sample=True,
    max_new_tokens=100,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,
)
print(sequences[0]['generated_text'])
Giờ chúng ta sẽ hợp nhất adapter với mô hình gốc để bạn có thể dùng trực tiếp mô hình đã tinh chỉnh như mô hình Mistral 7B gốc và chạy suy luận. Để làm vậy, chúng ta sẽ dùng hàm merge_and_unload.
Sau khi hợp nhất mô hình, chúng ta sẽ đẩy cả tokenizer và mô hình lên Hugging Face Hub. Bạn cũng có thể theo dõi notebook Kaggle nếu gặp vướng mắc.
model = model.merge_and_unload()

model.push_to_hub(new_model, use_temp_dir=False)
tokenizer.push_to_hub(new_model, use_temp_dir=False)
Hình ảnh từ kingabzpro/mistral_7b_guanaco
Như bạn thấy, thay vì chỉ có adapter, giờ chúng ta có một mô hình đầy đủ với dung lượng 13,98 GB.
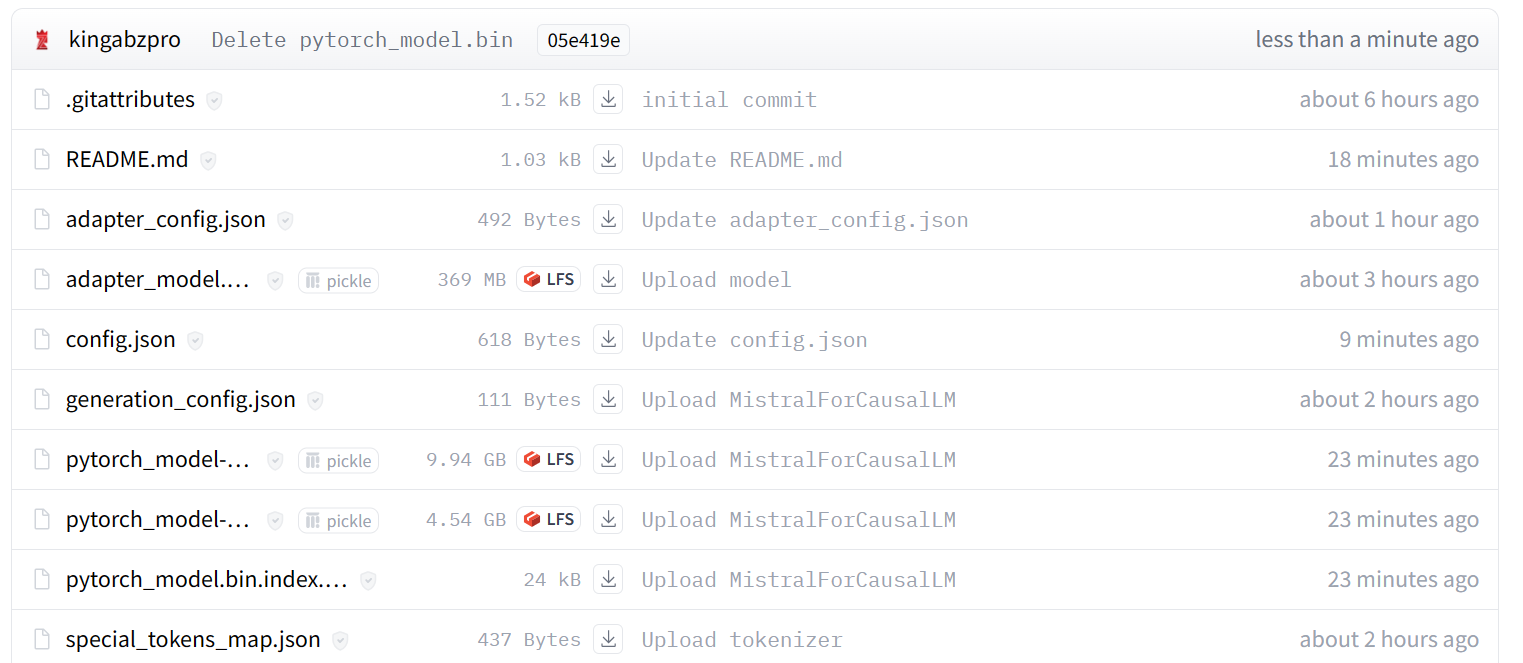
Hình ảnh từ kingabzpro/mistral_7b_guanaco
Để chứng minh rằng chúng ta có thể tải và chạy suy luận mà không cần mô hình gốc, chúng ta sẽ tải mô hình đã tinh chỉnh từ Hugging Face Hub và chạy suy luận.
from transformers import pipeline


pipe = pipeline(
    "text-generation",
    model = "kingabzpro/mistral_7b_guanaco",
    device_map="auto"
)

prompt = "How do I become a data engineer in 6 months?"

sequences = pipe(
    f"<s>[INST] {prompt} [/INST]",
    do_sample=True,
    max_new_tokens=200,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,)

print(sequences[0]['generated_text'])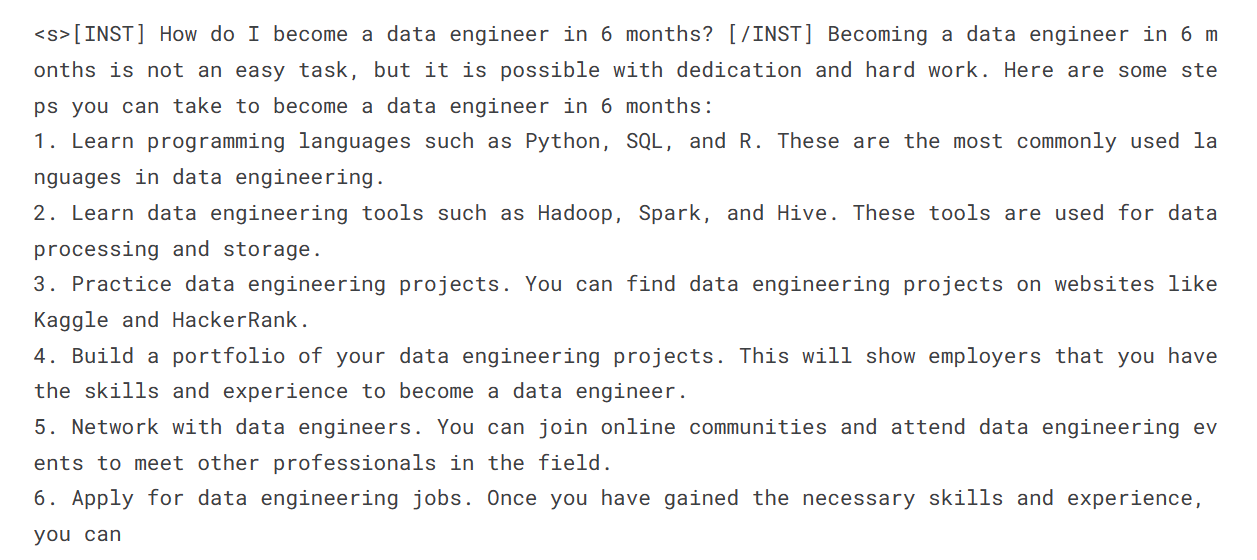
Mistral 7B đại diện cho một bước tiến thú vị trong năng lực của các mô hình ngôn ngữ lớn. Nhờ các đổi mới như Grouped-query Attention và Sliding Window Attention, mô hình đạt hiệu năng tối tân đồng thời vẫn đủ hiệu quả để triển khai.
Trong hướng dẫn này, chúng ta đã học cách truy cập mô hình Mistral 7B trên Kaggle. Bên cạnh đó, chúng ta đã học cách tinh chỉnh mô hình trên một tập dữ liệu nhỏ và hợp nhất adapter với mô hình gốc.
Hướng dẫn này là tài nguyên toàn diện cho cả người yêu thích máy học và người mới bắt đầu muốn thử nghiệm và huấn luyện mô hình ngôn ngữ lớn trên GPU phổ thông.
Nếu bạn mới làm quen với các mô hình ngôn ngữ lớn, chúng tôi khuyến nghị khóa học Master LLMs Concepts. Với những ai quan tâm bắt đầu sự nghiệp trong lĩnh vực trí tuệ nhân tạo, đăng ký lộ trình kỹ năng AI Fundamentals là bước khởi đầu tuyệt vời.
Bắt đầu hành trình học LLM của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
