
Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Sau khi Meta ra mắt phiên bản đầu tiên của LLaMA, một cuộc chạy đua mới bắt đầu nhằm xây dựng các Mô hình Ngôn ngữ Lớn (LLM) tốt hơn có thể cạnh tranh với các mô hình như GPT-3.5 (ChatGPT). Cộng đồng mã nguồn mở nhanh chóng phát hành những mô hình ngày càng mạnh mẽ. Với những tiến triển liên tục được công bố, người đam mê AI có cảm giác như đang đón Giáng Sinh.
Tuy nhiên, những bước tiến này cũng có mặt trái. Hầu hết các mô hình nguồn mở đều có giấy phép hạn chế, nghĩa là chỉ được dùng cho mục đích nghiên cứu. Thứ hai, chỉ các công ty lớn hoặc viện nghiên cứu có ngân sách đáng kể mới có khả năng tinh chỉnh hoặc huấn luyện các mô hình. Cuối cùng, việc triển khai và vận hành các mô hình lớn tiên tiến rất tốn kém.
Phiên bản mới của các mô hình LLaMA hướng tới giải quyết những vấn đề này. Mô hình có giấy phép thương mại, giúp nhiều tổ chức có thể tiếp cận hơn. Bên cạnh đó, các phương pháp mới cho phép tinh chỉnh trên GPU người dùng với bộ nhớ hạn chế.
Việc dân chủ hóa AI là then chốt để thúc đẩy ứng dụng rộng rãi. Bằng cách gỡ bỏ rào cản gia nhập, ngay cả các công ty nhỏ cũng có thể xây dựng mô hình tùy biến phù hợp với nhu cầu và ngân sách của mình.
Trong hướng dẫn này, chúng ta sẽ khám phá Llama-2 và trình diễn cách tinh chỉnh nó trên một tập dữ liệu mới bằng Google Colab. Đồng thời, chúng ta sẽ đề cập đến các phương pháp và kỹ thuật tinh chỉnh mới giúp giảm sử dụng bộ nhớ và tăng tốc quá trình huấn luyện.
Hình ảnh do Tác giả tạo bằng DALL-E 3
transformers, peft, trl, bitsandbytes)Llama 2 là bộ sưu tập LLM nguồn mở thế hệ thứ hai từ Meta đi kèm giấy phép thương mại. Mô hình được thiết kế để xử lý nhiều tác vụ xử lý ngôn ngữ tự nhiên, với quy mô từ 7 tỷ đến 70 tỷ tham số. Khám phá thêm về các mô hình LLaMA qua bài viết Giới thiệu về LLaMA của Meta AI: Trao quyền cho đổi mới AI.
Llama-2-Chat, được tối ưu cho hội thoại, cho thấy hiệu năng tương tự các mô hình đóng như ChatGPT và PaLM. Chúng ta thậm chí có thể cải thiện hiệu năng bằng cách tinh chỉnh trên một tập dữ liệu hội thoại chất lượng cao.
Tinh chỉnh trong học máy là quá trình điều chỉnh trọng số và tham số của mô hình đã huấn luyện sẵn trên dữ liệu mới để cải thiện hiệu năng cho một tác vụ cụ thể. Quá trình này huấn luyện mô hình trên tập dữ liệu mới đặc thù cho tác vụ, đồng thời cập nhật trọng số để thích ứng với dữ liệu mới. Đọc thêm về tinh chỉnh qua hướng dẫn tinh chỉnh GPT 3.5 của chúng tôi.
Tinh chỉnh LLM trên phần cứng người dùng là một thách thức do giới hạn VRAM và năng lực tính toán. Tuy nhiên, trong hướng dẫn này, chúng ta sẽ vượt qua những hạn chế về bộ nhớ và tính toán để huấn luyện mô hình bằng phiên bản miễn phí của Google Colab Notebook.
Phần này, chúng ta sẽ tìm hiểu tất cả các bước cần thiết để tinh chỉnh mô hình Llama 2 với 7 tỷ tham số trên GPU T4. Bạn có thể sử dụng GPU miễn phí trên Google Colab hoặc Kaggle. Mã chạy được trên cả hai nền tảng.
GPU T4 của Colab chỉ có 16 GB VRAM. Đó vừa đủ để lưu trọng số của Llama 2–7b, đồng nghĩa không thể tinh chỉnh toàn phần, và chúng ta cần dùng các kỹ thuật tinh chỉnh hiệu quả tham số như LoRA hoặc QLoRA.
Chúng ta sẽ dùng kỹ thuật QLoRA để tinh chỉnh mô hình ở độ chính xác 4-bit và tối ưu sử dụng VRAM. Để làm điều đó, chúng ta sẽ sử dụng hệ sinh thái thư viện LLM của Hugging Face: transformers, accelerate, peft, trl và bitsandbytes.
Chúng ta sẽ bắt đầu bằng cách cài đặt các thư viện cần thiết.
%%capture
%pip install accelerate peft bitsandbytes transformers trl
Sau đó, chúng ta sẽ nạp các mô-đun cần thiết từ những thư viện này.
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import LoraConfig
from trl import SFTTrainerBạn có thể truy cập mô hình Llama-2 chính thức của Meta từ Hugging Face, nhưng bạn phải gửi yêu cầu và đợi vài ngày để được xác nhận. Thay vì chờ đợi, chúng ta sẽ dùng Llama-2-7b-chat-hf của NousResearch làm mô hình gốc. Nó tương tự bản gốc nhưng dễ truy cập hơn.
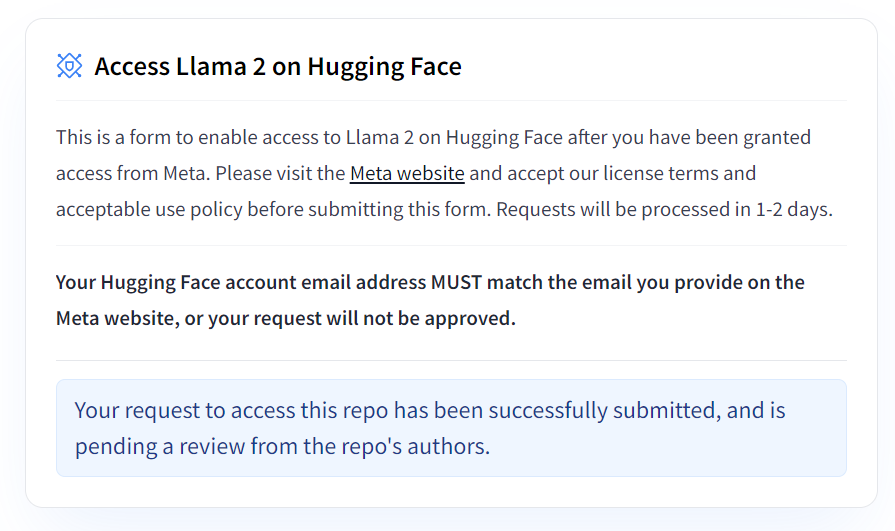
Hình ảnh từ Hugging Face
Chúng ta sẽ tinh chỉnh mô hình gốc bằng một tập dữ liệu nhỏ hơn có tên mlabonne/guanaco-llama2-1k và đặt tên cho mô hình đã tinh chỉnh.
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"

# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"

# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"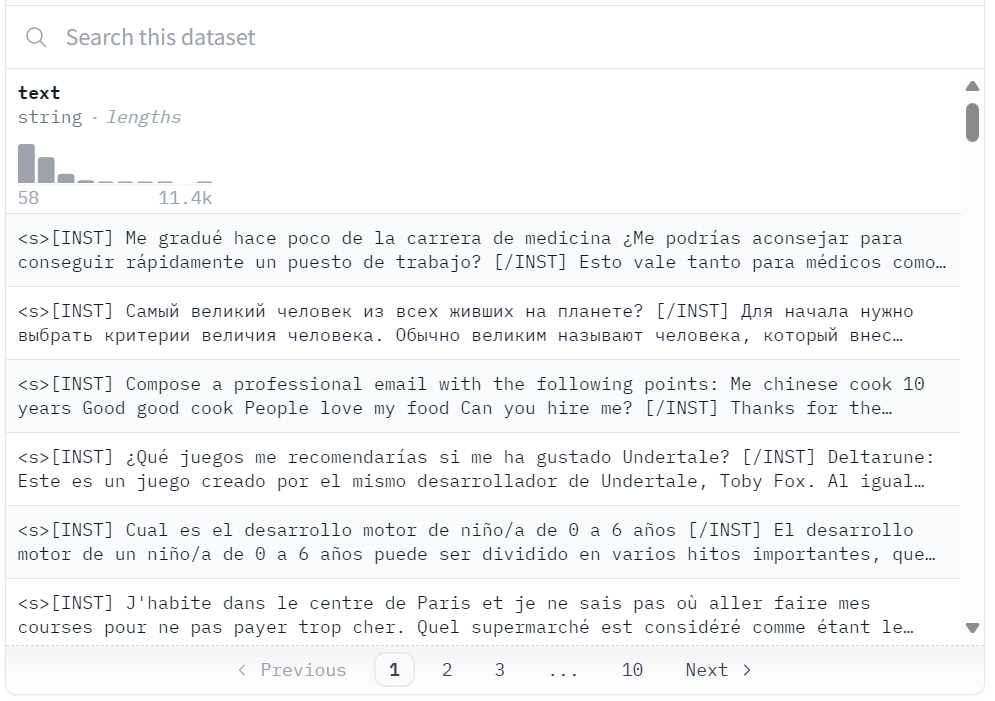
Tập dữ liệu trên Hugging Face
Chúng ta sẽ nạp tập dữ liệu “guanaco-llama2-1k” từ Hugging Face hub. Tập dữ liệu có 1000 mẫu, đã được xử lý để khớp định dạng prompt của Llama 2, và là một tập con của timdettmers/openassistant-guanaco.
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.Lượng tử hóa 4-bit thông qua QLoRA cho phép tinh chỉnh hiệu quả các LLM rất lớn trên phần cứng người dùng mà vẫn giữ hiệu năng cao. Điều này cải thiện đáng kể tính khả dụng cho các ứng dụng thực tế.
QLoRA lượng tử hóa một mô hình ngôn ngữ đã huấn luyện xuống 4-bit và đóng băng các tham số. Sau đó, một số ít các tầng Low-Rank Adapter có thể huấn luyện được sẽ được thêm vào mô hình.
Trong quá trình tinh chỉnh, gradient được lan truyền ngược qua mô hình đã lượng tử 4-bit (đóng băng) chỉ vào các tầng Low-Rank Adapter. Như vậy, toàn bộ mô hình tiền huấn luyện vẫn cố định ở 4-bit trong khi chỉ các adapter được cập nhật. Việc lượng tử hóa 4-bit cũng không làm suy giảm hiệu năng đáng kể.
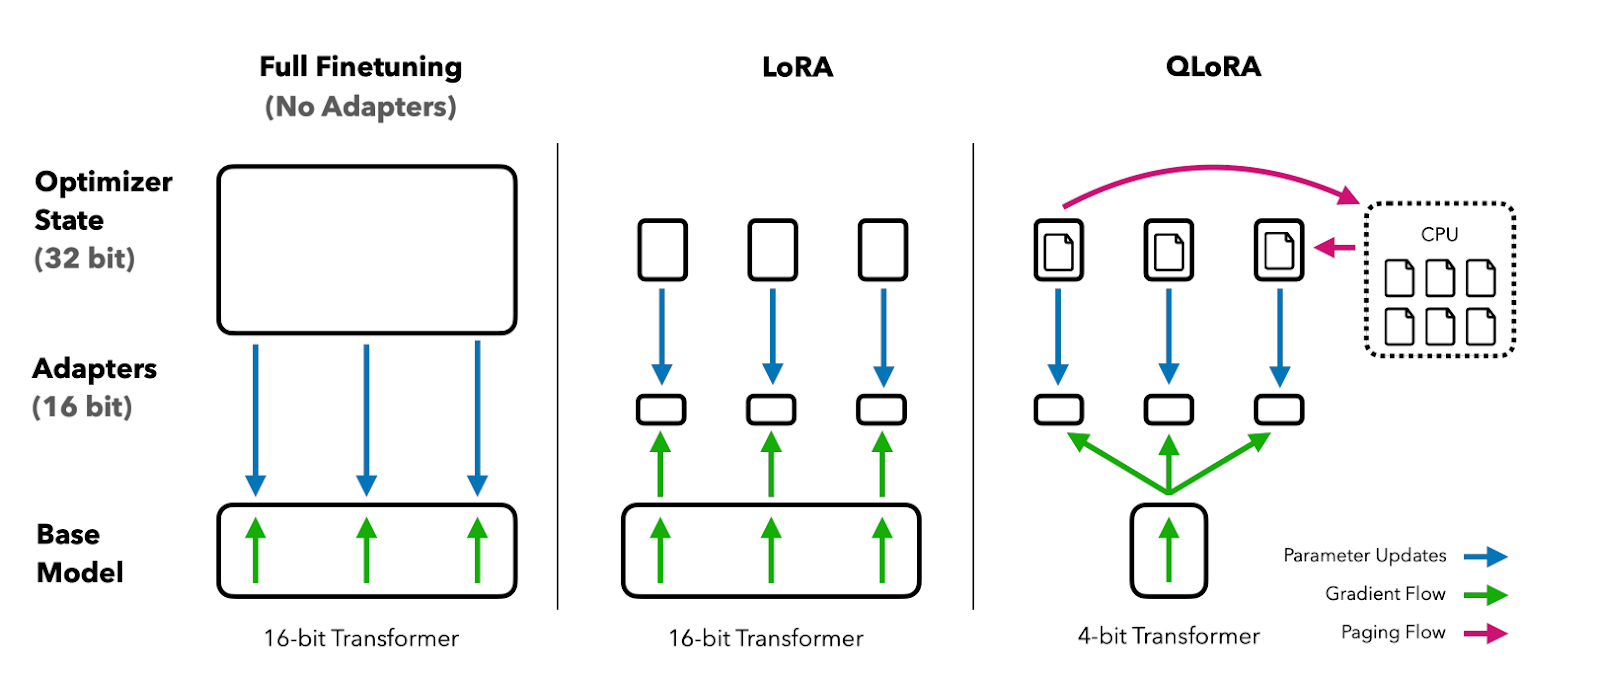
Hình ảnh từ bài báo QLoRA
Bạn có thể đọc bài báo để hiểu rõ hơn.
| Tính năng | Tinh chỉnh toàn phần | LoRA | QLoRA |
|---|---|---|---|
| Tham số được cập nhật | Tất cả tham số mô hình | Ma trận adapter nhỏ (~0,1–1%) | Ma trận adapter nhỏ (~0,1–1%) |
| Độ chính xác mô hình gốc | FP16 / BF16 | FP16 / BF16 | 4-bit (NF4) |
| VRAM cho mô hình 7B | ~60+ GB | ~16 GB | ~6–8 GB |
| Tương thích GPU người dùng | Không | Giới hạn | Có (T4, RTX 3060+) |
| Chất lượng so với tinh chỉnh toàn phần | Chuẩn tham chiếu | ~98–99% | ~96–98% |
| Tốc độ huấn luyện | Chậm nhất | Nhanh | Nhanh |
Trong trường hợp của chúng ta, ta tạo lượng tử hóa 4-bit với cấu hình kiểu NF4 bằng BitsAndBytes.
compute_dtype = getattr(torch, "float16")

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)Giờ chúng ta sẽ nạp mô hình với độ chính xác 4-bit cùng kiểu tính toán "float16" từ Hugging Face để huấn luyện nhanh hơn.
model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=quant_config,
    device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 1Tiếp theo, chúng ta sẽ nạp tokenizer từ Hugging Face và đặt padding_side là “right” để khắc phục vấn đề với fp16.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Tinh chỉnh truyền thống của các mô hình ngôn ngữ tiền huấn luyện (PLM) yêu cầu cập nhật tất cả tham số của mô hình, rất tốn kém tính toán và cần lượng dữ liệu khổng lồ.
Parameter-Efficient Fine-Tuning (PEFT) chỉ cập nhật một tập nhỏ các tham số có ảnh hưởng lớn nhất của mô hình, giúp hiệu quả hơn nhiều. Tìm hiểu về các tham số qua tài liệu chính thức của PEFT.
peft_params = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
)Dưới đây là danh sách các siêu tham số có thể dùng để tối ưu quá trình huấn luyện:
training_params = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="tensorboard"
)Tinh chỉnh có giám sát (SFT) là bước quan trọng trong học tăng cường từ phản hồi của con người (RLHF). Thư viện TRL từ HuggingFace cung cấp API dễ dùng để tạo các mô hình SFT và huấn luyện chúng trên tập dữ liệu của bạn chỉ với vài dòng mã. Thư viện đi kèm các công cụ để huấn luyện mô hình ngôn ngữ bằng học tăng cường, bắt đầu với tinh chỉnh có giám sát, sau đó là mô hình phần thưởng, và cuối cùng là tối ưu hóa chính sách tiệm cận (PPO).
Chúng ta sẽ cung cấp cho SFT Trainer mô hình, tập dữ liệu, cấu hình Lora, tokenizer và các tham số huấn luyện.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_params,
    dataset_text_field="text",
    max_seq_length=None,
    tokenizer=tokenizer,
    args=training_params,
    packing=False,
)
Chúng ta sẽ dùng .train() để tinh chỉnh mô hình Llama 2 trên tập dữ liệu mới. Mất khoảng một tiếng rưỡi để hoàn thành 1 epoch.
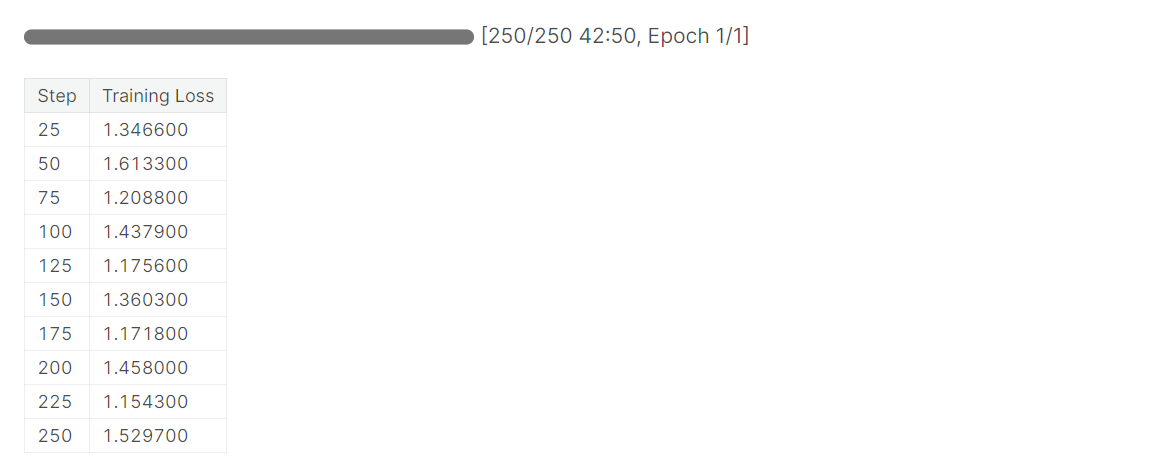
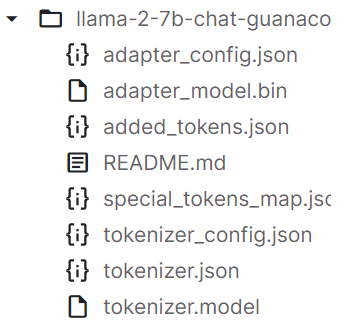
Sau khi huấn luyện mô hình, chúng ta sẽ lưu adapter của mô hình và tokenizer. Bạn cũng có thể tải mô hình lên Hugging Face bằng API tương tự.
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
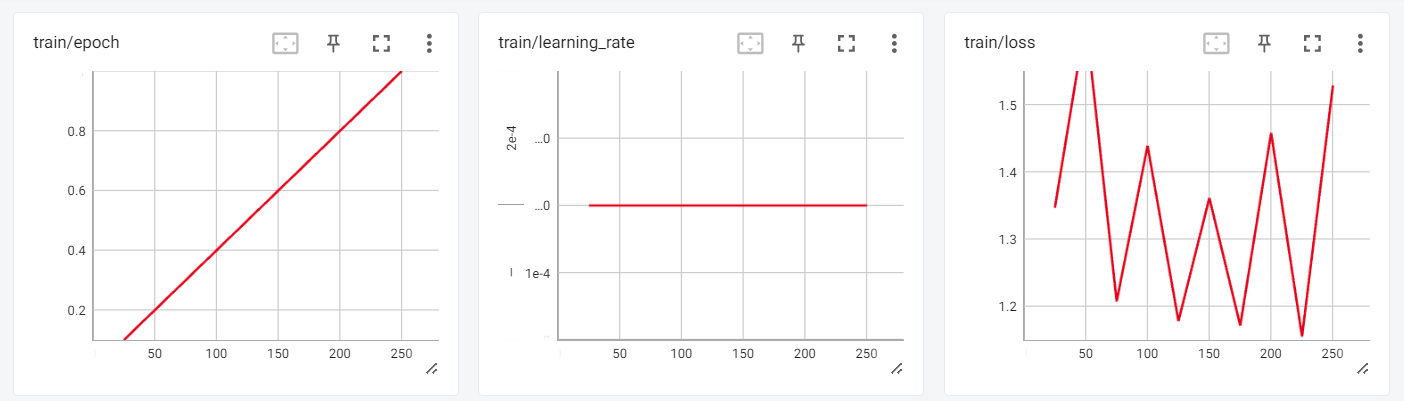
Giờ chúng ta có thể xem lại kết quả huấn luyện trong phiên tương tác của Tensorboard.
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
Để kiểm thử mô hình đã tinh chỉnh, chúng ta sẽ dùng pipeline sinh văn bản của transformers và hỏi những câu đơn giản như “Leonardo Da Vinci là ai?”.
logging.set_verbosity(logging.CRITICAL)

prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Đầu ra:
Mô hình sinh ra câu trả lời mạch lạc và chi tiết.
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.

Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.

Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.

Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
Hãy hỏi thêm một câu nữa.
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Đầu ra:
Guanaco là một tập dữ liệu chất lượng cao đã từng được dùng để tinh chỉnh các LLM tối tân trước đây. Toàn bộ tập dữ liệu Guanaco có trên Hugging Face và có tiềm năng đạt hiệu năng tốt hơn nữa trên nhiều tác vụ ngôn ngữ tự nhiên.
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.

The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.

In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.

The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.

Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in
Đây là Colab Notebook với mã và đầu ra để hỗ trợ hành trình viết mã của bạn.
Tiếp theo, bạn có thể dùng LlamaIndex và xây dựng ứng dụng AI của riêng bạn bằng mô hình vừa huấn luyện theo hướng dẫn LlamaIndex: Bổ sung dữ liệu cá nhân vào LLM. Bạn có thể tìm cảm hứng bằng cách xem 5 dự án xây dựng bằng mô hình sinh và công cụ nguồn mở.
Kể từ khi Llama 2 ra mắt vào tháng 7/2023, Meta đã phát hành một số mô hình mới với cải tiến lớn. Llama 3 (tháng 4/2024) giới thiệu bộ từ vựng 128K token lớn hơn và grouped query attention (GQA) trên mọi kích thước mô hình. Llama 3.1 (tháng 7/2024) mở rộng độ dài ngữ cảnh lên 128K token và bổ sung biến thể 405B tham số. Llama 3.2 (tháng 9/2024) mang đến khả năng đa phương thức và các mô hình nhẹ 1B/3B tối ưu cho thiết bị biên.
Hệ sinh thái tinh chỉnh cũng tiến hóa đáng kể. Các công cụ như Unsloth cho phép huấn luyện nhanh gấp 2 lần và giảm 60% bộ nhớ so với PEFT tiêu chuẩn của Hugging Face, và các công cụ giao diện như LLaMA-Factory giúp tinh chỉnh mà không cần viết mã. Các khái niệm cốt lõi QLoRA và PEFT trong hướng dẫn này vẫn là nền tảng — chúng tôi khuyến nghị khám phá các hướng dẫn về tinh chỉnh Llama 3.1 và tinh chỉnh Llama 3.2 để cập nhật cách tiếp cận mới nhất.
Trong hướng dẫn này, chúng ta đã trình bày cách tinh chỉnh mô hình LLaMA 2 bằng các kỹ thuật như QLoRA, PEFT và SFT để vượt qua hạn chế về bộ nhớ và tính toán. Bằng cách tận dụng các thư viện Hugging Face như transformers, accelerate, peft, trl và bitsandbytes, chúng ta đã tinh chỉnh thành công mô hình LLaMA 2 7B trên GPU người dùng.
Tổng thể, hướng dẫn này minh họa cách các tiến bộ gần đây đã giúp dân chủ hóa và mở rộng khả năng tiếp cận các mô hình ngôn ngữ lớn, cho phép ngay cả người đam mê cũng có thể xây dựng AI tối tân với nguồn lực hạn chế.
Để tiếp tục học, hãy tham gia khóa Fine-Tuning with Llama 3 để thực hành với các mô hình mới hơn, hoặc đào sâu hệ sinh thái dùng trong hướng dẫn này với khóa Working with Hugging Face. Với nền tảng cơ bản, hãy bắt đầu với Introduction to LLMs in Python hoặc khóa Large Language Models (LLMs) Concepts, và khám phá lộ trình kỹ năng AI Fundamentals.
Bắt đầu hành trình AI của bạn ngay hôm nay!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
