

Khóa học
Hiểu về Trí tuệ Nhân tạo
2 giờ
430.7K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleMạng nơ-ron càng sâu thì lẽ ra phải hoạt động tốt hơn. Nhưng trên thực tế, điều đó không phải lúc nào cũng đúng.
Sau một độ sâu nhất định, độ chính xác thậm chí có thể bắt đầu giảm. Không phải do mô hình bị quá khớp - mà do quá trình huấn luyện tự nó bị phá vỡ. Gradient dần biến mất trước khi tới được các lớp đầu, và những lớp đó ngừng học. Bạn có thể nghĩ rằng thêm nhiều lớp sẽ khắc phục được, nhưng thường nó chỉ làm mọi thứ tệ hơn.
ResNet giải quyết điều này bằng ý tưởng cốt lõi là kết nối bỏ qua. Thay vì buộc mọi lớp phải học từ đầu, nó cho phép mạng bỏ qua một số lớp và cộng trực tiếp đầu vào vào đầu ra.
Trong bài viết này, tôi sẽ trình bày cách ResNet hoạt động, kiến trúc của nó trông như thế nào, và vì sao nó vẫn là thuật toán ưa dùng trong học sâu hiện đại.
Muốn xem ResNet hoạt động trong thực tế? Hãy giải bài tập Phân loại ảnh với ResNet trong khuôn khổ khóa học Deep Learning cho Ảnh với PyTorch.
ResNet - viết tắt của Residual Network (Mạng Phần dư) - là một kiến trúc mạng nơ-ron được thiết kế để giúp việc huấn luyện các mạng sâu trở nên khả thi.
Ý tưởng được giới thiệu bởi Microsoft Research từ năm 2015. Thuật toán sử dụng các kết nối phần dư để vượt qua những vấn đề huấn luyện từng hạn chế mạng sâu thời đó. Ý tưởng thì đơn giản, nhưng sau phát hiện này, lần đầu tiên bạn có thể huấn luyện ổn định các mạng 50, 101 hay thậm chí 152 lớp - mà không chứng kiến hiệu năng suy giảm.
Trước ResNet, đi sâu đến vậy gần như không khả thi.
Nhiều lớp hơn đáng lẽ phải tạo nhiều cơ hội học hơn cho mạng. Trên thực tế, vượt qua một độ sâu nhất định, mọi thứ bắt đầu hỏng.
Có hai vấn đề xảy ra ở đây.
Đầu tiên là vấn đề tiêu biến gradient. Mạng nơ-ron học bằng cách truyền ngược tín hiệu sai số qua mạng - một quy trình gọi là lan truyền ngược. Mỗi lớp điều chỉnh trọng số dựa trên tín hiệu đó. Nhưng khi tín hiệu đi ngược qua nhiều lớp, nó liên tục bị nhân với các số nhỏ và co lại. Đến khi tới các lớp đầu, gần như không còn gì. Những lớp đó ngừng cập nhật, tức là ngừng học.
Thứ hai là vấn đề suy giảm. Điều này đi ngược trực giác. Bạn kỳ vọng mạng 56 lớp phải ít nhất tốt ngang mạng 20 lớp - rốt cuộc nó có dung lượng lớn hơn. Nhưng các nhà nghiên cứu lại thấy điều ngược lại. Mạng sâu hơn hoạt động kém hơn, ngay cả trên dữ liệu huấn luyện. Điều đó loại trừ nguyên nhân quá khớp. Mô hình không phải đang ghi nhớ quá nhiều. Thay vào đó, nó gặp khó khăn trong tối ưu hóa.
Đây là khác biệt then chốt. Đây không phải là vấn đề khái quát hóa mà bạn có thể sửa bằng dropout hay regularization. Đây là vấn đề tối ưu hóa - mạng không tìm được bộ trọng số tốt ngay từ đầu.
ResNet được thiết kế để giải hai vấn đề này. Hãy xem cách nó làm.
Mạng nơ-ron truyền thống cố học phép ánh xạ trực tiếp từ đầu vào đến đầu ra. Mỗi lớp nhìn vào dữ liệu vào và cố tìm xem đầu ra nên là gì. Điều đó ổn với mạng nông. Nhưng khi bạn đi sâu hơn, bạn gặp lại hai vấn đề đã bàn ở trên.
Với ResNet, thay vì yêu cầu mỗi khối học toàn bộ phép ánh xạ, nó đặt câu hỏi đơn giản hơn: tôi cần cộng gì vào đầu vào để ra đúng đầu ra?
Phần chênh lệch đó được gọi là phần dư (residual).
Vậy nên thay vì học:
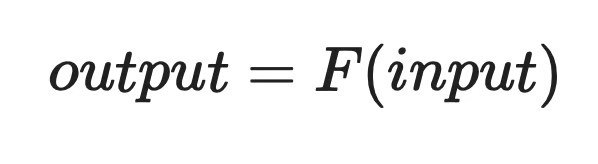
Học phần dư (1)
Mạng học:
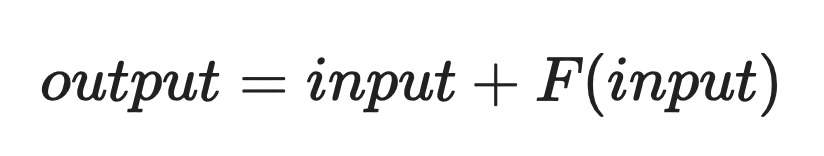
Học phần dư (2)
Trong đó F(input) là phần dư - phép hiệu chỉnh nhỏ mạng cần thực hiện. Nếu lớp không cần thay đổi gì, nó có thể đẩy F(input) về gần 0 và truyền thẳng đầu vào qua mà không đổi.
Nghe có vẻ chỉ là một chỉnh sửa nhỏ. Nhưng nó thay đổi thứ mà mạng phải học. Học một phép hiệu chỉnh nhỏ là một bài toán tối ưu dễ hơn nhiều so với học một biến đổi đầy đủ từ đầu, và đó là lý do khiến mạng sâu hơn có thể được huấn luyện.
Kết nối bỏ qua đúng như tên gọi - một đường dẫn trực tiếp bỏ qua một hoặc nhiều lớp và đưa đầu vào tới một điểm muộn hơn trong mạng.
Trong một mạng truyền thống, dữ liệu chảy qua từng lớp theo thứ tự. Mỗi lớp biến đổi đầu vào và chuyển kết quả cho lớp kế tiếp. Kết nối bỏ qua lấy đầu vào gốc và cộng trực tiếp nó vào đầu ra của một lớp ở dưới khối.
Hình dung đơn giản như sau:
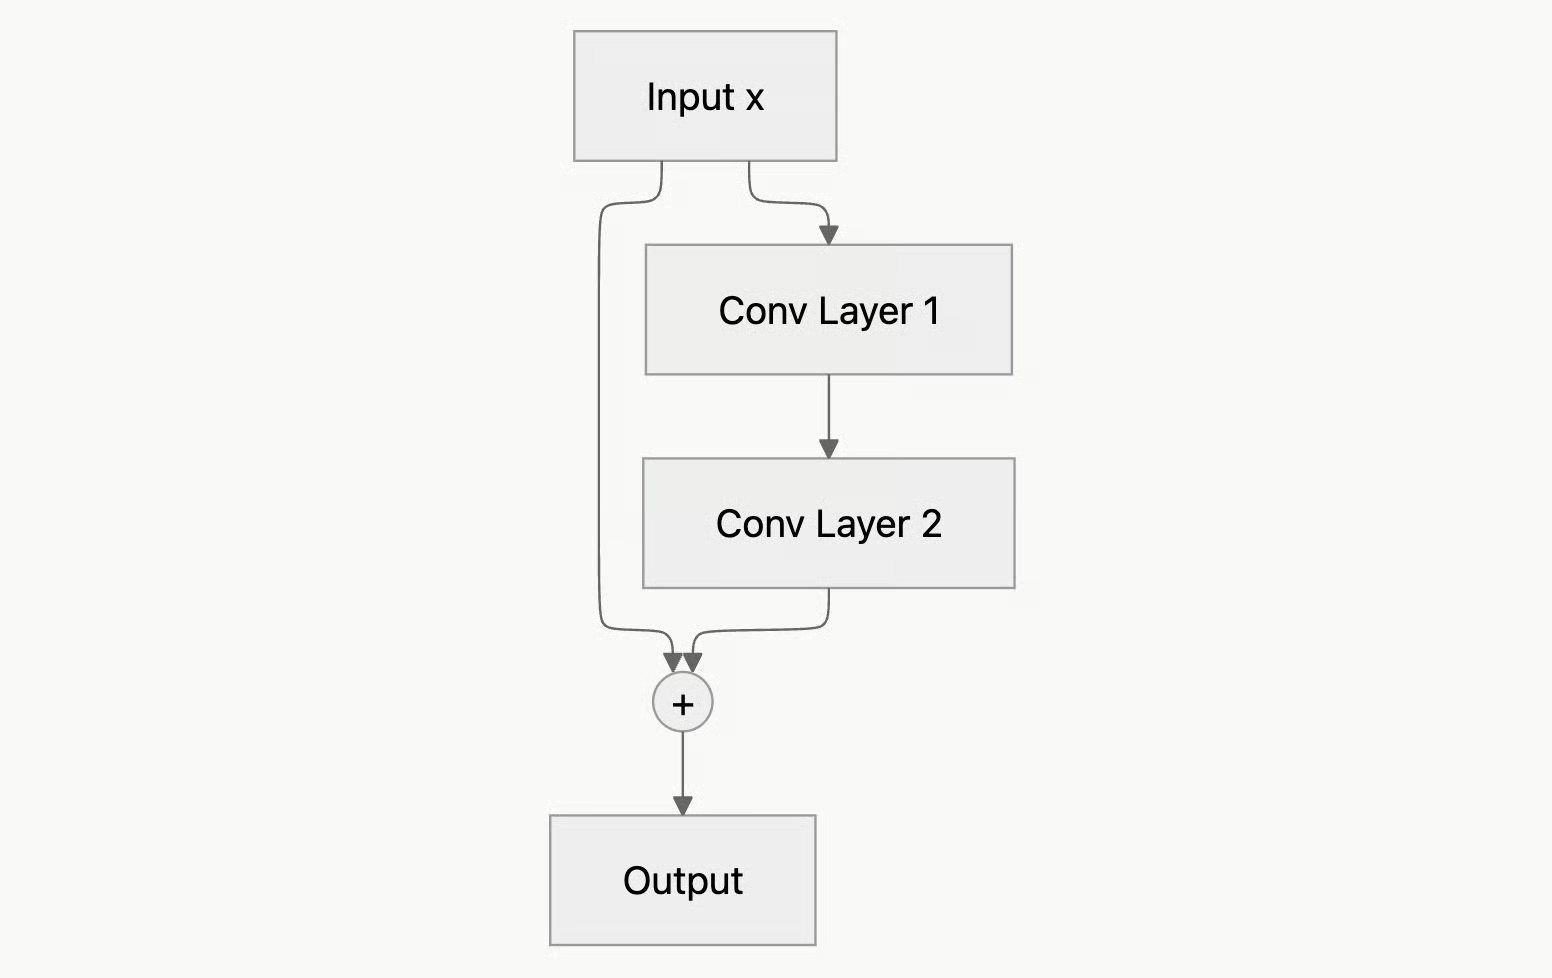
Ví dụ đồ thị kết nối bỏ qua
Đầu vào x đi theo hai nhánh cùng lúc. Một nhánh đi qua các lớp tích chập, nơi học phần dư F(x). Nhánh còn lại bỏ qua các lớp đó và nối tới bước cộng. Đầu ra cuối cùng là F(x) + x.
Lối tắt này làm một việc quan trọng cho huấn luyện. Trong lan truyền ngược, gradient có thể đi ngược qua kết nối bỏ qua mà không phải qua các lớp trung gian. Điều đó cung cấp cho các lớp đầu một tín hiệu rõ ràng, mạnh mẽ hơn để học - chính xác là thứ từng thiếu ở mạng sâu trước ResNet.
Khối phần dư là đơn vị lặp tạo nên ResNet. Hiểu một khối là bạn hiểu cả mạng.
Bên trong một khối diễn ra những gì:
Đầu vào x đi vào khối và tách thành hai nhánh
Một nhánh đi qua hai lớp tích chập, mỗi lớp theo sau là chuẩn hóa theo lô và kích hoạt ReLU
Nhánh còn lại bỏ qua các lớp đó - đây là kết nối bỏ qua
Hai nhánh gặp nhau tại bước cộng, nơi đầu vào gốc được cộng vào đầu ra của các lớp tích chập
Áp dụng kích hoạt ReLU cuối cùng lên kết quả
Hoặc dưới dạng sơ đồ:
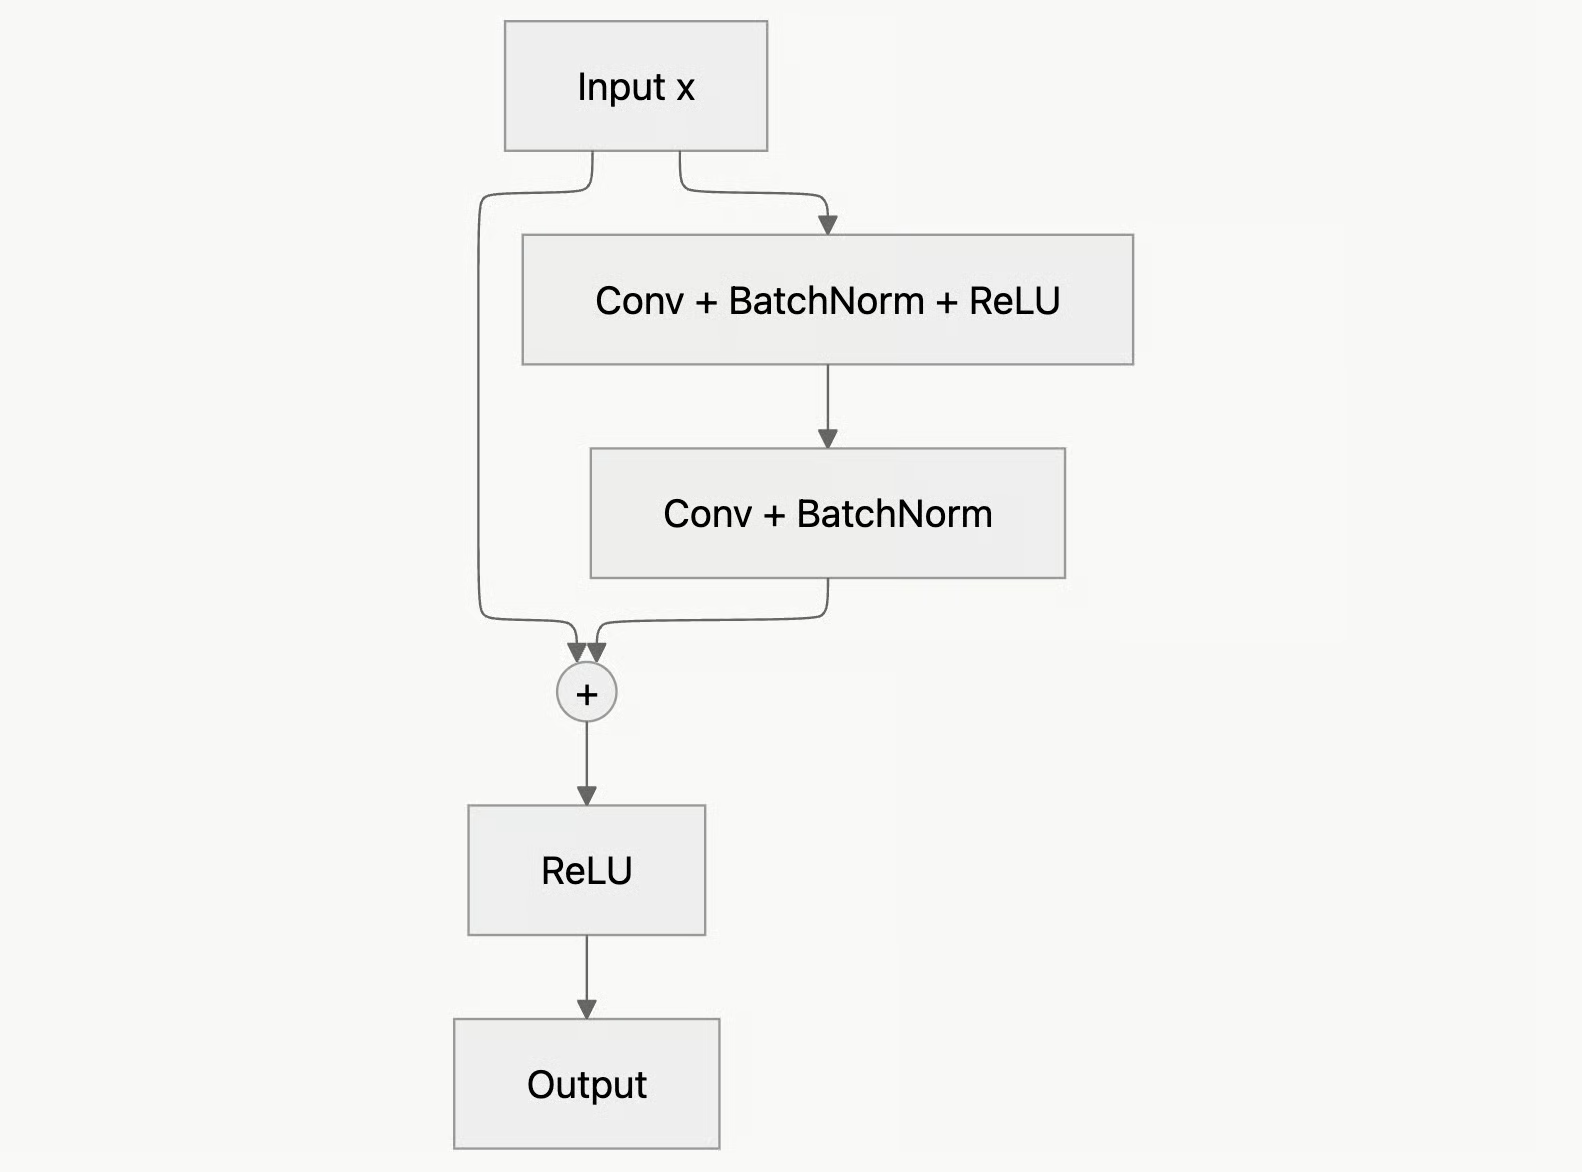
Sơ đồ khối ResNet
Kết nối bỏ qua ở đây được gọi là ánh xạ đồng nhất (identity mapping) - đầu vào đi qua mà không đổi và được cộng trực tiếp vào đầu ra đã học. Đây là lối tắt đơn giản nhất, không biến đổi và không thêm tham số.
Nhưng để phép cộng hoạt động, cả hai nhánh phải tạo ra tensor cùng kích thước. Nếu các lớp tích chập thay đổi kích thước không gian hoặc số kênh, đầu vào x không thể cộng được. Khi đó, ResNet dùng lối tắt chiếu (projection shortcut) - một tích chập 1×1 trên nhánh bỏ qua để biến đổi x cho khớp.
Hầu hết các khối trong ResNet dùng lối tắt đồng nhất. Lối tắt chiếu chỉ xuất hiện khi kích thước thay đổi, thường là khi mạng chuyển giữa các giai đoạn.
ResNet có một vài biến thể chuẩn, mỗi loại được đặt tên theo tổng số lớp. Lựa chọn đúng phụ thuộc vào mục tiêu của bạn - tốc độ, độ chính xác, hay cân bằng giữa hai yếu tố.
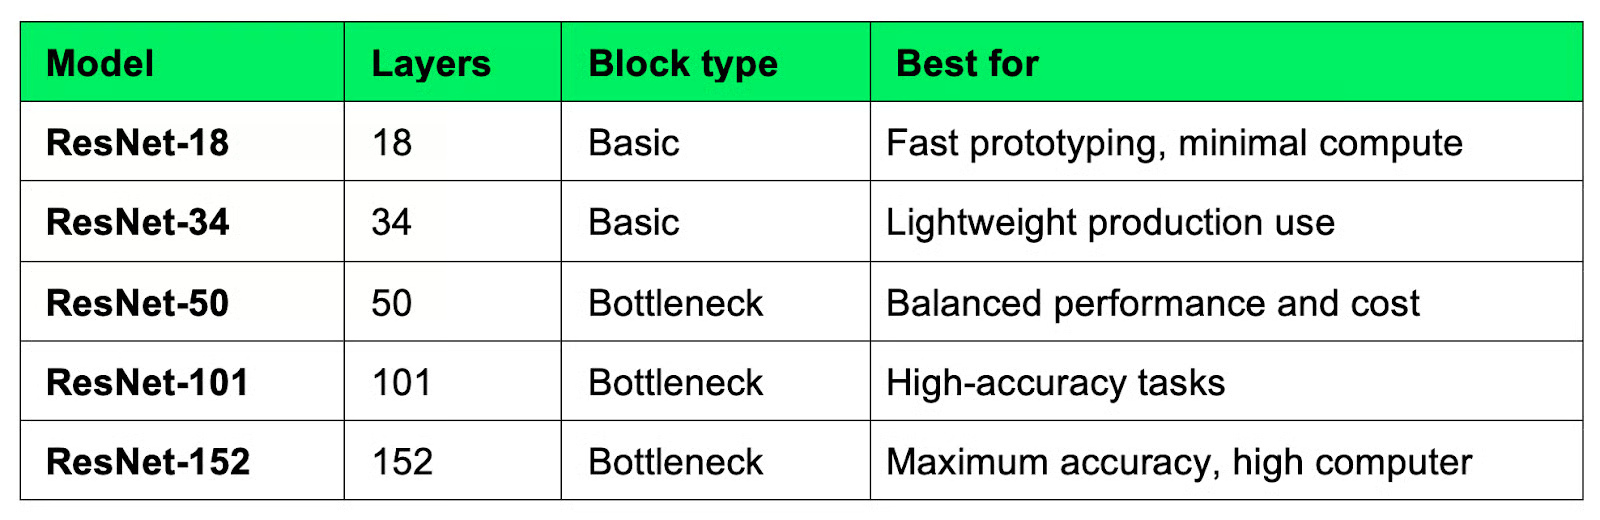
So sánh kiến trúc ResNet
ResNet-18 và ResNet-34 dùng khối cơ bản tiêu chuẩn - hai lớp tích chập 3×3 với một kết nối bỏ qua. Chúng chạy nhanh và rẻ, phù hợp khi bạn thử nghiệm nhanh hoặc phần cứng hạn chế.
ResNet-50 trở lên chuyển sang thiết kế khác gọi là khối cổ chai (bottleneck), sử dụng ba lớp thay vì hai. Thay đổi này giúp mạng sâu hơn dễ huấn luyện mà không làm chi phí tính toán tăng tỷ lệ thuận. Bạn sẽ đọc thêm cách nó hoạt động ở phần tiếp theo.
ResNet-101 và ResNet-152 tiến thêm một bước nữa với chi phí thời gian huấn luyện dài hơn và dùng bộ nhớ cao hơn. Chúng phổ biến trong nghiên cứu và các hệ thống sản xuất nơi độ chính xác quan trọng hơn tốc độ.
Trong hầu hết công việc thực tế, ResNet-50 là điểm khởi đầu mặc định. Nó cân bằng tốt giữa độ sâu và chi phí, và được hỗ trợ tốt trên mọi framework học sâu lớn.
Các ResNet sâu hơn không dùng cùng thiết kế khối như loại nông. Bắt đầu từ ResNet-50, kiến trúc chuyển sang khối cổ chai, một thiết kế ba lớp giúp giữ chi phí tính toán ở mức kiểm soát khi độ sâu tăng.
Khối dùng ba tích chập nối tiếp nhau:
Hai tích chập 1×1 đầu và cuối đóng vai trò cổ chai - vì thế có tên gọi này. Chúng nén dữ liệu trước khi tích chập 3×3 tốn kém chạy, rồi khôi phục sau đó.
Một tích chập 3×3 trên đầu vào có số kênh lớn rất tốn tính toán. Bằng cách giảm kênh trước, khối cổ chai cho phép lớp 3×3 làm việc trên đầu vào nhỏ hơn nhiều. Kết quả là một khối có thể sâu hơn mà không tăng chi phí tính toán theo tỷ lệ.
Kết nối bỏ qua hoạt động giống hệt như trong khối cơ bản - đầu vào được cộng vào đầu ra trước kích hoạt cuối. Khác biệt duy nhất là ở đây gần như luôn cần lối tắt chiếu, vì số kênh thay đổi bên trong khối.
Vấn đề tiêu biến gradient là câu chuyện khoảng cách. Gradient phải đi qua mạng càng xa thì càng co lại - và khi tới các lớp đầu, không còn đủ để học.
Kết nối bỏ qua vượt qua vấn đề này bằng cách cho gradient một con đường ngắn hơn.
Trong lan truyền ngược, gradient không phải đi qua mọi lớp theo thứ tự. Chúng có thể đi ngược qua kết nối bỏ qua trực tiếp, hoàn toàn lướt qua các lớp tích chập. Lối tắt đó giữ gradient đủ lớn để thực sự cập nhật các lớp đầu.
Điều này cũng thay đổi thứ mỗi khối phải học. Thay vì tìm một biến đổi đầy đủ từ đầu, mạng chỉ cần học một hiệu chỉnh nhỏ trên đầu vào. Đó là bài toán tối ưu dễ hơn nhiều, và cho phép mạng đi sâu hơn mà việc huấn luyện không trở nên bất ổn.
Tóm lại, những mạng trước đây quá sâu để huấn luyện ổn định nay trở nên khả huấn.
CNN truyền thống và ResNet đều học đặc trưng từ ảnh, nhưng cách tiếp cận khác nhau.
Trong CNN truyền thống, dữ liệu chảy qua các lớp theo một đường thẳng. Mỗi lớp nhận đầu ra của lớp trước, áp dụng biến đổi, rồi truyền tiếp. Cách đó hoạt động tốt đến một mức nào đó. Khi vượt quá một độ sâu nhất định, cấu trúc tuần tự trở nên kém tin cậy trong lan truyền ngược - gradient co lại, các lớp đầu ngừng học, và độ chính xác bắt đầu giảm.
ResNet không đi theo đường thẳng. Kết nối bỏ qua cho phép đầu vào vượt qua một hoặc nhiều lớp và được cộng trực tiếp vào đầu ra ở dưới khối. Mạng vẫn học các biến đổi, nhưng cũng có một đường dẫn trực tiếp cho cả dữ liệu và gradient đi qua.
So sánh hai cách tiếp cận như sau:
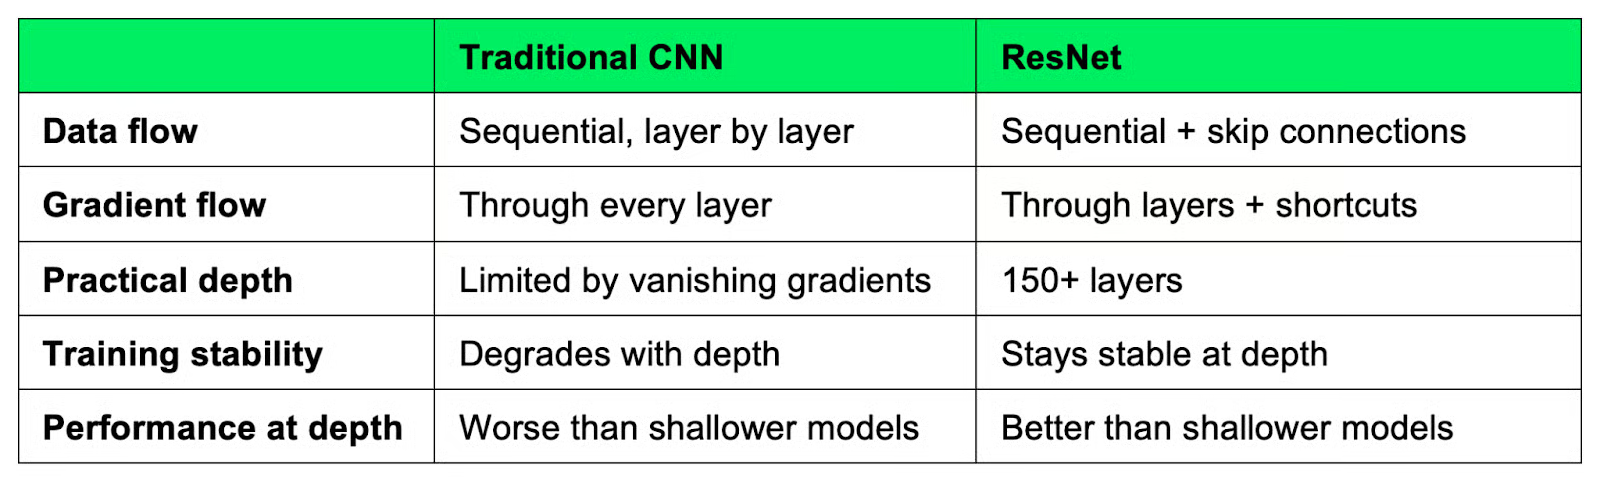
ResNet so với CNN truyền thống
Các kết nối bỏ qua vừa giúp gradient, vừa làm quá trình tối ưu mượt mà hơn, nghĩa là mạng tìm được trọng số tốt nhanh và tin cậy hơn.
Kiến trúc ResNet xuất hiện trong nhiều bài toán thực tế đa dạng.
Phân loại ảnh là nơi ResNet khởi đầu. Nó giành chiến thắng ở ImageNet Large Scale Visual Recognition Challenge năm 2015, và đến nay vẫn là lựa chọn hàng đầu để phân loại ảnh theo danh mục, từ ảnh y khoa, ảnh vệ tinh, đến ảnh sản phẩm.
Phát hiện đối tượng thường dùng ResNet. Các khung như Faster R-CNN và Mask R-CNN kết hợp ResNet với đầu phát hiện để nhận diện và định vị đối tượng trong ảnh. ResNet đảm nhiệm trích xuất đặc trưng, còn đầu phát hiện lo phần còn lại.
Học chuyển giao là nơi ResNet thực sự hữu ích với hầu hết nhà khoa học dữ liệu. Thay vì huấn luyện từ đầu - tốn nhiều ngày và nhiều dữ liệu - bạn tải một ResNet đã được huấn luyện trước trên ImageNet và tinh chỉnh trên bộ dữ liệu của bạn. Trọng số pretrained đã mã hóa các đặc trưng mức thấp hữu ích như cạnh, kết cấu, hình dạng, nên bạn xuất phát ở vị trí thuận lợi hơn nhiều.
Trích xuất đặc trưng cũng tương tự. Bạn chạy ảnh qua một ResNet pretrained và lấy đầu ra từ một trong các lớp sau. Những đầu ra đó là các biểu diễn dày đặc, có ý nghĩa của ảnh mà bạn có thể đưa vào một bộ phân loại hay thuật toán phân cụm đơn giản hơn.
Trong tất cả các trường hợp này, ResNet đóng vai trò điểm khởi đầu pretrained. Hầu hết các framework học sâu đều đi kèm trọng số ResNet pretrained, khiến nó trở thành một trong những kiến trúc dễ bắt đầu nhất.
ResNet là một bước tiến thực sự trong học sâu - nhưng như mọi kiến trúc khác, nó có đánh đổi. Hãy điểm qua một vài ưu và nhược điểm.
Rõ ràng nhất là độ sâu. Kết nối bỏ qua cho phép huấn luyện các mạng với 50, 100, thậm chí hơn 150 lớp mà không gặp vấn đề suy giảm. Điều này trước ResNet không thể làm ổn định được.
Huấn luyện cũng ổn định hơn. Các đường tắt cung cấp cho gradient một lộ trình sạch ngược qua mạng, đồng nghĩa ít phải tinh chỉnh, ít sập mô hình, và kết quả dự đoán hơn trên các tác vụ và bộ dữ liệu khác nhau.
Và hiệu năng cũng là một ưu điểm. Các biến thể ResNet liên tục xếp hạng tốt trên các benchmark ảnh, và các mô hình ResNet pretrained chuyển giao tốt sang miền mới, đó là lý do chúng vẫn là điểm khởi đầu mặc định cho rất nhiều dự án thị giác máy tính.
ResNet nặng về tính toán. Các biến thể sâu như ResNet-101 và ResNet-152 cần nhiều bộ nhớ và năng lực xử lý, có thể là rào cản khi phần cứng hạn chế hoặc cần suy luận nhanh.
Nó cũng không phải lựa chọn tốt nhất cho mọi tác vụ. Với bộ dữ liệu nhỏ hoặc bài toán đơn giản, một kiến trúc nhẹ hơn thường cho kết quả tương đương với chi phí chỉ bằng một phần nhỏ. Chọn ResNet-50 theo mặc định không phải lúc nào cũng đúng.
Và trong một số lĩnh vực, ResNet đã bị thay thế. Các kiến trúc như EfficientNet đạt độ chính xác tốt hơn trên mỗi tham số cho các tác vụ ảnh, và transformer đã chiếm lĩnh ở những nơi khác. ResNet vẫn được dùng rộng rãi, nhưng không còn là lựa chọn nghiêm túc duy nhất.
Mười một năm sau khi ra mắt, kiến trúc ResNet vẫn đứng vững. Điều này không phổ biến trong học sâu.
Phần lớn người thực hành vẫn chọn ResNet khi cần một đường cơ sở đáng tin cậy cho tác vụ thị giác máy tính. Nó được hiểu rõ, được hỗ trợ tốt trên mọi framework lớn, và trọng số pretrained sẵn có trong mọi thư viện chính. Vì vậy, khi bạn cần thứ gì đó hoạt động mà không cần thử nghiệm quá nhiều, ResNet thường là lựa chọn đầu tiên bạn thử.
Nhưng ảnh hưởng của nó còn vượt ra ngoài các biến thể của chính nó.
Ý tưởng cốt lõi của ResNet - rằng bạn có thể thêm lối tắt quanh các lớp để giúp thông tin và gradient lưu thông - hóa ra rất hữu ích rộng rãi. DenseNet cải tiến ý tưởng đó bằng cách nối mọi lớp với mọi lớp khác, không chỉ bỏ qua một hai lớp. Và dù transformer có kiến trúc khác, các kết nối phần dư bên trong mỗi khối transformer tuân theo cùng nguyên lý mà ResNet giới thiệu.
Các kiến trúc mới hơn như EfficientNet, ConvNeXt và vision transformer đã đẩy hiệu năng xa hơn ở những mảng cụ thể. Nhưng chúng không thay thế ResNet mà đúng hơn là xây dựng dựa trên nền tảng ResNet đặt ra.
Kiến trúc ResNet xoay quanh một điều: kết nối bỏ qua. Ý tưởng đó giải quyết hai vấn đề từng kìm hãm mạng sâu - tiêu biến gradient và vấn đề suy giảm - và khiến việc huấn luyện mạng ở độ sâu trước đây là bất khả thi trở nên thực tế.
Ý tưởng thêm lối tắt giữa các lớp nay đã trở thành khối xây dựng tiêu chuẩn trong học sâu hiện đại, xuất hiện trong DenseNet, transformer và hầu hết kiến trúc xây sau năm 2015.
Nếu bạn đang làm một bài toán thị giác máy tính ngày nay, ResNet vẫn là điểm khởi đầu vững chắc. Nó không phải lựa chọn mới nhất, nhưng là một trong những lựa chọn đáng tin cậy nhất. Hãy coi nó là đường cơ sở - bạn sẽ ngạc nhiên vì nó vẫn có thể vượt qua đối thủ vào năm 2026.
Nếu bạn mới học học sâu nhưng đã biết các nền tảng Python, hãy khám phá khóa Giới thiệu TensorFlow bằng Python của chúng tôi - khóa này sẽ giúp bạn bắt đầu với các chủ đề như ResNet chỉ trong một cuối tuần.
Học với DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google