

कोर्स
Understanding Artificial Intelligence
2 घंटा
430.7K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंगहरे न्यूरल नेटवर्क्स को बेहतर प्रदर्शन करना चाहिए। लेकिन व्यवहार में, ऐसा हमेशा नहीं होता।
एक निश्चित गहराई के बाद, सटीकता वास्तव में घटने लगती है। वजह ओवरफिटिंग नहीं—खुद प्रशिक्षण टूटने लगता है। ग्रेडिएंट्स शुरुआती लेयर्स तक पहुंचने से पहले ही गायब होने लगते हैं, और वे लेयर्स सीखना बंद कर देती हैं। आप मानेंगे कि और लेयर्स जोड़ने से समस्या सुलझ जाएगी, लेकिन इससे अक्सर समस्या और बढ़ जाती है।
ResNet ने इसे स्किप कनेक्शंस की मूल अवधारणा से ठीक किया। हर लेयर को शून्य से सीखने के लिए मजबूर करने के बजाय, यह नेटवर्क को लेयर्स को स्किप करने देता है और इनपुट को सीधे आउटपुट में जोड़ देता है।
इस लेख में, मैं बताऊंगा कि ResNet कैसे काम करता है, इसका आर्किटेक्चर कैसा दिखता है, और यह आधुनिक डीप लर्निंग में अब भी क्यों एक पसंदीदा एल्गोरिदम है।
क्या आप ResNet को व्यवहार में देखना चाहते हैं? हमारे Image classification with ResNet अभ्यास को Deep Learning for Images with PyTorch कोर्स के हिस्से के रूप में हल करें।
ResNet—जिसका अर्थ Residual Network है—एक ऐसा न्यूरल नेटवर्क आर्किटेक्चर है जिसे गहरे नेटवर्क्स का प्रशिक्षण व्यावहारिक बनाने के लिए डिज़ाइन किया गया है।
यह विचार 2015 में Microsoft Research ने प्रस्तुत किया था। एल्गोरिदम ने रेज़िडुअल कनेक्शंस का उपयोग उन प्रशिक्षण समस्याओं से निपटने के लिए किया जो उस समय गहरे नेटवर्क्स को सीमित करती थीं। विचार सरल था, लेकिन खोज के बाद, आप पहली बार 50, 101, या यहां तक कि 152 लेयर्स वाले नेटवर्क्स को विश्वसनीय रूप से प्रशिक्षित कर सकते थे—बिना प्रदर्शन घटते हुए देखे।
ResNet से पहले, इतनी गहराई तक जाना वास्तव में विकल्प नहीं था।
और अधिक लेयर्स का अर्थ होना चाहिए कि नेटवर्क के सीखने के अधिक अवसर मिलेंगे। व्यवहार में, एक निश्चित गहराई के बाद चीजें टूटने लगती हैं।
यहां दो समस्याएं काम कर रही हैं।
पहली है vanishing gradient समस्या। न्यूरल नेटवर्क्स त्रुटि संकेतों को नेटवर्क में पीछे की ओर भेजकर सीखते हैं—इसे backpropagation कहते हैं। हर लेयर उस संकेत के आधार पर अपने वज़न समायोजित करती है। लेकिन जैसे-जैसे संकेत कई लेयर्स से होकर वापस जाता है, वह बार-बार छोटे संख्याओं से गुणा होता रहता है और सिकुड़ता जाता है। जब तक वह शुरुआती लेयर्स तक पहुंचता है, तब तक लगभग कुछ नहीं बचता। वे लेयर्स अपडेट होना बंद कर देती हैं, यानी सीखना बंद हो जाता है।
दूसरी है degradation समस्या। यह थोड़ा प्रतिकूल प्रतीत होता है। आप उम्मीद करेंगे कि 56-लेयर वाला नेटवर्क कम से कम 20-लेयर वाले जितना अच्छा तो होगा—आखिरकार उसकी क्षमता अधिक है। लेकिन शोधकर्ताओं ने पाया कि उल्टा होता है। गहरा नेटवर्क और भी खराब प्रदर्शन करता है, यहां तक कि ट्रेनिंग डेटा पर भी। इसका अर्थ है कि कारण ओवरफिटिंग नहीं है। मॉडल बहुत कुछ याद नहीं कर रहा, बल्कि उसे ऑप्टिमाइज़ करने में दिक्कत हो रही है।
यही मुख्य अंतर है। ये ऐसी जनरलाइज़ेशन समस्याएं नहीं हैं जिन्हें आप ड्रॉपआउट या रेग्युलराइज़ेशन से ठीक कर सकें। ये ऑप्टिमाइज़ेशन की समस्याएं हैं—नेटवर्क शुरुआत में ही अच्छे वज़न खोज नहीं पा रहा है।
ResNets इन दोनों समस्याओं को हल करने के लिए बनाए गए थे। आइए देखें कैसे।
पारंपरिक न्यूरल नेटवर्क्स इनपुट से आउटपुट तक का प्रत्यक्ष मैपिंग सीखने की कोशिश करते हैं। हर लेयर यह देखती है कि क्या आया है और अनुमान लगाती है कि क्या निकलना चाहिए। उथले नेटवर्क्स के लिए यह ठीक काम करता है। लेकिन जैसे-जैसे आप गहराई में जाते हैं, आप ऊपर बताई गई दो समस्याओं से टकराते हैं।
ResNet में, हर ब्लॉक से पूरी मैपिंग सीखने के बजाय एक सरल सवाल पूछा जाता है: सही आउटपुट पाने के लिए मुझे इनपुट में क्या जोड़ना है?
इस अंतर को residual कहा जाता है।
तो यह सीखने के बजाय:
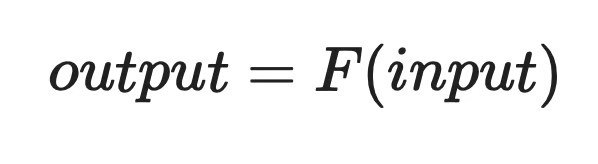
Residual learning (1)
नेटवर्क यह सीखता है:
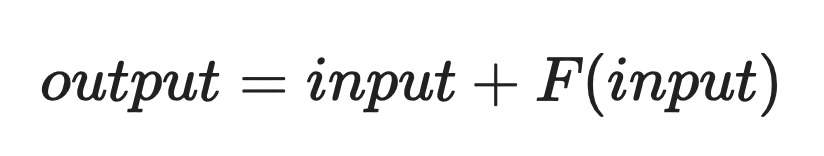
Residual learning (2)
जहां F(input) रेज़िडुअल है—वह छोटी-सी सुधारात्मक मात्रा जिसे नेटवर्क को जोड़ना है। यदि लेयर को कुछ बदलने की ज़रूरत नहीं है, तो वह F(input) को शून्य की ओर धकेल सकती है और इनपुट को जस का तस पास कर सकती है।
यह एक छोटा बदलाव लग सकता है। लेकिन यह नेटवर्क को सीखने वाली चीज़ बदल देता है। छोटे सुधार को सीखना, शून्य से पूरी ट्रांसफॉर्मेशन सीखने की तुलना में बहुत आसान ऑप्टिमाइज़ेशन समस्या है, और यही गहरे नेटवर्क्स को ट्रेन करने योग्य बनाता है।
स्किप कनेक्शन वही है जैसा यह सुनाई देता है—एक सीधा रास्ता जो एक या अधिक लेयर्स को बायपास करता है और इनपुट को नेटवर्क में आगे के किसी बिंदु पर फीड करता है।
पारंपरिक नेटवर्क में, डेटा क्रम से हर लेयर से होकर गुजरता है। हर लेयर इनपुट को ट्रांसफॉर्म करती है और परिणाम को अगली लेयर को पास कर देती है। स्किप कनेक्शंस मूल इनपुट को लेते हैं और उसे ब्लॉक में नीचे स्थित किसी लेयर के आउटपुट में सीधे जोड़ देते हैं।
इसे समझने का एक सरल तरीका यह है:
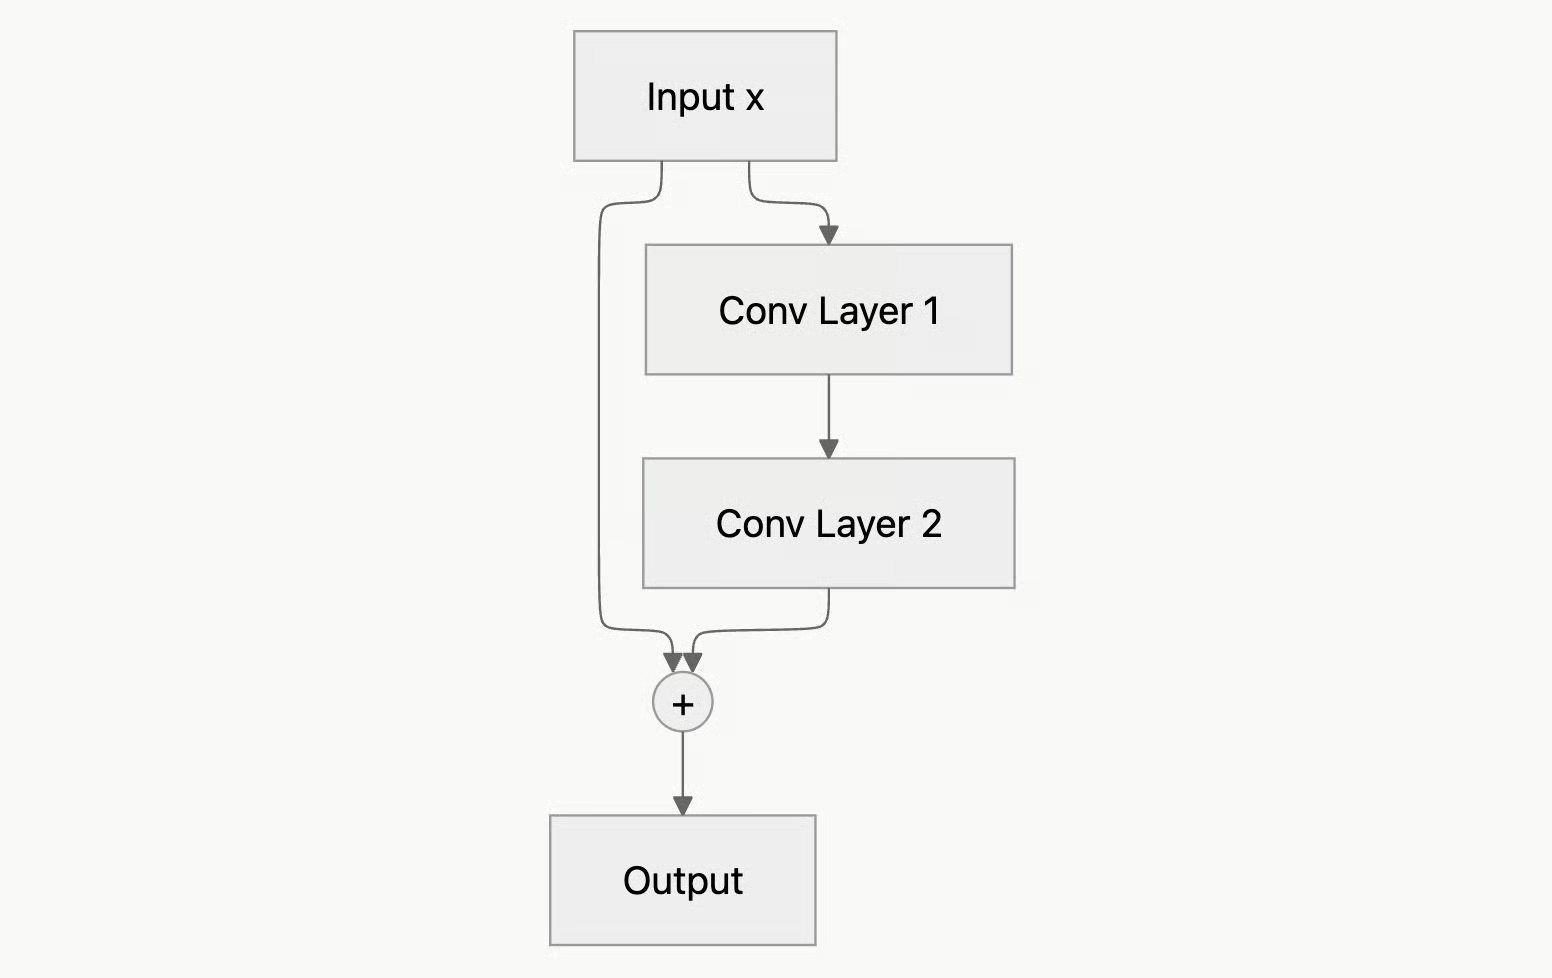
Skip connection graph example
इनपुट x एक साथ दो रास्तों से चलता है। एक रास्ता कन्वॉल्यूशनल लेयर्स से होकर जाता है, जो रेज़िडुअल F(x) सीखती हैं। दूसरा रास्ता उन लेयर्स को स्किप करता है और addition स्टेप से जुड़ता है। अंतिम आउटपुट F(x) + x होता है।
यह शॉर्टकट प्रशिक्षण के लिए महत्वपूर्ण काम करता है। बैकप्रोपेगेशन के दौरान, ग्रेडिएंट्स स्किप कनेक्शन से वापस जा सकते हैं, बिना बीच की लेयर्स से होकर गुजरे। इससे शुरुआती लेयर्स को एक साफ़, मजबूत सिग्नल मिलता है—जो ResNet से पहले गहरे नेटवर्क्स में कमी थी।
एक रेज़िडुअल ब्लॉक वही दोहराया जाने वाला यूनिट है जिससे ResNet बनता है। यदि आप एक ब्लॉक समझते हैं, तो आप पूरे नेटवर्क को समझते हैं।
एक सिंगल ब्लॉक के अंदर क्या हो रहा है:
इनपुट x ब्लॉक में प्रवेश करता है और दो रास्तों में बंट जाता है
एक रास्ता दो कन्वॉल्यूशनल लेयर्स से होकर जाता है, जिनके बाद बैच नॉर्मलाइज़ेशन और ReLU एक्टिवेशन होता है
दूसरा रास्ता उन लेयर्स को स्किप करता है—यही स्किप कनेक्शन है
दोनों रास्ते addition स्टेप पर मिलते हैं, जहां मूल इनपुट को कन्वॉल्यूशनल लेयर्स के आउटपुट में जोड़ दिया जाता है
अंत में एक ReLU एक्टिवेशन लगाया जाता है
या डायग्राम के रूप में:
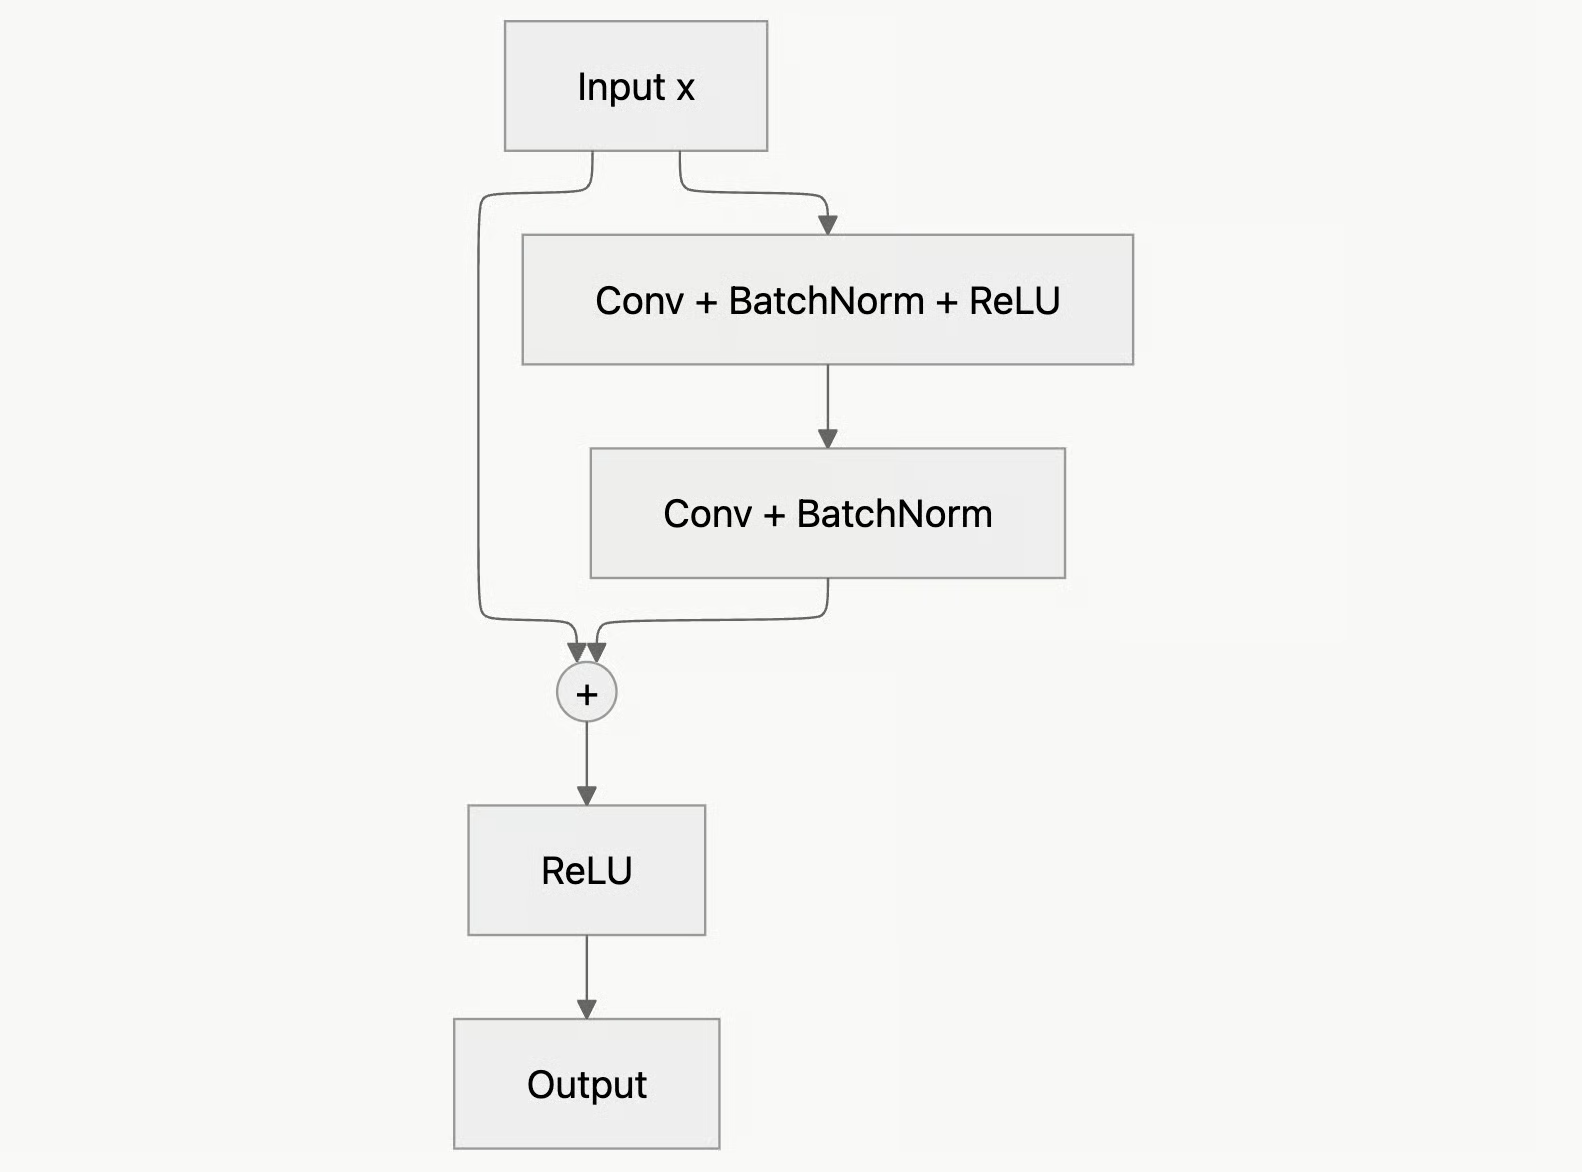
ResNet block diagram
यहां स्किप कनेक्शन को identity mapping कहा जाता है—इनपुट बिना बदले गुजरता है और सीधा सीखे गए आउटपुट में जोड़ दिया जाता है। यह संभवतः सबसे सरल शॉर्टकट है—कोई ट्रांसफॉर्मेशन नहीं और कोई अतिरिक्त पैरामीटर नहीं।
लेकिन addition के काम करने के लिए, दोनों रास्तों को समान आकार के टेंसर उत्पन्न करने चाहिए। यदि कन्वॉल्यूशनल लेयर्स स्थानिक डायमेंशंस या चैनलों की संख्या बदलती हैं, तो इनपुट x को जोड़ा नहीं जा सकता। ऐसे मामलों में, ResNet एक projection शॉर्टकट लगाता है—स्किप पाथ पर 1×1 कन्वॉल्यूशन जो x को मेल खाने के लिए रीशेप करता है।
ResNet के अधिकांश ब्लॉक्स identity शॉर्टकट्स का उपयोग करते हैं। Projection शॉर्टकट्स केवल तब दिखते हैं जब डायमेंशंस बदलते हैं, आमतौर पर जब नेटवर्क स्टेजेस के बीच आगे बढ़ता है।
ResNet कुछ मानक वेरिएंट्स में आता है, जिनका नाम उनकी कुल लेयर्स की संख्या पर होता है। सही विकल्प इस पर निर्भर करता है कि आप किसके लिए ऑप्टिमाइज़ कर रहे हैं—गति, सटीकता, या दोनों के बीच संतुलन।
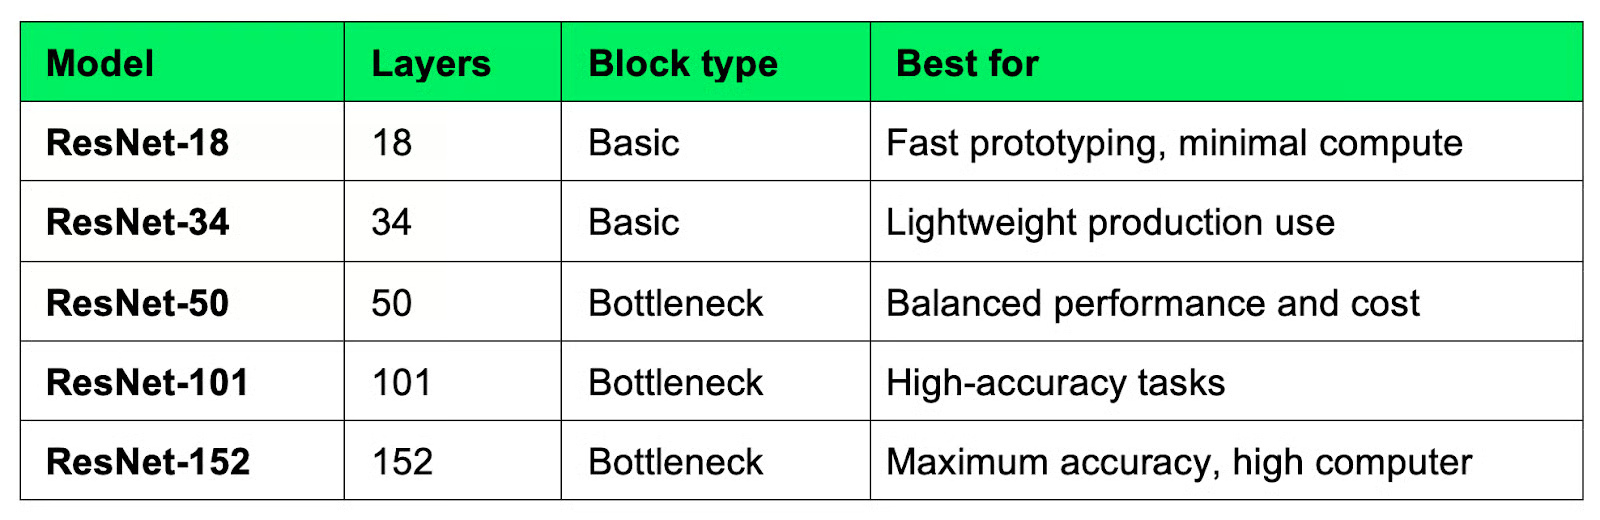
ResNet architecture comparison
ResNet-18 और ResNet-34 मानक बेसिक ब्लॉक का उपयोग करते हैं—दो 3×3 कन्वॉल्यूशनल लेयर्स के साथ एक स्किप कनेक्शन। ये तेज़ हैं और चलाने में सस्ते, इसलिए प्रोटोटाइपिंग या सीमित हार्डवेयर पर काम करते समय ये अच्छे शुरुआती विकल्प हैं।
ResNet-50 और उससे ऊपर के वेरिएंट्स एक अलग डिज़ाइन अपनाते हैं जिसे bottleneck ब्लॉक कहते हैं, जो दो की बजाय तीन लेयर्स का उपयोग करता है। यह बदलाव गहरे नेटवर्क्स को बिना अनुपातिक कंप्यूट लागत बढ़ाए ट्रेन करना आसान बनाता है। यह कैसे काम करता है, इसके बारे में आप अगले सेक्शन में और पढ़ेंगे।
ResNet-101 और ResNet-152 एक कदम और आगे जाते हैं—लंबे प्रशिक्षण समय और अधिक मेमोरी की कीमत पर। ये शोध में और उन प्रोडक्शन सिस्टम्स में आम हैं जहां गति से अधिक सटीकता महत्वपूर्ण होती है।
अधिकांश व्यावहारिक कार्यों के लिए, ResNet-50 डिफ़ॉल्ट शुरुआती बिंदु है। इसमें गहराई और लागत के बीच अच्छा संतुलन है, और यह हर बड़े डीप लर्निंग फ्रेमवर्क में अच्छी तरह सपोर्टेड है।
गहरे ResNets उथले वेरिएंट्स जैसा ब्लॉक डिज़ाइन इस्तेमाल नहीं करते। ResNet-50 से शुरू होकर, आर्किटेक्चर बॉटलनेक ब्लॉक पर स्विच करता है—यह तीन-लेयर वाला डिज़ाइन है जो गहराई बढ़ने पर भी गणना को प्रबंधनीय रखता है।
ब्लॉक तीन कन्वॉल्यूशंस को क्रम में उपयोग करता है:
पहला और आखिरी 1×1 कन्वॉल्यूशन बॉटलनेक का काम करते हैं—यहीं से नाम आया। वे महंगे 3×3 कन्वॉल्यूशन से पहले डेटा को कंप्रेस करते हैं, फिर बाद में उसे पुनर्स्थापित करते हैं।
उच्च-चैनल इनपुट पर 3×3 कन्वॉल्यूशन कम्प्यूटेशनली भारी होता है। पहले चैनल्स घटाकर, बॉटलनेक ब्लॉक 3×3 लेयर को बहुत छोटे इनपुट पर काम करने देता है। परिणामस्वरूप ब्लॉक गहराई में जाता है, बिना कंप्यूट लागत में अनुपातिक उछाल के।
स्किप कनेक्शन यहां भी उसी तरह काम करता है जैसे बेसिक ब्लॉक में—अंतिम एक्टिवेशन से पहले इनपुट को आउटपुट में जोड़ दिया जाता है। एकमात्र फर्क यह है कि यहां लगभग हमेशा projection शॉर्टकट चाहिए, क्योंकि ब्लॉक के अंदर चैनल डायमेंशंस बदलते हैं।
Vanishing gradient समस्या दूरी की समस्या है। जितना दूर ग्रेडिएंट को नेटवर्क से गुजरना पड़ता है, उतना ही वह सिकुड़ता जाता है—और शुरुआती लेयर्स तक पहुंचते-पहुंचते सीखने लायक बहुत कम बचता है।
स्किप कनेक्शंस इस समस्या को ग्रेडिएंट्स के लिए छोटा रास्ता देकर दूर करते हैं।
बैकप्रोपेगेशन के दौरान, ग्रेडिएंट्स को क्रम से हर लेयर से गुजरने की जरूरत नहीं। वे सीधे स्किप कनेक्शन से होकर वापस जा सकते हैं, कन्वॉल्यूशनल लेयर्स को पूरी तरह बायपास करते हुए। यह शॉर्टकट ग्रेडिएंट को इतना बड़ा रखता है कि वह शुरुआती लेयर्स को सचमुच अपडेट कर सके।
यह हर ब्लॉक को सीखने वाली चीज़ भी बदल देता है। शून्य से पूरी ट्रांसफॉर्मेशन खोजने के बजाय, नेटवर्क को केवल इनपुट के ऊपर एक छोटा-सा सुधार सीखना होता है। यह बहुत आसान ऑप्टिमाइज़ेशन समस्या है, और इसका मतलब है कि नेटवर्क गहराई में जा सकता है बिना प्रशिक्षण अस्थिर हुए।
संक्षेप में, जो नेटवर्क पहले विश्वसनीय रूप से ट्रेन करने के लिए बहुत गहरे थे, वे ट्रेन करने योग्य हो जाते हैं।
पारंपरिक CNNs और ResNets दोनों इमेज से फीचर्स सीखते हैं, लेकिन उनका तरीका अलग है।
एक पारंपरिक CNN में, डेटा सीधी रेखा में लेयर्स से होकर गुजरता है। हर लेयर पिछली का आउटपुट लेती है, ट्रांसफॉर्म करती है, और आगे पास कर देती है। यह एक सीमा तक अच्छा काम करता है। एक निश्चित गहराई के बाद, यह क्रमिक संरचना बैकप्रोपेगेशन के दौरान अविश्वसनीय हो जाती है—ग्रेडिएंट्स सिकुड़ते हैं, शुरुआती लेयर्स सीखना बंद कर देती हैं, और सटीकता घटने लगती है।
ResNet सीधी रेखा में नहीं जाता। स्किप कनेक्शंस इनपुट को एक या अधिक लेयर्स को बायपास करने देते हैं और ब्लॉक में नीचे स्थित आउटपुट में सीधे जोड़ते हैं। नेटवर्क अब भी ट्रांसफॉर्मेशन सीखता है, लेकिन डेटा और ग्रेडिएंट्स के लिए एक सीधा रास्ता भी मौजूद रहता है।
दोनों तरीकों की तुलना इस तरह है:
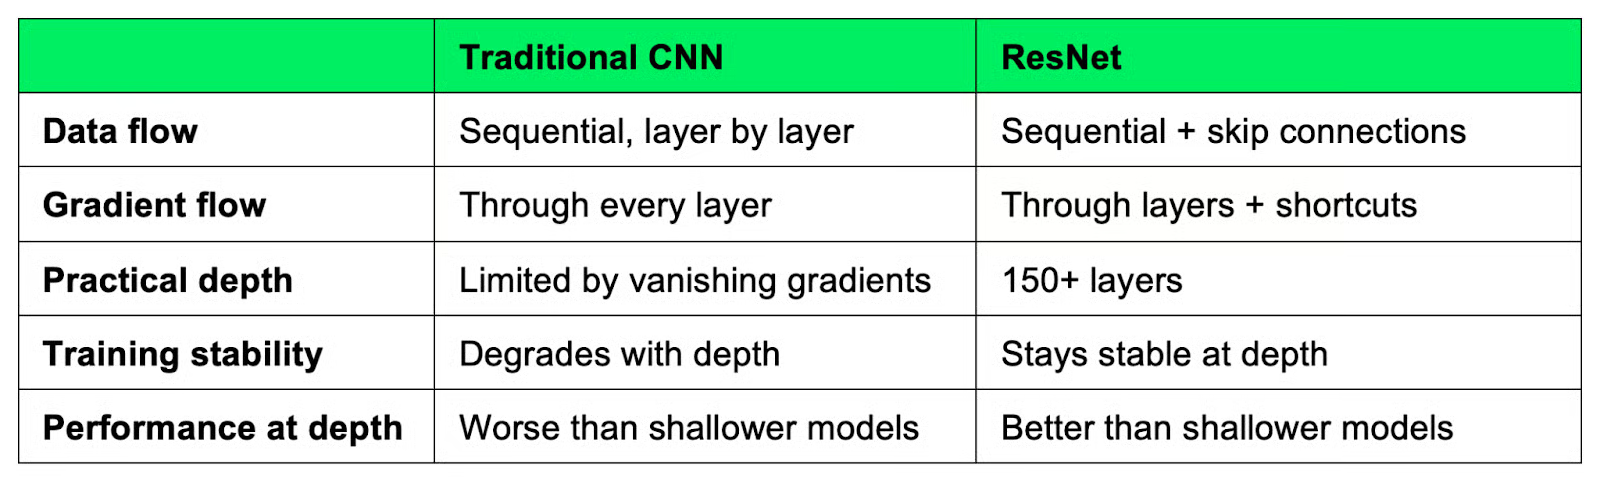
ResNet versus traditional CNN
स्किप कनेक्शंस ग्रेडिएंट्स में मदद करते हैं और ऑप्टिमाइज़ेशन को स्मूद बनाते हैं, जिसका मतलब है कि नेटवर्क अच्छे वज़न तेज़ी और अधिक विश्वसनीयता से ढूंढ लेता है।
ResNet आर्किटेक्चर असल दुनिया के कई कार्यों में दिखता है।
इमेज वर्गीकरण से ResNet की शुरुआत हुई। इसने 2015 में ImageNet Large Scale Visual Recognition Challenge जीता, और यह आज भी इमेजेज़ को श्रेणियों में वर्गीकृत करने के लिए पसंदीदा विकल्प है—चाहे वे मेडिकल स्कैन्स हों, सैटेलाइट इमेजरी, या प्रोडक्ट फ़ोटो।
ऑब्जेक्ट डिटेक्शन वर्कफ़्लोज़ में अक्सर ResNets का उपयोग होता है। Faster R-CNN और Mask R-CNN जैसे फ्रेमवर्क्स ResNet को एक डिटेक्शन हेड के साथ जोड़ते हैं जो इमेज के भीतर वस्तुओं की पहचान और लोकेलाइज़ेशन करता है। ResNet फीचर एक्सट्रैक्शन करता है और बाकी डिटेक्शन हेड संभालता है।
ट्रांसफ़र लर्निंग वहीं है जहां ResNet अधिकांश डेटा वैज्ञानिकों के लिए सच में उपयोगी होता है। शून्य से प्रशिक्षण देने के बजाय—जिसमें कई दिन और बहुत सारा डेटा लगता है—आप ImageNet पर प्रीट्रेंड ResNet लोड करते हैं और अपने डेटा सेट पर उसे फाइन-ट्यून करते हैं। प्रीट्रेंड वेट्स पहले से ही किनारों, टेक्स्चर्स, और आकारों जैसे लो-लेवल फीचर्स एन्कोड करते हैं, इसलिए आप कहीं बेहतर शुरुआती बिंदु से शुरू करते हैं।
फीचर एक्सट्रैक्शन का तरीका भी मिलताजुलता है। आप अपनी इमेजेज़ को एक प्रीट्रेंड ResNet से गुजारते हैं और बाद की किसी लेयर का आउटपुट लेते हैं। ये आउटपुट आपकी इमेजेज़ के सघन, सार्थक प्रतिनिधित्व होते हैं जिन्हें आप किसी सरल क्लासिफ़ायर या क्लस्टरिंग एल्गोरिदम में फीड कर सकते हैं।
इन सभी उपयोग मामलों में, ResNet एक प्रीट्रेंड शुरुआती बिंदु के रूप में काम करता है। अधिकांश डीप लर्निंग फ्रेमवर्क्स बॉक्स से बाहर ही प्रीट्रेंड ResNet वेट्स के साथ आते हैं, जिससे यह शुरू करने के लिए सबसे आसान आर्किटेक्चर्स में से एक बन जाता है।
ResNet डीप लर्निंग में एक वास्तविक प्रगति थी—लेकिन किसी भी आर्किटेक्चर की तरह, इसके भी कुछ समझौते हैं। आइए कुछ लाभ और सीमाओं पर नज़र डालते हैं।
सबसे स्पष्ट है गहराई। स्किप कनेक्शंस डेटा वैज्ञानिकों को 50, 100, या 150+ लेयर्स वाले नेटवर्क्स को degradation समस्या के बिना ट्रेन करने देते हैं। ResNet से पहले यह विश्वसनीय रूप से संभव नहीं था।
ट्रेनिंग भी अधिक स्थिर है। शॉर्टकट पाथ्स ग्रेडिएंट्स को नेटवर्क में साफ़ रास्ता देते हैं, जिसका मतलब है कम ट्यूनिंग, कम क्रैश, और अलग-अलग टास्क्स व डेटासेट्स पर अधिक अनुमाननीय परिणाम।
और प्रदर्शन भी एक लाभ है। ResNet वेरिएंट्स लगातार इमेज बेंचमार्क्स पर अच्छा स्थान प्राप्त करते हैं, और प्रीट्रेंड ResNet मॉडल्स नए डोमेन्स में अच्छी तरह ट्रांसफर होते हैं—इसीलिए वे अब भी कई कंप्यूटर विज़न प्रोजेक्ट्स के लिए डिफ़ॉल्ट शुरुआती बिंदु हैं।
ResNet कम्प्यूटेशनली भारी है। ResNet-101 और ResNet-152 जैसे गहरे वेरिएंट्स को बहुत मेमोरी और प्रोसेसिंग पावर चाहिए, जो सीमित हार्डवेयर या तेज़ इन्फेरेंस की ज़रूरत होने पर बाधा हो सकती है।
यह हर कार्य के लिए सबसे उपयुक्त भी नहीं है। छोटे डेटासेट्स या सरल समस्याओं के लिए, हल्का आर्किटेक्चर अक्सर बहुत कम लागत पर समान रूप से अच्छा करता है। डिफ़ॉल्ट रूप से ResNet-50 लेना हमेशा सही नहीं होता।
और कुछ क्षेत्रों में, ResNet को प्रतिस्थापित किया गया है। EfficientNet जैसी आर्किटेक्चर्स इमेज टास्क्स पर प्रति-पैरामीटर बेहतर सटीकता देती हैं, और अन्य में ट्रांसफॉर्मर्स हावी हो गए हैं। ResNet अभी भी व्यापक रूप से उपयोग होता है, लेकिन अब यह अकेला गंभीर विकल्प नहीं है।
परिचय के ग्यारह साल बाद भी, ResNet आर्किटेक्चर मजबूती से खड़ा है। डीप लर्निंग में यह आम नहीं है।
अधिकांश प्रैक्टिशनर्स अब भी कंप्यूटर विज़न कार्य के लिए विश्वसनीय बेसलाइन चाहिए तो ResNet ही चुनते हैं। यह अच्छी तरह समझा जाता है, हर बड़े फ्रेमवर्क में समर्थित है, और हर प्रमुख लाइब्रेरी में प्रीट्रेंड वेट्स उपलब्ध हैं। इसलिए जब आपको बिना ज़्यादा प्रयोग किए कुछ ऐसा चाहिए जो काम करे, तो ResNet आमतौर पर पहला विकल्प होता है।
लेकिन इसका प्रभाव इसके स्वयं के वेरिएंट्स से आगे तक जाता है।
ResNet का मूल विचार—कि आप सूचना और ग्रेडिएंट्स के प्रवाह में मदद के लिए लेयर्स के चारों ओर शॉर्टकट जोड़ सकते हैं—व्यापक रूप से उपयोगी साबित हुआ। DenseNet ने इस विचार को बेहतर किया, हर लेयर को हर दूसरी लेयर से जोड़कर, न कि केवल एक-दो को स्किप करके। और भले ही ट्रांसफॉर्मर्स की आर्किटेक्चर अलग हो, प्रत्येक ट्रांसफॉर्मर ब्लॉक के अंदर के रेज़िडुअल कनेक्शंस उसी सिद्धांत का पालन करते हैं जो ResNet ने पेश किया।
EfficientNet, ConvNeXt, और विज़न ट्रांसफॉर्मर्स जैसी नई आर्किटेक्चर्स ने विशिष्ट क्षेत्रों में प्रदर्शन को और आगे बढ़ाया है। लेकिन उन्होंने ResNet को प्रतिस्थापित कम और उसके स्थापित आधार पर अधिक निर्माण किया है।
ResNet आर्किटेक्चर की पूरी कहानी एक चीज़ पर टिकी है: स्किप कनेक्शंस। इसी एक विचार ने दो समस्याओं—vanishing gradients और degradation समस्या—को हल किया, जो गहरे नेटवर्क्स को पीछे खींच रही थीं, और ऐसी गहराई पर नेटवर्क्स को ट्रेन करना व्यावहारिक बनाया जो पहले संभव नहीं थी।
लेयर्स के बीच शॉर्टकट्स जोड़ने का विचार अब आधुनिक डीप लर्निंग का एक मानक बिल्डिंग ब्लॉक है—DenseNet, ट्रांसफॉर्मर्स, और 2015 के बाद बनी अधिकांश आर्किटेक्चर्स में दिखता है।
यदि आप आज किसी कंप्यूटर विज़न समस्या पर काम कर रहे हैं, तो ResNet अभी भी एक ठोस शुरुआती बिंदु है। यह सबसे नया विकल्प नहीं है, लेकिन सबसे भरोसेमंद में से एक है। इसे एक बेसलाइन की तरह लें—आप चकित होंगे कि 2026 में भी यह प्रतिस्पर्धियों को कैसे पीछे छोड़ देता है।
यदि आप डीप लर्निंग में नए हैं पर Python की बुनियाद जानते हैं, तो हमारा Introduction to TensorFlow in Python कोर्स देखें—यह आपको ResNet जैसे विषयों के साथ एक वीकेंड में शुरू करा देगा।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें