
课程
Data Engineering 入门
4 小时
130K
在思考集成数据的最佳方式吗?本节将介绍用于数据集成的多种技术。每种技术都适用于不同的环境和需求。我们逐一来看!
ETL 是传统的数据集成技术,包含三个关键步骤:
在抽取阶段,从不同系统收集数据;在转换阶段,确保数据被清洗、标准化并按一致的模式格式化;最后在加载阶段,将转换后的数据存入目标系统,使其可用于分析与报告。
当您需要将来自多个异构来源的数据整合并结构化,用于报告、分析或商业智能时,ETL 最为适用。它非常适合在分析前需要充分清洗和转换的结构化数据。
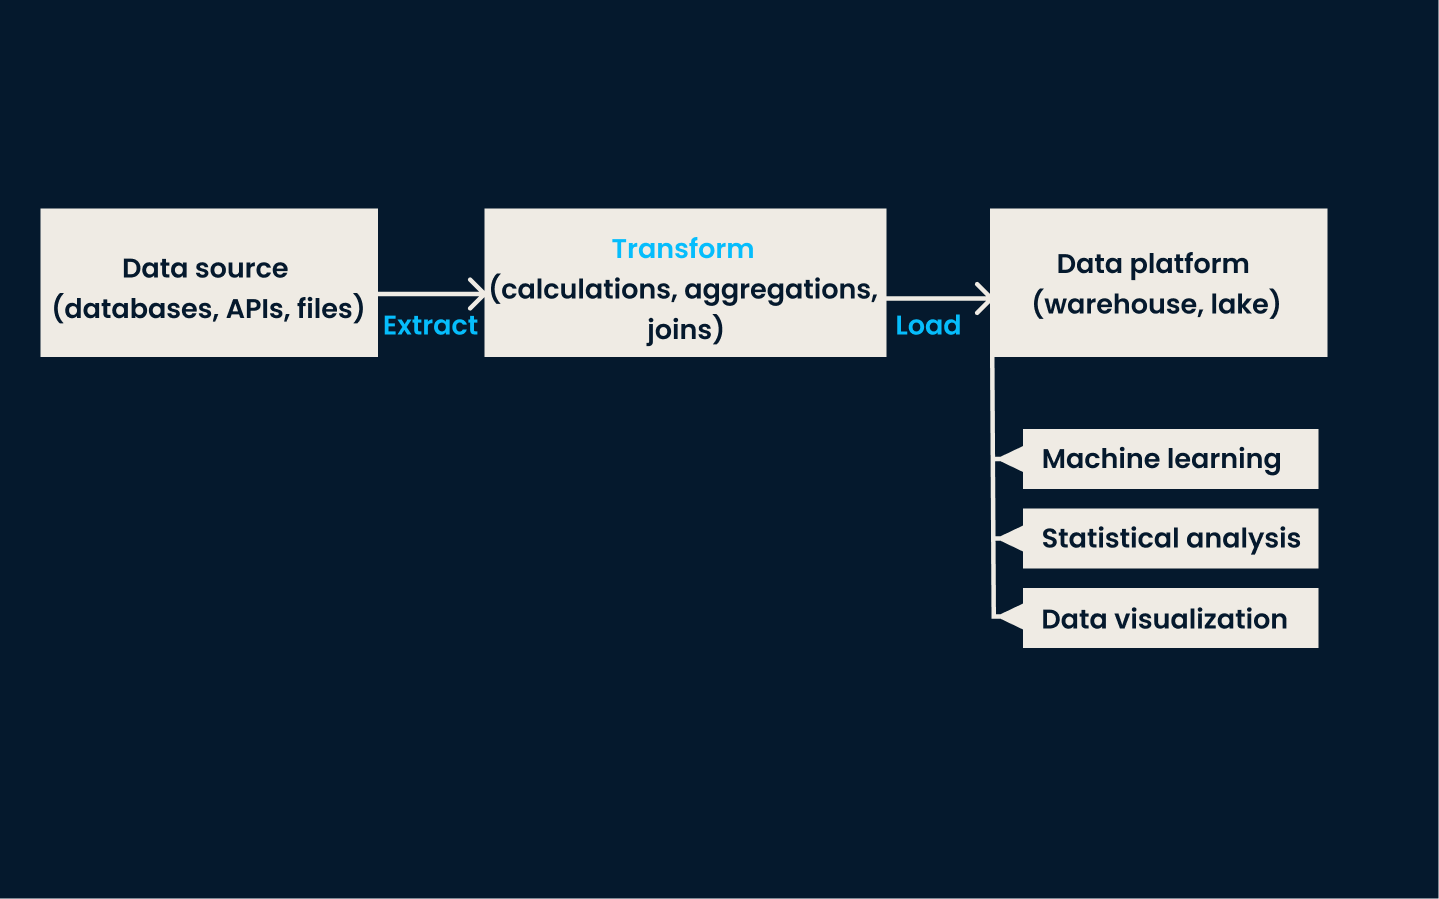
ETL 架构示例
这种方式在传统本地环境、数据量适中且转换复杂度适中时尤其有效。若您的数据需要批处理并定期更新,ETL 是首选方法。
ELT 是 ETL 的变体,专为处理云环境中常见的大型数据集而设计。在这种方法中,先抽取并将数据加载到目标系统,随后再进行转换。
换言之,ELT 适合需要快速加载海量原始数据、并在之后进行转换的组织。这为何时以及如何进行数据转换提供了更大的灵活性。如果您的业务涉及非结构化数据,或需要近实时转换,ELT 比传统 ETL 更合适。
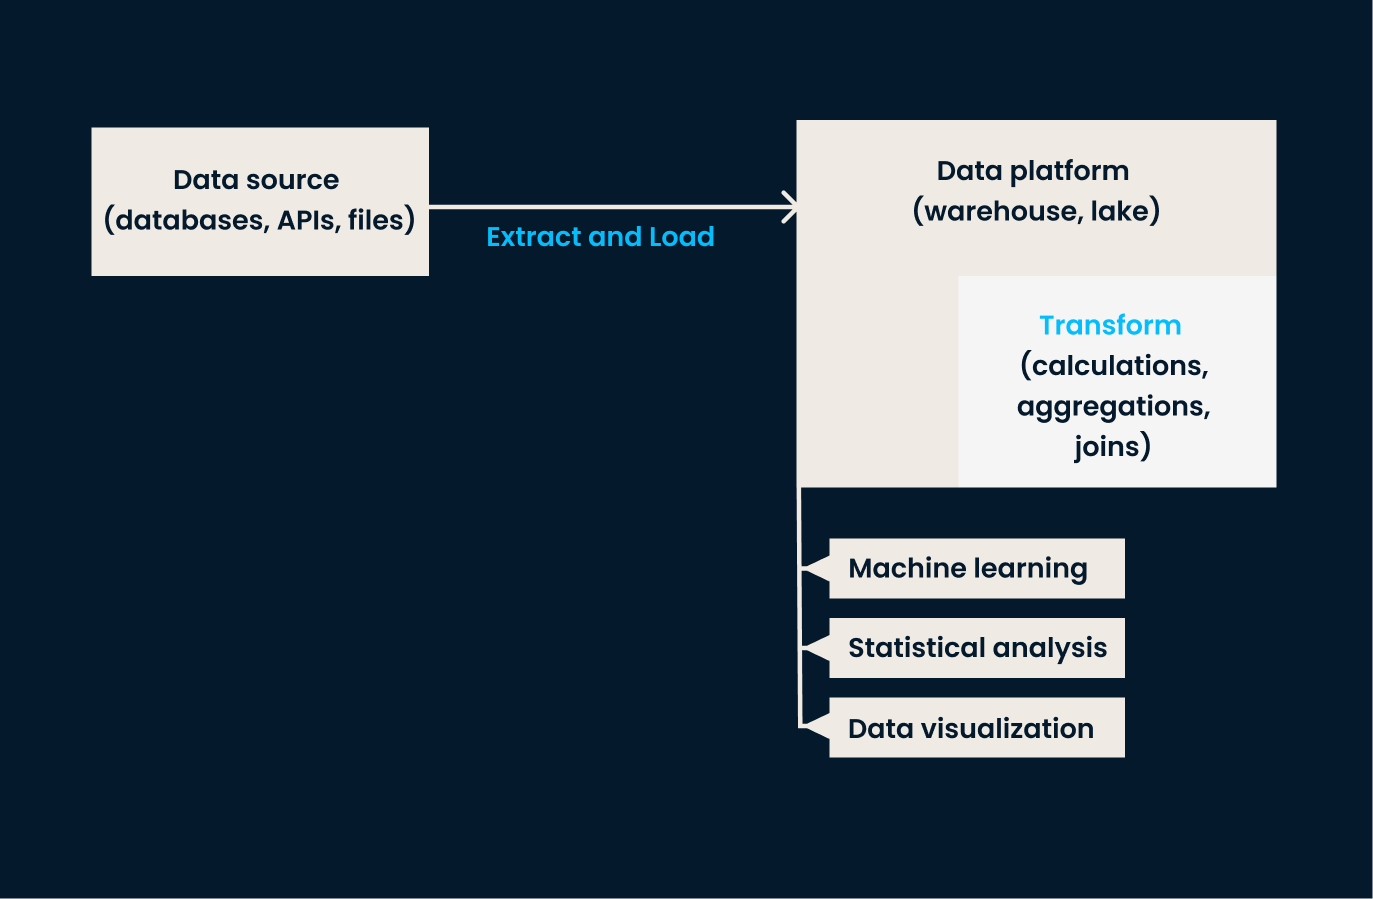
ELT 架构示例
如果您想进一步了解这些传统的数据工程流程,推荐查看Python 中的 ETL 与 ELT 课程!
数据复制是将数据从一个系统复制到另一个系统的过程。该技术确保所有系统使用相同的数据,并帮助不同环境保持同步。
复制可以实时执行,也可以按计划间隔进行,视具体需求而定。其主要优势是提升数据可用性与可靠性,确保关键系统能一致地访问最新信息。
该方法最适用于高可用与跨系统一致性至关重要的场景。它常被用于备份、灾难恢复,以及跨不同环境(如本地与云)进行数据同步。
对于需要在多个地点即时访问同一数据副本的应用,数据复制同样有价值。如果您的组织需要确保数据在不同平台或区域保持可用且最新,复制是极佳选择。
需要注意的是,从技术上讲,复制通常仅适用于传统数据库,以创建与原始数据完全一致的副本。
数据虚拟化是一种更现代的数据集成方法。它使用户无需移动或物理转换数据,就能实时访问与查询数据。
该技术并非将数据整合进单一存储库,而是创建一个虚拟层,连接各类数据源,提供来自多个系统的统一数据视图,从而更易访问与分析。
当实时数据访问比数据的物理迁移或整合更重要时,此技术效果最佳。对于拥有分散数据源、又希望在不增加传统 ETL 复杂度与延迟的情况下获得统一视图的组织而言,它非常理想。
如果您的场景需要按需访问多个数据源,例如跨多个数据库或 API 进行查询,数据虚拟化将是一种强大的解决方案。
流式数据集成处理来自事件驱动源(如物联网设备、社交媒体平台、金融市场等)的实时数据处理。该技术允许数据一经产生就被摄取并集成,而无需等待批处理。
此方法适用于需要及时洞察与快速响应的场景。如果您的组织需要基于最新信息快速决策,或对延迟敏感,流式数据集成是最优之选。
查看流处理概念课程,了解这一技术。
下表总结了我们刚讨论的不同技术:
|
技术 |
描述 |
最适用于 |
示例用例 |
优势 |
|
ETL(抽取、转换、加载) |
传统方法:将数据抽取、转换后加载至目标系统。 |
用于报告、分析或 BI 的结构化数据,且需要充分清洗与转换。 |
将多来源数据整合进数据仓库,进行批处理与定期更新。 |
确保数据清洁、标准化、结构化,随时可用于分析。 |
|
ELT(抽取、加载、转换) |
ETL 的现代变体:数据先加载到目标系统,再进行转换。 |
云环境中的大型数据集、非结构化数据或近实时转换需求。 |
将原始数据加载至云端数据湖或数据仓库,以便灵活、按需转换。 |
在转换的时间与方式上提供更大灵活性。 |
|
数据复制 |
在系统间复制数据,以维持跨环境的一致性与可用性。 |
高可用与一致性要求、灾难恢复、数据同步场景。 |
保持本地与云系统同步,或创建灾难恢复的备份副本。 |
提升数据可靠性,确保系统间能访问最新数据。 |
|
数据虚拟化 |
无需物理迁移或转换,即可实时访问与查询数据。 |
分散数据源场景,需要实时访问且不希望引入整合复杂度。 |
跨多个数据库或 API 查询,提供分析所需的统一视图而无需移动数据。 |
在异构来源间提供实时的统一数据视图。 |
|
流式数据集成 |
对事件驱动来源产生的数据进行实时处理与集成。 |
需要及时洞察、快速响应或低延迟处理的场景。 |
处理物联网设备数据、监控金融市场活动、或实时分析社交媒体流。 |
基于最新信息做出快速决策。 |
数据集成架构是决定数据如何整合与管理的框架。根据数据类型、存储需求与业务目标的不同,架构也有所差异。我们来看两种最常见的。
数据仓库集成着重将多个来源的数据集中到一个结构化、统一的存储库中,用于分析与报告。在这种架构中,会将各类运营系统的数据抽取、转换并加载(ETL)到数据仓库,在此进行清洗与组织。
数据仓库让您能够进行深入分析与报告,确保各业务部门访问到准确、最新的信息。该架构适用于结构化数据,且当全面报告是关键目标时更为理想。
推荐学习优秀的数据仓库概念课程,以更深入了解这一普遍采用的架构。
数据湖适合处理多样数据类型与格式的团队。它旨在以原始形态存储大量的非结构化、半结构化和结构化数据。数据湖可整合来自各种来源(如物联网设备、社交媒体与运营系统)的数据,而无需事先处理或转换。
该架构对于大数据用例尤为有利,因为它支持灵活存储,并可应用高级分析、机器学习或探索性分析。
下表比较了数据仓库与数据湖在数据集成方面的差异:
|
特性 |
数据仓库 |
数据湖 |
|
数据类型 |
结构化数据(如关系型表)。 |
结构化、半结构化(如 JSON、XML)与非结构化数据(如音频、视频、日志)。 |
|
数据模式 |
写时定义模式(Schema-on-write):数据必须符合预定义模式。 |
读时定义模式(Schema-on-read):数据可按原始形态摄取,在读取时再结构化。 |
|
ETL/ELT 流程 |
需要复杂 ETL,在加载前清洗与转换数据。 |
允许 ELT:先摄取原始数据,分析或检索时再进行转换。 |
|
数据来源 |
通常与事务系统、CRM、ERP 等集成。 |
支持来自多样来源的集成,包括物联网、社交媒体与大数据系统。 |
|
数据量 |
面向较小规模、干净且高质量的数据。 |
可大规模处理海量且多样的原始数据。 |
|
集成工具 |
专用 ETL 工具,如 Informatica、Talend 或 dbt。 |
大数据工具,如 Apache Spark、Kafka、Flume 及 ELT 框架。 |
|
时延 |
侧重面向商业智能的低时延查询。 |
常优先保证高吞吐的数据摄取,而非低时延查询响应。 |
|
数据治理 |
严格的数据治理,具备完善的数据质量检查。 |
治理更灵活,但需额外工具以实现稳健的数据质量与血缘追踪。 |
|
实时数据 |
不太适合实时数据集成。 |
支持实时数据摄取与流处理。 |
|
数据格式 |
依赖表格型格式(如 CSV、Excel、SQL 表)。 |
支持多种格式,包括 Parquet、Avro、ORC、文本与多媒体。 |
数据集成带来诸多益处,但也并非没有挑战。要高效地实现数据集成,您必须知道如何克服这些难题。
确保数据质量是企业在数据集成中面临的首要挑战之一。
当数据来自多个、分散的来源时,往往会出现不一致、缺失或错误。这些问题会导致分析不准确和决策偏差。为克服这些问题,团队必须在集成前实施数据清洗流程:校验、标准化并纠正数据。这可能涉及设置自动化数据质量检查、使用数据剖析工具,以及应用转换规则以确保各数据源之间的一致性。
随着 AI 时代的到来,数据质量比以往任何时候都更重要。现在正是通过数据质量入门课程深入了解它的好时机。
在不同系统间处理多种数据格式,也是数据集成中的一大挑战。
数据可能以 JSON、XML、CSV 或专有格式存在,并且各自采用不同的模式或数据模型。整合如此多样的数据需要使用能够将原始格式的数据转换并映射到通用、可用结构的工具与技术。
诸如数据转换与模式映射等方案有助于实现数据标准化。
随着数据量增长,可扩展性成为集成中的关键问题。海量数据、实时集成需求以及数据来源日益复杂,都会给传统数据集成系统带来压力。
为应对可扩展性挑战,您可以利用云平台、分布式计算以及能满足增长需求的现代集成技术。
维持数据安全与合规性是一项重大挑战——尤其在集成敏感或受监管的数据时。数据集成过程必须在存储、传输与访问各环节保护数据,防止未授权使用或泄露。
组织必须实施加密与访问控制,并遵循相关法规。通过优先部署安全措施与合规流程,您可以降低泄露风险,确保数据符合行业标准。
我们来看看当下最流行且强大的数据集成工具。每种工具都适用于不同的业务环境与数据管理需求。
Apache NiFi 由 Apache 软件基金会于 2014 年创建。这是一款开源工具,旨在实现系统之间的数据流自动化。NiFi 提供友好的可视化拖拽界面来构建数据管道,并支持多种数据格式。
对于需要在系统间实现实时、无缝数据传输的企业而言,该工具尤为有益。它非常适合医疗、金融等行业,这些行业数据流动持续不断,需要以最小延迟与错误进行快速处理。
Fivetran 成立于 2013 年,是一款云端 ELT(抽取、加载、转换)解决方案,可在各平台间自动化数据迁移与同步。其核心在于简化 ETL 流程,让用户能够搭建能自动适应模式变更的数据管道。
该工具对迁移至云端数据架构或在不显著增加开销的情况下扩展数据管理实践的企业尤其有用。由于 Fivetran 在加载后进行数据转换(ELT),它非常适合在云环境中优先考虑简洁与可扩展性的组织。
Microsoft 的 Azure Data Factory 是微软于 2015 年推出的基于云的数据集成服务。它可让用户在多种云与本地环境中创建、调度与编排数据工作流。
Azure Data Factory 能与微软的云服务套件良好集成,并提供广泛的连接器以整合不同来源的数据。对于已在 Microsoft Azure 生态中的企业,尤其是需要在混合云或本地系统间进行复杂数据集成的企业而言,这款工具非常理想。
查看教程:构建您的第一个 Azure Data Factory 管道。
成立于 1993 年的 Informatica 是领先的企业级数据集成平台。该平台以强大的数据转换能力著称,支持复杂的数据集成流程,被众多处理海量数据的大型组织广泛采用。
该平台提供的数据迁移、治理与清洗工具可跨多个系统协同工作。Informatica 非常适用于金融、医疗与电信等行业,在这些领域中,数据合规、转换与高可用性至关重要。
如果您想继续探索,请查看我们的最佳 ETL 工具清单。
本文探讨了数据集成的核心方面:从组成与技术,到支撑它的工具与架构。
我们看到,数据集成如何帮助组织将分散的数据来源整合为统一、易用的格式,从而自信地做出决策。此外,我们也讨论了集成过程中团队面临的挑战,并介绍了一些关键工具,帮助您开启数据集成之旅,让过程更顺畅。
若想进一步加深对数据集成的理解,推荐学习以下资源: