数据架构版图正在演进,受云技术日益普及与现代数据栈采用的推动。由此,ELT 流程正得到更广泛的应用。那么,这一流程究竟包含哪些内容?
本文将探讨 ELT 及其在先进数据架构中的角色。
什么是 ELT?
ELT 是 Extract、Load、Transform 的缩写,即抽取、加载、转换。它是一种数据集成流程,涉及从各类来源抽取数据,将其加载到数据存储系统中,并将其转换为便于分析的格式。
ELT 流程主要用于 现代数据栈架构中,在数据湖或数据仓库中对数据进行存储、转换与分析。
ELT 如何工作?
顾名思义,ELT 包含三个主要步骤:抽取、加载、转换。下面分别展开说明。
ELT 的第一步是从各类来源抽取数据,例如数据库、文件、API 或 Web 服务。这可以通过 ELT 软件等工具完成,或由开发人员编写自定义脚本实现。
常见的数据抽取平台包括 Airbyte 和 Fivetran。若需编写自定义脚本,Apache Spark 与 Python 被广泛采用。
抽取的数据可以是结构化、半结构化或非结构化的,来源于不同类型的系统,例如关系型数据库、NoSQL 数据库,或云存储。
2. 加载(Load)
数据抽取完成后,会被加载到集中式数据存储系统,如数据湖或数据仓库。此步骤将抽取的数据按原始格式进行组织与存储,不做转换。
数据工程师通常参与此环节,将数据加载到如下平台:
这些数据平台支持对海量数据的高速加载,并为来自不同来源的各类数据提供统一的真实数据来源。
ELT 的最后一步是将原始数据转换为适合分析与报表的优化格式。这包括清洗、过滤、聚合与结构化数据,使其便于商业智能与分析工具使用。
数据工程师或数据科学家通常负责此步骤,他们可能会使用以下工具:
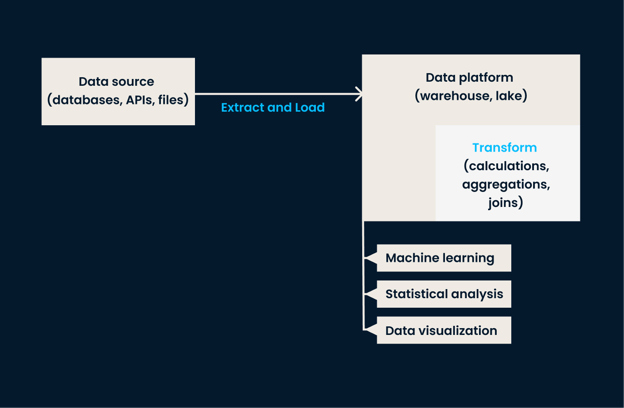
ELT 数据管道:在对数据进行任何转换之前,先完成抽取与加载阶段。转换步骤在数据平台内执行。
数据转换在数据仓库或数据湖内完成,这使得处理海量数据更为容易。借助现代云技术,这一过程可在近乎实时的情况下完成,为组织提供用于分析的最新且准确的数据。
想进一步学习如何在 ELT 中使用 Python?欢迎查看《ETL 与 ELT 的 Python 实践》课程,或许正合您意。
ELT 的优势
ELT 具备诸多优势,以下为其中一些亮点:
- 可扩展性: 借助云计算能力,ELT 能比传统 ETL 更快速地抽取、加载与转换海量数据。
- 灵活性: ELT 支持整合来自多种来源的数据,包括结构化、半结构化与非结构化数据。
- 实时洞察速度: 存储在数据湖或数据仓库中的原始数据可按需快速转换,提供实时洞察,加快决策速度。
ELT 与 ETL 的比较
现在来比较一下ELT 与 ETL 的差异。
如前所述,ELT 是一种较新的数据处理方式,先将数据加载到中心存储库,再在加载后进行转换。
相反,ETL(Extract、Transform、Load:抽取、转换、加载)是一种传统方法,在将数据加载到目标系统之前先进行转换。这些根本性差异不仅影响流程本身,也影响速度、成本与安全性。
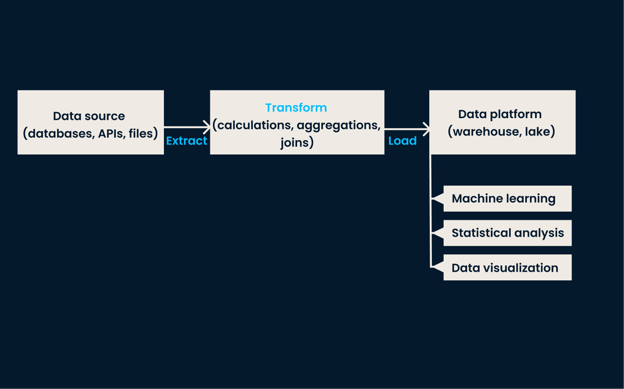
ETL 管道:转换步骤发生在将数据加载到目标平台之前。通常,转换在独立服务器上进行,而非在数据平台内部完成。
流程
ELT 采用“先加载,后转换”的方法,将数据以原始形式加载进存储系统,然后再为分析进行转换。
而 ETL 则采用“抽取—转换—加载”的方法,即先从各来源抽取数据,再进行转换,最后加载至数据仓库。
速度
ELT 以更快的数据处理速度著称,因为它省去了中间暂存区的需求。这支持实时或近实时的数据分析。
相比之下,ETL 通常因涉及多个转换与加载步骤而耗时更长。
成本
此外,ELT 无需昂贵的 ETL 软件,因为可通过 SQL 查询或其他开源工具完成转换。
相反,传统 ETL 流程往往更适用于本地部署环境,在该环境中数据源较为有限,且硬件资源的可扩展性不如云环境。本地部署的基础设施成本通常高于云基础设施。
安全
最后,ELT 在加载过程中即可对个人可识别信息(PII)进行数据加密与数据脱敏,因为这些操作在安全的中央存储库中完成。
ETL 则必须在抽取与转换的全流程中确保数据安全。然而,由于数据需要移动到额外的暂存存储并常在独立服务器上处理,这一点更具挑战。
ELT 的应用场景
凭借更快的数据处理速度与云计算分析能力,ELT 在一些用例中相较 ETL 更具优势。
以下是 ELT 流程的一些常见用途:
- 实时应用报告: ELT 使企业能够实时洞察用户应用行为。
- 数据仓库建设: 许多组织使用 ELT 将数据加载并转换至集中式数据仓库,以满足报表与分析需求。
- 基于云的数据集成: 随着云技术的兴起,ELT 已成为整合来自各类本地与云端应用数据源的流行选择。
ELT 的工具与技术
组织在实施 ELT 流程时可选用多种工具与技术,包括:
数据仓库与数据湖
在 ELT 的加载步骤中,数据湖与数据仓库对于为企业提供集中式数据存储空间至关重要。
以下是最受欢迎的云数据平台:
- Amazon Redshift: 一项云数据仓库服务,可快速高效地处理海量数据。
- Google BigQuery: 一款无服务器、可扩展的云数据仓库,支持对大型数据集的快速查询。
- Snowflake: 基于云的数据仓库,支持 ELT 流程,并提供先进的安全与性能特性。
- Amazon S3: 可作为存储原始数据的数据湖,随后可通过 SQL 查询或其他工具进行转换。
开源 ELT 工具
许多组织也会出于成本效益考虑,利用开源工具来实施 ELT 流程。
这些工具可助力 ELT 流程的不同阶段:
- Apache Airflow:用于工作流自动化与 ETL/ELT 流程的调度。
- dbt:在数据仓库内使用 SQL 进行数据转换的开源软件。
- Airbyte: 开源数据集成平台,支持 ELT 与 ETL 流程。
- Singer: 采用模块化方式,同时用于 ELT 与 ETL 流程的开源工具。
- Apache NiFi: 开源数据集成工具,支持数据路由、转换与系统中介逻辑。
开源工具与 ELT 流程十分契合,因为它们提供灵活性、开发者支持与多样的集成选项。
自定义脚本
开发者也可选择使用编程语言编写的脚本以获得更高的自定义性。通常会借助各类软件包与库来处理和转换数据。
这些脚本常用的编程语言包括:
- Python: 使用 Pandas、NumPy 与SQLAlchemy 等库,有助于数据的抽取、加载与转换。
- Apache Spark: 用于大数据处理与分析,常配合 Python(PySpark)、Java 与 Scala 等语言。
- R: 可使用tidyverse 框架及dplyr 与 data.table 等 R 库进行数据抽取与转换。
- SQL: 可使用 SQL 查询完成转换任务,且SQL Server Integration Services(SSIS)是常用的 ETL 工具,也支持 ELT 流程。
- Scala: 常与 Apache Spark 搭配,用于大数据处理与 ELT 任务。
- Java: 常与 Apache Hadoop、Apache Spark 等大数据框架配合用于 ELT 流程。
结语
总之,ELT 是数据处理领域新兴的趋势,相较传统 ETL 方法具备诸多优势。它支持更快速、更高效的数据转换,并提供更强的灵活性与可扩展性。
如果您打算进一步了解 ELT 或其他数据工程概念,不妨看看我们的数据工程师认证或Python 数据工程师职业路径。


数据架构版图正在演进,受云技术日益普及与现代数据栈采用的推动。由此,ELT 流程正得到更广泛的应用。那么,这一流程究竟包含哪些内容?
本文将探讨 ELT 及其在先进数据架构中的角色。
什么是 ELT?
ELT 是 Extract、Load、Transform 的缩写,即抽取、加载、转换。它是一种数据集成流程,涉及从各类来源抽取数据,将其加载到数据存储系统中,并将其转换为便于分析的格式。
ELT 流程主要用于 现代数据栈架构中,在数据湖或数据仓库中对数据进行存储、转换与分析。
ELT 如何工作?
顾名思义,ELT 包含三个主要步骤:抽取、加载、转换。下面分别展开说明。
1. 抽取(Extract)
ELT 的第一步是从各类来源抽取数据,例如数据库、文件、API 或 Web 服务。这可以通过 ELT 软件等工具完成,或由开发人员编写自定义脚本实现。
常见的数据抽取平台包括 Airbyte 和 Fivetran。若需编写自定义脚本,Apache Spark 与 Python 被广泛采用。
抽取的数据可以是结构化、半结构化或非结构化的,来源于不同类型的系统,例如关系型数据库、NoSQL 数据库,或云存储。
2. 加载(Load)
数据抽取完成后,会被加载到集中式数据存储系统,如数据湖或数据仓库。此步骤将抽取的数据按原始格式进行组织与存储,不做转换。
数据工程师通常参与此环节,将数据加载到如下平台:
这些数据平台支持对海量数据的高速加载,并为来自不同来源的各类数据提供统一的真实数据来源。
3. 转换(Transform)
ELT 的最后一步是将原始数据转换为适合分析与报表的优化格式。这包括清洗、过滤、聚合与结构化数据,使其便于商业智能与分析工具使用。
数据工程师或数据科学家通常负责此步骤,他们可能会使用以下工具:
ELT 数据管道:在对数据进行任何转换之前,先完成抽取与加载阶段。转换步骤在数据平台内执行。
数据转换在数据仓库或数据湖内完成,这使得处理海量数据更为容易。借助现代云技术,这一过程可在近乎实时的情况下完成,为组织提供用于分析的最新且准确的数据。
想进一步学习如何在 ELT 中使用 Python?欢迎查看《ETL 与 ELT 的 Python 实践》课程,或许正合您意。
ELT 的优势
ELT 具备诸多优势,以下为其中一些亮点:
ELT 与 ETL 的比较
现在来比较一下ELT 与 ETL 的差异。
如前所述,ELT 是一种较新的数据处理方式,先将数据加载到中心存储库,再在加载后进行转换。
相反,ETL(Extract、Transform、Load:抽取、转换、加载)是一种传统方法,在将数据加载到目标系统之前先进行转换。这些根本性差异不仅影响流程本身,也影响速度、成本与安全性。
ETL 管道:转换步骤发生在将数据加载到目标平台之前。通常,转换在独立服务器上进行,而非在数据平台内部完成。
流程
ELT 采用“先加载,后转换”的方法,将数据以原始形式加载进存储系统,然后再为分析进行转换。
而 ETL 则采用“抽取—转换—加载”的方法,即先从各来源抽取数据,再进行转换,最后加载至数据仓库。
速度
ELT 以更快的数据处理速度著称,因为它省去了中间暂存区的需求。这支持实时或近实时的数据分析。
相比之下,ETL 通常因涉及多个转换与加载步骤而耗时更长。
成本
此外,ELT 无需昂贵的 ETL 软件,因为可通过 SQL 查询或其他开源工具完成转换。
相反,传统 ETL 流程往往更适用于本地部署环境,在该环境中数据源较为有限,且硬件资源的可扩展性不如云环境。本地部署的基础设施成本通常高于云基础设施。
安全
最后,ELT 在加载过程中即可对个人可识别信息(PII)进行数据加密与数据脱敏,因为这些操作在安全的中央存储库中完成。
ETL 则必须在抽取与转换的全流程中确保数据安全。然而,由于数据需要移动到额外的暂存存储并常在独立服务器上处理,这一点更具挑战。
ELT 的应用场景
凭借更快的数据处理速度与云计算分析能力,ELT 在一些用例中相较 ETL 更具优势。
以下是 ELT 流程的一些常见用途:
ELT 的工具与技术
组织在实施 ELT 流程时可选用多种工具与技术,包括:
数据仓库与数据湖
在 ELT 的加载步骤中,数据湖与数据仓库对于为企业提供集中式数据存储空间至关重要。
以下是最受欢迎的云数据平台:
开源 ELT 工具
许多组织也会出于成本效益考虑,利用开源工具来实施 ELT 流程。
这些工具可助力 ELT 流程的不同阶段:
开源工具与 ELT 流程十分契合,因为它们提供灵活性、开发者支持与多样的集成选项。
自定义脚本
开发者也可选择使用编程语言编写的脚本以获得更高的自定义性。通常会借助各类软件包与库来处理和转换数据。
这些脚本常用的编程语言包括:
结语
总之,ELT 是数据处理领域新兴的趋势,相较传统 ETL 方法具备诸多优势。它支持更快速、更高效的数据转换,并提供更强的灵活性与可扩展性。
如果您打算进一步了解 ELT 或其他数据工程概念,不妨看看我们的数据工程师认证或Python 数据工程师职业路径。