

Cursus
Introductie tot Data Engineering
4 uur
130.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleBenieuwd wat de beste manier is om data te integreren? In deze sectie verkennen we de verschillende technieken voor data-integratie. Elke techniek is geschikt voor andere omgevingen en vereisten. Laten we ze bekijken!
ETL is de traditionele techniek voor data-integratie. Deze omvat drie kerntappen:
In de extractiefase wordt data verzameld uit verschillende systemen. De transformatiefase zorgt ervoor dat de data wordt opgeschoond, gestandaardiseerd en opgemaakt om in een consistent schema te passen. Tot slot wordt in de laadsfase de getransformeerde data opgeslagen in het doelsysteem, waar deze beschikbaar is voor analyse en rapportage.
ETL is het meest geschikt wanneer je data uit meerdere, uiteenlopende bronnen wilt integreren en structureren voor rapportage, analytics of business intelligence. Het is ideaal voor organisaties met gestructureerde data die grondig moet worden opgeschoond en getransformeerd vóór de analyse.
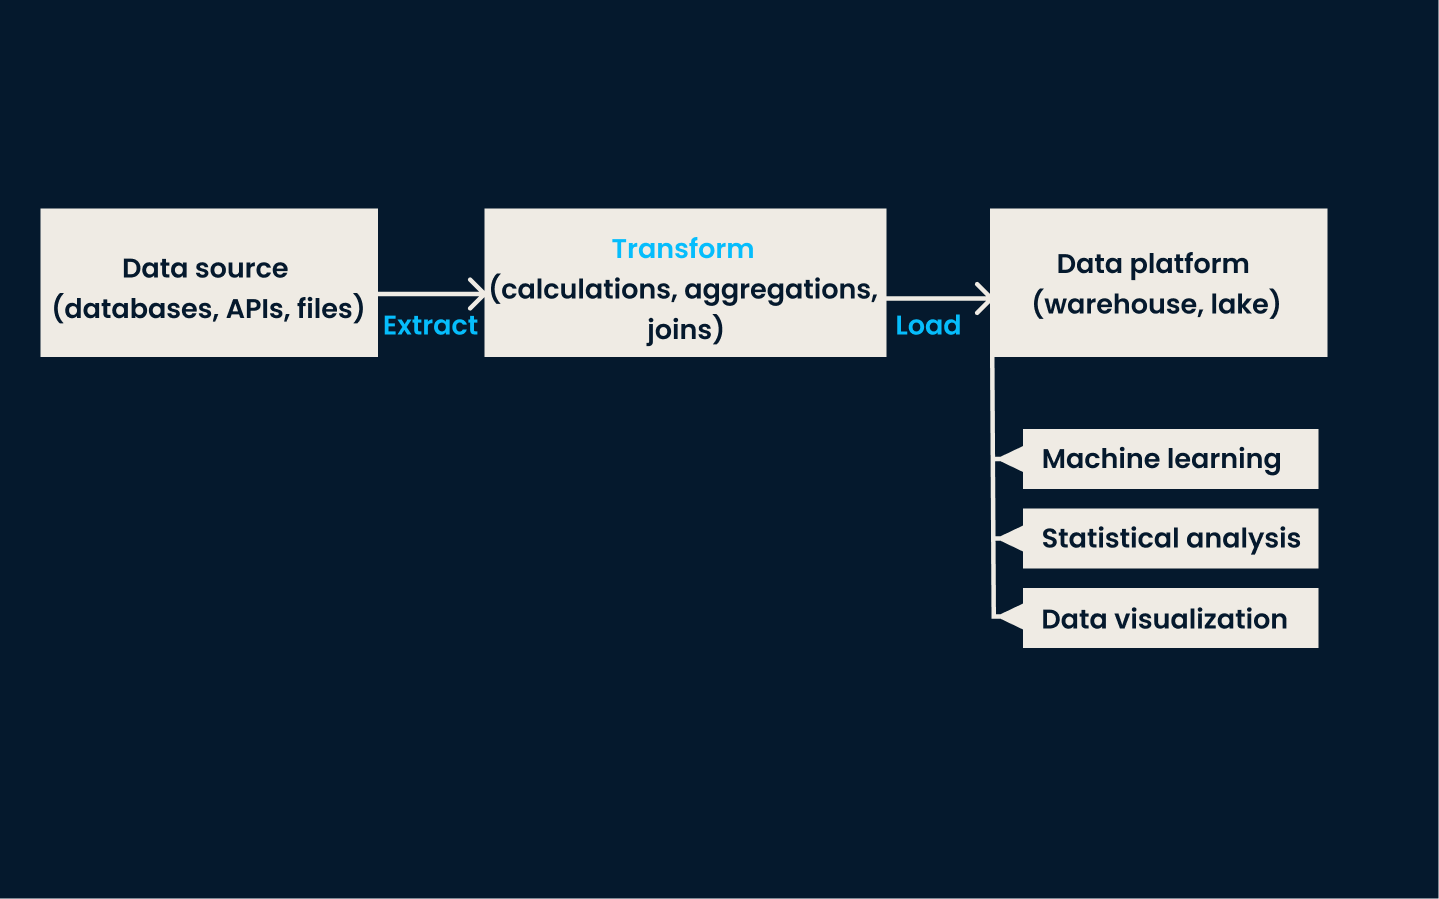
Voorbeeld van ETL-architectuur
Deze aanpak is vooral effectief in traditionele on-premise omgevingen met een gemiddeld datavolume en transformatiecomplexiteit. ETL is de aangewezen methode als je data batchverwerking en regelmatig geplande updates nodig heeft.
ELT is een variant op ETL die is ontworpen voor de grote datasets die je typisch in cloudomgevingen vindt. Bij deze aanpak wordt data eerst geëxtraheerd en geladen in een doelsysteem, en pas daarna vindt de transformatie plaats.
Met andere woorden: ELT is het beste voor organisaties die grote hoeveelheden ruwe data snel moeten laden en later willen transformeren. Dit geeft meer flexibiliteit in hoe en wanneer datatransformaties worden toegepast. Als je werkt met ongestructureerde data of transformatie bijna in real time nodig hebt, is ELT beter dan traditionele ETL.
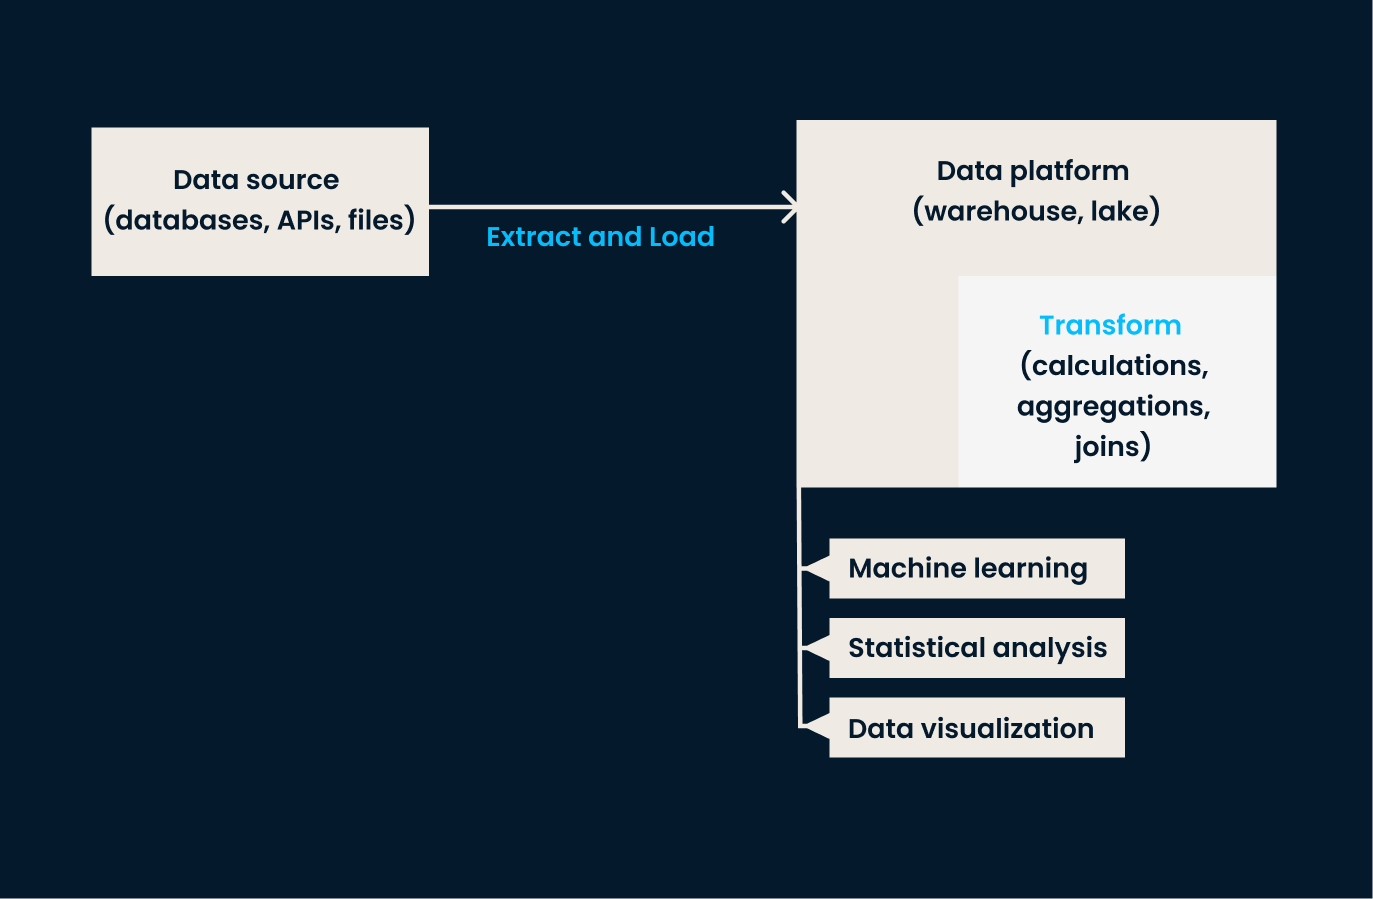
Voorbeeld van ELT-architectuur
Wil je meer leren over deze traditionele data-engineeringprocessen? Kijk dan vooral de ETL and ELT in Python-cursus!
Datareplicatie is het proces waarbij data van het ene systeem naar het andere wordt gekopieerd. Deze techniek zorgt ervoor dat alle systemen met dezelfde data werken en helpt verschillende omgevingen synchroon te houden.
Replicatie kan in real time of op geplande intervallen worden uitgevoerd, afhankelijk van de specifieke behoeften. Het belangrijkste voordeel is dat het de beschikbaarheid en betrouwbaarheid van data verbetert, zodat kritieke systemen consistent toegang hebben tot de meest actuele informatie.
Deze aanpak is het meest geschikt in scenario’s waarin hoge beschikbaarheid en consistentie tussen systemen cruciaal zijn. Het wordt vaak gebruikt voor back-ups, disaster recovery en datasynchronisatie tussen verschillende omgevingen, zoals tussen on-premise en cloudsystemen.
Datareplicatie is ook waardevol voor toepassingen die directe toegang tot identieke kopieën van data op meerdere locaties vereisen. Als je organisatie data beschikbaar en up-to-date moet houden in verschillende platforms of regio’s, is replicatie een uitstekende optie.
Houd er rekening mee dat de optie voor replicatie technisch gezien meestal alleen beschikbaar is voor traditionele databases om exacte kopieën van de originele data te maken.
Datavirtualisatie is een modernere benadering van data-integratie. Het stelt gebruikers in staat om data in real time te benaderen en te bevragen zonder deze te verplaatsen of fysiek te transformeren.
In plaats van data te consolideren in één opslagplaats, creëert deze techniek een virtuele laag die verbinding maakt met verschillende databronnen en een uniforme weergave biedt van data uit meerdere systemen, waardoor de data makkelijker toegankelijk en analyseerbaar wordt.
Deze techniek werkt het best wanneer realtime toegang belangrijker is dan het fysiek verplaatsen of consolideren van data. Het is ideaal voor organisaties met uiteenlopende databronnen die een uniforme weergave willen creëren zonder de complexiteit en vertraging van traditionele ETL-processen.
Datavirtualisatie is een krachtige oplossing als je use case on-demand toegang tot meerdere databronnen vereist, bijvoorbeeld bij het bevragen van verschillende databases of API’s.
Streaming data-integratie verwerkt data in real time uit eventgedreven bronnen (bijv. IoT-apparaten, sociale mediaplatforms, financiële markten, etc.). In plaats van te wachten op batchprocessen, zorgt deze techniek ervoor dat data wordt binnengehaald en geïntegreerd zodra deze wordt gegenereerd.
Deze aanpak wordt gebruikt in scenario’s waar tijdige inzichten en snelle reacties nodig zijn. Streaming data-integratie is optimaal als je organisatie snel beslissingen moet nemen op basis van de meest actuele informatie of wanneer latency een aandachtspunt is.
Bekijk de Streaming Concepts-cursus om meer te leren over deze techniek.
De onderstaande tabel vat de verschillende technieken die we zojuist hebben besproken samen:
|
Techniek |
Beschrijving |
Het best geschikt voor |
Voorbeelden van use cases |
Voordelen |
|
ETL (Extract, Transform, Load) |
Traditionele methode waarbij data wordt geëxtraheerd, getransformeerd en geladen in een doelsysteem. |
Gestructureerde data die grondige opschoning en transformatie vereist voor rapportage, analytics of BI. |
Data uit meerdere bronnen consolideren in een datawarehouse voor batchverwerking en geplande updates. |
Zorgt voor schone, gestandaardiseerde en gestructureerde data die klaar is voor analyse. |
|
ELT (Extract, Load, Transform) |
Moderne variant van ETL waarbij data na het laden in het doelsysteem wordt getransformeerd. |
Grote datasets in cloudomgevingen, ongestructureerde data of behoeften aan transformatie in near-realtime. |
Ruwe data laden in een cloudgebaseerd datalake of datawarehouse voor flexibele, on-demand transformatie. |
Biedt flexibiliteit in wanneer en hoe transformaties worden toegepast. |
|
Datareplicatie |
Kopieert data van het ene systeem naar het andere om consistentie en beschikbaarheid tussen omgevingen te behouden. |
Eisen rond hoge beschikbaarheid en consistentie, disaster recovery en datasynchronisatie. |
On-premise en cloudsystemen synchroon houden of back-upkopieën maken voor disaster recovery. |
Verbetert de betrouwbaarheid van data en zorgt voor actuele databeschikbaarheid in systemen. |
|
Datavirtualisatie |
Maakt realtime toegang en bevraging van data mogelijk zonder fysieke verplaatsing of transformatie. |
Uiteenlopende databronnen waarbij realtime toegang nodig is, zonder de complexiteit van consolidatie. |
Data bevragen over meerdere databases of API’s om een uniforme weergave voor analytics te bieden zonder data te verplaatsen. |
Biedt realtime, uniforme weergaven van data uit diverse bronnen. |
|
Streaming data-integratie |
Verwerkt en integreert data in real time zodra deze wordt gegenereerd uit eventgedreven bronnen. |
Scenario’s die tijdige inzichten, snelle reacties of low-latency verwerking vereisen. |
Data verwerken van IoT-apparaten, financiële marktactiviteit monitoren of socialmediastromen realtime analyseren. |
Maakt snelle besluitvorming mogelijk op basis van actuele informatie. |
Architecturen voor data-integratie zijn kaders die bepalen hoe data wordt geconsolideerd en beheerd. Deze architecturen variëren afhankelijk van het type data, de opslagvereisten en de bedrijfsdoelen. Laten we de twee meest voorkomende bekijken.
Integratie in een datawarehouse richt zich op het centraliseren van data uit meerdere bronnen in een gestructureerde, uniforme opslag voor analytics en rapportage. In deze architectuur wordt data uit verschillende operationele systemen geëxtraheerd, getransformeerd en geladen (ETL) in het datawarehouse, waar het wordt opgeschoond en geordend.
Een datawarehouse stelt je in staat diepgaande analyses en rapportages uit te voeren, zodat alle businessunits toegang hebben tot nauwkeurige, actuele informatie. Deze architectuur is ideaal voor gestructureerde data en wanneer uitgebreide rapportage een belangrijk doel is.
Ik raad de excellente cursus Data Warehousing Concepts aan om meer te leren over deze alomtegenwoordige architectuur.
Datalakes zijn zeer geschikt voor teams die met verschillende datatypes en -formaten werken. Ze zijn ontworpen om grote hoeveelheden ongestructureerde, semi-gestructureerde en gestructureerde data in ruwe vorm op te slaan. Datalakes integreren data uit diverse bronnen (bijv. IoT-apparaten, social media en operationele systemen) zonder dat deze eerst hoeft te worden verwerkt of getransformeerd.
Deze architectuur is gunstig voor use cases die met big data werken, omdat het flexibele opslag en de mogelijkheid biedt om geavanceerde analytics, machine learning of verkennende analyses toe te passen.
Hier is een vergelijkende tabel die de verschillen tussen datawarehouses en datalakes in termen van data-integratie benadrukt:
|
Kenmerk |
Datawarehouse |
Datalake |
|
Datatypes |
Gestructureerde data (bijv. relationele tabellen). |
Gestructureerde, semi-gestructureerde (bijv. JSON, XML) en ongestructureerde data (bijv. audio, video, logs). |
|
Dataschema |
Schema-on-write: data moet voldoen aan een vooraf gedefinieerd schema. |
Schema-on-read: data kan in ruwe vorm worden ingeladen en bij het lezen worden gestructureerd. |
|
ETL/ELT-proces |
Vereist complexe ETL-processen om data vóór het laden op te schonen en te transformeren. |
Staat ELT toe: ruwe data wordt ingeladen en transformaties vinden plaats tijdens analyse of opvraging. |
|
Databronnen |
Integreert doorgaans met transactionele systemen, CRM, ERP, etc. |
Ondersteunt integratie uit diverse bronnen, waaronder IoT-apparaten, social media en bigdatasystemen. |
|
Datavolume |
Ontworpen voor kleinere volumes schone, hoogwaardige data. |
Verwerkt enorme volumes ruwe en diverse data op schaal. |
|
Integratietools |
Gespecialiseerde ETL-tools zoals Informatica, Talend of dbt. |
Bigdatatools zoals Apache Spark, Kafka, Flume en ELT-frameworks. |
|
Latency |
Richt zich op queries met lage latency voor business intelligence. |
Prioriteert vaak hoge doorvoer bij data-inname boven queryresponsen met lage latency. |
|
Data governance |
Strikte governance met goed gedefinieerde datakwaliteitscontroles. |
Flexibele governance, maar vereist extra tools voor robuuste datakwaliteit en herkomsttracking. |
|
Realtime data |
Minder geschikt voor realtime data-integratie. |
Ondersteunt realtime data-inname en streaming. |
|
Dataformaten |
Leunt op tabelvormige formaten (bijv. CSV, Excel, SQL-tabellen). |
Ondersteunt uiteenlopende formaten, waaronder Parquet, Avro, ORC, tekstbestanden en multimedia. |
Data-integratie biedt veel voordelen, maar gaat niet zonder uitdagingen. Om dit succesvol en efficiënt te implementeren, moet je weten hoe je deze uitdagingen overwint.
Een van de grootste uitdagingen bij data-integratie is het waarborgen van de datakwaliteit.
Wanneer data afkomstig is uit meerdere, uiteenlopende bronnen, is deze vaak inconsistent, onvolledig of onjuist. Deze problemen kunnen leiden tot onnauwkeurige analyses en gebrekkige besluitvorming. Om dit te voorkomen, moeten teams datacleaningprocessen implementeren die de data valideren, standaardiseren en corrigeren voordat deze wordt geïntegreerd. Dit kan onder meer inhouden: geautomatiseerde datakwaliteitscontroles instellen, dataprofilerings-tools gebruiken en transformaties toepassen om consistentie over alle bronnen te waarborgen.
Nu we het AI-tijdperk ingaan, is datakwaliteit belangrijker dan ooit. Dit is hét moment om er meer over te leren met de cursus Introduction to Data Quality.
Een andere uitdaging bij data-integratie is het omgaan met verschillende dataformaten in uiteenlopende systemen.
Data kan komen in JSON, XML, CSV of propriëtaire formaten, elk met andere schema’s of datamodellen. Het integreren van zulke diverse data vereist tools en technieken om data vanuit het oorspronkelijke formaat te transformeren en te mappen naar een gemeenschappelijke, bruikbare structuur.
Oplossingen zoals datatransformatie en schemamapping helpen data te standaardiseren.
Naarmate datavolumes groeien, wordt schaalbaarheid een cruciaal aandachtspunt in integratie. Grote hoeveelheden data, eisen aan integratie in real time en de toenemende complexiteit van databronnen kunnen traditionele integratiesystemen onder druk zetten.
Om schaalbaarheidsuitdagingen aan te pakken, kun je gebruikmaken van cloudplatforms, gedistribueerde computing en moderne integratietechnologieën die groeiende databehoeften aankunnen.
Het waarborgen van databeveiliging en compliance is een grote uitdaging – zeker bij de integratie van gevoelige of gereguleerde data. Processen voor data-integratie moeten data beschermen tijdens opslag, overdracht en toegang om ongeautoriseerd gebruik of datalekken te voorkomen.
Organisaties moeten versleuteling en toegangscontrole toepassen en zich houden aan regelgeving. Door beveiligingsmaatregelen en complianceprotocollen te prioriteren, beperk je het risico op datalekken en zorg je dat data aan industrienormen voldoet.
Laten we enkele van de populairste en krachtigste tools voor data-integratie van dit moment verkennen. Elke tool is geschikt voor andere bedrijfsomgevingen en datamanagementbehoeften.
Apache NiFi werd in 2014 ontwikkeld door de Apache Software Foundation. Het is een open-sourcetool die is ontworpen om de stroom van data tussen systemen te automatiseren. NiFi biedt een gebruiksvriendelijke drag-and-drop-interface voor het bouwen van datapijplijnen en ondersteunt een breed scala aan dataformaten.
Bedrijven die data naadloos en in real time tussen systemen willen verplaatsen, zullen veel baat hebben bij deze tool. Hij is zeer geschikt voor sectoren als de gezondheidszorg en de financiële wereld, waar data constant stroomt en snel, met minimale vertraging of fouten, moet worden verwerkt.
Fivetran, opgericht in 2013, is een cloudgebaseerde ELT (Extract, Load, Transform)-oplossing die dataverplaatsing en -synchronisatie over verschillende platforms automatiseert. De tool richt zich op het vereenvoudigen van het ETL-proces door gebruikers in staat te stellen datapijplijnen in te richten die automatisch met schemawijzigingen meebewegen.
Deze tool is bijzonder handig voor bedrijven die overstappen op cloudgebaseerde data-architecturen of hun datamanagement willen opschalen zonder veel overhead. Omdat Fivetran transformaties na het laden verwerkt (ELT), is het ideaal voor organisaties die in hun cloudomgeving eenvoud en schaalbaarheid prioriteren.
Microsoft Azure Data Factory is een cloudgebaseerde data-integratieservice die Microsoft in 2015 lanceerde. Het stelt gebruikers in staat om dataworkflows te maken, plannen en orkestreren over verschillende cloud- en on-premise omgevingen.
Azure Data Factory integreert goed met Microsofts suite van cloudservices en biedt een breed scala aan connectoren voor het integreren van data uit verschillende bronnen. Deze tool is ideaal voor ondernemingen die al in het Microsoft Azure-ecosysteem zitten, vooral als ze complexe data-integratie nodig hebben over hybride cloudomgevingen of on-premises systemen.
Bekijk de tutorial over het bouwen van je eerste Azure Data Factory-pijplijn.
Opgericht in 1993, is Informatica een toonaangevend enterpriseplatform voor data-integratie. Informatica staat bekend om zijn robuuste datatransformatievermogen, ondersteunt complexe integratieprocessen en wordt veel gebruikt door grote organisaties die aanzienlijke datavolumes verwerken.
Het platform biedt tools die datamigratie, governance en opschoning over meerdere systemen mogelijk maken. Informatica is ideaal in sectoren als financiën, gezondheidszorg en telecommunicatie, waar compliance, transformatie en hoge beschikbaarheid van data cruciaal zijn.
Wil je meer ontdekken? Bekijk dan onze lijst met de beste ETL-tools.
In dit artikel hebben we de kernaspecten van data-integratie verkend: van componenten en technieken tot de tools en architecturen die het aansturen.
We hebben gezien hoe data-integratie organisaties helpt om uiteenlopende databronnen te consolideren tot een uniforme, toegankelijke vorm, zodat ze met vertrouwen beslissingen kunnen nemen. Daarnaast hebben we de uitdagingen besproken die teams tijdens integratie tegenkomen en enkele belangrijke tools aangestipt om je op weg te helpen en het traject soepeler te maken.
Wil je je begrip van data-integratie verder verdiepen? Bekijk dan de volgende resources:
Leer meer over data engineering met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

