
Tecniche di integrazione dei dati
Ti chiedi qual è il modo migliore per integrare i dati? In questa sezione esploreremo le varie tecniche utilizzate per integrare i dati. Ogni tecnica è adatta a diversi tipi di ambienti ed esigenze. Diamo un'occhiata!
ETL (Extract, Transform, Load)
L'ETL è la tecnica tradizionale di integrazione dei dati. Prevede tre passaggi chiave:
- Estrazione dei dati da varie fonti
- Trasformazione dei dati in un formato comune
- Caricamento dei dati in un archivio di destinazione, di norma un data warehouse
Nella fase di estrazione, i dati vengono raccolti da sistemi diversi. La fase di trasformazione garantisce che i dati siano puliti, standardizzati e formattati per adattarsi a uno schema coerente. Infine, nella fase di caricamento, i dati trasformati vengono archiviati nel sistema di destinazione, dove diventano disponibili per analisi e reportistica.
L'ETL è ideale quando devi integrare e strutturare dati provenienti da fonti multiple e diverse per reportistica, analisi o business intelligence. È perfetto per le organizzazioni con dati strutturati che richiedono un'accurata pulizia e trasformazione prima dell'analisi.
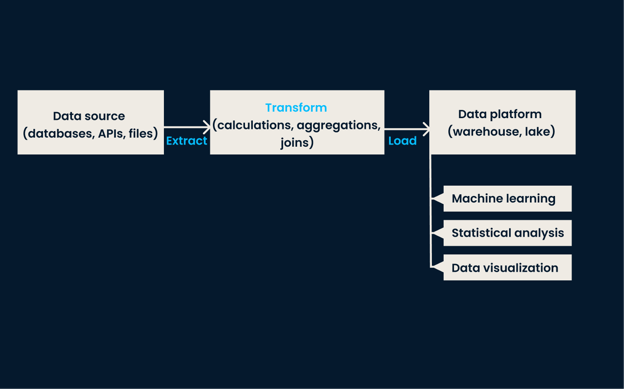
Esempio di architettura ETL
Questo approccio è particolarmente efficace in ambienti tradizionali on-premises con volumi di dati e complessità di trasformazione moderati. L'ETL è il metodo di riferimento se i tuoi dati richiedono elaborazione batch e aggiornamenti regolari.
ELT (Extract, Load, Transform)
ELT è una variante dell'ETL pensata per gestire i grandi dataset tipici degli ambienti cloud. In questo approccio, i dati vengono prima estratti e caricati nel sistema di destinazione e solo dopo il caricamento avviene la trasformazione.
In altre parole, l'ELT è ideale per le organizzazioni che devono caricare rapidamente grandi quantità di dati grezzi e trasformarli in un secondo momento. Questo concede maggiore flessibilità su come e quando applicare le trasformazioni. Se la tua azienda lavora con dati non strutturati o ha bisogno di trasformazioni quasi in tempo reale, l'ELT è preferibile all'ETL tradizionale.
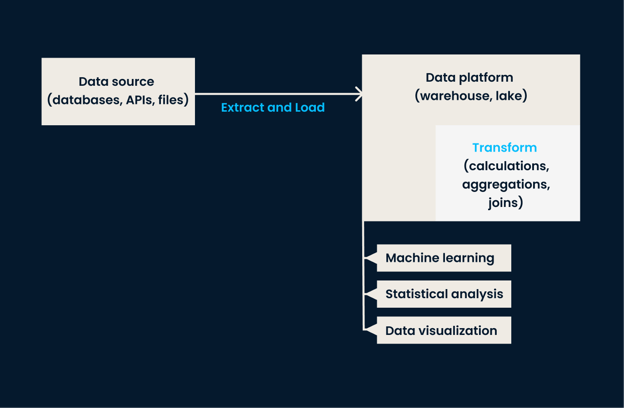
Esempio di architettura ELT
Se vuoi saperne di più su questi processi tradizionali di data engineering, ti consiglio di dare un'occhiata al corso ETL and ELT in Python!
Replica dei dati
La replica dei dati è il processo di copia dei dati da un sistema a un altro. Questa tecnica garantisce che tutti i sistemi lavorino con gli stessi dati e aiuta a mantenere sincronizzati ambienti diversi.
La replica può essere eseguita in tempo reale o a intervalli programmati, a seconda delle esigenze specifiche. Il suo principale vantaggio è migliorare la disponibilità e l'affidabilità dei dati, garantendo che i sistemi critici abbiano accesso coerente alle informazioni più aggiornate.
Questo approccio è più adatto a scenari in cui disponibilità elevata e coerenza tra sistemi sono fondamentali. È comunemente utilizzato per backup, disaster recovery e sincronizzazione dei dati tra ambienti diversi, ad esempio tra sistemi on-premises e cloud.
La replica dei dati è utile anche per applicazioni che richiedono accesso immediato a copie identiche dei dati in più sedi. Se la tua organizzazione deve garantire che i dati siano disponibili e aggiornati su diverse piattaforme o aree geografiche, la replica è un'ottima opzione.
Tieni conto che, tecnicamente, l'opzione di replica è di solito disponibile solo per i database tradizionali per creare copie esatte dei dati originali.
Virtualizzazione dei dati
La virtualizzazione dei dati è un approccio più moderno all'integrazione dei dati. Consente agli utenti di accedere e interrogare i dati in tempo reale senza spostarli o trasformarli fisicamente.
Invece di consolidare i dati in un unico repository, questa tecnica crea un livello virtuale che si collega a varie sorgenti dati e fornisce una vista unificata dei dati da più sistemi, rendendoli più facili da accedere e analizzare.
Questa tecnica funziona al meglio quando l'accesso ai dati in tempo reale è più importante dello spostamento o del consolidamento fisico dei dati. È ideale per organizzazioni con fonti dati eterogenee che vogliono creare una vista unificata senza la complessità e i ritardi dei processi ETL tradizionali.
La virtualizzazione dei dati è una soluzione potente se il tuo caso d'uso richiede accesso on-demand a più fonti dati, ad esempio quando si interroga tra vari database o API.
Integrazione di dati in streaming
L'integrazione di dati in streaming gestisce l'elaborazione in tempo reale dei dati provenienti da fonti event-driven (ad es. dispositivi IoT, piattaforme social, mercati finanziari, ecc.). Invece di attendere processi batch, questa tecnica consente di acquisire e integrare i dati non appena vengono generati.
Questo approccio si usa in scenari in cui servono insight tempestivi e risposte rapide. L'integrazione di dati in streaming è ottimale se la tua organizzazione deve prendere decisioni rapide basate sulle informazioni più aggiornate o se la latenza è un problema.
Dai un'occhiata al corso Streaming Concepts per saperne di più su questa tecnica.
La tabella seguente riassume le diverse tecniche appena discusse:
|
Tecnica |
Descrizione |
Più adatta per |
Casi d'uso esemplificativi |
Vantaggi |
|
ETL (Extract, Transform, Load) |
Metodo tradizionale che prevede estrazione, trasformazione e caricamento dei dati in un sistema di destinazione. |
Dati strutturati che richiedono un'accurata pulizia e trasformazione per report, analisi o BI. |
Consolidamento dei dati da più fonti in un data warehouse per elaborazione batch e aggiornamenti programmati. |
Garantisce dati puliti, standardizzati e strutturati pronti per l'analisi. |
|
ELT (Extract, Load, Transform) |
Variante moderna dell'ETL in cui i dati vengono trasformati dopo il caricamento nel sistema di destinazione. |
Grandi dataset in ambienti cloud, dati non strutturati o esigenze di trasformazione quasi in tempo reale. |
Caricamento di dati grezzi in un data lake o data warehouse basato su cloud per trasformazioni flessibili e on-demand. |
Offre flessibilità su quando e come applicare le trasformazioni. |
|
Replica dei dati |
Copia i dati da un sistema a un altro per mantenere coerenza e disponibilità tra gli ambienti. |
Requisiti di alta disponibilità e coerenza, disaster recovery e scenari di sincronizzazione dei dati. |
Mantenere sincronizzati sistemi on-premises e cloud o creare copie di backup per il disaster recovery. |
Migliora l'affidabilità dei dati e garantisce disponibilità di dati aggiornati tra i sistemi. |
|
Virtualizzazione dei dati |
Consente accesso e interrogazione dei dati in tempo reale senza spostamento o trasformazione fisica. |
Fonti dati eterogenee in cui serve accesso in tempo reale, senza la complessità del consolidamento. |
Interrogare dati tra più database o API per fornire una vista unificata per l'analisi senza spostare i dati. |
Fornisce viste unificate in tempo reale dei dati su fonti diverse. |
|
Integrazione di dati in streaming |
Elabora e integra i dati in tempo reale man mano che vengono generati da fonti event-driven. |
Scenari che richiedono insight tempestivi, risposte rapide o elaborazione a bassa latenza. |
Elaborazione dei dati da dispositivi IoT, monitoraggio dell'attività dei mercati finanziari o analisi in tempo reale di flussi social. |
Consente decisioni rapide basate su informazioni aggiornate. |
Architetture di integrazione dei dati
Le architetture di integrazione dei dati sono framework che determinano come i dati vengono consolidati e gestiti. Queste architetture variano in base al tipo di dati, ai requisiti di archiviazione e agli obiettivi di business. Vediamo le due più comuni.
Data warehouse
L'integrazione tramite data warehouse si concentra sulla centralizzazione dei dati da più fonti in un repository strutturato e unificato per analisi e reportistica. In questa architettura, i dati dei vari sistemi operativi vengono estratti, trasformati e caricati (ETL) nel data warehouse, dove vengono puliti e organizzati.
Un data warehouse ti permette di svolgere analisi approfondite e reportistica, assicurando che tutte le unità di business accedano a informazioni accurate e aggiornate. Questa architettura è ideale per dati strutturati e quando un reporting completo è un obiettivo chiave.
Ti consiglio l'eccellente corso Data Warehousing Concepts per approfondire questa architettura onnipresente.
Data lake
I data lake sono adatti ai team che lavorano con tipi e formati di dati eterogenei. Sono progettati per archiviare grandi volumi di dati non strutturati, semistrutturati e strutturati nella loro forma grezza. I data lake integrano dati da varie fonti (ad es. dispositivi IoT, social media e sistemi operativi) senza la necessità di essere prima processati o trasformati.
Questa architettura è utile per casi d'uso che gestiscono big data, poiché consente archiviazione flessibile e la possibilità di applicare analisi avanzate, machine learning o analisi esplorative.
Ecco una tabella comparativa che evidenzia le differenze tra data warehouse e data lake in termini di integrazione dei dati:
|
Caratteristica |
Data warehouse |
Data lake |
|
Tipi di dati |
Dati strutturati (ad es. tabelle relazionali). |
Dati strutturati, semistrutturati (ad es. JSON, XML) e non strutturati (ad es. audio, video, log). |
|
Schema dei dati |
Schema-on-write: i dati devono rispettare uno schema predefinito. |
Schema-on-read: i dati possono essere acquisiti in forma grezza e strutturati alla lettura. |
|
Processo ETL/ELT |
Richiede processi ETL complessi per pulire e trasformare i dati prima del caricamento. |
Consente ELT: i dati grezzi vengono acquisiti e le trasformazioni avvengono durante l'analisi o il recupero. |
|
Fonti dati |
In genere si integra con sistemi transazionali, CRM, ERP, ecc. |
Supporta l'integrazione da fonti eterogenee, inclusi dispositivi IoT, social media e sistemi big data. |
|
Volume dei dati |
Progettato per gestire volumi più piccoli di dati puliti e di alta qualità. |
Gestisce volumi massivi di dati grezzi e diversificati su larga scala. |
|
Strumenti di integrazione |
Strumenti ETL specializzati come Informatica, Talend o dbt. |
Strumenti big data come Apache Spark, Kafka, Flume e framework ELT. |
|
Latenza |
Si concentra su query a bassa latenza per la business intelligence. |
Spesso privilegia l'alta velocità di ingestione dei dati rispetto a risposte di query a bassa latenza. |
|
Data governance |
Governance rigorosa con controlli di qualità dei dati ben definiti. |
Governance flessibile, ma richiede strumenti aggiuntivi per una qualità dei dati robusta e il tracciamento della lineage. |
|
Dati in tempo reale |
Meno adatto all'integrazione di dati in tempo reale. |
Supporta l'acquisizione e lo streaming di dati in tempo reale. |
|
Formati dei dati |
Si basa su formati tabellari (ad es. CSV, Excel, tabelle SQL). |
Supporta formati vari, tra cui Parquet, Avro, ORC, file di testo e contenuti multimediali. |
Sfide nell'integrazione dei dati e come superarle
L'integrazione dei dati offre molti vantaggi, ma non è priva di sfide. Per implementarla in modo efficace ed efficiente, devi sapere come affrontarle.
Problemi di qualità dei dati
Una delle principali sfide che le aziende affrontano nell'integrazione dei dati è garantire la qualità dei dati.
Quando i dati provengono da fonti multiple e disparate, sono spesso incoerenti, mancanti o errati. Questi problemi possono portare ad analisi inaccurate e a decisioni sbagliate. Per superare ciò, i team devono implementare processi di data cleaning che convalidino, standardizzino e correggano i dati prima dell'integrazione. Questo può prevedere l'impostazione di controlli automatici di qualità, l'uso di strumenti di data profiling e l'applicazione di regole di trasformazione per garantire coerenza tra tutte le fonti.
Entrando nell'era dell'AI, la qualità dei dati è più importante che mai. Ora è il momento di approfondirla seguendo il corso Introduction to Data Quality.
Gestione di formati di dati diversi
Un'altra sfida nell'integrazione dei dati è gestire i vari formati di dati tra sistemi diversi.
I dati possono arrivare in JSON, XML, CSV o formati proprietari, ciascuno con schemi o modelli diversi. Integrare dati così eterogenei richiede strumenti e tecniche per trasformare e mappare i dati dal formato originale in una struttura comune e utilizzabile.
Soluzioni come la trasformazione dei dati e il mapping degli schemi aiutano a standardizzare i dati.
Preoccupazioni di scalabilità
Con la crescita dei volumi di dati, la scalabilità diventa una preoccupazione critica nell'integrazione. Grandi quantità di dati, esigenze di integrazione in tempo reale e la crescente complessità delle fonti possono mettere sotto stress i sistemi tradizionali di integrazione.
Per affrontare le sfide di scalabilità, puoi sfruttare piattaforme cloud, calcolo distribuito e tecnologie di integrazione moderne in grado di gestire esigenze di dati in crescita.
Sicurezza e conformità
Mantenere la sicurezza dei dati e la conformità rappresenta una sfida significativa – soprattutto quando si integrano dati sensibili o regolamentati. I processi di integrazione devono proteggere i dati durante l'archiviazione, il trasferimento e l'accesso per prevenire usi non autorizzati o violazioni.
Le organizzazioni devono implementare crittografia e controlli di accesso e aderire alle normative. Dando priorità alle misure di sicurezza e ai protocolli di conformità, puoi mitigare il rischio di violazioni e assicurare che i dati soddisfino gli standard del settore.
Strumenti per l'integrazione dei dati
Esploriamo alcuni degli strumenti di integrazione dei dati più popolari e potenti disponibili oggi. Ognuno è adatto a contesti aziendali e esigenze di gestione dei dati diversi.
Apache NiFi
Apache NiFi è stato creato dalla Apache Software Foundation nel 2014. È uno strumento open source progettato per automatizzare il flusso di dati tra i sistemi. NiFi fornisce un'interfaccia intuitiva drag-and-drop per costruire pipeline di dati e supporta un'ampia gamma di formati.
Le aziende che necessitano di spostare i dati senza soluzione di continuità tra sistemi in tempo reale troveranno questo strumento particolarmente utile. È molto adatto a settori come sanità e finanza, dove i dati fluiscono costantemente e devono essere elaborati rapidamente, con ritardi o errori minimi.
Fivetran
Fivetran, fondata nel 2013, è una soluzione ELT (Extract, Load, Transform) basata su cloud che automatizza lo spostamento e la sincronizzazione dei dati tra varie piattaforme. Il suo obiettivo principale è semplificare il processo ETL consentendo agli utenti di impostare pipeline che si adattano automaticamente ai cambiamenti di schema.
Questo strumento è particolarmente utile per le aziende che migrano verso architetture dati cloud o che vogliono scalare le pratiche di gestione dei dati senza overhead significativi. Poiché Fivetran gestisce le trasformazioni post-caricamento (ELT), è ideale per le organizzazioni che danno priorità a semplicità e scalabilità nei loro ambienti cloud.
Microsoft Azure Data Factory
Microsoft Azure Data Factory è un servizio di integrazione dei dati basato su cloud lanciato da Microsoft nel 2015. Consente di creare, pianificare e orchestrare workflow di dati tra vari ambienti cloud e on-premises.
Azure Data Factory si integra bene con la suite di servizi cloud di Microsoft e offre un'ampia gamma di connettori per integrare dati da fonti diverse. Questo strumento è ideale per le imprese già nell'ecosistema Microsoft Azure, specialmente quelle che richiedono integrazioni complesse tra ambienti ibridi cloud o sistemi on-premises.
Dai un'occhiata al tutorial su come creare la tua prima pipeline con Azure Data Factory.
Informatica
Fondata nel 1993, Informatica è una piattaforma leader a livello enterprise per l'integrazione dei dati. Nota per le sue solide capacità di trasformazione, supporta processi di integrazione complessi ed è ampiamente utilizzata da grandi organizzazioni che gestiscono volumi significativi di dati.
La piattaforma offre strumenti che facilitano migrazione, governance e pulizia dei dati su più sistemi. Informatica è ideale nei settori finanza, sanità e telecomunicazioni, dove conformità, trasformazione e alta disponibilità dei dati sono fondamentali.
Se vuoi esplorare di più, consulta la nostra lista dei migliori strumenti ETL.
Conclusione
In questo articolo abbiamo esplorato gli aspetti fondamentali dell'integrazione dei dati, dai suoi componenti e tecniche agli strumenti e alle architetture che la sostengono.
Abbiamo visto come l'integrazione aiuti le organizzazioni a consolidare fonti di dati eterogenee in un formato unificato e accessibile, così da prendere decisioni con maggiore sicurezza. Inoltre, abbiamo discusso le sfide che i team affrontano durante l'integrazione e toccato alcuni strumenti chiave per aiutarti a iniziare e rendere il percorso più fluido.
Per approfondire ulteriormente la tua comprensione dell'integrazione dei dati, ti consiglio di esplorare le seguenti risorse:
FAQ
Qual è la differenza tra ETL ed ELT nell'integrazione dei dati?
L'ETL prevede estrazione, trasformazione e poi caricamento dei dati, mentre l'ELT carica prima i dati e li trasforma in un secondo momento.
Perché l'integrazione dei dati è importante per le aziende?
L'integrazione dei dati consente una vista unificata delle informazioni provenienti da più fonti. Questo aiuta le aziende a prendere decisioni migliori e migliora l'efficienza.
Quali sono le principali sfide nell'integrazione dei dati?
Le sfide comuni includono problemi di qualità dei dati, gestione di formati eterogenei, preoccupazioni di scalabilità e garanzia di sicurezza e conformità.
In cosa differiscono i data lake dai data warehouse nell'integrazione?
I data lake archiviano grandi volumi di dati non strutturati o semistrutturati, mentre i data warehouse sono ottimizzati per dati strutturati e query analitiche.
Quali strumenti sono comunemente usati per l'integrazione dei dati?
Tra gli strumenti più diffusi ci sono Apache NiFi per automatizzare i flussi di dati, Fivetran per l'ELT su cloud e Azure Data Factory per orchestrare i workflow tra sistemi cloud.





Immagina sia il tuo primo giorno da medico in un nuovo ospedale. Un paziente entra e lamenta forti mal di testa nelle ultime due settimane. Dopo alcuni controlli, apri la sua cartella clinica per approfondire la storia. Con tua sorpresa, alcune informazioni sono online, altre si trovano nel sistema di un altro reparto e parti della sua storia sono mancanti. Ora sei bloccato. Hai un'idea di cosa possa causare i mal di testa, ma non puoi formulare una diagnosi con sicurezza senza avere tutte le informazioni in un unico posto.
L'integrazione dei dati permette di abbattere silos come quello descritto sopra. L'idea è dare alle persone accesso alle informazioni provenienti da più fonti in un unico luogo per aiutarle a prendere decisioni migliori (e ad essere più efficienti).
In questo articolo esploreremo l'integrazione dei dati in maggiore profondità. In particolare, scoprirai:
Iniziamo!
Che cos'è l'integrazione dei dati?
L'integrazione dei dati è il processo di combinare dati provenienti da fonti diverse in una vista unificata e coerente, accessibile e analizzabile in tutta l'organizzazione. Questo processo fa sì che le informazioni siano:
L'integrazione dei dati è rilevante quando i dati sono dispersi tra più piattaforme e reparti. Aiuta ad abbattere i silos e a migliorare l'efficienza operativa, con una comunicazione più fluida tra sistemi e team. E con una visione completa dei propri dati, le persone sono in una posizione migliore per prendere decisioni informate e strategiche.
Componenti dell'integrazione dei dati
Per integrare i dati in modo efficace entrano in gioco diversi componenti. Questi elementi assicurano che il flusso di dati da varie fonti verso una forma coesa e utilizzabile sia senza intoppi.
In questa sezione parleremo dei diversi componenti che lo rendono possibile.
Sorgenti dati
Le sorgenti dati sono i vari punti di origine da cui i dati vengono raccolti e integrati. Per esempio:
Un'integrazione efficace dei dati inizia con l'identificazione e la connessione di queste fonti eterogenee.
Trasformazione dei dati
Prima che i dati di varie fonti possano essere integrati, spesso devono essere trasformati in un formato comune. Perché? I dati del mondo reale sono spesso disordinati, e queste incoerenze possono infiltrarsi nei tuoi sistemi. Di conseguenza, i dati nelle tue fonti possono contenere errori come duplicati, formati incorretti o persino tipi di dato sbagliati. Tutti questi problemi vanno corretti o preprocessati per garantire che i dati siano allineati con la struttura del sistema di destinazione.
La trasformazione dei dati è il processo di pulizia, conversione e standardizzazione dei dati per garantirne la compatibilità tra sistemi diversi.
Archiviazione dei dati e sistemi di destinazione
Una volta integrati e trasformati, i dati devono essere archiviati in un sistema in cui possano essere facilmente accessibili e analizzati. Le opzioni di archiviazione comuni per i dati integrati includono: