
数据预处理的步骤
数据预处理包含若干步骤,每一步都针对数据质量、结构与相关性方面的特定挑战。
下面我们来看这些关键步骤,一般按如下顺序进行:
步骤 1:数据清洗
数据清洗是识别并纠正数据中的错误或不一致之处,以确保其准确与完整。目标是解决可能扭曲分析或影响模型性能的问题。
例如:
- 处理缺失值: 使用均值/众数填充、删除,或预测模型来填补或移除缺失数据。
- 去除重复: 消除重复记录,确保每条记录唯一且相关。
- 纠正不一致格式: 标准化格式(如日期格式、字符串大小写)以保持一致性。
以下是 Python 中的示例:
# Creating a manual dataset
data = pd.DataFrame({
'name': ['John', 'Jane', 'Jack', 'John', None],
'age': [28, 34, None, 28, 22],
'purchase_amount': [100.5, None, 85.3, 100.5, 50.0],
'date_of_purchase': ['2023/12/01', '2023/12/02', '2023/12/01', '2023/12/01', '2023/12/03']
})
# Handling missing values using mean imputation for 'age' and 'purchase_amount'
imputer = SimpleImputer(strategy='mean')
data[['age', 'purchase_amount']] = imputer.fit_transform(data[['age', 'purchase_amount']])
# Removing duplicate rows
data = data.drop_duplicates()
# Correcting inconsistent date formats
data['date_of_purchase'] = pd.to_datetime(data['date_of_purchase'], errors='coerce')
print(data)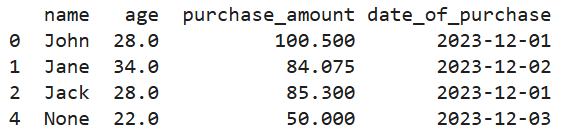
上述代码的输出
步骤 2:数据集成
数据集成是将来自多个来源的数据合并为统一的数据集。当数据来源于不同系统时,这通常是必要的。
常见的数据集成技术包括:
- 模式匹配: 对齐不同来源的字段与数据结构以确保一致性。
- 数据去重: 识别并移除跨多个数据集的重复条目。
例如,假设我们拥有来自多个数据库的客户数据。以下是如何将其合并为单一视图:
# Creating two manual datasets
data1 = pd.DataFrame({
'customer_id': [1, 2, 3],
'name': ['John', 'Jane', 'Jack'],
'age': [28, 34, 29]
})
data2 = pd.DataFrame({
'customer_id': [1, 3, 4],
'purchase_amount': [100.5, 85.3, 45.0],
'purchase_date': ['2023-12-01', '2023-12-02', '2023-12-03']
})
# Merging datasets on a common key 'customer_id'
merged_data = pd.merge(data1, data2, on='customer_id', how='inner')
print(merged_data)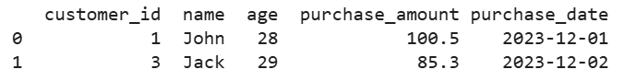
上述代码的输出
步骤 3:数据转换
数据转换是将数据转换为适合分析、机器学习或挖掘的格式。
例如:
- 缩放与归一化: 将数值调整到共同尺度,这对依赖距离度量的算法通常是必需的。
- 编码分类变量: 使用独热编码或标签编码将分类数据转换为数值。
- 特征工程与提取: 创建新特征或选择重要特征以提升模型表现。
以下演示如何在 Python 中使用 scikit-learn:
from sklearn.preprocessing import StandardScaler, OneHotEncoder
# Creating a manual dataset
data = pd.DataFrame({
'category': ['A', 'B', 'A', 'C', 'B'],
'numeric_column': [10, 15, 10, 20, 15]
})
# Scaling numeric data
scaler = StandardScaler()
data['scaled_numeric_column'] = scaler.fit_transform(data[['numeric_column']])
# Encoding categorical variables using one-hot encoding
encoder = OneHotEncoder(sparse_output=False)
encoded_data = pd.DataFrame(encoder.fit_transform(data[['category']]),
columns=encoder.get_feature_names_out(['category']))
# Concatenating the encoded data with the original dataset
data = pd.concat([data, encoded_data], axis=1)
print(data)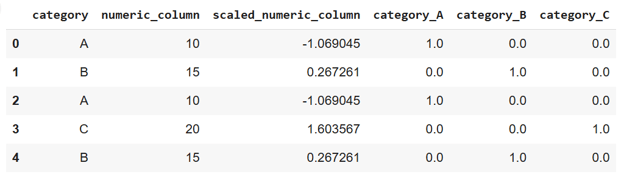
上述代码的输出
步骤 4:数据降维/约简
数据约简通过减少特征或记录数量来简化数据集,同时保留关键信息。这有助于在不牺牲准确度的前提下加速分析与模型训练。
常见技术包括:
- 特征选择: 选择对分析或模型表现贡献最大的特征。
- 主成分分析(PCA):一种降维技术,将数据转换到低维空间。
- 采样方法: 通过选择具有代表性的样本来减小数据集规模,适用于处理大数据集。
以下是如何在 Python 中实现降维:
from sklearn.decomposition import PCA
from sklearn.feature_selection import SelectKBest, chi2
# Creating a manual dataset
data = pd.DataFrame({
'feature1': [10, 20, 30, 40, 50],
'feature2': [1, 2, 3, 4, 5],
'feature3': [100, 200, 300, 400, 500],
'target': [0, 1, 0, 1, 0]
})
# Feature selection using SelectKBest
selector = SelectKBest(chi2, k=2)
selected_features = selector.fit_transform(data[['feature1', 'feature2', 'feature3']], data['target'])
# Printing selected features
print("Selected features (SelectKBest):")
print(selected_features)
# Dimensionality reduction using PCA
pca = PCA(n_components=2)
pca_data = pca.fit_transform(data[['feature1', 'feature2', 'feature3']])
# Printing PCA results
print("PCA reduced data:")
print(pca_data)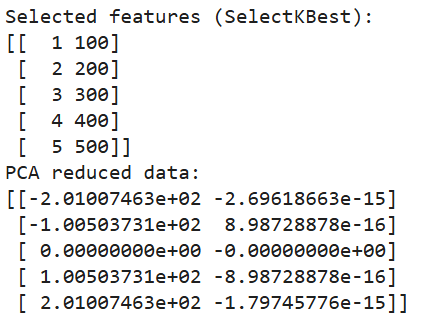
上述代码的输出
常见数据预处理技术与示例
我们已经明确,预处理原始数据对于确保其适合分析或机器学习模型至关重要,也介绍了相关步骤。
本节将探讨在预处理阶段应对常见问题的多种技术。此外,我们还将介绍数据增强,这是一种在图像或文本数据集等特定场景下用于创建合成数据的有用方法。
处理缺失数据
缺失数据会对机器学习模型或分析的性能产生负面影响。有效处理缺失值的策略包括:
- 插补(Imputation): 通过计算估计值填补缺失,例如可用数据的均值、中位数或众数。更高级的方法包括基于数据内部关系的预测建模来估计缺失值。
# Note: This is dummy code and not expected to run on its own
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='mean') # Replace 'mean' with 'median' or 'most_frequent' if needed
data['column_with_missing'] = imputer.fit_transform(data[['column_with_missing']])- 删除: 移除包含缺失值的行或列是直接的解决方案,但需谨慎使用,因为若缺失较多,可能造成有价值数据的流失。
data.dropna(inplace=True) # Removes rows with any missing values- 对缺失值建模: 当缺失模式更复杂时,可用机器学习模型根据其余数据预测缺失值,通过引入变量间关系来提升准确度。
离群点检测与处理
离群点是显著偏离其他数据的极端值,与缺失值类似,会扭曲分析并影响模型性能。常见检测与处理方法包括:
- Z 分数方法: 衡量数据点距均值的标准差数。超出某个阈值(如 ±3 个标准差)的点可视为离群点。
# Note: this is dummy code.
# It won’t work unless a data with a column named “column” is imported
from scipy import stats
z_scores = stats.zscore(data['column']) outliers = abs(z_scores) > 3 # Identifying outliers- 四分位距(IQR):IQR 是第一四分位数(Q1)与第三四分位数(Q3)之间的范围。超过 Q3 上方或 Q1 下方 1.5 倍 IQR 的值被视为离群点。
Q1 = data['column'].quantile(0.25)
Q3 = data['column'].quantile(0.75)
IQR = Q3 - Q1
outliers = (data['column'] < (Q1 - 1.5 * IQR)) | (data['column'] > (Q3 + 1.5 * IQR))- 可视化技术: 例如箱线图、散点图或直方图等可帮助检测数据集中的离群点。识别后可根据其对分析的影响选择删除或转换。
数据编码
处理分类数据时,需要进行编码,将类别转换为机器学习算法可处理的数值表示。常见编码技术包括:
- 独热编码:如前所述,该方法为每个类别创建二进制列。
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder(sparse_output=False)
encoded_data = encoder.fit_transform(data[['categorical_column']])- 标签编码: 为每个类别分配唯一数值。但若类别无自然顺序,该方法可能引入非预期的有序关系。
from sklearn.preprocessing import LabelEncoder
le = LabelEncoder()
data['encoded_column'] = le.fit_transform(data['categorical_column'])- 有序编码: 当分类变量具有内在顺序(如低、中、高)时使用。每个类别映射为反映其排序的整数值。
from sklearn.preprocessing import OrdinalEncoder
oe = OrdinalEncoder(categories=[['low', 'medium', 'high']])
data['ordinal_column'] = oe.fit_transform(data[['ordinal_column']])数据缩放与归一化
缩放与归一化可确保数值特征处于相近尺度,这对依赖距离度量的算法(如 KNN、SVM)尤为重要。
- 最小-最大缩放: 将数据缩放到指定范围(通常为 0 到 1)。当需要所有特征具有相同尺度时很有用。
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
data[['scaled_column']] = scaler.fit_transform(data[['numeric_column']])- 标准化(Z 分数归一化): 将数据缩放为均值为 0、标准差为 1,有助于模型在近似正态分布的特征上表现更佳。
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
data[['standardized_column']] = scaler.fit_transform(data[['numeric_column']])数据增强
数据增强通过创建新的合成样本来人为扩大数据集规模。对于深度学习中的图像或文本数据集尤其有用,此类模型需要大量数据以获得稳健表现。
- 图像增强: 通过旋转、翻转、缩放或加入噪声等技术,创建多样化样本以提升模型泛化能力。
from tensorflow.keras.preprocessing.image import ImageDataGenerator
datagen = ImageDataGenerator(
rotation_range=40,
width_shift_range=0.2,
height_shift_range=0.2,
shear_range=0.2,
zoom_range=0.2,
horizontal_flip=True,
fill_mode='nearest')
augmented_images = datagen.flow_from_directory('image_directory', target_size=(150, 150))- 文本增强: 对于文本数据,可使用同义词替换、随机插入、回译(将句子翻译为另一语言再译回原语言以引入变化)等方法。
import nlpaug.augmenter.word as naw
# install nlpaug here: https://github.com/makcedward/nlpaug
aug = naw.SynonymAug(aug_src='wordnet')
augmented_text = aug.augment("This is a sample text for augmentation.")数据预处理工具
尽管您可以用纯 Python 实现数据处理,但也有强大的工具可用于处理各类任务并提升整体效率。以下是一些示例:
Python 库
Python 中有不少专门的数据预处理库。以下三种最为流行:
- Pandas:Python 最常用的数据操作与清洗库。它提供灵活的数据结构,主要是 DataFrame 与 Series,便于高效处理与操作结构化数据。Pandas 支持处理缺失数据、合并数据集、筛选数据与重塑等操作。
import pandas as pd
# Load a sample dataset
data = pd.DataFrame({
'name': ['John', 'Jane', 'Jack'],
'age': [28, 31, 34]
})
print(data)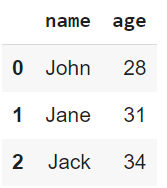
上述代码的输出
- NumPy: 用于数值计算的基础库。它支持大型多维数组与矩阵,并提供对这些数组进行操作的数学函数。NumPy 常作为许多更高层数据处理库(如 Pandas)的基础。
import numpy as np
# Create an array and perform element-wise operations
array = np.array([1, 2, 3, 4])
squared_array = np.square(array)
print(squared_array)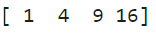
上述代码的输出
- Scikit-learn: 广泛用于机器学习任务,同时也提供众多预处理工具,如缩放、编码与数据转换。其预处理模块包含处理分类数据、数值数据缩放、特征提取等工具。
from sklearn.preprocessing import StandardScaler
# Standardize data
data = [[10, 2], [15, 5], [20, 3]]
scaler = StandardScaler()
scaled_data = scaler.fit_transform(data)
print(scaled_data)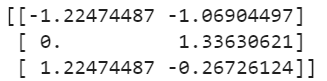
上述代码的输出
云平台
本地系统可能难以高效处理超大数据集。在这种情况下,云平台提供可扩展且高效的解决方案,使您能够在分布式系统上处理海量数据。
可考虑的云平台工具包括:
- AWS Glue:Amazon Web Services 提供的全托管 ETL 服务。它可自动发现与组织数据,并为分析做好准备。Glue 支持数据编目,并可连接 AWS 的 S3 与 Redshift 等服务。
- Azure Data Factory: Microsoft 的云端数据集成服务。它支持为大规模数据构建 ETL 与 ELT 流水线。Azure Data Factory 允许用户在各服务之间移动数据,使用转换进行预处理,并通过可视化界面编排工作流。
自动化工具
将预处理中的重复步骤自动化可以节省时间并减少错误——尤其在处理机器学习模型与大型数据集时。以下工具提供内置的预处理流水线:
- AutoML 平台:AutoML 是自动化机器学习的缩写(字面之意)。也就是说,这些平台会自动化机器学习流程中的多个阶段。平台如 Google 的 AutoML、Microsoft 的 Azure AutoML 与 H2O.ai 的 AutoML 提供自动化流水线,可在较少人工干预下完成特征选择、数据转换与模型选择等任务。
- scikit-learn 中的预处理流水线: Scikit-learn 提供了Pipeline 类,用于简化与自动化预处理步骤。它允许将多个预处理操作串联为单一可执行工作流,确保预处理任务一致地应用:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
# Example Pipeline combining different preprocessing tasks
numeric_transformer = Pipeline(steps=[
('imputer', SimpleImputer(strategy='mean')),
('scaler', StandardScaler())
])
categorical_transformer = Pipeline(steps=[
('imputer', SimpleImputer(strategy='most_frequent')),
('encoder', OneHotEncoder())
])
preprocessor = ColumnTransformer(transformers=[
('num', numeric_transformer, ['age']),
('cat', categorical_transformer, ['category'])
])
preprocessed_data = preprocessor.fit_transform(data)数据预处理最佳实践
遵循最佳实践对提升预处理效果至关重要。以下是我建议您考虑的做法:
理解数据
在开始预处理之前,务必深入理解数据集。进行探索性数据分析以识别数据结构。您需要具体了解:
- 关键特征
- 潜在异常
- 变量关系
若不先了解数据集特性,很可能会应用错误的预处理方法,从而扭曲数据。
自动化重复步骤
预处理往往包含重复性任务。通过构建流水线自动化这些任务,可确保一致性与效率,并降低人为错误概率。利用 scikit-learn 或云平台中的流水线功能来简化工作流程。
记录预处理步骤
清晰的文档可实现两个目标:
- 可复现性
- 可理解性(便于日后自己或团队成员理解)。
应记录每个决策、转换或筛选步骤及其理由。这将显著提升团队协作,并帮助您在中断后快速恢复项目进度。
迭代改进
数据预处理不是一次性任务——而应是迭代过程。随着模型的演进与性能反馈的产生,利用这些信息回访并优化预处理步骤,常能带来更好结果。例如,特征工程可能揭示新的有用特征,或优化离群点处理可提升模型精度——请据此更新您的预处理步骤。
结论
数据预处理在任何数据项目的成功中都扮演关键角色。恰当的预处理可将原始数据转化为干净、结构化的格式,帮助模型与分析产出更准确、更有意义的洞见。
本文介绍了多种帮助您实施数据预处理的技术。但最重要的是,这一过程并非一次性,而是持续迭代!不断打磨将带来更佳的模型表现与更好的决策。准备充分的数据集是任何数据与 AI 项目成功的基石。
若想继续学习,建议查看以下优质资源:

您的数据质量会直接影响分析结果的准确性与模型表现。原因在于,原始数据往往包含不一致、错误以及无关信息,这些都会扭曲结果并导致错误结论。数据预处理就是缓解这一问题的方法,也就是将原始数据转换为干净、结构化格式的过程。
在本文中,我将介绍:
让我们开始吧!
什么是数据预处理?
数据预处理是数据准备的关键环节。它指的是对原始数据施加的任何处理,使其准备好用于进一步的分析或处理任务。
传统上,数据预处理是数据分析的重要前置步骤。近年来,这些技术也被用于训练机器学习与 AI 模型,并从中进行推理。
因此,数据预处理可以定义为将原始数据转换为更高效、更准确地用于以下任务的格式的过程: