कुछ साल पहले तक, बड़े भाषा मॉडल से एक ढंग का ईमेल भी लिखवाना मुश्किल था। जब OpenAI ने अपना पहला ओपन-सोर्स मॉडल जारी किया, तो उसका सुसंगत पाठ जनरेट करना चौंकाने वाला था। कुछ ही सालों में, अब हमारे पास ऐसे AI मॉडल हैं जो पूर्ण सॉफ्टवेयर इंजीनियरिंग प्रोजेक्ट बना सकते हैं, मीटिंग्स बुक कर सकते हैं, Amazon पर प्रोडक्ट खरीद सकते हैं, और भी बहुत कुछ। 2026 में परिदृश्य काफी बदल गया है, और डेवलपर्स का सवाल है कि उनके उपयोग मामलों के लिए कौन-सा मॉडल सबसे उपयुक्त होगा।
इस सवाल के केंद्र में अब GPT-5.4 और Claude Opus 4.6 हैं। दोनों अलग-अलग तरीकों से सक्षम हैं, और दोनों कुछ ही हफ्तों के अंतर से लॉन्च हुए। हालांकि, दोनों मॉडलों की कीमतें अलग हैं और वे अलग-अलग परिदृश्यों में सर्वोत्तम प्रदर्शन करते हैं।
पिछले हफ्ते से मैं उनके रिलीज़ रिपोर्ट और स्वतंत्र लीडरबोर्ड्स में गहराई से देख रहा हूँ। इस लेख में, मैं आपको अपनी खोजों से परिचित कराऊंगा ताकि आप अपने वर्कफ़्लो के लिए सर्वश्रेष्ठ मॉडल चुन सकें।
Claude Opus 4.6 क्या है?
Claude Opus 4.6 अब तक का Anthropic का सबसे सक्षम मॉडल है। Opus 4.6 पिछले मॉडल का उन्नयन है, जिसमें कोडिंग और लंबे समय तक चलने वाले एजेंटिक कार्यों में प्रमुख सुधार किए गए हैं। Anthropic का कहना है कि यह प्लानिंग, कोड रिव्यू और डिबगिंग में बेहतर प्रदर्शन करता है, और यहां तक कि अपनी गलतियां भी खुद पकड़ लेता है।
Claude Opus 4.6 की प्रमुख विशेषताएं और क्षमताएं
Anthropic ने Opus 4.6 को 1M टोकन कॉन्टेक्स्ट विंडो (बीटा) के साथ जारी किया है, जिसमें अधिकतम 128K टोकन आउटपुट है। इससे मॉडल बड़े कोडबेस में काम कर सकता है और डोक्यूमेंटेशन जैसे बड़े दस्तावेज़ों को इनपुट के रूप में ले सकता है।
इस रिलीज़ में एडैप्टिव थिंकिंग भी शामिल है, यानी अब Claude यह तय कर सकता है कि विस्तारित सोच कब सक्षम की जाए, बजाय इसके कि आप इसे मैन्युअली ऑन करें।
Claude Opus 4.6 तय कर सकता है कि किसी चीज़ के लिए त्वरित सुधार पर्याप्त है या फिर अधिक समय लेकर तर्क करने और समाधान की योजना बनाने की जरूरत है। मुझे लगता है कि यह जटिल इंजीनियरिंग समस्याओं को हल करने में बहुत उपयोगी होगा। यह कोई आश्चर्य नहीं कि यह मॉडल टेक्स्ट और कोडिंग एरीना लीडरबोर्ड में शीर्ष पर है।
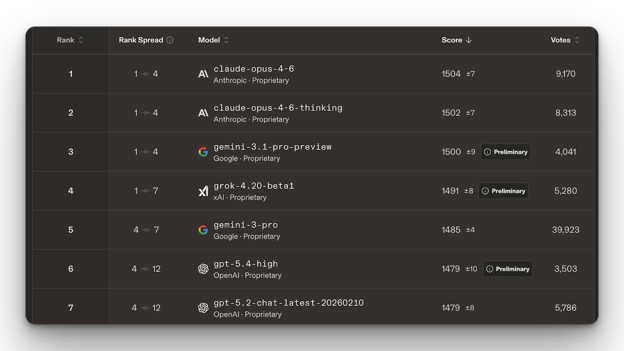
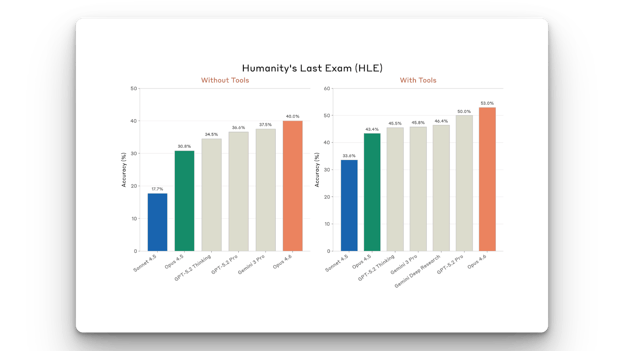
कोडिंग बेंचमार्क में, Claude Opus 4.6 ने SWE-Bench Verified पर 81.42% स्कोर किया, जो मापता है कि कोई मॉडल वास्तविक GitHub इश्यूज़ को कितना अच्छा सुलझाता है। यह मॉडल Humanity’s Last Exam में भी सर्वश्रेष्ठ रहा।
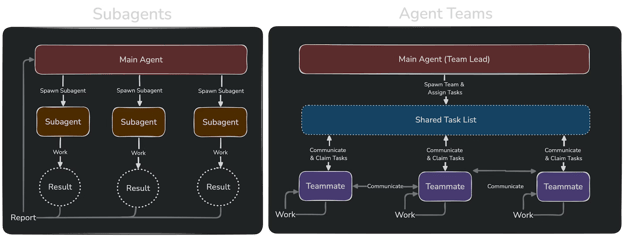
Opus 4.6 के साथ, Claude ने एजेंट टीमें नामक एक प्रायोगिक सुविधा भी Claude Code में पेश की। इसे ऑन करने पर, आप कई एजेंट्स को कार्यों पर लगाने के लिए स्पिन-अप कर सकते हैं। एजेंट्स साझा कार्यों और इंटर-एजेंट मैसेजिंग के साथ एक टीम की तरह काम करते हैं।
आप हमारे Claude Code ट्यूटोरियल से यह सीख सकते हैं कि Anthropic के Claude Code का उपयोग Supabase Python लाइब्रेरी के व्यावहारिक उदाहरण के माध्यम से सॉफ्टवेयर डेवलपमेंट वर्कफ़्लो कैसे बेहतर किए जा सकते हैं।
Claude Opus 4.6 के फायदे और कमियां
Claude Opus 4.6 एक बहुत ही मजबूत एजेंटिक मॉडल है। दरअसल, OpenClaw के निर्माता इसे OpenClaw में इस्तेमाल करने की सलाह देते हैं क्योंकि इसे प्रॉम्प्ट इंजेक्शंस से जहर देना मुश्किल है। इससे मॉडल दुर्भावनापूर्ण कोड के प्रति अधिक सुदृढ़ बनता है।
एजेंट्स टीमें सुविधा, भले ही अभी प्रायोगिक हो, सबएजेंट्स से एक बड़ा अपग्रेड है। इसके साथ, आप अपना कार्य कई Claude एजेंट्स में बांट सकते हैं। उदाहरण के लिए, एक बैकएंड संभाल सकता है, दूसरा फ्रंटएंड, और एक अन्य टेस्ट चला सकता है। प्रत्येक एजेंट की अपनी कॉन्टेक्स्ट विंडो होती है, जिससे कॉन्टेक्स्ट विंडो सीमाओं के कारण कार्य विफलता का जोखिम घटता है।
Claude Opus 4.6 एक सशक्त मॉडल है, लेकिन जैसा कहा जाता है, फ्री लंच जैसा कुछ नहीं होता। यह मॉडल चलाने में सस्ता नहीं है, खासकर यदि आप हेवी यूज़र हैं।
इसी बीच, Anthropic ने इसका सक्सेसर मॉडल प्रकाशित कर दिया है। हमारी Claude Opus 4.7 गाइड भी अवश्य देखें!
GPT-5.4 क्या है?
GPT-5.4 OpenAI का सबसे हालिया और सबसे सक्षम मॉडल है। इसे GPT-5.3-Codex की कोडिंग क्षमताओं को जोड़कर और रीजनिंग जोड़कर एक एकल शक्तिशाली मॉडल के रूप में बनाया गया है। यानी अब आपको कोडिंग के लिए Codex मॉडल और अन्य कार्यों के लिए अन्य OpenAI मॉडलों के बीच स्विच करने की जरूरत नहीं है।
GPT-5.4 की प्रमुख विशेषताएं और क्षमताएं
GPT-5.4 की जो विशेषता मुझे सबसे रोचक लगी, वह है कंप्यूटर उपयोग क्षमताएं। OSWorld पर, जो किसी मॉडल की डेस्कटॉप कंप्यूटर का उपयोग करने की क्षमता को मापता है, GPT-5.4 ने 75.0% स्कोर किया, जबकि मानव प्रदर्शन 72.4% था। संदर्भ के लिए, GPT-5.2 ने इसी टेस्ट पर 47.3% स्कोर किया था।
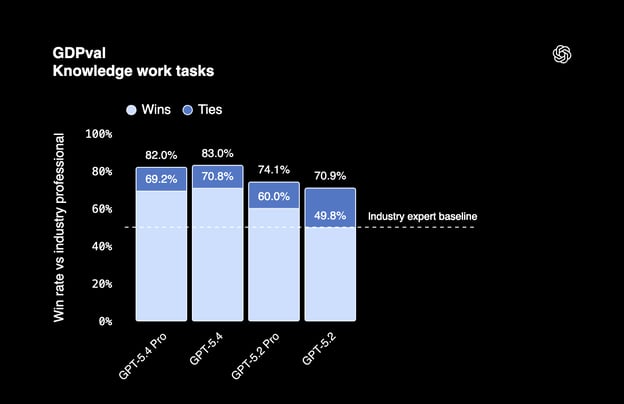
GDPval पर, जो 44 व्यवसायों में प्रोफ़ेशनल नॉलेज वर्क को परखता है, GPT-5.4 ने 83% स्कोर किया। इसका मतलब है कि यह मॉडल शीर्ष अमेरिकी नौकरियों में एजेंटिक कार्य प्रोफ़ेशनल स्तर पर कर सकता है।
GPT-5.4 में टोकन दक्षता भी है, यानी यह कई कार्यों के लिए पिछले मॉडलों की तुलना में कम टोकन उपयोग करता है। यदि आप प्रतिदिन कई रिक्वेस्ट चलाते हैं, तो यह ध्यान देने योग्य बात है।
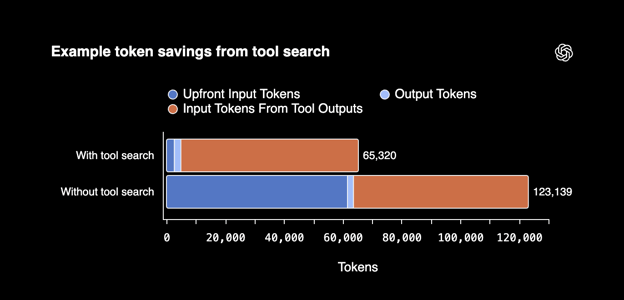
GPT-5.4 ने टूल सर्च सिस्टम भी पेश किया है, जो मॉडल को कई टूल्स दिए जाने पर अधिक कुशलता से काम करने में सक्षम बनाता है। प्रॉम्प्ट में टूल डेफिनिशन शामिल करने के बजाय, जिससे अधिक टोकन जुड़ते हैं, अब मॉडल को टूल्स की सूची और एक सर्च क्षमता दी जाती है। जब मॉडल को किसी टूल की जरूरत होती है, तो वह उसे खोजकर उस विशेष बातचीत में जोड़ देता है। इससे टोकन दक्षता बेहतर होती है।
GPT-5.4 के फायदे और कमियां
जो बात मुझे सबसे प्रभावशाली लगती है, वह है स्वायत्त कंप्यूटर उपयोग में GPT-5.4 की मानवों से बेहतर क्षमता। इस क्षेत्र में यह Claude Opus 4.6 को पछाड़ता है, OSWorld बेंचमार्क पर 75% स्कोर के साथ, जबकि Opus 4.6 का स्कोर 72.7% है।
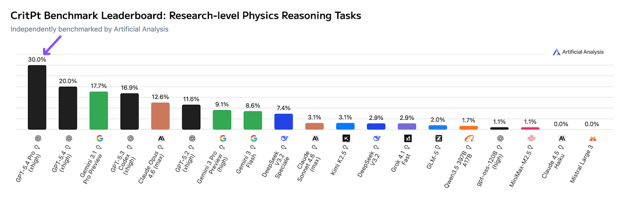
Artificial Analysis के स्वतंत्र शोध के अनुसार, GPT 5.4 (xhigh) ने CritPt बेंचमार्क पर 30% का स्कोर हासिल किया, जो LLMs को शोध-स्तरीय भौतिकी तर्क कार्यों पर परखता है और 71 समग्र शोध चुनौतियां शामिल करता है।
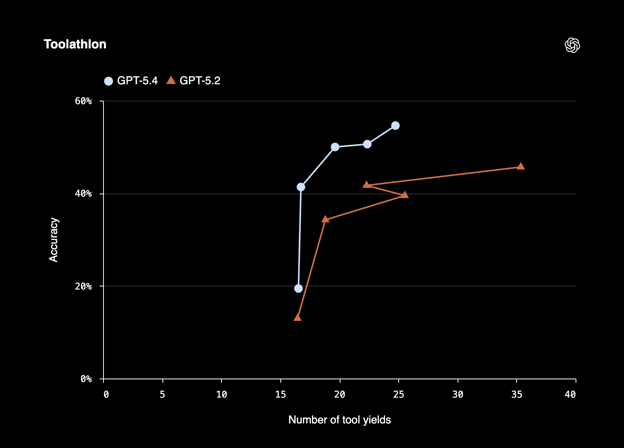
GPT-5.4 टूल कॉलिंग में अधिक बेहतर और सटीक है। रिलीज़ रिपोर्ट में, OpenAI बताता है कि Toolathlon पर, जो एजेंट्स के वास्तविक दुनिया के टूल्स और APIs से बहु-चरणीय कार्य पूरे करने की क्षमता को परखता है, यह कम चरणों में बेहतर परिणाम प्राप्त करता है।
Claude Opus 4.6 की तरह, GPT-5.4 भी सस्ता मॉडल नहीं है। सौभाग्य से, OpenAI बैच इन्फरेंस API पर कम कीमतें देता है।
GPT-5.4 बनाम Claude Opus 4.6: आमने-सामने तुलना
अब जब आपने GPT-5.4 और Opus 4.6 के फायदे और कमियां देख ली हैं, तो आइए उनकी तुलना करें ताकि यह तय किया जा सके कि आपके उपयोग मामलों के लिए कौन-सा बेहतर है।
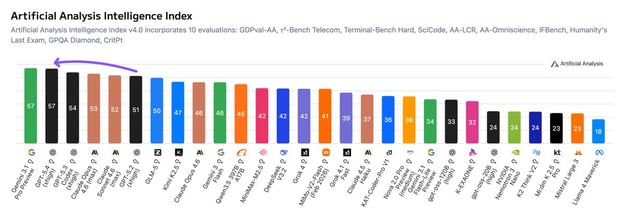
कुल मिलाकर, Artificial Analysis Intelligence Index के अनुसार GPT-5.4 सबसे अच्छा मॉडल है, जो विभिन्न बेंचमार्क्स पर मॉडलों के प्रदर्शन को मापता है। इसे केवल Gemini 3.1 Pro मात देता है।
एजेंटिक और कंप्यूटर उपयोग प्रदर्शन
मल्टी-एजेंट ऑर्केस्ट्रेशन में Claude Opus 4.6 आगे है। इसकी एजेंट टीमें सुविधा के साथ, आप अलग-अलग कार्यों पर काम करने वाले समानांतर एजेंट्स के साथ कई वर्कफ़्लो चला सकते हैं।
कंप्यूटर उपयोग में GPT-5.4 मामूली बढ़त लेता है। यदि आपके एजेंट को डेस्कटॉप ऑपरेट करना, ब्राउज़र नेविगेट करना, या GUI-आधारित सॉफ़्टवेयर से इंटरैक्ट करना है, तो फिलहाल GPT-5.4 बेहतर विकल्प है
कोडिंग बेंचमार्क
Claude Opus 4.6 बेहतर प्रोग्रामर है, SWE-Bench Verified पर 80.84% स्कोर के साथ और एक संशोधित प्रॉम्प्ट का उपयोग करते समय 81.4% के साथ।
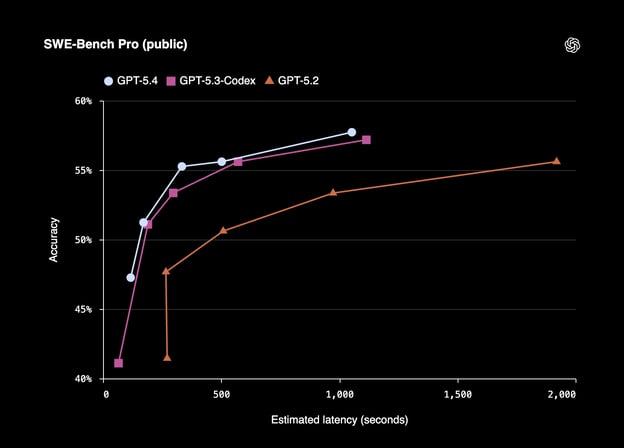
GPT-5.4 ने GPT-5.3-Codex की कोडिंग क्षमताएं विरासत में पाई हैं। OpenAI के अनुसार, GPT-5.4 ने SWE-Bench Pro (Public) पर 57.7% स्कोर हासिल किया है, और रीजनिंग कार्यों में कम लेटेंसी दिखाता है।
लागत और टोकन दक्षता
अपनी रिपोर्ट में, OpenAI का दावा है कि GPT-5.4 ने कुछ कार्यों पर टोकन उपयोग में 47% की कमी दिखाई। Opus 4.6 से महंगा होने के बावजूद, इस टोकन कमी के कारण बड़े पैमाने पर GPT-5.4 चलाना सस्ता पड़ सकता है।
हालांकि, कम लेकिन जटिल एजेंटिक कार्यों के लिए Opus 4.6 अब भी बेहतर मॉडल हो सकता है।
संदर्भ के लिए, सबसे शक्तिशाली GPT-5.4 मॉडल (कॉन्टेक्स्ट लंबाई>272K) की कीमत 1M इनपुट टोकन के लिए $60 और 1M आउटपुट टोकन के लिए $270 है, जबकि Claude Opus 4.6 की कीमत 1M इनपुट टोकन के लिए $5 और 1M आउटपुट टोकन के लिए $25 है।
कॉन्टेक्स्ट विंडो और मेमोरी
GPT-5.4 और Claude Opus 4.6 दोनों 1M टोकन तक का कॉन्टेक्स्ट सपोर्ट करते हैं, हालांकि Claude का बीटा में है। इससे दोनों मॉडल बड़े कोडबेस पर काम करने के लिए मजबूत दावेदार बनते हैं।
तुलनात्मक तालिका
|
श्रेणी
|
Claude Opus 4.6
|
GPT-5.4
|
|
एजेंटिक कार्य
|
मजबूत (एजेंट टीमें, पैरेलल ऑर्केस्ट्रेशन)
|
मजबूत (कंप्यूटर उपयोग, OSWorld 75%)
|
|
कोडिंग बेंचमार्क
|
SWE-Bench 80.2% विथ थिंकिंग
|
SWE-Bench Pro (Public) पर 57.7%
|
|
कंप्यूटर उपयोग
|
OSWorld पर 72.7%
|
OSWorld 75% (मानव विशेषज्ञों को मात)
|
|
कॉन्टेक्स्ट विंडो
|
1M टोकन (बीटा), 128K अधिकतम आउटपुट
|
1M टोकन
|
|
नॉलेज वर्क
|
Humanity's Last Exam लीडर
|
GDPval 83%
|
|
प्राइसिंग (इनपुट/आउटपुट)
|
$5 बेस इनपुट टोकन
प्रति मिलियन टोकन $25 आउटपुट टोकन
|
gpt-5.4 (<272K कॉन्टेक्स्ट लंबाई) की कीमत 1M इनपुट टोकन के लिए $2.50 और 1M आउटपुट टोकन के लिए $15.00 है। बड़े कॉन्टेक्स्ट विंडो वाले मॉडल अधिक महंगे हैं।
|
|
टोकन दक्षता
|
मानक
|
कुछ कार्यों पर 47% कम टोकन
|
|
किसके लिए सर्वश्रेष्ठ
|
लंबे समय तक चलने वाले एजेंट्स, जटिल कोडबेस
|
कंप्यूटर उपयोग, डॉक वर्कफ़्लो, एंटरप्राइज
|
GPT-5.4 बनाम Claude Opus 4.6: आपको कौन-सा चुनना चाहिए?
अंत में, सबसे महत्वपूर्ण सवाल का जवाब दें: इन दोनों में से आपको किसे चुनना चाहिए?
आपको Claude Opus 4.6 चुनना चाहिए, यदि…
- आप ऐसे एजेंट बना या चला रहे हैं जो लंबे समय तक बड़े कोडबेस के भीतर काम करते हैं।
- आप मल्टी-एजेंट वर्कफ़्लोज़ चाहते हैं, जहां अलग-अलग एजेंट समानांतर में काम करें और एक-दूसरे को कार्य सौंपें।
- आपके वर्कफ़्लो में बहुत लंबे दस्तावेज़, लंबी कोड फ़ाइलें, या बड़े कॉन्टेक्स्ट को थामे रखने की जरूरत वाले कार्य शामिल हैं।
- आप पहले से Anthropic इकोसिस्टम में हैं, और आपकी टीम Claude के साथ सहज है।
आपको GPT-5.4 चुनना चाहिए, यदि…
- आपके AI एजेंट को कंप्यूटर चलाने की जरूरत है—क्लिक करना, टाइप करना, एप्लिकेशन नेविगेट करना, और फ़ॉर्म अपने आप भरना।
- आप वित्त, क़ानून, या ऑपरेशन्स जैसे प्रोफ़ेशनल डोमेन्स में काम करते हैं और चाहते हैं कि मॉडल इंडस्ट्री प्रोफ़ेशनल के स्तर पर प्रदर्शन करे।
- आप बड़े पैमाने पर अपनी API लागत घटाना चाहते हैं। कुछ कार्यों पर 47% टोकन दक्षता में सुधार रोज़ाना हज़ारों कम्प्लीशंस में जोड़ कर बड़ा फर्क लाता है।
- आप बिना स्पेशलिस्ट मॉडलों के बीच स्विच किए, हर चीज़ के लिए एक ही मॉडल चाहते हैं।
भविष्य की दिशा
Anthropic के मॉडल लंबे समय से कोडिंग के लिए पसंदीदा रहे हैं, लेकिन वे क्रिएटिव राइटिंग जैसे अप्रत्याशित क्षेत्रों में भी चमकते हैं। वास्तव में, बहुत से लोग तर्क देंगे कि इस काम में वे सर्वश्रेष्ठ हैं।
लेकिन Anthropic ने कभी सार्वजनिक रूप से यह नहीं कहा कि उनके मॉडल किसी विशिष्ट कार्य में विशेषज्ञ हैं, जैसा कि OpenAI ने कहा था कि Codex मॉडल विशेष रूप से प्रोग्रामिंग के लिए है।
मुझे यह बेहद दिलचस्प लगता है कि अब OpenAI Anthropic की दिशा में बढ़ रहा है। अपनी नवीनतम रिलीज़ के साथ, वे एक एकीकृत मॉडल की ओर बढ़ रहे हैं जो प्रोफ़ेशनल कार्यों की एक विस्तृत श्रृंखला संभालता है। यह उपयोगकर्ताओं के लिए बहुत बड़ा फ़ायदा है; कोई भी अपना काम करने के लिए लगातार स्पेशलिस्ट मॉडलों के बीच स्विच नहीं करना चाहता।
दूसरी ओर, यह देखना अच्छा है कि Anthropic ने 1M कॉन्टेक्स्ट विंडो को अपनाया है, जो अन्य मॉडलों (जैसे Gemini 3) में लंबे समय से है। मुझे लगता है कि भविष्य में इन मॉडलों में बहुत मिलती-जुलती विशेषताएं होंगी, जिससे उपयोगकर्ताओं के लिए निर्णायक भेद बहुत कम रह जाएंगे। फिर भी, अलग-अलग कार्यों पर मॉडल का प्रदर्शन ही मुख्य अंतरकर्ता होगा, क्योंकि उपयोगकर्ता उन मॉडलों को पसंद करेंगे जो उनके विशिष्ट वर्कफ़्लो पर अच्छा करते हैं।
निष्कर्ष
2026 में, Anthropic और OpenAI दोनों के पास एजेंटिक कार्यों के लिए मजबूत मॉडल हैं। जो बात आपको उलझन में डाल सकती है, वह यह है कि वे अलग-अलग बेंचमार्क रिपोर्ट करते हैं—संभवतः वहीं चुनते हैं जहां उनके मॉडल चमकते हों।
अब आपको अन्य बेंचमार्क्स के लिए स्वतंत्र विश्लेषणों का सहारा लेना होगा और अपने उपयोग मामलों पर उन्हें खुद परखना होगा। जो स्पष्ट है, वह यह कि मॉडल बेहतर हो रहे हैं। और आपको भी उन्हें इस्तेमाल करने में बेहतर होना चाहिए।
इस एजेंटिक मूवमेंट में पीछे न छूटने का एक तरीका है इन मॉडलों का सॉफ्टवेयर इंजीनियरिंग में प्रभावी उपयोग सीखना। मैं सलाह दूंगा कि आप हमारे Software Development with Cursor कोर्स में मुफ्त में दाखिला लेकर शुरुआत करें। आप Introduction to Claude Models कोर्स और OpenAI Fundamentals स्किल ट्रैक भी कर सकते हैं।


कुछ साल पहले तक, बड़े भाषा मॉडल से एक ढंग का ईमेल भी लिखवाना मुश्किल था। जब OpenAI ने अपना पहला ओपन-सोर्स मॉडल जारी किया, तो उसका सुसंगत पाठ जनरेट करना चौंकाने वाला था। कुछ ही सालों में, अब हमारे पास ऐसे AI मॉडल हैं जो पूर्ण सॉफ्टवेयर इंजीनियरिंग प्रोजेक्ट बना सकते हैं, मीटिंग्स बुक कर सकते हैं, Amazon पर प्रोडक्ट खरीद सकते हैं, और भी बहुत कुछ। 2026 में परिदृश्य काफी बदल गया है, और डेवलपर्स का सवाल है कि उनके उपयोग मामलों के लिए कौन-सा मॉडल सबसे उपयुक्त होगा।
इस सवाल के केंद्र में अब GPT-5.4 और Claude Opus 4.6 हैं। दोनों अलग-अलग तरीकों से सक्षम हैं, और दोनों कुछ ही हफ्तों के अंतर से लॉन्च हुए। हालांकि, दोनों मॉडलों की कीमतें अलग हैं और वे अलग-अलग परिदृश्यों में सर्वोत्तम प्रदर्शन करते हैं।
पिछले हफ्ते से मैं उनके रिलीज़ रिपोर्ट और स्वतंत्र लीडरबोर्ड्स में गहराई से देख रहा हूँ। इस लेख में, मैं आपको अपनी खोजों से परिचित कराऊंगा ताकि आप अपने वर्कफ़्लो के लिए सर्वश्रेष्ठ मॉडल चुन सकें।
Claude Opus 4.6 क्या है?
Claude Opus 4.6 अब तक का Anthropic का सबसे सक्षम मॉडल है। Opus 4.6 पिछले मॉडल का उन्नयन है, जिसमें कोडिंग और लंबे समय तक चलने वाले एजेंटिक कार्यों में प्रमुख सुधार किए गए हैं। Anthropic का कहना है कि यह प्लानिंग, कोड रिव्यू और डिबगिंग में बेहतर प्रदर्शन करता है, और यहां तक कि अपनी गलतियां भी खुद पकड़ लेता है।
Claude Opus 4.6 की प्रमुख विशेषताएं और क्षमताएं
Anthropic ने Opus 4.6 को 1M टोकन कॉन्टेक्स्ट विंडो (बीटा) के साथ जारी किया है, जिसमें अधिकतम 128K टोकन आउटपुट है। इससे मॉडल बड़े कोडबेस में काम कर सकता है और डोक्यूमेंटेशन जैसे बड़े दस्तावेज़ों को इनपुट के रूप में ले सकता है।
इस रिलीज़ में एडैप्टिव थिंकिंग भी शामिल है, यानी अब Claude यह तय कर सकता है कि विस्तारित सोच कब सक्षम की जाए, बजाय इसके कि आप इसे मैन्युअली ऑन करें।
Claude Opus 4.6 तय कर सकता है कि किसी चीज़ के लिए त्वरित सुधार पर्याप्त है या फिर अधिक समय लेकर तर्क करने और समाधान की योजना बनाने की जरूरत है। मुझे लगता है कि यह जटिल इंजीनियरिंग समस्याओं को हल करने में बहुत उपयोगी होगा। यह कोई आश्चर्य नहीं कि यह मॉडल टेक्स्ट और कोडिंग एरीना लीडरबोर्ड में शीर्ष पर है।
कोडिंग बेंचमार्क में, Claude Opus 4.6 ने SWE-Bench Verified पर 81.42% स्कोर किया, जो मापता है कि कोई मॉडल वास्तविक GitHub इश्यूज़ को कितना अच्छा सुलझाता है। यह मॉडल Humanity’s Last Exam में भी सर्वश्रेष्ठ रहा।
Opus 4.6 के साथ, Claude ने एजेंट टीमें नामक एक प्रायोगिक सुविधा भी Claude Code में पेश की। इसे ऑन करने पर, आप कई एजेंट्स को कार्यों पर लगाने के लिए स्पिन-अप कर सकते हैं। एजेंट्स साझा कार्यों और इंटर-एजेंट मैसेजिंग के साथ एक टीम की तरह काम करते हैं।
आप हमारे Claude Code ट्यूटोरियल से यह सीख सकते हैं कि Anthropic के Claude Code का उपयोग Supabase Python लाइब्रेरी के व्यावहारिक उदाहरण के माध्यम से सॉफ्टवेयर डेवलपमेंट वर्कफ़्लो कैसे बेहतर किए जा सकते हैं।
Claude Opus 4.6 के फायदे और कमियां
Claude Opus 4.6 एक बहुत ही मजबूत एजेंटिक मॉडल है। दरअसल, OpenClaw के निर्माता इसे OpenClaw में इस्तेमाल करने की सलाह देते हैं क्योंकि इसे प्रॉम्प्ट इंजेक्शंस से जहर देना मुश्किल है। इससे मॉडल दुर्भावनापूर्ण कोड के प्रति अधिक सुदृढ़ बनता है।
एजेंट्स टीमें सुविधा, भले ही अभी प्रायोगिक हो, सबएजेंट्स से एक बड़ा अपग्रेड है। इसके साथ, आप अपना कार्य कई Claude एजेंट्स में बांट सकते हैं। उदाहरण के लिए, एक बैकएंड संभाल सकता है, दूसरा फ्रंटएंड, और एक अन्य टेस्ट चला सकता है। प्रत्येक एजेंट की अपनी कॉन्टेक्स्ट विंडो होती है, जिससे कॉन्टेक्स्ट विंडो सीमाओं के कारण कार्य विफलता का जोखिम घटता है।
Claude Opus 4.6 एक सशक्त मॉडल है, लेकिन जैसा कहा जाता है, फ्री लंच जैसा कुछ नहीं होता। यह मॉडल चलाने में सस्ता नहीं है, खासकर यदि आप हेवी यूज़र हैं।
इसी बीच, Anthropic ने इसका सक्सेसर मॉडल प्रकाशित कर दिया है। हमारी Claude Opus 4.7 गाइड भी अवश्य देखें!
GPT-5.4 क्या है?
GPT-5.4 OpenAI का सबसे हालिया और सबसे सक्षम मॉडल है। इसे GPT-5.3-Codex की कोडिंग क्षमताओं को जोड़कर और रीजनिंग जोड़कर एक एकल शक्तिशाली मॉडल के रूप में बनाया गया है। यानी अब आपको कोडिंग के लिए Codex मॉडल और अन्य कार्यों के लिए अन्य OpenAI मॉडलों के बीच स्विच करने की जरूरत नहीं है।
GPT-5.4 की प्रमुख विशेषताएं और क्षमताएं
GPT-5.4 की जो विशेषता मुझे सबसे रोचक लगी, वह है कंप्यूटर उपयोग क्षमताएं। OSWorld पर, जो किसी मॉडल की डेस्कटॉप कंप्यूटर का उपयोग करने की क्षमता को मापता है, GPT-5.4 ने 75.0% स्कोर किया, जबकि मानव प्रदर्शन 72.4% था। संदर्भ के लिए, GPT-5.2 ने इसी टेस्ट पर 47.3% स्कोर किया था।
GDPval पर, जो 44 व्यवसायों में प्रोफ़ेशनल नॉलेज वर्क को परखता है, GPT-5.4 ने 83% स्कोर किया। इसका मतलब है कि यह मॉडल शीर्ष अमेरिकी नौकरियों में एजेंटिक कार्य प्रोफ़ेशनल स्तर पर कर सकता है।
GPT-5.4 में टोकन दक्षता भी है, यानी यह कई कार्यों के लिए पिछले मॉडलों की तुलना में कम टोकन उपयोग करता है। यदि आप प्रतिदिन कई रिक्वेस्ट चलाते हैं, तो यह ध्यान देने योग्य बात है।
GPT-5.4 ने टूल सर्च सिस्टम भी पेश किया है, जो मॉडल को कई टूल्स दिए जाने पर अधिक कुशलता से काम करने में सक्षम बनाता है। प्रॉम्प्ट में टूल डेफिनिशन शामिल करने के बजाय, जिससे अधिक टोकन जुड़ते हैं, अब मॉडल को टूल्स की सूची और एक सर्च क्षमता दी जाती है। जब मॉडल को किसी टूल की जरूरत होती है, तो वह उसे खोजकर उस विशेष बातचीत में जोड़ देता है। इससे टोकन दक्षता बेहतर होती है।
GPT-5.4 के फायदे और कमियां
जो बात मुझे सबसे प्रभावशाली लगती है, वह है स्वायत्त कंप्यूटर उपयोग में GPT-5.4 की मानवों से बेहतर क्षमता। इस क्षेत्र में यह Claude Opus 4.6 को पछाड़ता है, OSWorld बेंचमार्क पर 75% स्कोर के साथ, जबकि Opus 4.6 का स्कोर 72.7% है।
Artificial Analysis के स्वतंत्र शोध के अनुसार, GPT 5.4 (xhigh) ने CritPt बेंचमार्क पर 30% का स्कोर हासिल किया, जो LLMs को शोध-स्तरीय भौतिकी तर्क कार्यों पर परखता है और 71 समग्र शोध चुनौतियां शामिल करता है।
GPT-5.4 टूल कॉलिंग में अधिक बेहतर और सटीक है। रिलीज़ रिपोर्ट में, OpenAI बताता है कि Toolathlon पर, जो एजेंट्स के वास्तविक दुनिया के टूल्स और APIs से बहु-चरणीय कार्य पूरे करने की क्षमता को परखता है, यह कम चरणों में बेहतर परिणाम प्राप्त करता है।
Claude Opus 4.6 की तरह, GPT-5.4 भी सस्ता मॉडल नहीं है। सौभाग्य से, OpenAI बैच इन्फरेंस API पर कम कीमतें देता है।
GPT-5.4 बनाम Claude Opus 4.6: आमने-सामने तुलना
अब जब आपने GPT-5.4 और Opus 4.6 के फायदे और कमियां देख ली हैं, तो आइए उनकी तुलना करें ताकि यह तय किया जा सके कि आपके उपयोग मामलों के लिए कौन-सा बेहतर है।
कुल मिलाकर, Artificial Analysis Intelligence Index के अनुसार GPT-5.4 सबसे अच्छा मॉडल है, जो विभिन्न बेंचमार्क्स पर मॉडलों के प्रदर्शन को मापता है। इसे केवल Gemini 3.1 Pro मात देता है।
एजेंटिक और कंप्यूटर उपयोग प्रदर्शन
मल्टी-एजेंट ऑर्केस्ट्रेशन में Claude Opus 4.6 आगे है। इसकी एजेंट टीमें सुविधा के साथ, आप अलग-अलग कार्यों पर काम करने वाले समानांतर एजेंट्स के साथ कई वर्कफ़्लो चला सकते हैं।
कंप्यूटर उपयोग में GPT-5.4 मामूली बढ़त लेता है। यदि आपके एजेंट को डेस्कटॉप ऑपरेट करना, ब्राउज़र नेविगेट करना, या GUI-आधारित सॉफ़्टवेयर से इंटरैक्ट करना है, तो फिलहाल GPT-5.4 बेहतर विकल्प है
कोडिंग बेंचमार्क
Claude Opus 4.6 बेहतर प्रोग्रामर है, SWE-Bench Verified पर 80.84% स्कोर के साथ और एक संशोधित प्रॉम्प्ट का उपयोग करते समय 81.4% के साथ।
GPT-5.4 ने GPT-5.3-Codex की कोडिंग क्षमताएं विरासत में पाई हैं। OpenAI के अनुसार, GPT-5.4 ने SWE-Bench Pro (Public) पर 57.7% स्कोर हासिल किया है, और रीजनिंग कार्यों में कम लेटेंसी दिखाता है।
लागत और टोकन दक्षता
अपनी रिपोर्ट में, OpenAI का दावा है कि GPT-5.4 ने कुछ कार्यों पर टोकन उपयोग में 47% की कमी दिखाई। Opus 4.6 से महंगा होने के बावजूद, इस टोकन कमी के कारण बड़े पैमाने पर GPT-5.4 चलाना सस्ता पड़ सकता है।
हालांकि, कम लेकिन जटिल एजेंटिक कार्यों के लिए Opus 4.6 अब भी बेहतर मॉडल हो सकता है।
संदर्भ के लिए, सबसे शक्तिशाली GPT-5.4 मॉडल (कॉन्टेक्स्ट लंबाई>272K) की कीमत 1M इनपुट टोकन के लिए $60 और 1M आउटपुट टोकन के लिए $270 है, जबकि Claude Opus 4.6 की कीमत 1M इनपुट टोकन के लिए $5 और 1M आउटपुट टोकन के लिए $25 है।
कॉन्टेक्स्ट विंडो और मेमोरी
GPT-5.4 और Claude Opus 4.6 दोनों 1M टोकन तक का कॉन्टेक्स्ट सपोर्ट करते हैं, हालांकि Claude का बीटा में है। इससे दोनों मॉडल बड़े कोडबेस पर काम करने के लिए मजबूत दावेदार बनते हैं।
तुलनात्मक तालिका
श्रेणी
Claude Opus 4.6
GPT-5.4
एजेंटिक कार्य
मजबूत (एजेंट टीमें, पैरेलल ऑर्केस्ट्रेशन)
मजबूत (कंप्यूटर उपयोग, OSWorld 75%)
कोडिंग बेंचमार्क
SWE-Bench 80.2% विथ थिंकिंग
SWE-Bench Pro (Public) पर 57.7%
कंप्यूटर उपयोग
OSWorld पर 72.7%
OSWorld 75% (मानव विशेषज्ञों को मात)
कॉन्टेक्स्ट विंडो
1M टोकन (बीटा), 128K अधिकतम आउटपुट
1M टोकन
नॉलेज वर्क
Humanity's Last Exam लीडर
GDPval 83%
प्राइसिंग (इनपुट/आउटपुट)
$5 बेस इनपुट टोकन
प्रति मिलियन टोकन $25 आउटपुट टोकन
gpt-5.4 (<272K कॉन्टेक्स्ट लंबाई) की कीमत 1M इनपुट टोकन के लिए $2.50 और 1M आउटपुट टोकन के लिए $15.00 है। बड़े कॉन्टेक्स्ट विंडो वाले मॉडल अधिक महंगे हैं।
टोकन दक्षता
मानक
कुछ कार्यों पर 47% कम टोकन
किसके लिए सर्वश्रेष्ठ
लंबे समय तक चलने वाले एजेंट्स, जटिल कोडबेस
कंप्यूटर उपयोग, डॉक वर्कफ़्लो, एंटरप्राइज
GPT-5.4 बनाम Claude Opus 4.6: आपको कौन-सा चुनना चाहिए?
अंत में, सबसे महत्वपूर्ण सवाल का जवाब दें: इन दोनों में से आपको किसे चुनना चाहिए?
आपको Claude Opus 4.6 चुनना चाहिए, यदि…
आपको GPT-5.4 चुनना चाहिए, यदि…
भविष्य की दिशा
Anthropic के मॉडल लंबे समय से कोडिंग के लिए पसंदीदा रहे हैं, लेकिन वे क्रिएटिव राइटिंग जैसे अप्रत्याशित क्षेत्रों में भी चमकते हैं। वास्तव में, बहुत से लोग तर्क देंगे कि इस काम में वे सर्वश्रेष्ठ हैं।
लेकिन Anthropic ने कभी सार्वजनिक रूप से यह नहीं कहा कि उनके मॉडल किसी विशिष्ट कार्य में विशेषज्ञ हैं, जैसा कि OpenAI ने कहा था कि Codex मॉडल विशेष रूप से प्रोग्रामिंग के लिए है।
मुझे यह बेहद दिलचस्प लगता है कि अब OpenAI Anthropic की दिशा में बढ़ रहा है। अपनी नवीनतम रिलीज़ के साथ, वे एक एकीकृत मॉडल की ओर बढ़ रहे हैं जो प्रोफ़ेशनल कार्यों की एक विस्तृत श्रृंखला संभालता है। यह उपयोगकर्ताओं के लिए बहुत बड़ा फ़ायदा है; कोई भी अपना काम करने के लिए लगातार स्पेशलिस्ट मॉडलों के बीच स्विच नहीं करना चाहता।
दूसरी ओर, यह देखना अच्छा है कि Anthropic ने 1M कॉन्टेक्स्ट विंडो को अपनाया है, जो अन्य मॉडलों (जैसे Gemini 3) में लंबे समय से है। मुझे लगता है कि भविष्य में इन मॉडलों में बहुत मिलती-जुलती विशेषताएं होंगी, जिससे उपयोगकर्ताओं के लिए निर्णायक भेद बहुत कम रह जाएंगे। फिर भी, अलग-अलग कार्यों पर मॉडल का प्रदर्शन ही मुख्य अंतरकर्ता होगा, क्योंकि उपयोगकर्ता उन मॉडलों को पसंद करेंगे जो उनके विशिष्ट वर्कफ़्लो पर अच्छा करते हैं।
निष्कर्ष
2026 में, Anthropic और OpenAI दोनों के पास एजेंटिक कार्यों के लिए मजबूत मॉडल हैं। जो बात आपको उलझन में डाल सकती है, वह यह है कि वे अलग-अलग बेंचमार्क रिपोर्ट करते हैं—संभवतः वहीं चुनते हैं जहां उनके मॉडल चमकते हों।
अब आपको अन्य बेंचमार्क्स के लिए स्वतंत्र विश्लेषणों का सहारा लेना होगा और अपने उपयोग मामलों पर उन्हें खुद परखना होगा। जो स्पष्ट है, वह यह कि मॉडल बेहतर हो रहे हैं। और आपको भी उन्हें इस्तेमाल करने में बेहतर होना चाहिए।
इस एजेंटिक मूवमेंट में पीछे न छूटने का एक तरीका है इन मॉडलों का सॉफ्टवेयर इंजीनियरिंग में प्रभावी उपयोग सीखना। मैं सलाह दूंगा कि आप हमारे Software Development with Cursor कोर्स में मुफ्त में दाखिला लेकर शुरुआत करें। आप Introduction to Claude Models कोर्स और OpenAI Fundamentals स्किल ट्रैक भी कर सकते हैं।