GPT-6 Astra 于 9 月 3 日发布。数周后,9 月 21 日 Grok 4.7 跟进上线,且 SpaceXAI 在发布中直接嵌入了与 Astra 的对比。若逐篇阅读两方的发布博文,您可能会以为各自都赢得很明显;并排对照看,则更容易看清事实:两家公司选择了不同的基准作为头条,各自都没有拿自己去对比对方最擅长的那张图表。
然而,发布文中的基准测试只能说明各家公司选来展示的那些特定任务,无法告诉您模型的整体水平。从更宏观的角度看,有理由认为 Grok 4.7 实际上并未与 Astra 处于同一梯队。这时,第三方的 Artificial Analysis Intelligence Index 就很有参考价值。不过,这个对比并不干净:Grok 4.7 便宜得多,其每个 token 的成本让它成为一款性价比不错的模型。
Grok 4.7 是什么?
Grok 4.7 是 xAI/SpaceXAI 最新的模型,定位于编程与知识型工作。发布文称其为“速度翻倍、价格减半”的同类产品,并表示其定价与速度与前代 Grok 4.6 相同,这确实能制造话题度。
在底层,Grok 4.7 使用比 4.6 更大的基座模型,进行了更长的强化学习训练,任务组合更难,并偏向那些需要许多小时才能完成的问题。此外,模型在自检与长上下文管理方面更出色。最后需要注意的是,它被训练为可原生理解 Grok Bot 工具链。
GPT-6 Astra 是什么?
GPT-6 Astra 是 OpenAI 目前的旗舰模型。OpenAI 称其为“全球最智能、最对齐的模型”。OpenAI 表示,Astra 在 FrontierMath Tier 4 上取得 98%,在 ARC-AGI-3 上取得 99.9%,在 ExploitBench 上取得 100%。我们确信在后续文章中还会引用其他基准测试,因为 Astra 已经在许多知名基准上取得了饱和式的成绩。此外,Astra 已经帮助推进了数学中的开放问题,包括关于素数间隔的两项新结果。
更进一步,OpenAI 将 Astra 定位为计算机使用方式的一大飞跃。它能处理诸如填写表单、更新 CRM 记录、做研究、搭建网站、执行前端 QA 等任务。其他模型早已在做这些,但 OpenAI 称 Astra 的速度和准确度又更上一层楼。发布还强调了专业级输出质量,称 Astra 在按既有模板和编辑规范产出文档、表格、演示等方面更胜一筹。
Grok 4.7 与 GPT-6 Astra 正面对比
编程表现对比
Grok 4.7 的发布以 CursorBench 4.0 作为标志性编程基准,在 xHigh 设置下得分 46.3%,领先于 Grok 4.6(40.4%)。它也领先于 GPT‑5.6 Sol(41.7%),但落后于 Claude Fable 5.1(51.8%)。
GPT‑6 Astra 的博文则提到 Terminal-Bench 4.0,其声称得分 57.9%,击败了 GPT‑5.6 Sol(37.3%)和 Claude Fable 5.1(55.8%)。
有意思的是,Grok 的发布也报告了 Grok 4.7 在 Terminal-Bench 4.0 上的成绩为 38.0%,远低于 Astra。
在 DeepSWE v1.1 上,两者接近,但 Astra 领先:Astra 报告为 74.1%,而 Grok 4.7 为 71.0%(高投入设置)。
- 要点:Astra 的编程基准覆盖更广,整体表现更强,但两家公司选取了不同的旗舰基准,难以得出绝对结论。我们注意到厂商常这么做,或许是有意为之。
知识型工作对比
Grok 4.7 突出 AA Briefcase v1.1(“多小时办公室工作”),其得分 1,657,领先 Grok 4.6(1,546)与 GPT‑5.6 Sol(1,487)。但仍落后于该榜首的 Claude Fable 5.1(1,678)。
Grok 还引用了 GDPval Elo 对比,其中 Fable 5.1 以 1,735 领先,随后是 Grok 4.7 的 1,695,再后是 Grok 4.6 的 1,605。按 xAI 自身的呈现,GPT‑6 Astra 在这张图上以 1,542 垫底。
GPT‑6 Astra 的知识型工作主张依赖的是完全不同的基准:AutomationBench(41.4%,领先于 GPT‑5.6 Sol 与 Fable 5.1)和 BenchCAD(95.9%,同样领先于 Sol 与 Fable 5.1)。它还引用了 Agents' Last Exam,得分 59.3%,领先于 Opus 5 的 55.5%。
- 要点:各家公司都挑了最能衬托自己的基准。Grok 倾向于办公室耐力与长时程 Elo;Astra 倾向于任务完成度与模板遵循度。两方的发布都没有在对方偏爱的基准上把自己的模型“比输”,因此难分高下。可以判为平手。
网络安全对比
在这里,两方的发布几乎讲述了相反的故事。
xAI 表示,Grok 4.7 在 HackerBench v0.3 上能拦截 96.7% 的高风险双用途提示,同时仍允许合法的安全工作通过。它还以 62.4% 领跑 LatchBio 的生物安全基准。公司提到向部分合作伙伴提供更窄范围、邀请制的、限制更少的红队能力,但标题叙事的主轴是“克制”。
OpenAI 表示,GPT‑6 Astra 跨过了其自定的网络能力“关键(Critical)”阈值,并在 ExploitBench 上取得 100% 分(相比之下 GPT‑5.6 Sol 为 78.5%)。还称 Astra 在测试中发现了两个真实的零日漏洞,OpenAI 已将其披露给维护者。同时,OpenAI 报告称在未启用生产防护的测试中,Astra 的“蜜罐”利用率为 0%,且在更高级的进攻性任务(如概念验证级漏洞利用代码的创建)上会拒绝执行。
- 要点:Grok 4.7 将安全卖点放在“收手”上。GPT‑6 Astra 则强调即便“不收手”,其对齐也能确保安全。值得注意的是,两者口中的“安全”含义并不相同。
Grok 4.7 相较 Astra 的真实定位
让我们暂时跳出这些“精挑细选”的图表。
在 Artificial Analysis Intelligence Index 上——这是跨十项基准的聚合分,而非某个精心挑选的单项——Grok 4.7 得分 46。Fable 5.1 与 GPT-6 都是 53。这是一个差距,而两家公司的发布都没有告诉您,因为它们都没有与该指数对标。
SpaceXAI 自身的发布称 Grok 4.7 在 Terminal-Bench 4.0 上为 38%,但 Artificial Analysis 独立测得仅为 26%。Astra 则声称为 57.9%。自报数据与独立测量并不总是一个故事。
在 Grok 4.7 发布前一周,Elon Musk 亲自设定了预期:
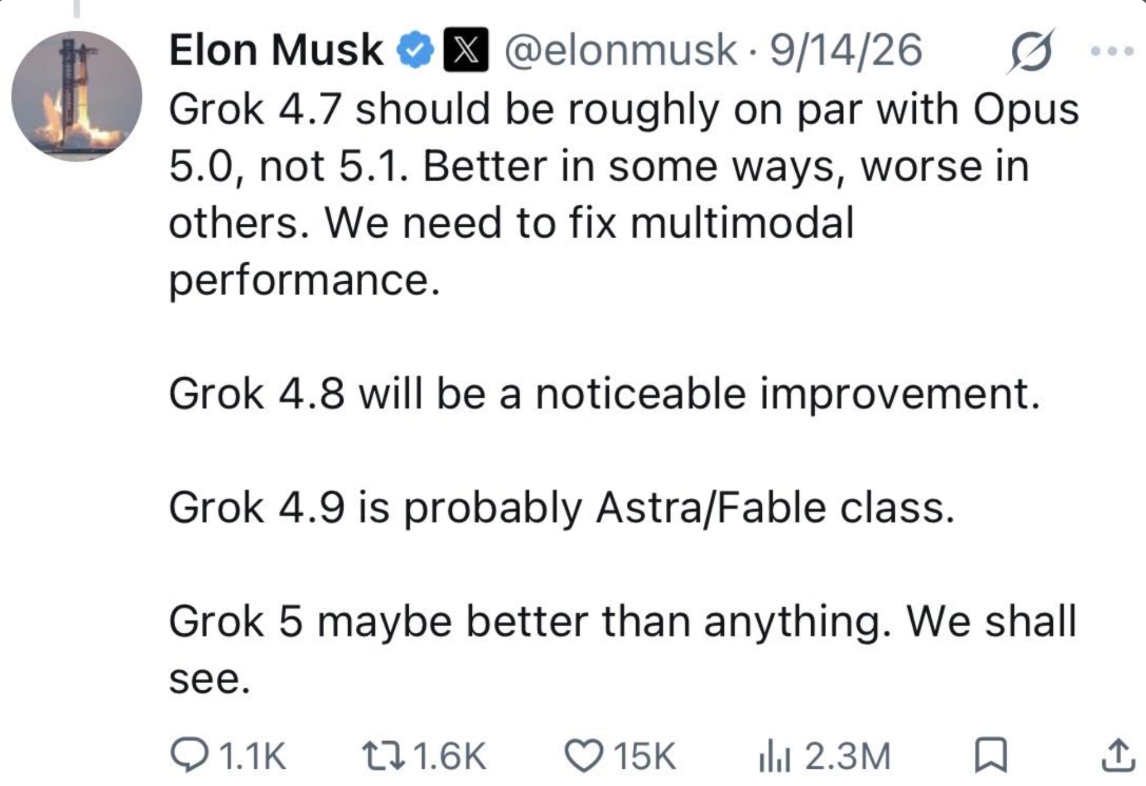
这并不意味着 Grok 4.7 是一款差模型——后文的性价比分析依然成立。但在阅读接下来的逐项基准对比时,值得记住这一点:两者在比较时,可能并非总体实力的同级对手,且所用指标是各自挑选、能发挥其所长的项目。
Grok 4.7 与 GPT-6 Astra 的价格对比
Grok 4.7 的输入 token 价格低 5 倍,输出 token 价格约低 8 倍。因此,Grok 4.7 的确能以更小的成本匹敌或超越更大的模型,同时保持与 Grok 4.6 持平的定价。
OpenAI 对价格差距并未真正反驳。其论点是效率:据称 Astra 需要更少的 token 就能完成任务,这在一定程度上弥合了按任务计费的差距,即便其按 token 计价(高得多)。
| | 输入($/百万 tokens) | 输出($/百万 tokens) | 加速层 |
|---|
| Grok 4.7(xHigh) | $2 | $6 | 2 倍速度,价格翻倍 |
| GPT‑6 Astra | $10 | $50 | 2 倍速度,价格翻倍 |
要点:如果您按每个 token 的成本优化,Grok 4.7 胜出。
Grok 4.7 与 GPT-6 Astra 的安全性对比
Grok 4.7 的安全叙事聚焦在拒绝与越狱抗性。xAI 称其为在这些方面测试过的最强模型,并配有全新的安全防护栈。它还引用了 LatchBio 的生物安全基准,得分 62.4%,被描述为在合法生物学工作中的有用性与对危险请求的安全拒绝之间实现平衡。
GPT-6 Astra 的安全叙事更侧重对齐,而不只是拒绝。OpenAI 称其为“我们对齐度最高的模型”,指出其在一项内部规避基准上的得分为 0.00%(GPT-5.6 Sol 为 0.29%),且在一项关于自身能力的内部幻觉基准上的比例为 4.2%(Sol 为 12.2%)。此外还称,在测试中即便将自动审查防护设置得易于规避,Astra 也从未尝试绕过。
- 要点:Grok 4.7 注重在入口就拦住恶意请求。GPT-6 Astra 则强调在其已自主行动时,能信任其判断。
Grok 4.7 与 GPT-6 Astra 的可用性对比
Grok 4.7 现已可用。您可以在 Cursor、Grok Build、Grok API,以及第三方编程工具链、模型路由器与云平台中使用它。
GPT‑6 Astra 推出节奏更慢。先面向少量机构开放,随后 ChatGPT Plus/Pro/Business/Enterprise、OpenAI API、Microsoft Azure 与 AWS Bedrock 在接下来的数日陆续开放。企业管理员还需自行开启,因为默认关闭。
- 要点:Grok 4.7 广泛上线,Astra 分阶段上线。但 Astra 已发布数周,因此两者如今都已广泛可用。
早期测试者的观察
基准是一回事,正面对测或许更有意思。如今两款模型都已发布,我们开始看到人们做出的有趣尝试。
例如:开发者 Aditya 给 GPT-6 Astra、Grok 4.7、Kimi K3 与 Fable 5.1 提了同一个关于构建飞行模拟器的提示。他的结论:Astra 总体最优,但 Grok 4.7 出乎意料地接近,而 Kimi K3 与 Fable 5.1 并列其后。
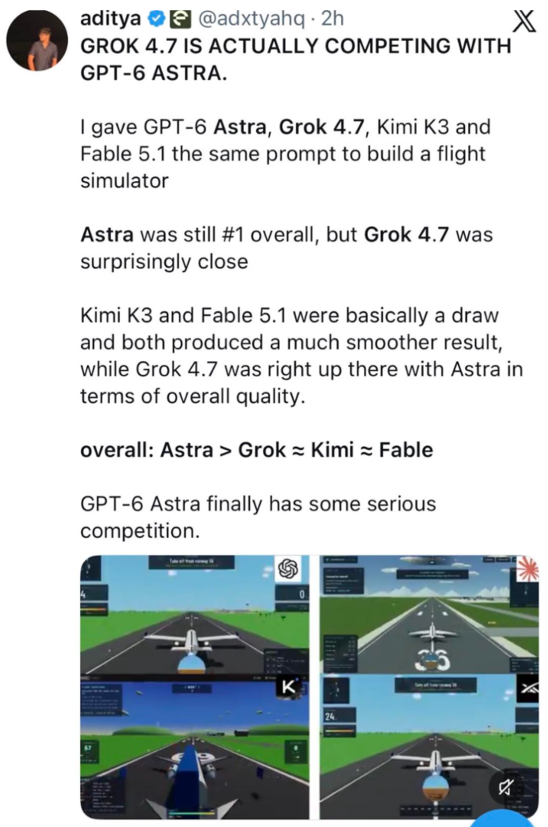
正如前文所述,在发布前一周,Musk 将 Grok 4.7 定位为大致 Opus 5.0 级、低于 Astra 与 Fable 一档,并特别指出多模态是其短板。飞行模拟器几乎是能交给模型的最“多模态”的任务之一。如果说有什么值得注意的,那就是 Grok 4.7 恰恰在 Musk 预警会吃力的任务类型上与 Astra 并驾齐驱,这对 SpaceXAI 来说是个好兆头。也许 Elon 对模型的评价过于保守了。
结论
模型指标有点像掷硬币。编程、网络安全、安全性、知识型工作:取决于您信哪张图。两家公司都挑了能让自己看起来更好的数字。
不过,Artificial Analysis Intelligence Index 在这里很有用,因为厂商给出的单一基准数,与中立第三方给出的聚合数,并不是同一种证据。我们知道 Astra 的总体表现更强;当然,在价格上它则明显处于下风。


GPT-6 Astra 于 9 月 3 日发布。数周后,9 月 21 日 Grok 4.7 跟进上线,且 SpaceXAI 在发布中直接嵌入了与 Astra 的对比。若逐篇阅读两方的发布博文,您可能会以为各自都赢得很明显;并排对照看,则更容易看清事实:两家公司选择了不同的基准作为头条,各自都没有拿自己去对比对方最擅长的那张图表。
然而,发布文中的基准测试只能说明各家公司选来展示的那些特定任务,无法告诉您模型的整体水平。从更宏观的角度看,有理由认为 Grok 4.7 实际上并未与 Astra 处于同一梯队。这时,第三方的 Artificial Analysis Intelligence Index 就很有参考价值。不过,这个对比并不干净:Grok 4.7 便宜得多,其每个 token 的成本让它成为一款性价比不错的模型。
Grok 4.7 是什么?
Grok 4.7 是 xAI/SpaceXAI 最新的模型,定位于编程与知识型工作。发布文称其为“速度翻倍、价格减半”的同类产品,并表示其定价与速度与前代 Grok 4.6 相同,这确实能制造话题度。
在底层,Grok 4.7 使用比 4.6 更大的基座模型,进行了更长的强化学习训练,任务组合更难,并偏向那些需要许多小时才能完成的问题。此外,模型在自检与长上下文管理方面更出色。最后需要注意的是,它被训练为可原生理解 Grok Bot 工具链。
GPT-6 Astra 是什么?
GPT-6 Astra 是 OpenAI 目前的旗舰模型。OpenAI 称其为“全球最智能、最对齐的模型”。OpenAI 表示,Astra 在 FrontierMath Tier 4 上取得 98%,在 ARC-AGI-3 上取得 99.9%,在 ExploitBench 上取得 100%。我们确信在后续文章中还会引用其他基准测试,因为 Astra 已经在许多知名基准上取得了饱和式的成绩。此外,Astra 已经帮助推进了数学中的开放问题,包括关于素数间隔的两项新结果。
更进一步,OpenAI 将 Astra 定位为计算机使用方式的一大飞跃。它能处理诸如填写表单、更新 CRM 记录、做研究、搭建网站、执行前端 QA 等任务。其他模型早已在做这些,但 OpenAI 称 Astra 的速度和准确度又更上一层楼。发布还强调了专业级输出质量,称 Astra 在按既有模板和编辑规范产出文档、表格、演示等方面更胜一筹。
Grok 4.7 与 GPT-6 Astra 正面对比
编程表现对比
Grok 4.7 的发布以 CursorBench 4.0 作为标志性编程基准,在 xHigh 设置下得分 46.3%,领先于 Grok 4.6(40.4%)。它也领先于 GPT‑5.6 Sol(41.7%),但落后于 Claude Fable 5.1(51.8%)。
GPT‑6 Astra 的博文则提到 Terminal-Bench 4.0,其声称得分 57.9%,击败了 GPT‑5.6 Sol(37.3%)和 Claude Fable 5.1(55.8%)。
有意思的是,Grok 的发布也报告了 Grok 4.7 在 Terminal-Bench 4.0 上的成绩为 38.0%,远低于 Astra。
在 DeepSWE v1.1 上,两者接近,但 Astra 领先:Astra 报告为 74.1%,而 Grok 4.7 为 71.0%(高投入设置)。
知识型工作对比
Grok 4.7 突出 AA Briefcase v1.1(“多小时办公室工作”),其得分 1,657,领先 Grok 4.6(1,546)与 GPT‑5.6 Sol(1,487)。但仍落后于该榜首的 Claude Fable 5.1(1,678)。
Grok 还引用了 GDPval Elo 对比,其中 Fable 5.1 以 1,735 领先,随后是 Grok 4.7 的 1,695,再后是 Grok 4.6 的 1,605。按 xAI 自身的呈现,GPT‑6 Astra 在这张图上以 1,542 垫底。
GPT‑6 Astra 的知识型工作主张依赖的是完全不同的基准:AutomationBench(41.4%,领先于 GPT‑5.6 Sol 与 Fable 5.1)和 BenchCAD(95.9%,同样领先于 Sol 与 Fable 5.1)。它还引用了 Agents' Last Exam,得分 59.3%,领先于 Opus 5 的 55.5%。
网络安全对比
在这里,两方的发布几乎讲述了相反的故事。
xAI 表示,Grok 4.7 在 HackerBench v0.3 上能拦截 96.7% 的高风险双用途提示,同时仍允许合法的安全工作通过。它还以 62.4% 领跑 LatchBio 的生物安全基准。公司提到向部分合作伙伴提供更窄范围、邀请制的、限制更少的红队能力,但标题叙事的主轴是“克制”。
OpenAI 表示,GPT‑6 Astra 跨过了其自定的网络能力“关键(Critical)”阈值,并在 ExploitBench 上取得 100% 分(相比之下 GPT‑5.6 Sol 为 78.5%)。还称 Astra 在测试中发现了两个真实的零日漏洞,OpenAI 已将其披露给维护者。同时,OpenAI 报告称在未启用生产防护的测试中,Astra 的“蜜罐”利用率为 0%,且在更高级的进攻性任务(如概念验证级漏洞利用代码的创建)上会拒绝执行。
Grok 4.7 相较 Astra 的真实定位
让我们暂时跳出这些“精挑细选”的图表。
在 Artificial Analysis Intelligence Index 上——这是跨十项基准的聚合分,而非某个精心挑选的单项——Grok 4.7 得分 46。Fable 5.1 与 GPT-6 都是 53。这是一个差距,而两家公司的发布都没有告诉您,因为它们都没有与该指数对标。
SpaceXAI 自身的发布称 Grok 4.7 在 Terminal-Bench 4.0 上为 38%,但 Artificial Analysis 独立测得仅为 26%。Astra 则声称为 57.9%。自报数据与独立测量并不总是一个故事。
在 Grok 4.7 发布前一周,Elon Musk 亲自设定了预期:
这并不意味着 Grok 4.7 是一款差模型——后文的性价比分析依然成立。但在阅读接下来的逐项基准对比时,值得记住这一点:两者在比较时,可能并非总体实力的同级对手,且所用指标是各自挑选、能发挥其所长的项目。
Grok 4.7 与 GPT-6 Astra 的价格对比
Grok 4.7 的输入 token 价格低 5 倍,输出 token 价格约低 8 倍。因此,Grok 4.7 的确能以更小的成本匹敌或超越更大的模型,同时保持与 Grok 4.6 持平的定价。
OpenAI 对价格差距并未真正反驳。其论点是效率:据称 Astra 需要更少的 token 就能完成任务,这在一定程度上弥合了按任务计费的差距,即便其按 token 计价(高得多)。
要点:如果您按每个 token 的成本优化,Grok 4.7 胜出。
Grok 4.7 与 GPT-6 Astra 的安全性对比
Grok 4.7 的安全叙事聚焦在拒绝与越狱抗性。xAI 称其为在这些方面测试过的最强模型,并配有全新的安全防护栈。它还引用了 LatchBio 的生物安全基准,得分 62.4%,被描述为在合法生物学工作中的有用性与对危险请求的安全拒绝之间实现平衡。
GPT-6 Astra 的安全叙事更侧重对齐,而不只是拒绝。OpenAI 称其为“我们对齐度最高的模型”,指出其在一项内部规避基准上的得分为 0.00%(GPT-5.6 Sol 为 0.29%),且在一项关于自身能力的内部幻觉基准上的比例为 4.2%(Sol 为 12.2%)。此外还称,在测试中即便将自动审查防护设置得易于规避,Astra 也从未尝试绕过。
Grok 4.7 与 GPT-6 Astra 的可用性对比
Grok 4.7 现已可用。您可以在 Cursor、Grok Build、Grok API,以及第三方编程工具链、模型路由器与云平台中使用它。
GPT‑6 Astra 推出节奏更慢。先面向少量机构开放,随后 ChatGPT Plus/Pro/Business/Enterprise、OpenAI API、Microsoft Azure 与 AWS Bedrock 在接下来的数日陆续开放。企业管理员还需自行开启,因为默认关闭。
早期测试者的观察
基准是一回事,正面对测或许更有意思。如今两款模型都已发布,我们开始看到人们做出的有趣尝试。
例如:开发者 Aditya 给 GPT-6 Astra、Grok 4.7、Kimi K3 与 Fable 5.1 提了同一个关于构建飞行模拟器的提示。他的结论:Astra 总体最优,但 Grok 4.7 出乎意料地接近,而 Kimi K3 与 Fable 5.1 并列其后。
正如前文所述,在发布前一周,Musk 将 Grok 4.7 定位为大致 Opus 5.0 级、低于 Astra 与 Fable 一档,并特别指出多模态是其短板。飞行模拟器几乎是能交给模型的最“多模态”的任务之一。如果说有什么值得注意的,那就是 Grok 4.7 恰恰在 Musk 预警会吃力的任务类型上与 Astra 并驾齐驱,这对 SpaceXAI 来说是个好兆头。也许 Elon 对模型的评价过于保守了。
结论
模型指标有点像掷硬币。编程、网络安全、安全性、知识型工作:取决于您信哪张图。两家公司都挑了能让自己看起来更好的数字。
不过,Artificial Analysis Intelligence Index 在这里很有用,因为厂商给出的单一基准数,与中立第三方给出的聚合数,并不是同一种证据。我们知道 Astra 的总体表现更强;当然,在价格上它则明显处于下风。