GPT-6 Astra a été lancé le 3 septembre. Grok 4.7 a suivi quelques semaines plus tard, le 21 septembre, avec dans sa présentation des comparaisons directes face à Astra. Lisez chaque article séparément et vous aurez l’impression que chacun sort grand gagnant. Lisez-les côte à côte, et l’image se précise : les deux entreprises ont mis en avant des benchmarks différents, et aucune ne s’est vraiment mesurée au terrain de prédilection de l’autre.
Or, les benchmarks des billets de lancement ne parlent que des tâches choisies pour briller. Ils ne disent pas où se situe un modèle dans l’ensemble. Sur ce point, il y a des raisons de penser que Grok 4.7 ne joue pas tout à fait dans la même cour qu’Astra. C’est là que l’Artificial Analysis Intelligence Index est utile, car il provient d’un tiers. Cela dit, la comparaison reste imparfaite. Grok 4.7 est bien moins cher, et son coût par token en fait un bon modèle.
Qu’est-ce que Grok 4.7 ?
Grok 4.7 est le dernier modèle de xAI/SpaceXAI, pensé pour le développement et les tâches de connaissance. La sortie le présente comme « deux fois plus rapide, pour moitié moins cher » que des modèles comparables, et précise qu’il est servi au même prix et à la même vitesse que son prédécesseur, Grok 4.6 — de quoi susciter l’intérêt.
Sous le capot, Grok 4.7 s’appuie sur un modèle de base plus grand que 4.6, entraîné plus longtemps par renforcement sur un mix de tâches plus difficiles et pondéré vers des problèmes nécessitant de nombreuses heures de travail. Le modèle vérifie mieux son propre travail et gère mieux les longs contextes. Enfin, il a été entraîné pour comprendre nativement l’environnement Grok Bot.
Qu’est-ce que GPT-6 Astra ?
GPT-6 Astra est le modèle phare actuel d’OpenAI, présenté comme « le modèle le plus intelligent et le mieux aligné au monde ». OpenAI indique qu’Astra obtient 98 % sur FrontierMath Tier 4, 99,9 % sur ARC-AGI-3, et 100 % sur ExploitBench. Nous citerons sûrement d’autres tests à l’avenir, car Astra a saturé nombre des benchmarks les plus connus. Astra a aussi contribué à résoudre des problèmes ouverts en mathématiques, notamment deux nouveaux résultats sur les écarts entre nombres premiers.
OpenAI positionne également Astra comme un grand pas en avant pour l’usage de l’ordinateur. Il gère des tâches comme remplir des formulaires, mettre à jour un CRM, faire de la recherche, créer des sites web et exécuter de la QA front-end. D’autres modèles pouvaient déjà faire tout cela, mais OpenAI affirme qu’Astra est nettement plus rapide et précis. La sortie insiste aussi sur la qualité professionnelle des livrables : Astra suivrait mieux des modèles existants et une charte éditoriale pour produire documents, feuilles de calcul, présentations, etc.
Grok 4.7 vs GPT-6 Astra : comparaisons directes
Grok 4.7 vs GPT-6 Astra en programmation
Le lancement de Grok 4.7 met en avant CursorBench 4.0 comme benchmark signature pour le code, où il obtient 46,3 % (réglage xHigh), devant Grok 4.6 (40,4 %). Il dépasse aussi GPT‑5.6 Sol (41,7 %), mais reste derrière Claude Fable 5.1 (51,8 %).
Le billet de GPT‑6 Astra cite plutôt Terminal‑Bench 4.0, avec 57,9 %, ce qui bat GPT‑5.6 Sol (37,3 %) et Claude Fable 5.1 (55,8 %).
Fait notable, la présentation de Grok mentionne aussi un score Terminal‑Bench 4.0 de 38,0 % pour Grok 4.7, très en‑deçà d’Astra.
Sur DeepSWE v1.1, les deux sont proches, mais Astra garde l’avantage : 74,1 % pour Astra contre 71,0 % pour Grok 4.7 (à effort élevé).
- À retenir : la batterie de tests d’Astra pour le code est plus large et donne une image globale plus solide, mais les deux entreprises ont choisi des benchmarks « vitrines » différents, rendant la comparaison peu évidente. Nous notons que c’est sans doute volontaire.
Grok 4.7 vs GPT-6 Astra sur le travail de connaissance
Grok 4.7 met en avant AA Briefcase v1.1 (« travail de bureau sur plusieurs heures »), où il marque 1 657, devant Grok 4.6 (1 546) et GPT‑5.6 Sol (1 487). Mais il reste derrière Claude Fable 5.1, en tête avec 1 678.
Grok cite aussi une comparaison GDPval Elo où Fable 5.1 est premier à 1 735, devant Grok 4.7 à 1 695, puis Grok 4.6 à 1 605. GPT‑6 Astra arrive dernier dans ce graphique à 1 542, du moins selon la présentation de xAI.
Les affirmations d’Astra sur le travail de connaissance s’appuient sur d’autres benchmarks : AutomationBench (41,4 %, devant GPT‑5.6 Sol et Fable 5.1) et BenchCAD (95,9 %, là encore devant Sol et Fable 5.1). OpenAI cite aussi Agents’ Last Exam, avec 59,3 %, contre 55,5 % pour Opus 5.
- À retenir : chacun a choisi les benchmarks qui le mettent le plus en valeur. Grok privilégie l’endurance bureautique et des scores Elo de long terme ; Astra s’appuie sur des benchmarks de réalisation de tâches et de respect de modèles. Aucun ne se mesure franchement au terrain fort de l’autre, et la comparaison reste délicate. Match nul.
Grok 4.7 vs GPT-6 Astra en cybersécurité
C’est là que les deux récits divergent presque à l’opposé.
xAI indique que Grok 4.7 bloque 96,7 % des prompts à double usage risqué sur HackerBench v0.3, tout en laissant passer le travail de sécurité légitime. Il arrive aussi en tête du benchmark de biosécurité de LatchBio avec 62,4 %. L’entreprise mentionne offrir à certains partenaires un accès plus restreint, sur invitation, à des capacités de red teaming moins bridées, mais met surtout en avant la retenue.
OpenAI affirme que GPT‑6 Astra franchit son propre seuil « Critical » de capacité cyber et annonce 100 % sur ExploitBench, contre 78,5 % pour GPT‑5.6 Sol. OpenAI précise aussi qu’Astra a découvert deux vulnérabilités zero‑day réelles pendant les tests, signalées aux mainteneurs. Parallèlement, OpenAI rapporte un taux d’exploitation « honeypot » de 0 % lorsque Astra a été testé sans garde‑fous en production, et dit qu’Astra refusera des tâches offensives avancées, comme la création de preuves de concept d’exploit.
- À retenir : Grok 4.7 est présenté comme sûr parce qu’il retient ses réponses. GPT‑6 Astra est présenté comme sûr grâce à son alignement, même lorsqu’il ne retient pas ses actions. Remarquez que « sécurité » ne recouvre pas la même notion dans chaque discours.
Où se situe réellement Grok 4.7 face à Astra
Prenons un peu de recul par rapport aux graphiques « sur‑mesure ».
Sur l’Artificial Analysis Intelligence Index — un agrégat de dix benchmarks, et non une tâche choisie — Grok 4.7 obtient 46. Fable 5.1 et GPT‑6 sont à 53. L’écart est réel, et aucun des billets de lancement ne le montre, car aucun ne se compare à cet indice.
La présentation de SpaceXAI revendique 38 % sur Terminal‑Bench 4.0, mais Artificial Analysis a mesuré Grok 4.7 à seulement 26 % sur le même benchmark. Astra revendique 57,9 %. Les chiffres auto‑rapportés et les mesures indépendantes ne racontent pas toujours la même histoire.
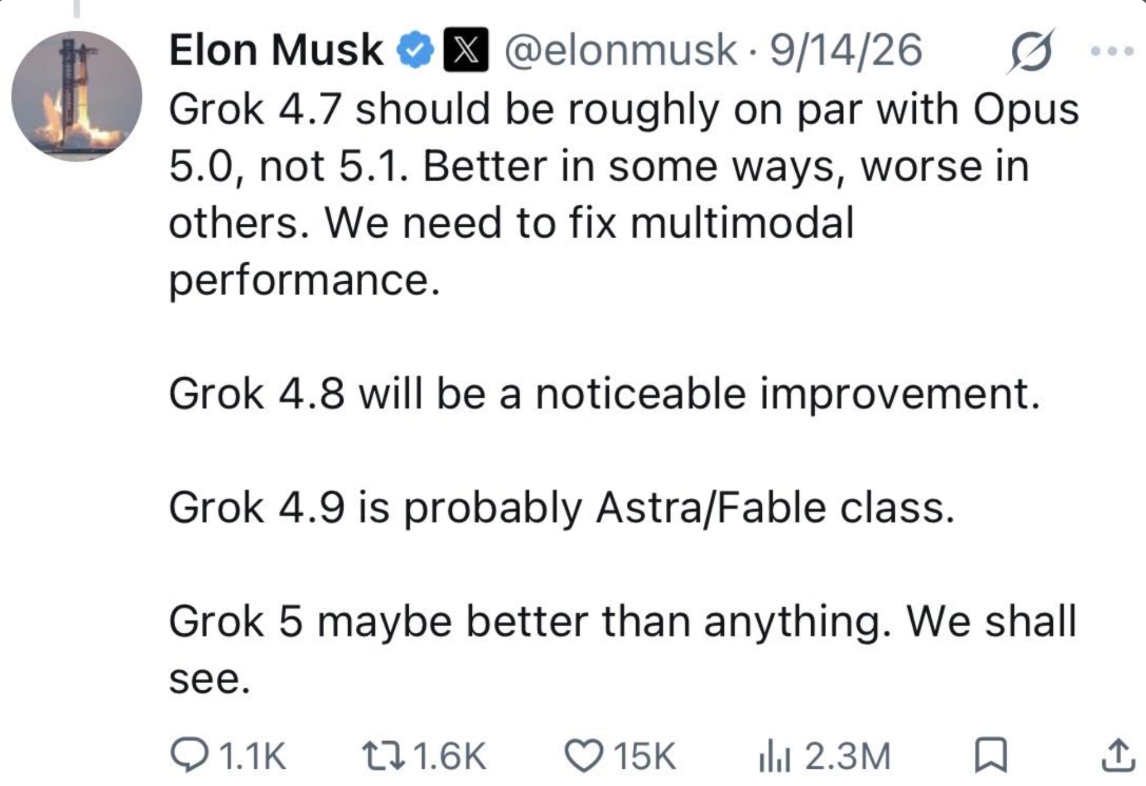
Elon Musk lui‑même a cadré les attentes une semaine avant le lancement de Grok 4.7 :
Rien de tout cela ne signifie que Grok 4.7 est un mauvais modèle — l’argument prix‑performance présenté plus loin tient toujours. Mais gardez cela en tête pour les comparaisons benchmark par benchmark qui suivent : elles confrontent deux modèles qui ne sont peut‑être pas du même niveau globalement, avec des métriques choisies parce que leur modèle y performe bien.
Grok 4.7 vs GPT-6 Astra sur le prix
Grok 4.7 est 5× moins cher sur les tokens d’entrée et environ 8× moins cher sur les tokens de sortie. Il égale donc, voire dépasse, des modèles plus gros pour une fraction du coût, tout en conservant le même tarif que Grok 4.6.
OpenAI ne conteste pas vraiment l’écart de prix. L’entreprise met en avant l’efficacité : Astra aurait besoin de moins de tokens pour terminer une tâche, ce qui réduirait en partie l’écart en coût par tâche, même si le prix par token est plus élevé (beaucoup plus élevé).
| | Entrée ($/M tokens) | Sortie ($/M tokens) | Palier rapide |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2× plus rapide pour 2× le prix |
| GPT‑6 Astra | $10 | $50 | 2× plus rapide pour 2× le prix |
À retenir : si vous optimisez le coût par token, Grok 4.7 l’emporte.
Grok 4.7 vs GPT-6 Astra sur la sécurité
Le discours de Grok 4.7 sur la sécurité met l’accent sur les refus et la résistance aux « jailbreaks ». xAI le présente comme le modèle le plus solide qu’ils aient testé sur ces points, grâce à une nouvelle pile de garde‑fous. Il cite aussi le benchmark de biosécurité de LatchBio, où il atteint 62,4 %, présenté comme un équilibre entre utilité pour le travail biologique légitime et refus des demandes dangereuses.
La promesse de sécurité de GPT‑6 Astra repose davantage sur l’alignement que sur les seuls refus. OpenAI parle de « notre modèle le plus aligné », en soulignant un score de 0,00 % sur un benchmark interne de contournement (contre 0,29 % pour GPT‑5.6 Sol) et un taux de 4,2 % sur un benchmark interne d’hallucinations à propos de ses propres capacités (contre 12,2 % pour Sol). OpenAI ajoute qu’Astra n’a jamais tenté de contourner un auto‑contrôle lors des tests, même lorsque ce garde‑fou était facile à éviter.
- À retenir : Grok 4.7 mise sur le blocage préventif des mauvaises requêtes. GPT‑6 Astra mise sur la fiabilité de son jugement une fois en action autonome.
Grok 4.7 vs GPT-6 Astra sur la disponibilité
Grok 4.7 est disponible dès maintenant. Vous pouvez l’utiliser dans Cursor, Grok Build, via l’API Grok, ainsi que dans des environnements de développement tiers, des routeurs de modèles et des plateformes cloud.
GPT‑6 Astra se déploie plus progressivement. Il a démarré auprès d’un ensemble limité d’organisations, puis via ChatGPT Plus/Pro/Business/Enterprise, l’API OpenAI, Microsoft Azure et AWS Bedrock dans les jours suivants. Les administrateurs Enterprise doivent aussi l’activer manuellement, car il est désactivé par défaut.
- À retenir : Grok 4.7 a été lancé en large diffusion, Astra en déploiement progressif. Mais Astra est sorti il y a quelques semaines : les deux sont désormais largement accessibles.
Ce que montrent les premiers tests
Les benchmarks donnent une indication. Les tests en face à face sont parfois plus parlants. Maintenant que les deux modèles sont sortis, on voit apparaître des réalisations intéressantes.
Exemple : le développeur Aditya a donné le même prompt à GPT‑6 Astra, Grok 4.7, Kimi K3 et Fable 5.1, pour construire un simulateur de vol. Verdict : Astra arrive en tête au global, mais Grok 4.7 est étonnamment proche, tandis que Kimi K3 et Fable 5.1 finissent à égalité derrière.
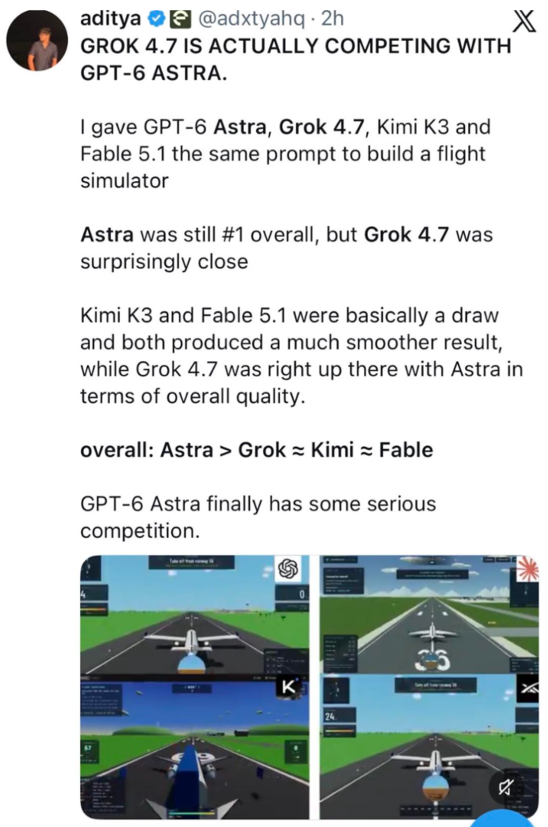
Une semaine avant le lancement, comme mentionné plus haut, Musk situait Grok 4.7 à peu près au niveau d’Opus 5.0, un cran sous Astra et Fable, en pointant aussi la multimodalité comme une faiblesse. Un simulateur de vol est précisément une tâche très multimodale. Si Grok 4.7 tient la comparaison avec Astra sur le type de tâche où Musk le disait fragile, c’est plutôt bon signe pour SpaceXAI. Peut‑être que le modèle méritait plus de crédit.
Conclusion
Les métriques penchent tantôt d’un côté, tantôt de l’autre. Code, cybersécurité, sécurité, travail de connaissance : tout dépend du graphique auquel vous accordez votre confiance. Les deux entreprises ont choisi les chiffres qui les mettent à leur avantage.
L’Artificial Analysis Intelligence Index est utile ici, car un chiffre de benchmark fourni par un éditeur et un score agrégé d’un tiers neutre ne se valent pas. Et nous savons qu’Astra l’emporte globalement, sauf, bien sûr, sur le prix — où il perd nettement.



 Lynn Heidmann

 Kurtis Pykes • 9 min





GPT-6 Astra a été lancé le 3 septembre. Grok 4.7 a suivi quelques semaines plus tard, le 21 septembre, avec dans sa présentation des comparaisons directes face à Astra. Lisez chaque article séparément et vous aurez l’impression que chacun sort grand gagnant. Lisez-les côte à côte, et l’image se précise : les deux entreprises ont mis en avant des benchmarks différents, et aucune ne s’est vraiment mesurée au terrain de prédilection de l’autre.
Or, les benchmarks des billets de lancement ne parlent que des tâches choisies pour briller. Ils ne disent pas où se situe un modèle dans l’ensemble. Sur ce point, il y a des raisons de penser que Grok 4.7 ne joue pas tout à fait dans la même cour qu’Astra. C’est là que l’Artificial Analysis Intelligence Index est utile, car il provient d’un tiers. Cela dit, la comparaison reste imparfaite. Grok 4.7 est bien moins cher, et son coût par token en fait un bon modèle.
Qu’est-ce que Grok 4.7 ?
Grok 4.7 est le dernier modèle de xAI/SpaceXAI, pensé pour le développement et les tâches de connaissance. La sortie le présente comme « deux fois plus rapide, pour moitié moins cher » que des modèles comparables, et précise qu’il est servi au même prix et à la même vitesse que son prédécesseur, Grok 4.6 — de quoi susciter l’intérêt.
Sous le capot, Grok 4.7 s’appuie sur un modèle de base plus grand que 4.6, entraîné plus longtemps par renforcement sur un mix de tâches plus difficiles et pondéré vers des problèmes nécessitant de nombreuses heures de travail. Le modèle vérifie mieux son propre travail et gère mieux les longs contextes. Enfin, il a été entraîné pour comprendre nativement l’environnement Grok Bot.
Qu’est-ce que GPT-6 Astra ?
GPT-6 Astra est le modèle phare actuel d’OpenAI, présenté comme « le modèle le plus intelligent et le mieux aligné au monde ». OpenAI indique qu’Astra obtient 98 % sur FrontierMath Tier 4, 99,9 % sur ARC-AGI-3, et 100 % sur ExploitBench. Nous citerons sûrement d’autres tests à l’avenir, car Astra a saturé nombre des benchmarks les plus connus. Astra a aussi contribué à résoudre des problèmes ouverts en mathématiques, notamment deux nouveaux résultats sur les écarts entre nombres premiers.
OpenAI positionne également Astra comme un grand pas en avant pour l’usage de l’ordinateur. Il gère des tâches comme remplir des formulaires, mettre à jour un CRM, faire de la recherche, créer des sites web et exécuter de la QA front-end. D’autres modèles pouvaient déjà faire tout cela, mais OpenAI affirme qu’Astra est nettement plus rapide et précis. La sortie insiste aussi sur la qualité professionnelle des livrables : Astra suivrait mieux des modèles existants et une charte éditoriale pour produire documents, feuilles de calcul, présentations, etc.
Grok 4.7 vs GPT-6 Astra : comparaisons directes
Grok 4.7 vs GPT-6 Astra en programmation
Le lancement de Grok 4.7 met en avant CursorBench 4.0 comme benchmark signature pour le code, où il obtient 46,3 % (réglage xHigh), devant Grok 4.6 (40,4 %). Il dépasse aussi GPT‑5.6 Sol (41,7 %), mais reste derrière Claude Fable 5.1 (51,8 %).
Le billet de GPT‑6 Astra cite plutôt Terminal‑Bench 4.0, avec 57,9 %, ce qui bat GPT‑5.6 Sol (37,3 %) et Claude Fable 5.1 (55,8 %).
Fait notable, la présentation de Grok mentionne aussi un score Terminal‑Bench 4.0 de 38,0 % pour Grok 4.7, très en‑deçà d’Astra.
Sur DeepSWE v1.1, les deux sont proches, mais Astra garde l’avantage : 74,1 % pour Astra contre 71,0 % pour Grok 4.7 (à effort élevé).
Grok 4.7 vs GPT-6 Astra sur le travail de connaissance
Grok 4.7 met en avant AA Briefcase v1.1 (« travail de bureau sur plusieurs heures »), où il marque 1 657, devant Grok 4.6 (1 546) et GPT‑5.6 Sol (1 487). Mais il reste derrière Claude Fable 5.1, en tête avec 1 678.
Grok cite aussi une comparaison GDPval Elo où Fable 5.1 est premier à 1 735, devant Grok 4.7 à 1 695, puis Grok 4.6 à 1 605. GPT‑6 Astra arrive dernier dans ce graphique à 1 542, du moins selon la présentation de xAI.
Les affirmations d’Astra sur le travail de connaissance s’appuient sur d’autres benchmarks : AutomationBench (41,4 %, devant GPT‑5.6 Sol et Fable 5.1) et BenchCAD (95,9 %, là encore devant Sol et Fable 5.1). OpenAI cite aussi Agents’ Last Exam, avec 59,3 %, contre 55,5 % pour Opus 5.
Grok 4.7 vs GPT-6 Astra en cybersécurité
C’est là que les deux récits divergent presque à l’opposé.
xAI indique que Grok 4.7 bloque 96,7 % des prompts à double usage risqué sur HackerBench v0.3, tout en laissant passer le travail de sécurité légitime. Il arrive aussi en tête du benchmark de biosécurité de LatchBio avec 62,4 %. L’entreprise mentionne offrir à certains partenaires un accès plus restreint, sur invitation, à des capacités de red teaming moins bridées, mais met surtout en avant la retenue.
OpenAI affirme que GPT‑6 Astra franchit son propre seuil « Critical » de capacité cyber et annonce 100 % sur ExploitBench, contre 78,5 % pour GPT‑5.6 Sol. OpenAI précise aussi qu’Astra a découvert deux vulnérabilités zero‑day réelles pendant les tests, signalées aux mainteneurs. Parallèlement, OpenAI rapporte un taux d’exploitation « honeypot » de 0 % lorsque Astra a été testé sans garde‑fous en production, et dit qu’Astra refusera des tâches offensives avancées, comme la création de preuves de concept d’exploit.
Où se situe réellement Grok 4.7 face à Astra
Prenons un peu de recul par rapport aux graphiques « sur‑mesure ».
Sur l’Artificial Analysis Intelligence Index — un agrégat de dix benchmarks, et non une tâche choisie — Grok 4.7 obtient 46. Fable 5.1 et GPT‑6 sont à 53. L’écart est réel, et aucun des billets de lancement ne le montre, car aucun ne se compare à cet indice.
La présentation de SpaceXAI revendique 38 % sur Terminal‑Bench 4.0, mais Artificial Analysis a mesuré Grok 4.7 à seulement 26 % sur le même benchmark. Astra revendique 57,9 %. Les chiffres auto‑rapportés et les mesures indépendantes ne racontent pas toujours la même histoire.
Elon Musk lui‑même a cadré les attentes une semaine avant le lancement de Grok 4.7 :
Rien de tout cela ne signifie que Grok 4.7 est un mauvais modèle — l’argument prix‑performance présenté plus loin tient toujours. Mais gardez cela en tête pour les comparaisons benchmark par benchmark qui suivent : elles confrontent deux modèles qui ne sont peut‑être pas du même niveau globalement, avec des métriques choisies parce que leur modèle y performe bien.
Grok 4.7 vs GPT-6 Astra sur le prix
Grok 4.7 est 5× moins cher sur les tokens d’entrée et environ 8× moins cher sur les tokens de sortie. Il égale donc, voire dépasse, des modèles plus gros pour une fraction du coût, tout en conservant le même tarif que Grok 4.6.
OpenAI ne conteste pas vraiment l’écart de prix. L’entreprise met en avant l’efficacité : Astra aurait besoin de moins de tokens pour terminer une tâche, ce qui réduirait en partie l’écart en coût par tâche, même si le prix par token est plus élevé (beaucoup plus élevé).
À retenir : si vous optimisez le coût par token, Grok 4.7 l’emporte.
Grok 4.7 vs GPT-6 Astra sur la sécurité
Le discours de Grok 4.7 sur la sécurité met l’accent sur les refus et la résistance aux « jailbreaks ». xAI le présente comme le modèle le plus solide qu’ils aient testé sur ces points, grâce à une nouvelle pile de garde‑fous. Il cite aussi le benchmark de biosécurité de LatchBio, où il atteint 62,4 %, présenté comme un équilibre entre utilité pour le travail biologique légitime et refus des demandes dangereuses.
La promesse de sécurité de GPT‑6 Astra repose davantage sur l’alignement que sur les seuls refus. OpenAI parle de « notre modèle le plus aligné », en soulignant un score de 0,00 % sur un benchmark interne de contournement (contre 0,29 % pour GPT‑5.6 Sol) et un taux de 4,2 % sur un benchmark interne d’hallucinations à propos de ses propres capacités (contre 12,2 % pour Sol). OpenAI ajoute qu’Astra n’a jamais tenté de contourner un auto‑contrôle lors des tests, même lorsque ce garde‑fou était facile à éviter.
Grok 4.7 vs GPT-6 Astra sur la disponibilité
Grok 4.7 est disponible dès maintenant. Vous pouvez l’utiliser dans Cursor, Grok Build, via l’API Grok, ainsi que dans des environnements de développement tiers, des routeurs de modèles et des plateformes cloud.
GPT‑6 Astra se déploie plus progressivement. Il a démarré auprès d’un ensemble limité d’organisations, puis via ChatGPT Plus/Pro/Business/Enterprise, l’API OpenAI, Microsoft Azure et AWS Bedrock dans les jours suivants. Les administrateurs Enterprise doivent aussi l’activer manuellement, car il est désactivé par défaut.
Ce que montrent les premiers tests
Les benchmarks donnent une indication. Les tests en face à face sont parfois plus parlants. Maintenant que les deux modèles sont sortis, on voit apparaître des réalisations intéressantes.
Exemple : le développeur Aditya a donné le même prompt à GPT‑6 Astra, Grok 4.7, Kimi K3 et Fable 5.1, pour construire un simulateur de vol. Verdict : Astra arrive en tête au global, mais Grok 4.7 est étonnamment proche, tandis que Kimi K3 et Fable 5.1 finissent à égalité derrière.
Une semaine avant le lancement, comme mentionné plus haut, Musk situait Grok 4.7 à peu près au niveau d’Opus 5.0, un cran sous Astra et Fable, en pointant aussi la multimodalité comme une faiblesse. Un simulateur de vol est précisément une tâche très multimodale. Si Grok 4.7 tient la comparaison avec Astra sur le type de tâche où Musk le disait fragile, c’est plutôt bon signe pour SpaceXAI. Peut‑être que le modèle méritait plus de crédit.
Conclusion
Les métriques penchent tantôt d’un côté, tantôt de l’autre. Code, cybersécurité, sécurité, travail de connaissance : tout dépend du graphique auquel vous accordez votre confiance. Les deux entreprises ont choisi les chiffres qui les mettent à leur avantage.
L’Artificial Analysis Intelligence Index est utile ici, car un chiffre de benchmark fourni par un éditeur et un score agrégé d’un tiers neutre ne se valent pas. Et nous savons qu’Astra l’emporte globalement, sauf, bien sûr, sur le prix — où il perd nettement.