O GPT-6 Astra foi lançado em 3 de setembro. O Grok 4.7 chegou algumas semanas depois, em 21 de setembro, já trazendo comparações com o Astra dentro do próprio anúncio. Se você ler os dois posts separadamente, vai parecer que cada um é o claro vencedor. Lendo lado a lado, dá para ver o que realmente acontece: as duas empresas escolheram benchmarks diferentes para estampar no topo, e nenhuma mediu seu modelo contra o gráfico favorito da outra.
Só que os benchmarks do post de lançamento contam apenas sobre as tarefas que cada empresa decidiu destacar. Eles não dizem em que nível o modelo está no geral. Nessa visão mais ampla, há motivos para achar que o Grok 4.7 não joga exatamente na mesma liga do Astra. É aí que o Artificial Analysis Intelligence Index ajuda, por ser de terceiros. Dito isso, a comparação não é limpa. O Grok 4.7 é bem mais barato, e o custo por token faz dele um bom modelo.
O que é o Grok 4.7?
Grok 4.7 é o modelo mais novo da xAI/SpaceXAI, voltado para programação e trabalho de conhecimento. O lançamento o descreve como "duas vezes mais rápido, pela metade do preço" em relação a modelos comparáveis, e diz que ele é oferecido com o mesmo preço e velocidade do seu antecessor, o Grok 4.6 — uma ótima forma de gerar buzz.
Por baixo do capô, o Grok 4.7 usa um modelo base maior que o 4.6, treinado com uma etapa mais longa de reinforcement learning, em um conjunto de tarefas mais difíceis e com peso maior para problemas que levam muitas horas para concluir. Além disso, o modelo está melhor em checar o próprio trabalho e gerenciar contextos mais extensos. Por fim, vale notar que ele foi treinado para entender nativamente o ambiente do Grok Bot.
O que é o GPT-6 Astra?
GPT-6 Astra é o modelo carro-chefe atual da OpenAI. A empresa o chama de "o modelo mais inteligente e alinhado do mundo". Segundo a OpenAI, o Astra marca 98% no FrontierMath Tier 4, 99,9% no ARC-AGI-3 e 100% no ExploitBench. É bem provável que, em artigos futuros, a gente use outros testes de benchmark, já que o Astra está saturando muitos dos mais conhecidos. Além disso, o Astra já ajudou com problemas em aberto de matemática, incluindo dois novos resultados sobre lacunas entre números primos.
Mais que isso, a OpenAI posiciona o Astra como um salto importante no uso do computador. Ele dá conta de tarefas como preencher formulários, atualizar registros de CRM, fazer pesquisas, construir sites e rodar QA de frontend. Outros modelos já faziam tudo isso, mas a OpenAI diz que o Astra é muito mais rápido e preciso. O anúncio também reforça a qualidade profissional dos outputs, dizendo que o Astra segue melhor modelos e guias de estilo existentes ao produzir documentos, planilhas, apresentações e afins.
Comparativos diretos: Grok 4.7 vs. GPT-6 Astra
Grok 4.7 vs. GPT-6 Astra em programação
O lançamento do Grok 4.7 destaca o CursorBench 4.0 como seu benchmark assinatura para código, onde ele marca 46,3% (configuração xHigh), superando o Grok 4.6 (40,4%). Ele também fica à frente do GPT‑5.6 Sol (41,7%), mas atrás do Claude Fable 5.1 (51,8%).
Já o post do GPT‑6 Astra menciona o Terminal-Bench 4.0, no qual ele alega 57,9%, superando o GPT‑5.6 Sol (37,3%) e o Claude Fable 5.1 (55,8%).
Curiosamente, o anúncio do Grok também informa um número de 38,0% no Terminal-Bench 4.0 para o Grok 4.7, bem abaixo da pontuação do Astra.
No DeepSWE v1.1, os dois ficam próximos, mas o Astra leva vantagem: Astra reporta 74,1% contra 71,0% do Grok 4.7 (em high effort).
- Resumo: O conjunto de benchmarks do Astra para código é mais amplo e mostra um quadro geral mais forte, mas as duas empresas escolheram benchmarks-vitrine diferentes, o que dificulta uma comparação justa. Isso acontece com frequência — provavelmente de propósito.
Grok 4.7 vs. GPT-6 Astra em trabalho de conhecimento
O Grok 4.7 destaca o AA Briefcase v1.1 ("trabalho de escritório por várias horas"), onde marca 1.657, à frente do Grok 4.6 (1.546) e do GPT‑5.6 Sol (1.487). Mas ainda fica atrás do Claude Fable 5.1, que lidera o ranking com 1.678.
O Grok também cita uma comparação GDPval Elo em que o Fable 5.1 lidera com 1.735, seguido pelo Grok 4.7 com 1.695 e depois pelo Grok 4.6 com 1.605. O GPT‑6 Astra aparece por último nesse gráfico com 1.542 — ao menos na apresentação da xAI.
As afirmações do GPT‑6 Astra sobre trabalho de conhecimento se apoiam em benchmarks totalmente diferentes: AutomationBench (41,4%, à frente do GPT‑5.6 Sol e do Fable 5.1) e BenchCAD (95,9%, novamente à frente do Sol e do Fable 5.1). Ele também cita o Agents' Last Exam, com 59,3%, acima dos 55,5% do Opus 5.
- Resumo: Cada empresa escolheu os benchmarks que mais a favorecem. O Grok se apoia em resistência a longo prazo em tarefas de escritório e em pontuações Elo de horizonte longo, enquanto o Astra se apoia em benchmarks de conclusão de tarefas e de seguir modelos/template. Nenhum dos anúncios coloca seu próprio modelo contra o benchmark favorito da outra e perde, então é difícil comparar. Podemos chamar esse de empate.
Grok 4.7 vs. GPT-6 Astra em cibersegurança
Aqui, os dois anúncios contam histórias quase opostas.
A xAI diz que o Grok 4.7 bloqueia 96,7% de prompts de uso duplo arriscados no HackerBench v0.3, ao mesmo tempo em que permite trabalhos legítimos de segurança. Ele também lidera o benchmark de biossegurança da LatchBio com 62,4%. A empresa menciona dar a alguns parceiros acesso mais restrito, por convite, a capacidades de red team menos limitadas, mas a mensagem principal é de contenção.
A OpenAI diz que o GPT‑6 Astra ultrapassa seu próprio limiar "Crítico" de capacidade cibernética e reporta 100% no ExploitBench, contra 78,5% do GPT‑5.6 Sol. Afirma também que o Astra encontrou duas vulnerabilidades zero-day reais durante os testes, que a OpenAI disse ter comunicado aos mantenedores. Junto a isso, a OpenAI reporta 0% de taxa de exploração em "honeypots" quando o Astra foi testado sem proteções de produção e diz que o Astra recusará tarefas ofensivas mais avançadas, como criação de prova de conceito de exploit.
- Resumo: O Grok 4.7 é vendido como seguro porque segura a onda. O GPT‑6 Astra é vendido como seguro porque permanece alinhado mesmo quando não segura. Vale notar que "seguro" significa coisas diferentes em cada discurso.
Onde o Grok 4.7 realmente se posiciona em relação ao Astra
Vamos sair dos gráficos escolhidos a dedo.
No Artificial Analysis Intelligence Index — uma média de dez benchmarks, não uma tarefa escolhida a dedo — o Grok 4.7 marca 46. Fable 5.1 e GPT-6 marcam 53. É uma diferença, e não é algo que os posts de lançamento mostrem, já que nenhum deles compara com esse índice.
O próprio anúncio da SpaceXAI afirma 38% no Terminal-Bench 4.0, mas a Artificial Analysis mediu o Grok 4.7 de forma independente em apenas 26% no mesmo benchmark. O Astra afirma 57,9%. Números auto-reportados e números medidos independentemente nem sempre contam a mesma história.
O próprio Elon Musk preparou o terreno uma semana antes do lançamento do Grok 4.7:
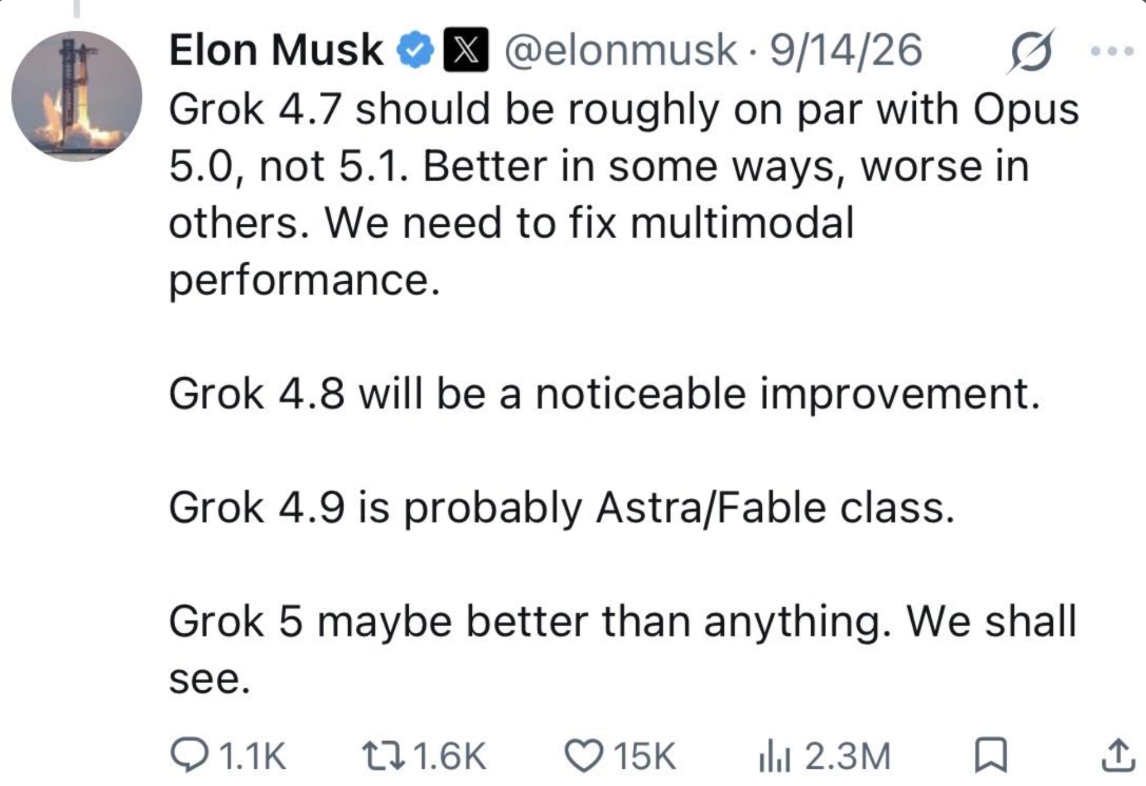
Nada disso significa que o Grok 4.7 seja um modelo ruim — a relação preço-desempenho que mostramos mais adiante continua valendo. Mas é importante ler as comparações de benchmark a seguir com isso em mente: elas comparam dois modelos que talvez não sejam pares no geral, usando métricas escolhidas porque favorecem cada um deles.
Grok 4.7 vs. GPT-6 Astra em preço
O Grok 4.7 é 5x mais barato em tokens de entrada e cerca de 8x mais barato em tokens de saída. Ou seja, o Grok 4.7 iguala ou supera modelos maiores por uma fração do custo, mantendo o preço estável em relação ao Grok 4.6.
A OpenAI não contesta muito a diferença de preço. Ela argumenta eficiência: o Astra precisaria de menos tokens para concluir uma tarefa, o que reduziria parcialmente o custo por tarefa, mesmo que a tarifa por token seja mais alta (bem mais alta).
| | Entrada ($/M tokens) | Saída ($/M tokens) | Camada fast |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2x de velocidade por 2x o preço |
| GPT‑6 Astra | $10 | $50 | 2x de velocidade por 2x o preço |
Resumo: se o seu foco é custo por token, o Grok 4.7 vence.
Grok 4.7 vs. GPT-6 Astra em segurança
A proposta de segurança do Grok 4.7 gira em torno de recusas e resistência a jailbreak. A xAI o chama de o modelo mais forte que testaram nesses quesitos, respaldado por uma nova pilha de salvaguardas. Também cita o benchmark de biossegurança da LatchBio, no qual marca 62,4%, vendendo o equilíbrio entre utilidade em trabalhos biológicos legítimos e recusas seguras a pedidos perigosos.
A proposta de segurança do GPT-6 Astra fala mais de alinhamento do que de recusas isoladas. A OpenAI o chama de "nosso modelo mais alinhado", apontando 0,00% em um benchmark interno de contorno de salvaguardas (contra 0,29% do GPT-5.6 Sol) e 4,2% em um benchmark interno de alucinações sobre suas próprias capacidades (contra 12,2% do Sol). Diz também que o Astra nunca tentou burlar uma proteção de auto-review nos testes, mesmo quando essa proteção foi tornada fácil de driblar.
- Resumo: O Grok 4.7 foca em barrar pedidos ruins já na largada. O GPT-6 Astra foca em poder confiar no seu julgamento quando já está atuando de forma autônoma.
Grok 4.7 vs. GPT-6 Astra em disponibilidade
O Grok 4.7 já está disponível. Você encontra no Cursor, no Grok Build, na Grok API e em ferramentas de código de terceiros, roteadores de modelos e plataformas de nuvem.
O GPT‑6 Astra está chegando de forma mais gradual. Começou com um conjunto limitado de organizações; depois, o acesso veio para ChatGPT Plus/Pro/Business/Enterprise, a OpenAI API, Microsoft Azure e AWS Bedrock ao longo dos dias seguintes. Em empresas, os admins também precisam ativá-lo manualmente, pois vem desativado por padrão.
- Resumo: O Grok 4.7 fez um lançamento amplo; o Astra, em etapas. Mas o Astra saiu há algumas semanas, então ambos já estão amplamente disponíveis.
O que os primeiros testes estão mostrando
Benchmark é uma coisa. Teste direto, lado a lado, costuma ser ainda mais interessante. Agora que os dois modelos estão no ar, começam a aparecer coisas legais que as pessoas estão construindo.
Um exemplo: o desenvolvedor Aditya deu o mesmo prompt para o GPT-6 Astra, o Grok 4.7, o Kimi K3 e o Fable 5.1 — a tarefa era construir um simulador de voo. Veredito dele: o Astra ficou em primeiro no geral, mas o Grok 4.7 chegou surpreendentemente perto, enquanto Kimi K3 e Fable 5.1 empataram atrás.
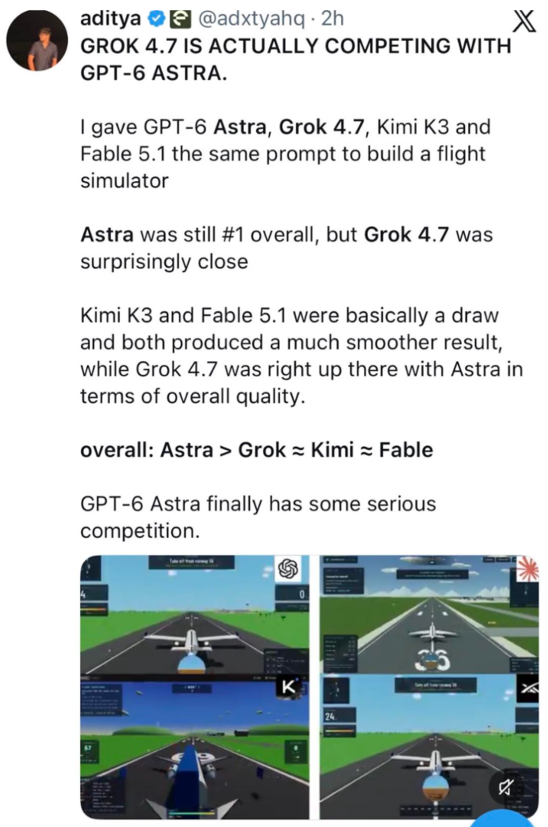
Uma semana antes do lançamento, como já mencionei, Musk posicionou o Grok 4.7 como algo próximo da classe Opus 5.0 e um degrau abaixo de Astra e Fable, além de apontar multimodalidade como fraqueza específica. Um simulador de voo é tão multimodal quanto uma tarefa pode ser. Se for assim, o Grok 4.7 ter acompanhado o Astra justamente no tipo de tarefa em que o Musk disse que ele teria dificuldade é um bom sinal para a SpaceXAI. Talvez o Elon tenha subestimado o modelo.
Conclusão
As métricas dos modelos dão um pouco cara ou coroa. Código, cibersegurança, segurança, trabalho de conhecimento: depende de qual gráfico você decide confiar. As duas empresas escolheram os números que as favorecem.
Mas o Artificial Analysis Intelligence Index é útil aqui porque um número único de benchmark fornecido pelo vendedor e um número agregado de um terceiro neutro não são o mesmo tipo de evidência — e sabemos que o Astra vence no geral, exceto, claro, em preço, onde perde feio.


 Richie Cotton• 7 min

 Khalid Abdelaty• 15 min

 Abid Ali Awan• 9 min




O GPT-6 Astra foi lançado em 3 de setembro. O Grok 4.7 chegou algumas semanas depois, em 21 de setembro, já trazendo comparações com o Astra dentro do próprio anúncio. Se você ler os dois posts separadamente, vai parecer que cada um é o claro vencedor. Lendo lado a lado, dá para ver o que realmente acontece: as duas empresas escolheram benchmarks diferentes para estampar no topo, e nenhuma mediu seu modelo contra o gráfico favorito da outra.
Só que os benchmarks do post de lançamento contam apenas sobre as tarefas que cada empresa decidiu destacar. Eles não dizem em que nível o modelo está no geral. Nessa visão mais ampla, há motivos para achar que o Grok 4.7 não joga exatamente na mesma liga do Astra. É aí que o Artificial Analysis Intelligence Index ajuda, por ser de terceiros. Dito isso, a comparação não é limpa. O Grok 4.7 é bem mais barato, e o custo por token faz dele um bom modelo.
O que é o Grok 4.7?
Grok 4.7 é o modelo mais novo da xAI/SpaceXAI, voltado para programação e trabalho de conhecimento. O lançamento o descreve como "duas vezes mais rápido, pela metade do preço" em relação a modelos comparáveis, e diz que ele é oferecido com o mesmo preço e velocidade do seu antecessor, o Grok 4.6 — uma ótima forma de gerar buzz.
Por baixo do capô, o Grok 4.7 usa um modelo base maior que o 4.6, treinado com uma etapa mais longa de reinforcement learning, em um conjunto de tarefas mais difíceis e com peso maior para problemas que levam muitas horas para concluir. Além disso, o modelo está melhor em checar o próprio trabalho e gerenciar contextos mais extensos. Por fim, vale notar que ele foi treinado para entender nativamente o ambiente do Grok Bot.
O que é o GPT-6 Astra?
GPT-6 Astra é o modelo carro-chefe atual da OpenAI. A empresa o chama de "o modelo mais inteligente e alinhado do mundo". Segundo a OpenAI, o Astra marca 98% no FrontierMath Tier 4, 99,9% no ARC-AGI-3 e 100% no ExploitBench. É bem provável que, em artigos futuros, a gente use outros testes de benchmark, já que o Astra está saturando muitos dos mais conhecidos. Além disso, o Astra já ajudou com problemas em aberto de matemática, incluindo dois novos resultados sobre lacunas entre números primos.
Mais que isso, a OpenAI posiciona o Astra como um salto importante no uso do computador. Ele dá conta de tarefas como preencher formulários, atualizar registros de CRM, fazer pesquisas, construir sites e rodar QA de frontend. Outros modelos já faziam tudo isso, mas a OpenAI diz que o Astra é muito mais rápido e preciso. O anúncio também reforça a qualidade profissional dos outputs, dizendo que o Astra segue melhor modelos e guias de estilo existentes ao produzir documentos, planilhas, apresentações e afins.
Comparativos diretos: Grok 4.7 vs. GPT-6 Astra
Grok 4.7 vs. GPT-6 Astra em programação
O lançamento do Grok 4.7 destaca o CursorBench 4.0 como seu benchmark assinatura para código, onde ele marca 46,3% (configuração xHigh), superando o Grok 4.6 (40,4%). Ele também fica à frente do GPT‑5.6 Sol (41,7%), mas atrás do Claude Fable 5.1 (51,8%).
Já o post do GPT‑6 Astra menciona o Terminal-Bench 4.0, no qual ele alega 57,9%, superando o GPT‑5.6 Sol (37,3%) e o Claude Fable 5.1 (55,8%).
Curiosamente, o anúncio do Grok também informa um número de 38,0% no Terminal-Bench 4.0 para o Grok 4.7, bem abaixo da pontuação do Astra.
No DeepSWE v1.1, os dois ficam próximos, mas o Astra leva vantagem: Astra reporta 74,1% contra 71,0% do Grok 4.7 (em high effort).
Grok 4.7 vs. GPT-6 Astra em trabalho de conhecimento
O Grok 4.7 destaca o AA Briefcase v1.1 ("trabalho de escritório por várias horas"), onde marca 1.657, à frente do Grok 4.6 (1.546) e do GPT‑5.6 Sol (1.487). Mas ainda fica atrás do Claude Fable 5.1, que lidera o ranking com 1.678.
O Grok também cita uma comparação GDPval Elo em que o Fable 5.1 lidera com 1.735, seguido pelo Grok 4.7 com 1.695 e depois pelo Grok 4.6 com 1.605. O GPT‑6 Astra aparece por último nesse gráfico com 1.542 — ao menos na apresentação da xAI.
As afirmações do GPT‑6 Astra sobre trabalho de conhecimento se apoiam em benchmarks totalmente diferentes: AutomationBench (41,4%, à frente do GPT‑5.6 Sol e do Fable 5.1) e BenchCAD (95,9%, novamente à frente do Sol e do Fable 5.1). Ele também cita o Agents' Last Exam, com 59,3%, acima dos 55,5% do Opus 5.
Grok 4.7 vs. GPT-6 Astra em cibersegurança
Aqui, os dois anúncios contam histórias quase opostas.
A xAI diz que o Grok 4.7 bloqueia 96,7% de prompts de uso duplo arriscados no HackerBench v0.3, ao mesmo tempo em que permite trabalhos legítimos de segurança. Ele também lidera o benchmark de biossegurança da LatchBio com 62,4%. A empresa menciona dar a alguns parceiros acesso mais restrito, por convite, a capacidades de red team menos limitadas, mas a mensagem principal é de contenção.
A OpenAI diz que o GPT‑6 Astra ultrapassa seu próprio limiar "Crítico" de capacidade cibernética e reporta 100% no ExploitBench, contra 78,5% do GPT‑5.6 Sol. Afirma também que o Astra encontrou duas vulnerabilidades zero-day reais durante os testes, que a OpenAI disse ter comunicado aos mantenedores. Junto a isso, a OpenAI reporta 0% de taxa de exploração em "honeypots" quando o Astra foi testado sem proteções de produção e diz que o Astra recusará tarefas ofensivas mais avançadas, como criação de prova de conceito de exploit.
Onde o Grok 4.7 realmente se posiciona em relação ao Astra
Vamos sair dos gráficos escolhidos a dedo.
No Artificial Analysis Intelligence Index — uma média de dez benchmarks, não uma tarefa escolhida a dedo — o Grok 4.7 marca 46. Fable 5.1 e GPT-6 marcam 53. É uma diferença, e não é algo que os posts de lançamento mostrem, já que nenhum deles compara com esse índice.
O próprio anúncio da SpaceXAI afirma 38% no Terminal-Bench 4.0, mas a Artificial Analysis mediu o Grok 4.7 de forma independente em apenas 26% no mesmo benchmark. O Astra afirma 57,9%. Números auto-reportados e números medidos independentemente nem sempre contam a mesma história.
O próprio Elon Musk preparou o terreno uma semana antes do lançamento do Grok 4.7:
Nada disso significa que o Grok 4.7 seja um modelo ruim — a relação preço-desempenho que mostramos mais adiante continua valendo. Mas é importante ler as comparações de benchmark a seguir com isso em mente: elas comparam dois modelos que talvez não sejam pares no geral, usando métricas escolhidas porque favorecem cada um deles.
Grok 4.7 vs. GPT-6 Astra em preço
O Grok 4.7 é 5x mais barato em tokens de entrada e cerca de 8x mais barato em tokens de saída. Ou seja, o Grok 4.7 iguala ou supera modelos maiores por uma fração do custo, mantendo o preço estável em relação ao Grok 4.6.
A OpenAI não contesta muito a diferença de preço. Ela argumenta eficiência: o Astra precisaria de menos tokens para concluir uma tarefa, o que reduziria parcialmente o custo por tarefa, mesmo que a tarifa por token seja mais alta (bem mais alta).
Resumo: se o seu foco é custo por token, o Grok 4.7 vence.
Grok 4.7 vs. GPT-6 Astra em segurança
A proposta de segurança do Grok 4.7 gira em torno de recusas e resistência a jailbreak. A xAI o chama de o modelo mais forte que testaram nesses quesitos, respaldado por uma nova pilha de salvaguardas. Também cita o benchmark de biossegurança da LatchBio, no qual marca 62,4%, vendendo o equilíbrio entre utilidade em trabalhos biológicos legítimos e recusas seguras a pedidos perigosos.
A proposta de segurança do GPT-6 Astra fala mais de alinhamento do que de recusas isoladas. A OpenAI o chama de "nosso modelo mais alinhado", apontando 0,00% em um benchmark interno de contorno de salvaguardas (contra 0,29% do GPT-5.6 Sol) e 4,2% em um benchmark interno de alucinações sobre suas próprias capacidades (contra 12,2% do Sol). Diz também que o Astra nunca tentou burlar uma proteção de auto-review nos testes, mesmo quando essa proteção foi tornada fácil de driblar.
Grok 4.7 vs. GPT-6 Astra em disponibilidade
O Grok 4.7 já está disponível. Você encontra no Cursor, no Grok Build, na Grok API e em ferramentas de código de terceiros, roteadores de modelos e plataformas de nuvem.
O GPT‑6 Astra está chegando de forma mais gradual. Começou com um conjunto limitado de organizações; depois, o acesso veio para ChatGPT Plus/Pro/Business/Enterprise, a OpenAI API, Microsoft Azure e AWS Bedrock ao longo dos dias seguintes. Em empresas, os admins também precisam ativá-lo manualmente, pois vem desativado por padrão.
O que os primeiros testes estão mostrando
Benchmark é uma coisa. Teste direto, lado a lado, costuma ser ainda mais interessante. Agora que os dois modelos estão no ar, começam a aparecer coisas legais que as pessoas estão construindo.
Um exemplo: o desenvolvedor Aditya deu o mesmo prompt para o GPT-6 Astra, o Grok 4.7, o Kimi K3 e o Fable 5.1 — a tarefa era construir um simulador de voo. Veredito dele: o Astra ficou em primeiro no geral, mas o Grok 4.7 chegou surpreendentemente perto, enquanto Kimi K3 e Fable 5.1 empataram atrás.
Uma semana antes do lançamento, como já mencionei, Musk posicionou o Grok 4.7 como algo próximo da classe Opus 5.0 e um degrau abaixo de Astra e Fable, além de apontar multimodalidade como fraqueza específica. Um simulador de voo é tão multimodal quanto uma tarefa pode ser. Se for assim, o Grok 4.7 ter acompanhado o Astra justamente no tipo de tarefa em que o Musk disse que ele teria dificuldade é um bom sinal para a SpaceXAI. Talvez o Elon tenha subestimado o modelo.
Conclusão
As métricas dos modelos dão um pouco cara ou coroa. Código, cibersegurança, segurança, trabalho de conhecimento: depende de qual gráfico você decide confiar. As duas empresas escolheram os números que as favorecem.
Mas o Artificial Analysis Intelligence Index é útil aqui porque um número único de benchmark fornecido pelo vendedor e um número agregado de um terceiro neutro não são o mesmo tipo de evidência — e sabemos que o Astra vence no geral, exceto, claro, em preço, onde perde feio.