
Kursus
Memahami Kecerdasan Buatan
2 jam
426.1K
GPT-6 Astra diluncurkan pada 3 September. Grok 4.7 menyusul beberapa minggu kemudian, pada 21 September, dengan perbandingan melawan Astra dari SpaceXAI yang langsung disertakan dalam rilisnya. Baca kedua postingan itu satu per satu dan Anda akan mengira masing-masing jelas menang. Baca berdampingan, dan akan lebih jelas apa yang sebenarnya terjadi: dua perusahaan memilih tolok ukur berbeda untuk ditonjolkan, dan tidak ada yang mengukur diri terhadap bagan favorit pihak lain.
Namun tolok ukur di postingan peluncuran hanya memberi tahu Anda tentang tugas spesifik yang dipilih masing-masing perusahaan untuk dipamerkan. Itu tidak memberi tahu Anda posisi model secara keseluruhan. Untuk pertanyaan yang lebih besar itu, ada alasan untuk berpikir Grok 4.7 sebenarnya tidak bermain di kelas yang sama dengan Astra. Di sinilah Artificial Analysis Intelligence Index berguna karena merupakan pihak ketiga. Meski begitu, perbandingannya tidak bersih. Grok 4.7 jauh lebih murah, dan biaya per token membuatnya menjadi model yang bagus.
Grok 4.7 adalah model terbaru xAI/SpaceXAI, diposisikan untuk pekerjaan coding dan pengetahuan. Rilisnya menggambarkan model ini sebagai "dua kali lebih cepat, dengan setengah harga" dibanding model sekelasnya, dan menyatakan disajikan dengan harga dan kecepatan yang sama seperti pendahulunya, Grok 4.6, yang merupakan cara bagus untuk menarik perhatian.
Di balik itu, Grok 4.7 menggunakan model dasar yang lebih besar daripada 4.6, dilatih dengan run reinforcement learning yang lebih panjang pada campuran tugas yang lebih sulit dan diberi bobot pada masalah yang memakan waktu berjam-jam untuk diselesaikan. Selain itu, model ini lebih baik dalam memeriksa hasil kerjanya sendiri dan mengelola konteks yang lebih panjang. Terakhir, perlu diketahui model ini dilatih untuk memahami secara native kerangka Grok Bot.
GPT-6 Astra adalah model andalan OpenAI saat ini. OpenAI menyebutnya "model paling cerdas dan paling selaras di dunia." OpenAI mengatakan Astra meraih 98% pada FrontierMath Tier 4, 99,9% pada ARC-AGI-3, dan 100% pada ExploitBench. Kami yakin di artikel-artikel berikutnya kami akan merujuk tolok ukur lainnya karena Astra telah mendominasi banyak tolok ukur paling dikenal. Selain itu, Astra sudah membantu memecahkan masalah terbuka dalam matematika, termasuk dua hasil baru terkait jarak antar bilangan prima.
Lebih jauh lagi, OpenAI memposisikan Astra sebagai lompatan besar dalam penggunaan komputer. Model ini menangani tugas seperti mengisi formulir, memperbarui catatan CRM, melakukan riset, membangun situs web, dan menjalankan QA frontend. Model lain sudah melakukan semua ini, tetapi OpenAI mengatakan Astra lebih cepat dan lebih akurat. Rilisnya juga menekankan kualitas keluaran profesional, menyebut Astra lebih baik dalam mengikuti templat dan gaya rumah yang ada saat menghasilkan dokumen, spreadsheet, slide, dan sejenisnya.
Rilis Grok 4.7 menempatkan CursorBench 4.0 sebagai tolok ukur coding utamanya, dengan skor 46,3% (pengaturan xHigh), unggul dari Grok 4.6 (40,4%). Ini juga di atas GPT‑5.6 Sol (41,7%), tetapi di bawah Claude Fable 5.1 (51,8%).
Postingan GPT‑6 Astra justru menyebut Terminal-Bench 4.0, dengan klaim 57,9%, mengalahkan GPT‑5.6 Sol (37,3%) dan Claude Fable 5.1 (55,8%).
Menariknya, rilis Grok juga melaporkan angka Terminal-Bench 4.0 sebesar 38,0% untuk Grok 4.7, yang jauh di bawah skor Astra.
Pada DeepSWE v1.1, keduanya berdekatan, tetapi Astra unggul: Astra melaporkan 74,1% versus 71,0% untuk Grok 4.7 (pada upaya tinggi).
Grok 4.7 menonjolkan AA Briefcase v1.1 ("pekerjaan kantor berjam-jam"), dengan skor 1.657, unggul dari Grok 4.6 (1.546) dan GPT‑5.6 Sol (1.487). Namun masih di bawah Claude Fable 5.1, yang memimpin grafik itu dengan 1.678.
Grok juga menyebut perbandingan GDPval Elo di mana Fable 5.1 memimpin pada 1.735, diikuti Grok 4.7 pada 1.695, lalu Grok 4.6 pada 1.605. GPT‑6 Astra berada terakhir di grafik ini pada 1.542, setidaknya dalam presentasi versi xAI.
Klaim pekerjaan pengetahuan GPT‑6 Astra bertumpu pada tolok ukur yang sama sekali berbeda: AutomationBench (41,4%, di atas GPT‑5.6 Sol dan Fable 5.1) dan BenchCAD (95,9%, kembali di atas Sol dan Fable 5.1). Astra juga menyebut Agents' Last Exam, dengan skor 59,3%, unggul dari 55,5% milik Opus 5.
Di sinilah kedua rilis memberi kisah yang hampir berlawanan.
xAI mengatakan Grok 4.7 memblokir 96,7% prompt penggunaan ganda berisiko pada HackerBench v0.3, sambil tetap mengizinkan pekerjaan keamanan yang sah. Model ini juga memimpin tolok ukur biosafety LatchBio di 62,4%. Perusahaan menyebut memberi mitra terpilih akses terbatas dan undangan khusus ke kapabilitas red-team yang kurang dibatasi, tetapi bingkai utama pesannya adalah pengekangan.
OpenAI mengatakan GPT‑6 Astra melampaui ambang "Kritis" untuk kapabilitas siber versi mereka, dan melaporkan skor 100% pada ExploitBench, versus 78,5% untuk GPT‑5.6 Sol. OpenAI juga mengatakan Astra menemukan dua kerentanan zero-day nyata selama pengujian, yang menurut OpenAI telah mereka ungkapkan kepada para maintainer. Bersamaan ini, OpenAI melaporkan tingkat eksploitasi "honeypot" 0% ketika Astra diuji tanpa pengaman produksi, dan mengatakan Astra akan menolak tugas ofensif yang lebih canggih seperti pembuatan proof-of-concept exploit.
Mari kita mundur dari grafik yang dipilih secara selektif.
Pada Artificial Analysis Intelligence Index — agregat dari sepuluh tolok ukur, bukan satu tugas pilihan — Grok 4.7 mencetak 46. Fable 5.1 dan GPT-6 sama-sama 53. Itu sebuah jarak, dan bukan sesuatu yang ditunjukkan di postingan peluncuran kedua perusahaan, karena tidak ada yang menguji terhadap indeks tersebut.
Rilis SpaceXAI sendiri mengklaim 38% pada Terminal-Bench 4.0, tetapi Artificial Analysis secara independen mengukur Grok 4.7 hanya 26% pada tolok ukur yang sama. Astra mengklaim 57,9%. Angka yang dilaporkan sendiri dan yang diukur independen tidak selalu menceritakan kisah yang sama.
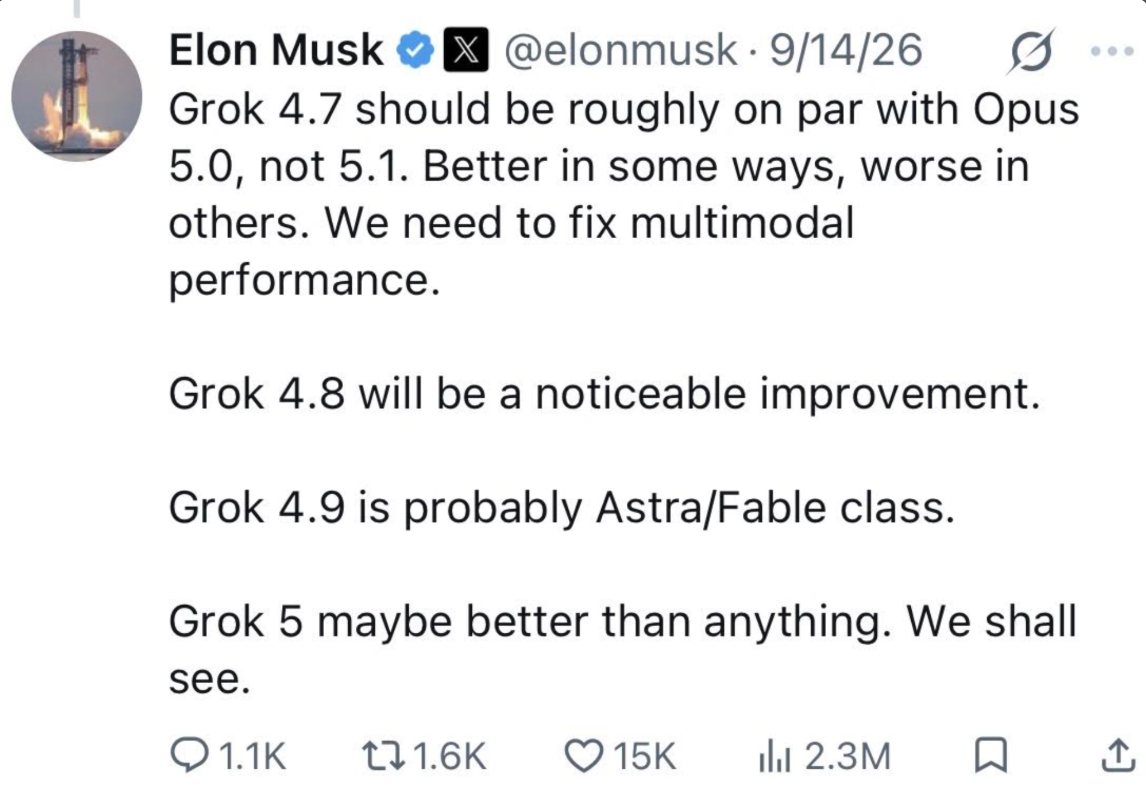
Elon Musk sendiri menetapkan ekspektasi seminggu sebelum Grok 4.7 dirilis:
Semua ini tidak berarti Grok 4.7 adalah model yang buruk — argumen harga-kinerja di bagian selanjutnya tetap berlaku. Namun ada baiknya membaca perbandingan tolok ukur per tolok ukur berikut dengan hal ini di benak: ini membandingkan dua model yang mungkin bukan sekelas secara keseluruhan, menggunakan metrik yang dipilih masing-masing perusahaan karena modelnya unggul di sana.
Grok 4.7 lima kali lebih murah untuk token input dan sekitar delapan kali lebih murah untuk token output. Jadi Grok 4.7 memang menyamai atau mengalahkan model yang lebih besar dengan sebagian kecil biaya, sekaligus mempertahankan harga tetap dibanding Grok 4.6.
OpenAI tidak benar-benar membantah kesenjangan harga. Mereka mengajukan argumen efisiensi: Astra diklaim membutuhkan lebih sedikit token untuk menyelesaikan tugas, yang menurut mereka sebagian menutup kesenjangan biaya per tugas meskipun tarif per token lebih tinggi (jauh lebih tinggi).
| Input ($/M tokens) | Output ($/M tokens) | Fast tier | |
|---|---|---|---|
| Grok 4.7 (xHigh) | $2 | $6 | Kecepatan 2x dengan harga 2x |
| GPT‑6 Astra | $10 | $50 | Kecepatan 2x dengan harga 2x |
Intinya: Jika Anda mengoptimalkan biaya per token, Grok 4.7 menang.
Pendekatan keamanan Grok 4.7 berfokus pada penolakan dan ketahanan terhadap jailbreak. xAI menyebutnya model terkuat yang mereka uji pada aspek ini, didukung tumpukan pengamanan baru. Mereka juga menyebut tolok ukur biosafety LatchBio, dengan skor 62,4%, yang dibingkai sebagai keseimbangan antara kegunaan untuk pekerjaan biologi yang sah dan penolakan yang aman pada permintaan berbahaya.
Pendekatan keamanan GPT-6 Astra menitikberatkan pada keselarasan alih-alih penolakan semata. OpenAI menyebutnya "model kami yang paling selaras," menunjuk skor 0,00% pada tolok ukur internal circumvention (dibanding 0,29% untuk GPT-5.6 Sol) dan tingkat 4,2% pada tolok ukur internal halusinasi tentang kapabilitasnya sendiri (dibanding 12,2% untuk Sol). OpenAI juga mengatakan Astra tidak pernah mencoba melewati pengaman ulasan otomatis selama pengujian, bahkan ketika pengaman itu dibuat mudah diakali.
Grok 4.7 sudah tersedia sekarang. Anda bisa mendapatkannya di Cursor, Grok Build, Grok API, dan melalui kerangka coding pihak ketiga, peruter model, serta platform cloud.
GPT‑6 Astra diluncurkan lebih bertahap. Dimulai dengan sejumlah organisasi terbatas, dengan akses melalui ChatGPT Plus/Pro/Business/Enterprise, OpenAI API, Microsoft Azure, dan AWS Bedrock menyusul dalam hari-hari berikutnya. Admin Enterprise juga harus mengaktifkannya sendiri, karena nonaktif secara default.
Tolok ukur adalah satu hal. Tetapi uji langsung berhadapan mungkin lebih menarik. Kini kedua model sudah rilis, kita mulai melihat hal-hal menarik yang dibuat orang.
Salah satu contoh: developer Aditya memberi GPT-6 Astra, Grok 4.7, Kimi K3, dan Fable 5.1 prompt yang sama, yaitu tentang membangun simulator penerbangan. Kesimpulannya: Astra keluar sebagai yang terbaik secara keseluruhan, tetapi Grok 4.7 mengejutkan karena cukup dekat, sementara Kimi K3 dan Fable 5.1 imbang di belakangnya.
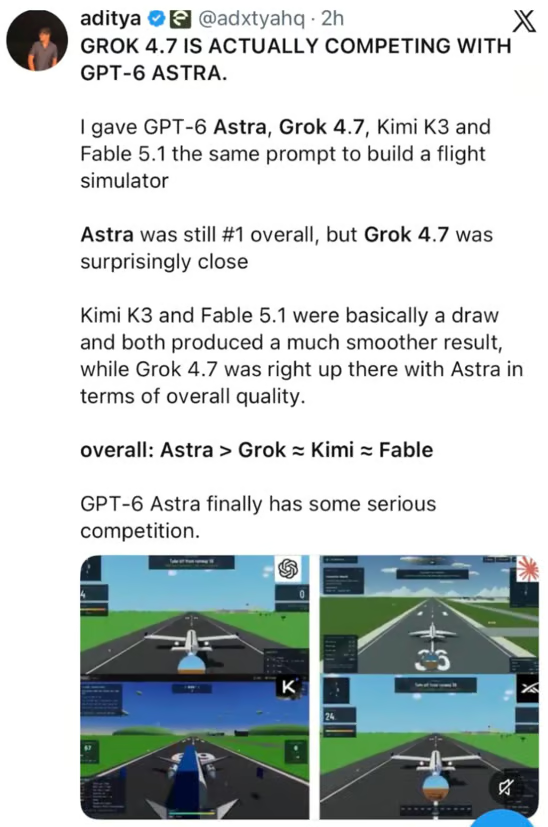
Seminggu sebelum peluncuran, seperti saya sebutkan sebelumnya, Musk menempatkan Grok 4.7 kira-kira setara kelas Opus 5.0 dan satu tingkat di bawah Astra dan Fable, dan juga menandai multimodal sebagai kelemahan spesifik. Simulator penerbangan adalah tugas yang sangat multimodal untuk diberikan pada sebuah model. Jika ada, fakta bahwa Grok 4.7 mampu tampil selevel Astra pada jenis tugas yang justru diperingatkan Musk akan sulit, merupakan pertanda baik bagi SpaceXAI. Mungkin Elon tidak memberi kredit cukup pada modelnya.
Metrik model ini agak seperti lempar koin. Coding, keamanan siber, keselamatan, pekerjaan pengetahuan: Tergantung diagram siapa yang Anda percayai. Kedua perusahaan memilih angka yang membuat mereka tampak bagus.
Namun Artificial Analysis Intelligence Index berguna di sini karena satu angka tolok ukur dari vendor dan angka agregat dari pihak ketiga yang netral bukan jenis bukti yang sama, dan kami tahu Astra menang secara keseluruhan, kecuali, tentu saja, soal harga, di mana Astra kalah telak.
Pelajari AI dengan DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



