GPT-6 Astra se lanzó el 3 de septiembre. Grok 4.7 llegó unas semanas después, el 21 de septiembre, con comparativas frente a Astra incluidas en el propio anuncio de SpaceXAI. Si lees cada post por separado, parece que cada uno gana con claridad. Si los lees en paralelo, se ve mejor lo que ocurre: dos empresas escogieron distintos benchmarks para encabezar sus resultados, y ninguna se midió contra el gráfico favorito de la otra.
Pero los benchmarks de los posts de lanzamiento solo cuentan cómo rinden en las tareas concretas que cada compañía quiso destacar. No te dicen dónde se sitúa un modelo en conjunto. En esa cuestión más amplia, hay motivos para pensar que Grok 4.7 no juega realmente en la misma liga que Astra. Aquí es útil el Artificial Analysis Intelligence Index, porque es de un tercero. Dicho esto, la comparación no es limpia. Grok 4.7 es mucho más barato, y el coste por token lo convierte en un buen modelo.
¿Qué es Grok 4.7?
Grok 4.7 es el modelo más reciente de xAI/SpaceXAI, orientado a programación y trabajo con conocimiento. Lo describen como "el doble de rápido, a la mitad de precio" que modelos comparables, y dicen que se sirve al mismo precio y velocidad que su predecesor, Grok 4.6, una buena manera de generar expectación.
Bajo el capó, Grok 4.7 usa un modelo base más grande que 4.6, entrenado con una fase de refuerzo más larga, una mezcla de tareas más exigente y con más peso en problemas que llevan muchas horas. Además, el modelo comprueba mejor su propio trabajo y gestiona contextos más largos. Por último, conviene saber que se entrenó para entender de forma nativa el arnés de Grok Bot.
¿Qué es GPT-6 Astra?
GPT-6 Astra es el modelo insignia actual de OpenAI. OpenAI lo presenta como "el modelo más inteligente y alineado del mundo". Afirma que Astra logra un 98% en FrontierMath Tier 4, un 99,9% en ARC-AGI-3 y un 100% en ExploitBench. Seguro que en futuros artículos citaremos otros tests porque Astra ha saturado muchos de los más conocidos. Además, Astra ya ha contribuido a problemas abiertos de matemáticas, con dos nuevos resultados sobre las brechas entre números primos.
Aún más, OpenAI posiciona Astra como un gran paso adelante en el uso del ordenador. Maneja tareas como rellenar formularios, actualizar registros de CRM, hacer investigación, crear sitios web y ejecutar QA de frontend. Otros modelos ya hacían todo esto, pero OpenAI dice que Astra es mucho más rápido y preciso. El anuncio también destaca la calidad profesional del output, asegurando que Astra sigue mejor los templates y el estilo editorial de una organización al generar documentos, hojas de cálculo, presentaciones y similares.
Comparativa cara a cara: Grok 4.7 vs. GPT-6 Astra
Grok 4.7 vs. GPT-6 Astra en programación
El lanzamiento de Grok 4.7 sitúa CursorBench 4.0 como su benchmark estrella de código, donde obtiene un 46,3% (ajuste xHigh), por delante de Grok 4.6 (40,4%). También mejora a GPT‑5.6 Sol (41,7%), pero queda por detrás de Claude Fable 5.1 (51,8%).
El post de GPT‑6 Astra menciona en su lugar Terminal-Bench 4.0, donde afirma un 57,9%, superando a GPT‑5.6 Sol (37,3%) y a Claude Fable 5.1 (55,8%).
Curiosamente, el lanzamiento de Grok también reporta un 38,0% en Terminal-Bench 4.0 para Grok 4.7, muy por debajo de la puntuación de Astra.
En DeepSWE v1.1, están cerca, pero Astra va por delante: Astra reporta un 74,1% frente al 71,0% de Grok 4.7 (con alto esfuerzo).
- Conclusión: La batería de benchmarks de Astra para programación es más amplia y dibuja un cuadro general más sólido, pero ambas empresas eligieron distintos benchmarks bandera, lo que dificulta una comparación directa. Es algo que vemos a menudo, seguramente a propósito.
Grok 4.7 vs. GPT-6 Astra en trabajo de conocimiento
Grok 4.7 destaca AA Briefcase v1.1 ("trabajo de oficina de varias horas"), donde logra 1.657, por encima de Grok 4.6 (1.546) y GPT‑5.6 Sol (1.487). Pero sigue por detrás de Claude Fable 5.1, que lidera con 1.678.
Grok también cita una comparación Elo de GDPval donde Fable 5.1 encabeza con 1.735, seguido de Grok 4.7 con 1.695 y Grok 4.6 con 1.605. GPT‑6 Astra queda último en ese gráfico con 1.542, al menos en la presentación de xAI.
Las afirmaciones de GPT‑6 Astra sobre trabajo de conocimiento se apoyan en benchmarks totalmente distintos: AutomationBench (41,4%, por delante de GPT‑5.6 Sol y Fable 5.1) y BenchCAD (95,9%, de nuevo por delante de Sol y Fable 5.1). También cita Agents' Last Exam, donde obtiene un 59,3%, por encima del 55,5% de Opus 5.
- Conclusión: Cada empresa escogió los benchmarks que más la favorecen. Grok se apoya en resistencia de oficina y puntuaciones Elo a largo plazo, mientras que Astra se apoya en finalización de tareas y seguimiento de plantillas. Ningún anuncio enfrenta su modelo al benchmark elegido por la otra y pierde, así que es difícil comparar. Dejémoslo en empate.
Grok 4.7 vs. GPT-6 Astra en ciberseguridad
Aquí es donde los dos anuncios cuentan historias casi opuestas.
xAI dice que Grok 4.7 bloquea el 96,7% de prompts de doble uso arriesgado en HackerBench v0.3, permitiendo a la vez el trabajo legítimo de seguridad. También lidera el benchmark de bioseguridad de LatchBio con un 62,4%. La empresa menciona que ofrece a algunos partners un acceso más restringido y por invitación a capacidades de red teaming menos limitadas, pero el titular es la contención.
OpenAI dice que GPT‑6 Astra supera su propio umbral "Critical" de capacidad cibernética, y reporta un 100% en ExploitBench, frente al 78,5% de GPT‑5.6 Sol. También afirma que Astra encontró dos vulnerabilidades zero-day reales durante las pruebas, que OpenAI asegura haber comunicado a los responsables. A la vez, OpenAI reporta una tasa de explotación "honeypot" del 0% cuando Astra se probó sin salvaguardas de producción, y dice que Astra se negará a realizar tareas ofensivas más avanzadas como crear pruebas de concepto de exploits.
- Conclusión: Grok 4.7 se vende como seguro porque se contiene. GPT‑6 Astra se vende como seguro porque está alineado incluso cuando no se contiene. Conviene notar que "seguro" significa cosas distintas en cada discurso.
Dónde se sitúa realmente Grok 4.7 frente a Astra
Alejémonos de los gráficos seleccionados con pinzas.
En el Artificial Analysis Intelligence Index —un agregado de diez benchmarks, no una tarea elegida a dedo—, Grok 4.7 obtiene 46. Fable 5.1 y GPT-6 marcan 53. Hay una distancia, y no es algo que te enseñe ninguno de los posts de lanzamiento, porque ninguno se mide contra ese índice.
El propio anuncio de SpaceXAI afirma un 38% en Terminal-Bench 4.0, pero Artificial Analysis midió de forma independiente a Grok 4.7 en solo un 26% en el mismo benchmark. Astra afirma un 57,9%. Las cifras auto-reportadas y las medidas de forma independiente no siempre cuentan la misma historia.
El propio Elon Musk fijó expectativas una semana antes del lanzamiento de Grok 4.7:
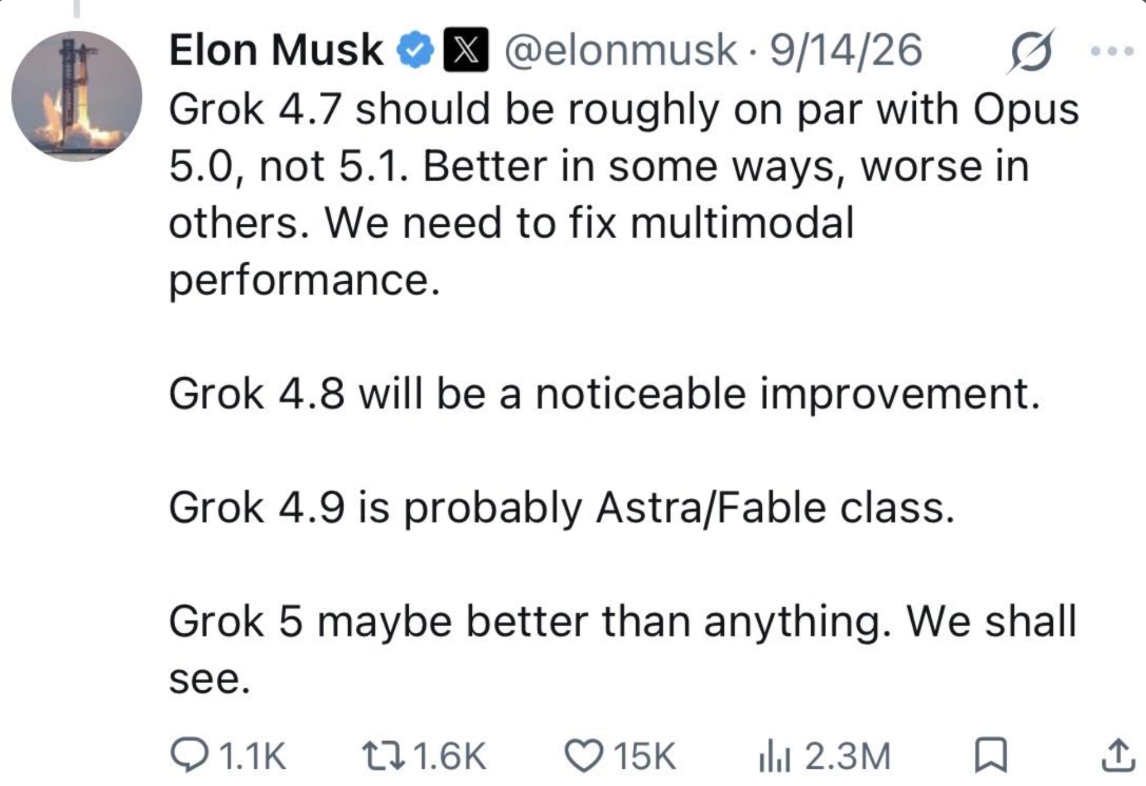
Nada de esto significa que Grok 4.7 sea un mal modelo —el argumento de relación calidad-precio que verás más abajo sigue en pie—. Pero conviene leer las comparativas benchmark a benchmark que siguen con esto en mente: están comparando dos modelos que quizá no sean pares en conjunto, usando métricas que cada empresa eligió porque su modelo sale bien parado.
Grok 4.7 vs. GPT-6 Astra en precio
Grok 4.7 es 5 veces más barato en tokens de entrada y aproximadamente 8 veces más barato en tokens de salida. Así que Grok 4.7 iguala o supera a modelos mayores a una fracción del coste, manteniendo además el precio respecto a Grok 4.6.
OpenAI no discute realmente la brecha de precio. Alega eficiencia: supuestamente Astra necesita menos tokens para completar una tarea, lo que, dice, cierra en parte la brecha en coste por tarea aunque la tarifa por token sea mayor (mucho mayor).
| | Entrada ($/M tokens) | Salida ($/M tokens) | Nivel rápido |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2x velocidad a 2x precio |
| GPT‑6 Astra | $10 | $50 | 2x velocidad a 2x precio |
Conclusión: si optimizas por coste por token, gana Grok 4.7.
Grok 4.7 vs. GPT-6 Astra en seguridad
El discurso de seguridad de Grok 4.7 se centra en negativas y resistencia a jailbreaks. xAI lo califica como el modelo más sólido que han probado en estos frentes, respaldado por una nueva pila de salvaguardas. También cita el benchmark de bioseguridad de LatchBio, donde obtiene un 62,4%, presentado como equilibrio entre utilidad para trabajos biológicos legítimos y negativa segura ante peticiones peligrosas.
La propuesta de seguridad de GPT-6 Astra gira más en torno a la alineación que a las negativas en sí. OpenAI lo llama "nuestro modelo más alineado", señalando un 0,00% en un benchmark interno de elusión (frente al 0,29% de GPT-5.6 Sol) y una tasa del 4,2% en un benchmark interno de alucinaciones sobre sus propias capacidades (frente al 12,2% de Sol). También afirma que Astra nunca intentó sortear una salvaguarda de revisión automática en pruebas, incluso cuando era fácil de evadir.
- Conclusión: Grok 4.7 se centra en frenar las peticiones peligrosas desde el principio. GPT-6 Astra se centra en poder confiar en su criterio una vez que ya actúa de forma autónoma.
Grok 4.7 vs. GPT-6 Astra en disponibilidad
Grok 4.7 ya está disponible. Puedes usarlo en Cursor, Grok Build, la API de Grok y a través de arneses de programación de terceros, routers de modelos y plataformas cloud.
GPT‑6 Astra va llegando más despacio. Empezó con un conjunto limitado de organizaciones y, después, acceso en ChatGPT Plus/Pro/Business/Enterprise, la API de OpenAI, Microsoft Azure y AWS Bedrock en los días siguientes. Además, en Enterprise los administradores deben activarlo manualmente, ya que viene desactivado por defecto.
- Conclusión: Grok 4.7 se lanzó de forma amplia, Astra de forma escalonada. Pero Astra salió hace unas semanas, así que ambos están muy disponibles ya.
Qué están viendo los primeros testers
Los benchmarks son una cosa. Las pruebas cara a cara quizá sean más interesantes. Ahora que ambos modelos están fuera, empezamos a ver cosas chulas que la gente está construyendo.
Un ejemplo: el desarrollador Aditya dio el mismo prompt a GPT-6 Astra, Grok 4.7, Kimi K3 y Fable 5.1, sobre construir un simulador de vuelo. Su veredicto: Astra quedó primero en general, pero Grok 4.7 estuvo sorprendentemente cerca, mientras que Kimi K3 y Fable 5.1 empataron por detrás.
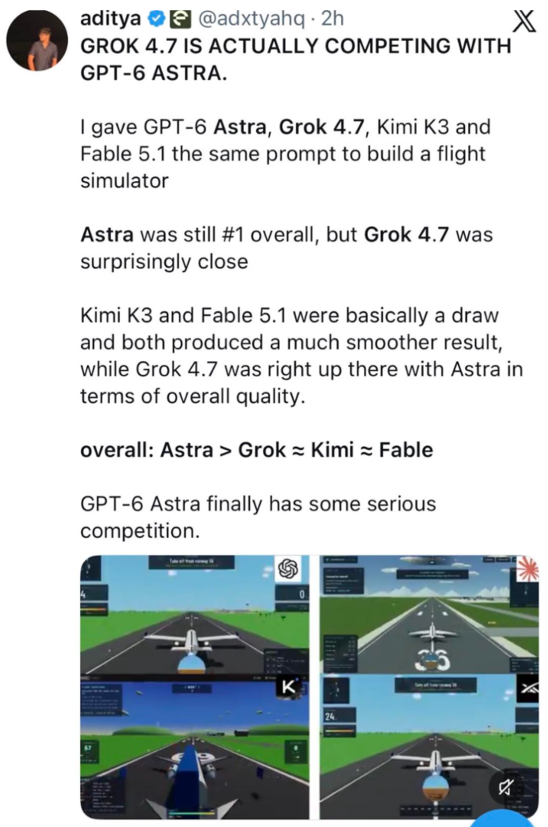
Una semana antes del lanzamiento, como decía, Musk situó a Grok 4.7 aproximadamente en la clase de Opus 5.0 y un peldaño por debajo de Astra y Fable, y también señaló lo multimodal como una debilidad concreta. Un simulador de vuelo es de lo más multimodal que puedes pedirle a un modelo. Si acaso, que Grok 4.7 compita con Astra justo en el tipo de tarea donde Musk avisó de que sufriría es una buena señal para SpaceXAI. Quizá Elon no le dio al modelo todo el crédito que merecía.
Conclusión
Las métricas del modelo son un poco cara o cruz. Programación, ciberseguridad, seguridad, trabajo de conocimiento: depende de en qué gráfico confíes. Ambas empresas escogieron los números que mejor las dejan.
Pero el Artificial Analysis Intelligence Index es útil aquí porque un número de benchmark de un proveedor y un número agregado de un tercero neutral no son la misma clase de evidencia, y sabemos que Astra gana en conjunto, salvo, claro, en precio, donde pierde con claridad.


GPT-6 Astra se lanzó el 3 de septiembre. Grok 4.7 llegó unas semanas después, el 21 de septiembre, con comparativas frente a Astra incluidas en el propio anuncio de SpaceXAI. Si lees cada post por separado, parece que cada uno gana con claridad. Si los lees en paralelo, se ve mejor lo que ocurre: dos empresas escogieron distintos benchmarks para encabezar sus resultados, y ninguna se midió contra el gráfico favorito de la otra.
Pero los benchmarks de los posts de lanzamiento solo cuentan cómo rinden en las tareas concretas que cada compañía quiso destacar. No te dicen dónde se sitúa un modelo en conjunto. En esa cuestión más amplia, hay motivos para pensar que Grok 4.7 no juega realmente en la misma liga que Astra. Aquí es útil el Artificial Analysis Intelligence Index, porque es de un tercero. Dicho esto, la comparación no es limpia. Grok 4.7 es mucho más barato, y el coste por token lo convierte en un buen modelo.
¿Qué es Grok 4.7?
Grok 4.7 es el modelo más reciente de xAI/SpaceXAI, orientado a programación y trabajo con conocimiento. Lo describen como "el doble de rápido, a la mitad de precio" que modelos comparables, y dicen que se sirve al mismo precio y velocidad que su predecesor, Grok 4.6, una buena manera de generar expectación.
Bajo el capó, Grok 4.7 usa un modelo base más grande que 4.6, entrenado con una fase de refuerzo más larga, una mezcla de tareas más exigente y con más peso en problemas que llevan muchas horas. Además, el modelo comprueba mejor su propio trabajo y gestiona contextos más largos. Por último, conviene saber que se entrenó para entender de forma nativa el arnés de Grok Bot.
¿Qué es GPT-6 Astra?
GPT-6 Astra es el modelo insignia actual de OpenAI. OpenAI lo presenta como "el modelo más inteligente y alineado del mundo". Afirma que Astra logra un 98% en FrontierMath Tier 4, un 99,9% en ARC-AGI-3 y un 100% en ExploitBench. Seguro que en futuros artículos citaremos otros tests porque Astra ha saturado muchos de los más conocidos. Además, Astra ya ha contribuido a problemas abiertos de matemáticas, con dos nuevos resultados sobre las brechas entre números primos.
Aún más, OpenAI posiciona Astra como un gran paso adelante en el uso del ordenador. Maneja tareas como rellenar formularios, actualizar registros de CRM, hacer investigación, crear sitios web y ejecutar QA de frontend. Otros modelos ya hacían todo esto, pero OpenAI dice que Astra es mucho más rápido y preciso. El anuncio también destaca la calidad profesional del output, asegurando que Astra sigue mejor los templates y el estilo editorial de una organización al generar documentos, hojas de cálculo, presentaciones y similares.
Comparativa cara a cara: Grok 4.7 vs. GPT-6 Astra
Grok 4.7 vs. GPT-6 Astra en programación
El lanzamiento de Grok 4.7 sitúa CursorBench 4.0 como su benchmark estrella de código, donde obtiene un 46,3% (ajuste xHigh), por delante de Grok 4.6 (40,4%). También mejora a GPT‑5.6 Sol (41,7%), pero queda por detrás de Claude Fable 5.1 (51,8%).
El post de GPT‑6 Astra menciona en su lugar Terminal-Bench 4.0, donde afirma un 57,9%, superando a GPT‑5.6 Sol (37,3%) y a Claude Fable 5.1 (55,8%).
Curiosamente, el lanzamiento de Grok también reporta un 38,0% en Terminal-Bench 4.0 para Grok 4.7, muy por debajo de la puntuación de Astra.
En DeepSWE v1.1, están cerca, pero Astra va por delante: Astra reporta un 74,1% frente al 71,0% de Grok 4.7 (con alto esfuerzo).
Grok 4.7 vs. GPT-6 Astra en trabajo de conocimiento
Grok 4.7 destaca AA Briefcase v1.1 ("trabajo de oficina de varias horas"), donde logra 1.657, por encima de Grok 4.6 (1.546) y GPT‑5.6 Sol (1.487). Pero sigue por detrás de Claude Fable 5.1, que lidera con 1.678.
Grok también cita una comparación Elo de GDPval donde Fable 5.1 encabeza con 1.735, seguido de Grok 4.7 con 1.695 y Grok 4.6 con 1.605. GPT‑6 Astra queda último en ese gráfico con 1.542, al menos en la presentación de xAI.
Las afirmaciones de GPT‑6 Astra sobre trabajo de conocimiento se apoyan en benchmarks totalmente distintos: AutomationBench (41,4%, por delante de GPT‑5.6 Sol y Fable 5.1) y BenchCAD (95,9%, de nuevo por delante de Sol y Fable 5.1). También cita Agents' Last Exam, donde obtiene un 59,3%, por encima del 55,5% de Opus 5.
Grok 4.7 vs. GPT-6 Astra en ciberseguridad
Aquí es donde los dos anuncios cuentan historias casi opuestas.
xAI dice que Grok 4.7 bloquea el 96,7% de prompts de doble uso arriesgado en HackerBench v0.3, permitiendo a la vez el trabajo legítimo de seguridad. También lidera el benchmark de bioseguridad de LatchBio con un 62,4%. La empresa menciona que ofrece a algunos partners un acceso más restringido y por invitación a capacidades de red teaming menos limitadas, pero el titular es la contención.
OpenAI dice que GPT‑6 Astra supera su propio umbral "Critical" de capacidad cibernética, y reporta un 100% en ExploitBench, frente al 78,5% de GPT‑5.6 Sol. También afirma que Astra encontró dos vulnerabilidades zero-day reales durante las pruebas, que OpenAI asegura haber comunicado a los responsables. A la vez, OpenAI reporta una tasa de explotación "honeypot" del 0% cuando Astra se probó sin salvaguardas de producción, y dice que Astra se negará a realizar tareas ofensivas más avanzadas como crear pruebas de concepto de exploits.
Dónde se sitúa realmente Grok 4.7 frente a Astra
Alejémonos de los gráficos seleccionados con pinzas.
En el Artificial Analysis Intelligence Index —un agregado de diez benchmarks, no una tarea elegida a dedo—, Grok 4.7 obtiene 46. Fable 5.1 y GPT-6 marcan 53. Hay una distancia, y no es algo que te enseñe ninguno de los posts de lanzamiento, porque ninguno se mide contra ese índice.
El propio anuncio de SpaceXAI afirma un 38% en Terminal-Bench 4.0, pero Artificial Analysis midió de forma independiente a Grok 4.7 en solo un 26% en el mismo benchmark. Astra afirma un 57,9%. Las cifras auto-reportadas y las medidas de forma independiente no siempre cuentan la misma historia.
El propio Elon Musk fijó expectativas una semana antes del lanzamiento de Grok 4.7:
Nada de esto significa que Grok 4.7 sea un mal modelo —el argumento de relación calidad-precio que verás más abajo sigue en pie—. Pero conviene leer las comparativas benchmark a benchmark que siguen con esto en mente: están comparando dos modelos que quizá no sean pares en conjunto, usando métricas que cada empresa eligió porque su modelo sale bien parado.
Grok 4.7 vs. GPT-6 Astra en precio
Grok 4.7 es 5 veces más barato en tokens de entrada y aproximadamente 8 veces más barato en tokens de salida. Así que Grok 4.7 iguala o supera a modelos mayores a una fracción del coste, manteniendo además el precio respecto a Grok 4.6.
OpenAI no discute realmente la brecha de precio. Alega eficiencia: supuestamente Astra necesita menos tokens para completar una tarea, lo que, dice, cierra en parte la brecha en coste por tarea aunque la tarifa por token sea mayor (mucho mayor).
Conclusión: si optimizas por coste por token, gana Grok 4.7.
Grok 4.7 vs. GPT-6 Astra en seguridad
El discurso de seguridad de Grok 4.7 se centra en negativas y resistencia a jailbreaks. xAI lo califica como el modelo más sólido que han probado en estos frentes, respaldado por una nueva pila de salvaguardas. También cita el benchmark de bioseguridad de LatchBio, donde obtiene un 62,4%, presentado como equilibrio entre utilidad para trabajos biológicos legítimos y negativa segura ante peticiones peligrosas.
La propuesta de seguridad de GPT-6 Astra gira más en torno a la alineación que a las negativas en sí. OpenAI lo llama "nuestro modelo más alineado", señalando un 0,00% en un benchmark interno de elusión (frente al 0,29% de GPT-5.6 Sol) y una tasa del 4,2% en un benchmark interno de alucinaciones sobre sus propias capacidades (frente al 12,2% de Sol). También afirma que Astra nunca intentó sortear una salvaguarda de revisión automática en pruebas, incluso cuando era fácil de evadir.
Grok 4.7 vs. GPT-6 Astra en disponibilidad
Grok 4.7 ya está disponible. Puedes usarlo en Cursor, Grok Build, la API de Grok y a través de arneses de programación de terceros, routers de modelos y plataformas cloud.
GPT‑6 Astra va llegando más despacio. Empezó con un conjunto limitado de organizaciones y, después, acceso en ChatGPT Plus/Pro/Business/Enterprise, la API de OpenAI, Microsoft Azure y AWS Bedrock en los días siguientes. Además, en Enterprise los administradores deben activarlo manualmente, ya que viene desactivado por defecto.
Qué están viendo los primeros testers
Los benchmarks son una cosa. Las pruebas cara a cara quizá sean más interesantes. Ahora que ambos modelos están fuera, empezamos a ver cosas chulas que la gente está construyendo.
Un ejemplo: el desarrollador Aditya dio el mismo prompt a GPT-6 Astra, Grok 4.7, Kimi K3 y Fable 5.1, sobre construir un simulador de vuelo. Su veredicto: Astra quedó primero en general, pero Grok 4.7 estuvo sorprendentemente cerca, mientras que Kimi K3 y Fable 5.1 empataron por detrás.
Una semana antes del lanzamiento, como decía, Musk situó a Grok 4.7 aproximadamente en la clase de Opus 5.0 y un peldaño por debajo de Astra y Fable, y también señaló lo multimodal como una debilidad concreta. Un simulador de vuelo es de lo más multimodal que puedes pedirle a un modelo. Si acaso, que Grok 4.7 compita con Astra justo en el tipo de tarea donde Musk avisó de que sufriría es una buena señal para SpaceXAI. Quizá Elon no le dio al modelo todo el crédito que merecía.
Conclusión
Las métricas del modelo son un poco cara o cruz. Programación, ciberseguridad, seguridad, trabajo de conocimiento: depende de en qué gráfico confíes. Ambas empresas escogieron los números que mejor las dejan.
Pero el Artificial Analysis Intelligence Index es útil aquí porque un número de benchmark de un proveedor y un número agregado de un tercero neutral no son la misma clase de evidencia, y sabemos que Astra gana en conjunto, salvo, claro, en precio, donde pierde con claridad.