GPT-6 Astra का लॉन्च 3 सितंबर को हुआ। कुछ हफ्तों बाद, 21 सितंबर को Grok 4.7 आया, जिसमें SpaceXAI ने जारी करते समय ही Astra के मुकाबले अपनी तुलना शामिल कर दी। अगर आप दोनों पोस्ट एक-एक कर पढ़ें तो हर एक साफ विजेता लगेगा। उन्हें साथ-साथ पढ़ें, तो ज़्यादा साफ दिखता है कि असल में हुआ क्या: दो कंपनियों ने अलग-अलग बेंचमार्क्स को सुर्खियों में रखा, और किसी ने भी खुद को दूसरी कंपनी के पसंदीदा चार्ट से नहीं आंका।
लेकिन लॉन्च-पोस्ट के बेंचमार्क्स सिर्फ उन्हीं खास कामों के बारे में बताते हैं जिन्हें दिखाने के लिए चुना गया। वे यह नहीं बताते कि कोई मॉडल कुल मिलाकर कहां खड़ा है। उस बड़े सवाल पर सोचें, तो वजह है मानने की कि Grok 4.7 असल में Astra के ही स्तर पर नहीं खेल रहा। यहीं Artificial Analysis Intelligence Index काम आता है, क्योंकि वह थर्ड-पार्टी है। फिर भी, तुलना साफ नहीं है। Grok 4.7 काफी सस्ता है, और प्रति टोकन लागत इसे अच्छा मॉडल बनाती है।
Grok 4.7 क्या है?
Grok 4.7 xAI/SpaceXAI का नया मॉडल है, जिसे कोडिंग और नॉलेज वर्क के लिए पोज़िशन किया गया है। रिलीज़ में इसे "दोगुनी रफ्तार, आधी कीमत" पर तुलनीय मॉडलों से बेहतर बताया गया है, और कहा गया है कि इसे अपने पूर्ववर्ती Grok 4.6 के समान कीमत और स्पीड पर सर्व किया जा रहा है, जो चर्चा बनाने का बढ़िया तरीका है।
अंदर से, Grok 4.7 में 4.6 से बड़ा बेस मॉडल है, जिसे कठिन टास्क-मिश्रण पर लंबी रिइनफोर्समेंट लर्निंग रन से प्रशिक्षित किया गया है और ऐसे समस्याओं पर वेट किया गया है जिन्हें पूरा करने में कई घंटे लगते हैं। साथ ही, मॉडल अपने काम की खुद जांच करने और लंबा कॉन्टेक्स्ट संभालने में बेहतर है। अंत में, हमें पता होना चाहिए कि इसे Grok Bot हार्नेस को नैटिव रूप से समझने के लिए प्रशिक्षित किया गया था।
GPT-6 Astra क्या है?
GPT-6 Astra OpenAI का मौजूदा फ्लैगशिप मॉडल है। OpenAI इसे "दुनिया का सबसे बुद्धिमान और सबसे अधिक एलाइन किया हुआ मॉडल" कहता है। OpenAI का कहना है कि Astra FrontierMath Tier 4 पर 98%, ARC-AGI-3 पर 99.9%, और ExploitBench पर 100% स्कोर करता है। हमें यकीन है कि भविष्य के लेखों में हम अन्य बेंचमार्क टेस्टों का भी हवाला देंगे क्योंकि Astra ने कई प्रसिद्ध बेंचमार्क्स पर संतृप्ति बना ली है। इसके अलावा, Astra ने गणित में खुले समस्याओं पर भी मदद की है, जिनमें अभाज्य संख्याओं के बीच गैप पर दो नए परिणाम शामिल हैं।
और आगे, OpenAI Astra को कंप्यूटर उपयोग में बड़ा कदम बताता है। यह फॉर्म भरने, CRM रिकॉर्ड अपडेट करने, रिसर्च करने, वेबसाइट बनाने और फ्रंटएंड QA चलाने जैसे काम संभालता है। अन्य मॉडल यह सब पहले से कर रहे थे, लेकिन OpenAI कहता है कि Astra इससे कहीं तेज़ और सटीक है। रिलीज़ में प्रोफेशनल आउटपुट क्वालिटी पर भी ज़ोर है, यह कहते हुए कि डॉक्यूमेंट्स, स्प्रेडशीट्स, स्लाइड डेक्स आदि बनाते समय Astra मौजूदा टेम्प्लेट्स और हाउस स्टाइल का बेहतर पालन करता है।
Grok 4.7 बनाम GPT-6 Astra: आमने-सामने तुलना
कोडिंग पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 की रिलीज़ CursorBench 4.0 को उसके सिग्नेचर कोडिंग बेंчमार्क के रूप में केंद्र में रखती है, जहां यह 46.3% (xHigh सेटिंग) स्कोर करता है, जो Grok 4.6 (40.4%) से आगे है। यह GPT‑5.6 Sol (41.7%) से भी आगे है, लेकिन Claude Fable 5.1 (51.8%) से पीछे है।
GPT‑6 Astra की पोस्ट इसके बजाय Terminal-Bench 4.0 का ज़िक्र करती है, जहां यह 57.9% का दावा करता है, जो GPT‑5.6 Sol (37.3%) और Claude Fable 5.1 (55.8%) को पछाड़ता है।
दिलचस्प है कि Grok की रिलीज़ Grok 4.7 के लिए Terminal-Bench 4.0 पर 38.0% भी बताती है, जो Astra के स्कोर से काफी कम है।
DeepSWE v1.1 पर, दोनों क़रीब हैं, लेकिन Astra आगे है: Astra 74.1% रिपोर्ट करता है, जबकि Grok 4.7 71.0% (हाई एफर्ट पर) बताता है।
- निष्कर्ष: Astra का कोडिंग बेंचमार्क सूट व्यापक है और कुल मिलाकर मजबूत तस्वीर दिखाता है, लेकिन दोनों कंपनियों ने अलग-अलग फ्लैगशिप बेंचमार्क चुने, जिससे सच्ची तुलना निकालना मुश्किल हो जाता है। हम देखते हैं कि कंपनियां यह शायद जानबूझकर करती हैं।
नॉलेज वर्क पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 AA Briefcase v1.1 ("कई घंटे का ऑफिस वर्क") को हाईलाइट करता है, जहां यह 1,657 स्कोर करता है, जो Grok 4.6 (1,546) और GPT‑5.6 Sol (1,487) से आगे है। लेकिन यह अब भी Claude Fable 5.1 से पीछे है, जो 1,678 पर चार्ट में सबसे ऊपर है।
Grok GDPval Elo तुलना का भी हवाला देता है जहां Fable 5.1 1,735 पर आगे है, उसके बाद Grok 4.7 1,695 पर, फिर Grok 4.6 1,605 पर। GPT‑6 Astra इस चार्ट में आखिरी आता है 1,542 पर, कम से कम xAI की अपनी प्रस्तुति में।
GPT‑6 Astra के नॉलेज-वर्क दावे पूरी तरह अलग बेंचमार्क्स पर टिके हैं: AutomationBench (41.4%, जो GPT‑5.6 Sol और Fable 5.1 से आगे है) और BenchCAD (95.9%, जो फिर से Sol और Fable 5.1 से आगे है)। यह Agents' Last Exam का भी हवाला देता है, जहां यह 59.3% स्कोर करता है, Opus 5 के 55.5% से आगे।
- निष्कर्ष: हर कंपनी ने वही बेंचमार्क चुने जो उसे सबसे ज़्यादा सूट करें। Grok ऑफिस-वर्क सहनशक्ति और लंबी-अवधि Elo स्कोर पर झुकता है, जबकि Astra टास्क-पूर्ति और टेम्प्लेट-फॉलोइंग बेंचमार्क्स पर। किसी रिलीज़ ने अपने मॉडल को दूसरी के चुने बेंचमार्क पर रखकर हारते हुए नहीं दिखाया, और तुलना मुश्किल है। इसे बराबरी मानें।
साइबरसुरक्षा पर Grok 4.7 बनाम GPT-6 Astra
यहीं दोनों रिलीज़ लगभग उल्टी कहानियां सुनाती हैं।
xAI कहता है कि Grok 4.7 HackerBench v0.3 पर जोखिमभरे ड्यूल-यूज़ प्रॉम्प्ट्स में से 96.7% को ब्लॉक करता है, जबकि वैध सुरक्षा कार्यों को आगे जाने देता है। यह LatchBio के बायोसेफ्टी बेंचमार्क पर भी 62.4% के साथ सबसे ऊपर है। कंपनी बताती है कि चुने हुए पार्टनर्स को संकुचित, निमंत्रण-आधारित, कम-प्रतिबंधित रेड-टीम क्षमताओं की पहुंच दी गई, लेकिन हेडलाइन फ़्रेमिंग संयम की है।
OpenAI कहता है कि GPT‑6 Astra उसकी अपनी साइबर क्षमता की "Critical" थ्रेशहोल्ड पार कर चुका है, और ExploitBench पर 100% स्कोर रिपोर्ट करता है, जबकि GPT‑5.6 Sol 78.5% पर था। यह भी कहता है कि टेस्टिंग के दौरान Astra ने दो असली ज़ीरो-डे कमजोरियां खोजीं, जिन्हें OpenAI के अनुसार मेंटेनर्स को बताया गया। इसके साथ, OpenAI एक 0% "हनीपॉट" एक्सप्लॉइट दर रिपोर्ट करता है जब Astra को प्रोडक्शन सेफगार्ड्स के बिना परखा गया, और कहता है कि Astra अधिक उन्नत आक्रामक कार्य, जैसे प्रूफ-ऑफ-कॉन्सेप्ट एक्सप्लॉइट बनाना, करने से मना करेगा।
- निष्कर्ष: Grok 4.7 को सुरक्षित इसलिए बेचा जा रहा है कि वह खुद को रोकता है। GPT‑6 Astra को सुरक्षित इसलिए बेचा जा रहा है कि वह बिना रोके भी एलाइन रहता है। गौर करने की बात है कि दोनों में "सुरक्षित" का मतलब अलग है।
Astra की तुलना में Grok 4.7 असल में कहां बैठता है
आइए चेरी-पिक्ड चार्ट्स से पीछे हटें।
Artificial Analysis Intelligence Index पर — जो दस बेंचमार्क्स का सम agregate है, न कि एक मनचाहा टास्क — Grok 4.7 को 46 स्कोर मिलता है। Fable 5.1 और GPT-6 दोनों 53 स्कोर करते हैं। यह गैप है, और यह वह बात नहीं है जो किसी भी कंपनी की लॉन्च पोस्ट आपको दिखाती है, क्योंकि किसी ने भी इस इंडेक्स पर बेंचमार्क नहीं किया।
SpaceXAI की अपनी रिलीज़ Terminal-Bench 4.0 पर 38% का दावा करती है, लेकिन Artificial Analysis ने उसी बेंचमार्क पर Grok 4.7 को स्वतंत्र रूप से सिर्फ 26% मापा। Astra ने 57.9% का दावा किया। स्वयं-रिपोर्टेड और स्वतंत्र रूप से मापी गई संख्याएं हमेशा एक जैसी कहानी नहीं बतातीं।
Elon Musk ने खुद Grok 4.7 के लॉन्च से एक हफ्ता पहले उम्मीदें सेट कीं:
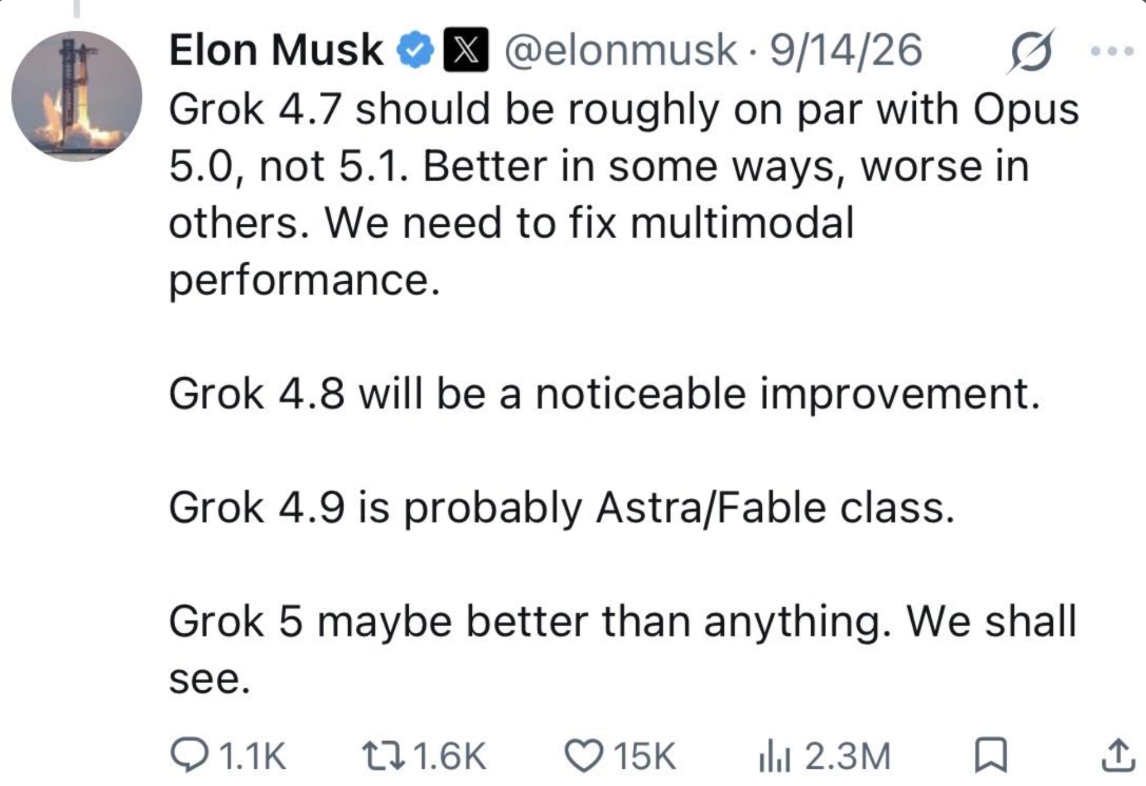
इस सबका मतलब यह नहीं कि Grok 4.7 खराब मॉडल है — इस लेख में आगे आने वाला प्राइस-परफॉर्मेंस केस अब भी मजबूत है। लेकिन आगे आने वाली बेंचमार्क-दर-बेंचमार्क तुलना पढ़ते समय यह ध्यान रखें: ये उन दो मॉडलों की तुलना है जो कुल मिलाकर शायद समकक्ष नहीं हैं, और मीट्रिक्स वही चुने गए हैं जिन पर हर कंपनी का मॉडल अच्छा करता है।
कीमत पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 इनपुट टोकन पर 5 गुना सस्ता है और आउटपुट टोकन पर लगभग 8 गुना सस्ता। इसलिए Grok 4.7 कम लागत में बड़े मॉडलों की बराबरी या बढ़त ले आता है, और साथ ही Grok 4.6 के मुकाबले कीमतें सपाट रखता है।
OpenAI कीमत के अंतर से वाकई में बहस नहीं करता। वह दक्षता की दलील देता है: कथित तौर पर Astra को कोई काम खत्म करने के लिए कम टोकन चाहिए होते हैं, जो प्रति-टास्क लागत पर अंतर को आंशिक रूप से कम कर देता है, भले ही प्रति-टोकन रेट अधिक (काफी अधिक) हो।
| | इनपुट ($/M tokens) | आउटपुट ($/M tokens) | फास्ट टियर |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2x स्पीड 2x कीमत पर |
| GPT‑6 Astra | $10 | $50 | 2x स्पीड 2x कीमत पर |
निष्कर्ष: अगर आप प्रति-टोकन लागत के लिए ऑप्टिमाइज़ कर रहे हैं, तो Grok 4.7 विजेता है।
सुरक्षा पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 की सुरक्षा पेशकश इंकार करने और जेलब्रेक-प्रतिरोध पर केंद्रित है। xAI इसे इन मोर्चों पर उनके द्वारा परखा गया सबसे मजबूत मॉडल कहता है, जिसे नए सेफगार्ड स्टैक का सहारा प्राप्त है। यह LatchBio के बायोसेफ्टी बेंचमार्क का भी हवाला देता है, जहां यह 62.4% स्कोर करता है, जिसे वैध जैविक कार्यों में उपयोगिता और खतरनाक अनुरोधों पर सुरक्षित इंकार के बीच संतुलन के रूप में पेश किया गया है।
GPT-6 Astra की सुरक्षा पेशकश सिर्फ इंकार की बजाय एलाइनमेंट पर है। OpenAI इसे "हमारा सबसे अधिक एलाइन किया हुआ मॉडल" कहता है, एक आंतरिक सर्कमवेंशन बेंचमार्क पर 0.00% स्कोर की ओर इशारा करते हुए (GPT-5.6 Sol के 0.29% के मुकाबले) और अपनी ही क्षमताओं पर एक आंतरिक हेलुसिनेशन बेंचमार्क पर 4.2% दर (Sol के 12.2% के मुकाबले)। यह भी कहता है कि टेस्टिंग में Astra ने कभी ऑटो-रिव्यू सेफगार्ड को बायपास करने की कोशिश नहीं की, भले ही उस सेफगार्ड को आसानी से छलने लायक बना दिया गया हो।
- निष्कर्ष: Grok 4.7 शुरुआत में ही गलत अनुरोधों को रोकने पर फोकस करता है। GPT-6 Astra उस पर फोकस करता है कि एक बार स्वायत्त रूप से काम करते समय उसके निर्णय पर भरोसा किया जा सके।
उपलब्धता पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 अभी उपलब्ध है। आप इसे Cursor, Grok Build, Grok API, और थर्ड-पार्टी कोडिंग हार्नेस, मॉडल राउटर्स और क्लाउड प्लेटफ़ॉर्म्स के जरिए पा सकते हैं।
GPT‑6 Astra धीरे-धीरे रोलआउट हो रहा है। यह चुनिंदा संगठनों से शुरू हुआ, इसके बाद ChatGPT Plus/Pro/Business/Enterprise एक्सेस, OpenAI API, Microsoft Azure, और AWS Bedrock अगले दिनों में आए। एंटरप्राइज़ एडमिन्स को भी इसे खुद ऑन करना पड़ता है, क्योंकि यह डिफ़ॉल्ट रूप से ऑफ़ रहता है।
- निष्कर्ष: Grok 4.7 का लॉन्च वाइड था, Astra का स्टेज्ड। लेकिन Astra कुछ हफ्ते पहले लॉन्च हो चुका, इसलिए अब दोनों व्यापक रूप से उपलब्ध हैं।
शुरुआती टेस्टर्स क्या देख रहे हैं
बेंचमार्क्स एक बात हैं। लेकिन आमने-सामने टेस्ट शायद ज़्यादा दिलचस्प होते हैं। अब जब दोनों मॉडल बाहर हैं, हम देख रहे हैं कि लोग क्या-क्या बढ़िया चीज़ें बना रहे हैं।
एक उदाहरण: डेवलपर आदित्य ने GPT-6 Astra, Grok 4.7, Kimi K3, और Fable 5.1 को एक ही प्रॉम्प्ट दिया, जो फ्लाइट सिमुलेटर बनाने के बारे में था। उनका फ़ैसला: कुल मिलाकर Astra सबसे ऊपर आया, लेकिन Grok 4.7 चौंकाने वाली तरह से क़रीब था, जबकि Kimi K3 और Fable 5.1 उसके पीछे टाई पर रहे।
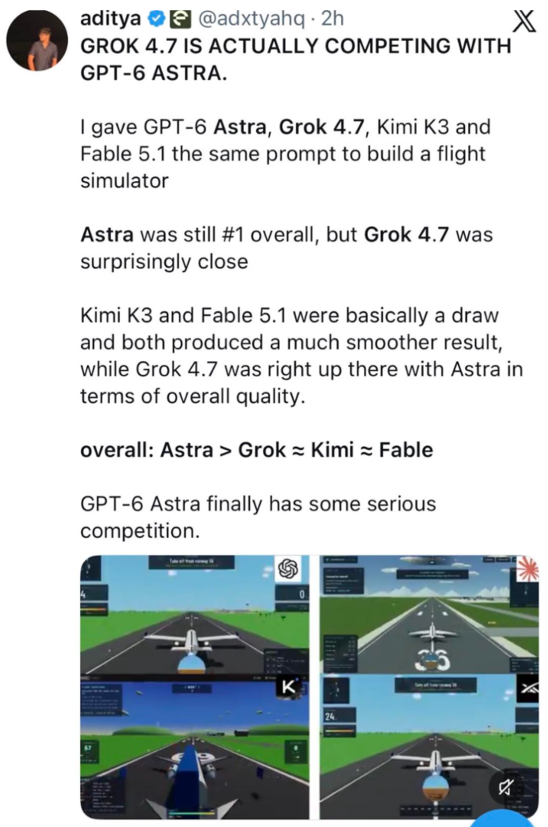
लॉन्च से एक हफ्ता पहले, जैसा मैंने पहले बताया, Musk ने Grok 4.7 को मोटे तौर पर Opus 5.0-क्लास और Astra व Fable से एक स्तर नीचे आंका था, और मल्टीमॉडल को एक खास कमजोरी बताया था। फ्लाइट सिमुलेटर किसी मॉडल को दी जा सकने वाली जितनी मल्टीमॉडल टास्क हो सकती है, उतनी है। अगर कुछ है, तो ठीक उसी तरह के टास्क पर, जिसके बारे में Musk ने संघर्ष की चेतावनी दी थी, Grok 4.7 का Astra के साथ दिखना SpaceXAI के लिए अच्छा संकेत है। शायद Elon ने मॉडल को कम आंका।
निष्कर्ष
मॉडल मेट्रिक्स कुछ-कुछ सिक्का उछाल जैसे हैं। कोडिंग, साइबरसुरक्षा, सुरक्षा, नॉलेज वर्क: यह इस पर निर्भर है कि आप किसके चार्ट पर भरोसा करते हैं। दोनों कंपनियों ने वही संख्याएं चुनीं जो उन्हें अच्छी दिखाएं।
लेकिन Artificial Analysis Intelligence Index यहां उपयोगी है क्योंकि किसी विक्रेता का एक अकेला बेंचमार्क नंबर और किसी निष्पक्ष थर्ड पार्टी का समग्र नंबर एक जैसी गवाही नहीं हैं, और हमें पता है कि कुल मिलाकर Astra आगे है, सिवाय कीमत के, जहां वह बुरी तरह पीछे रह जाता है।


GPT-6 Astra का लॉन्च 3 सितंबर को हुआ। कुछ हफ्तों बाद, 21 सितंबर को Grok 4.7 आया, जिसमें SpaceXAI ने जारी करते समय ही Astra के मुकाबले अपनी तुलना शामिल कर दी। अगर आप दोनों पोस्ट एक-एक कर पढ़ें तो हर एक साफ विजेता लगेगा। उन्हें साथ-साथ पढ़ें, तो ज़्यादा साफ दिखता है कि असल में हुआ क्या: दो कंपनियों ने अलग-अलग बेंचमार्क्स को सुर्खियों में रखा, और किसी ने भी खुद को दूसरी कंपनी के पसंदीदा चार्ट से नहीं आंका।
लेकिन लॉन्च-पोस्ट के बेंचमार्क्स सिर्फ उन्हीं खास कामों के बारे में बताते हैं जिन्हें दिखाने के लिए चुना गया। वे यह नहीं बताते कि कोई मॉडल कुल मिलाकर कहां खड़ा है। उस बड़े सवाल पर सोचें, तो वजह है मानने की कि Grok 4.7 असल में Astra के ही स्तर पर नहीं खेल रहा। यहीं Artificial Analysis Intelligence Index काम आता है, क्योंकि वह थर्ड-पार्टी है। फिर भी, तुलना साफ नहीं है। Grok 4.7 काफी सस्ता है, और प्रति टोकन लागत इसे अच्छा मॉडल बनाती है।
Grok 4.7 क्या है?
Grok 4.7 xAI/SpaceXAI का नया मॉडल है, जिसे कोडिंग और नॉलेज वर्क के लिए पोज़िशन किया गया है। रिलीज़ में इसे "दोगुनी रफ्तार, आधी कीमत" पर तुलनीय मॉडलों से बेहतर बताया गया है, और कहा गया है कि इसे अपने पूर्ववर्ती Grok 4.6 के समान कीमत और स्पीड पर सर्व किया जा रहा है, जो चर्चा बनाने का बढ़िया तरीका है।
अंदर से, Grok 4.7 में 4.6 से बड़ा बेस मॉडल है, जिसे कठिन टास्क-मिश्रण पर लंबी रिइनफोर्समेंट लर्निंग रन से प्रशिक्षित किया गया है और ऐसे समस्याओं पर वेट किया गया है जिन्हें पूरा करने में कई घंटे लगते हैं। साथ ही, मॉडल अपने काम की खुद जांच करने और लंबा कॉन्टेक्स्ट संभालने में बेहतर है। अंत में, हमें पता होना चाहिए कि इसे Grok Bot हार्नेस को नैटिव रूप से समझने के लिए प्रशिक्षित किया गया था।
GPT-6 Astra क्या है?
GPT-6 Astra OpenAI का मौजूदा फ्लैगशिप मॉडल है। OpenAI इसे "दुनिया का सबसे बुद्धिमान और सबसे अधिक एलाइन किया हुआ मॉडल" कहता है। OpenAI का कहना है कि Astra FrontierMath Tier 4 पर 98%, ARC-AGI-3 पर 99.9%, और ExploitBench पर 100% स्कोर करता है। हमें यकीन है कि भविष्य के लेखों में हम अन्य बेंचमार्क टेस्टों का भी हवाला देंगे क्योंकि Astra ने कई प्रसिद्ध बेंचमार्क्स पर संतृप्ति बना ली है। इसके अलावा, Astra ने गणित में खुले समस्याओं पर भी मदद की है, जिनमें अभाज्य संख्याओं के बीच गैप पर दो नए परिणाम शामिल हैं।
और आगे, OpenAI Astra को कंप्यूटर उपयोग में बड़ा कदम बताता है। यह फॉर्म भरने, CRM रिकॉर्ड अपडेट करने, रिसर्च करने, वेबसाइट बनाने और फ्रंटएंड QA चलाने जैसे काम संभालता है। अन्य मॉडल यह सब पहले से कर रहे थे, लेकिन OpenAI कहता है कि Astra इससे कहीं तेज़ और सटीक है। रिलीज़ में प्रोफेशनल आउटपुट क्वालिटी पर भी ज़ोर है, यह कहते हुए कि डॉक्यूमेंट्स, स्प्रेडशीट्स, स्लाइड डेक्स आदि बनाते समय Astra मौजूदा टेम्प्लेट्स और हाउस स्टाइल का बेहतर पालन करता है।
Grok 4.7 बनाम GPT-6 Astra: आमने-सामने तुलना
कोडिंग पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 की रिलीज़ CursorBench 4.0 को उसके सिग्नेचर कोडिंग बेंчमार्क के रूप में केंद्र में रखती है, जहां यह 46.3% (xHigh सेटिंग) स्कोर करता है, जो Grok 4.6 (40.4%) से आगे है। यह GPT‑5.6 Sol (41.7%) से भी आगे है, लेकिन Claude Fable 5.1 (51.8%) से पीछे है।
GPT‑6 Astra की पोस्ट इसके बजाय Terminal-Bench 4.0 का ज़िक्र करती है, जहां यह 57.9% का दावा करता है, जो GPT‑5.6 Sol (37.3%) और Claude Fable 5.1 (55.8%) को पछाड़ता है।
दिलचस्प है कि Grok की रिलीज़ Grok 4.7 के लिए Terminal-Bench 4.0 पर 38.0% भी बताती है, जो Astra के स्कोर से काफी कम है।
DeepSWE v1.1 पर, दोनों क़रीब हैं, लेकिन Astra आगे है: Astra 74.1% रिपोर्ट करता है, जबकि Grok 4.7 71.0% (हाई एफर्ट पर) बताता है।
नॉलेज वर्क पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 AA Briefcase v1.1 ("कई घंटे का ऑफिस वर्क") को हाईलाइट करता है, जहां यह 1,657 स्कोर करता है, जो Grok 4.6 (1,546) और GPT‑5.6 Sol (1,487) से आगे है। लेकिन यह अब भी Claude Fable 5.1 से पीछे है, जो 1,678 पर चार्ट में सबसे ऊपर है।
Grok GDPval Elo तुलना का भी हवाला देता है जहां Fable 5.1 1,735 पर आगे है, उसके बाद Grok 4.7 1,695 पर, फिर Grok 4.6 1,605 पर। GPT‑6 Astra इस चार्ट में आखिरी आता है 1,542 पर, कम से कम xAI की अपनी प्रस्तुति में।
GPT‑6 Astra के नॉलेज-वर्क दावे पूरी तरह अलग बेंचमार्क्स पर टिके हैं: AutomationBench (41.4%, जो GPT‑5.6 Sol और Fable 5.1 से आगे है) और BenchCAD (95.9%, जो फिर से Sol और Fable 5.1 से आगे है)। यह Agents' Last Exam का भी हवाला देता है, जहां यह 59.3% स्कोर करता है, Opus 5 के 55.5% से आगे।
साइबरसुरक्षा पर Grok 4.7 बनाम GPT-6 Astra
यहीं दोनों रिलीज़ लगभग उल्टी कहानियां सुनाती हैं।
xAI कहता है कि Grok 4.7 HackerBench v0.3 पर जोखिमभरे ड्यूल-यूज़ प्रॉम्प्ट्स में से 96.7% को ब्लॉक करता है, जबकि वैध सुरक्षा कार्यों को आगे जाने देता है। यह LatchBio के बायोसेफ्टी बेंचमार्क पर भी 62.4% के साथ सबसे ऊपर है। कंपनी बताती है कि चुने हुए पार्टनर्स को संकुचित, निमंत्रण-आधारित, कम-प्रतिबंधित रेड-टीम क्षमताओं की पहुंच दी गई, लेकिन हेडलाइन फ़्रेमिंग संयम की है।
OpenAI कहता है कि GPT‑6 Astra उसकी अपनी साइबर क्षमता की "Critical" थ्रेशहोल्ड पार कर चुका है, और ExploitBench पर 100% स्कोर रिपोर्ट करता है, जबकि GPT‑5.6 Sol 78.5% पर था। यह भी कहता है कि टेस्टिंग के दौरान Astra ने दो असली ज़ीरो-डे कमजोरियां खोजीं, जिन्हें OpenAI के अनुसार मेंटेनर्स को बताया गया। इसके साथ, OpenAI एक 0% "हनीपॉट" एक्सप्लॉइट दर रिपोर्ट करता है जब Astra को प्रोडक्शन सेफगार्ड्स के बिना परखा गया, और कहता है कि Astra अधिक उन्नत आक्रामक कार्य, जैसे प्रूफ-ऑफ-कॉन्सेप्ट एक्सप्लॉइट बनाना, करने से मना करेगा।
Astra की तुलना में Grok 4.7 असल में कहां बैठता है
आइए चेरी-पिक्ड चार्ट्स से पीछे हटें।
Artificial Analysis Intelligence Index पर — जो दस बेंचमार्क्स का सम agregate है, न कि एक मनचाहा टास्क — Grok 4.7 को 46 स्कोर मिलता है। Fable 5.1 और GPT-6 दोनों 53 स्कोर करते हैं। यह गैप है, और यह वह बात नहीं है जो किसी भी कंपनी की लॉन्च पोस्ट आपको दिखाती है, क्योंकि किसी ने भी इस इंडेक्स पर बेंचमार्क नहीं किया।
SpaceXAI की अपनी रिलीज़ Terminal-Bench 4.0 पर 38% का दावा करती है, लेकिन Artificial Analysis ने उसी बेंचमार्क पर Grok 4.7 को स्वतंत्र रूप से सिर्फ 26% मापा। Astra ने 57.9% का दावा किया। स्वयं-रिपोर्टेड और स्वतंत्र रूप से मापी गई संख्याएं हमेशा एक जैसी कहानी नहीं बतातीं।
Elon Musk ने खुद Grok 4.7 के लॉन्च से एक हफ्ता पहले उम्मीदें सेट कीं:
इस सबका मतलब यह नहीं कि Grok 4.7 खराब मॉडल है — इस लेख में आगे आने वाला प्राइस-परफॉर्मेंस केस अब भी मजबूत है। लेकिन आगे आने वाली बेंचमार्क-दर-बेंचमार्क तुलना पढ़ते समय यह ध्यान रखें: ये उन दो मॉडलों की तुलना है जो कुल मिलाकर शायद समकक्ष नहीं हैं, और मीट्रिक्स वही चुने गए हैं जिन पर हर कंपनी का मॉडल अच्छा करता है।
कीमत पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 इनपुट टोकन पर 5 गुना सस्ता है और आउटपुट टोकन पर लगभग 8 गुना सस्ता। इसलिए Grok 4.7 कम लागत में बड़े मॉडलों की बराबरी या बढ़त ले आता है, और साथ ही Grok 4.6 के मुकाबले कीमतें सपाट रखता है।
OpenAI कीमत के अंतर से वाकई में बहस नहीं करता। वह दक्षता की दलील देता है: कथित तौर पर Astra को कोई काम खत्म करने के लिए कम टोकन चाहिए होते हैं, जो प्रति-टास्क लागत पर अंतर को आंशिक रूप से कम कर देता है, भले ही प्रति-टोकन रेट अधिक (काफी अधिक) हो।
निष्कर्ष: अगर आप प्रति-टोकन लागत के लिए ऑप्टिमाइज़ कर रहे हैं, तो Grok 4.7 विजेता है।
सुरक्षा पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 की सुरक्षा पेशकश इंकार करने और जेलब्रेक-प्रतिरोध पर केंद्रित है। xAI इसे इन मोर्चों पर उनके द्वारा परखा गया सबसे मजबूत मॉडल कहता है, जिसे नए सेफगार्ड स्टैक का सहारा प्राप्त है। यह LatchBio के बायोसेफ्टी बेंचमार्क का भी हवाला देता है, जहां यह 62.4% स्कोर करता है, जिसे वैध जैविक कार्यों में उपयोगिता और खतरनाक अनुरोधों पर सुरक्षित इंकार के बीच संतुलन के रूप में पेश किया गया है।
GPT-6 Astra की सुरक्षा पेशकश सिर्फ इंकार की बजाय एलाइनमेंट पर है। OpenAI इसे "हमारा सबसे अधिक एलाइन किया हुआ मॉडल" कहता है, एक आंतरिक सर्कमवेंशन बेंचमार्क पर 0.00% स्कोर की ओर इशारा करते हुए (GPT-5.6 Sol के 0.29% के मुकाबले) और अपनी ही क्षमताओं पर एक आंतरिक हेलुसिनेशन बेंचमार्क पर 4.2% दर (Sol के 12.2% के मुकाबले)। यह भी कहता है कि टेस्टिंग में Astra ने कभी ऑटो-रिव्यू सेफगार्ड को बायपास करने की कोशिश नहीं की, भले ही उस सेफगार्ड को आसानी से छलने लायक बना दिया गया हो।
उपलब्धता पर Grok 4.7 बनाम GPT-6 Astra
Grok 4.7 अभी उपलब्ध है। आप इसे Cursor, Grok Build, Grok API, और थर्ड-पार्टी कोडिंग हार्नेस, मॉडल राउटर्स और क्लाउड प्लेटफ़ॉर्म्स के जरिए पा सकते हैं।
GPT‑6 Astra धीरे-धीरे रोलआउट हो रहा है। यह चुनिंदा संगठनों से शुरू हुआ, इसके बाद ChatGPT Plus/Pro/Business/Enterprise एक्सेस, OpenAI API, Microsoft Azure, और AWS Bedrock अगले दिनों में आए। एंटरप्राइज़ एडमिन्स को भी इसे खुद ऑन करना पड़ता है, क्योंकि यह डिफ़ॉल्ट रूप से ऑफ़ रहता है।
शुरुआती टेस्टर्स क्या देख रहे हैं
बेंचमार्क्स एक बात हैं। लेकिन आमने-सामने टेस्ट शायद ज़्यादा दिलचस्प होते हैं। अब जब दोनों मॉडल बाहर हैं, हम देख रहे हैं कि लोग क्या-क्या बढ़िया चीज़ें बना रहे हैं।
एक उदाहरण: डेवलपर आदित्य ने GPT-6 Astra, Grok 4.7, Kimi K3, और Fable 5.1 को एक ही प्रॉम्प्ट दिया, जो फ्लाइट सिमुलेटर बनाने के बारे में था। उनका फ़ैसला: कुल मिलाकर Astra सबसे ऊपर आया, लेकिन Grok 4.7 चौंकाने वाली तरह से क़रीब था, जबकि Kimi K3 और Fable 5.1 उसके पीछे टाई पर रहे।
लॉन्च से एक हफ्ता पहले, जैसा मैंने पहले बताया, Musk ने Grok 4.7 को मोटे तौर पर Opus 5.0-क्लास और Astra व Fable से एक स्तर नीचे आंका था, और मल्टीमॉडल को एक खास कमजोरी बताया था। फ्लाइट सिमुलेटर किसी मॉडल को दी जा सकने वाली जितनी मल्टीमॉडल टास्क हो सकती है, उतनी है। अगर कुछ है, तो ठीक उसी तरह के टास्क पर, जिसके बारे में Musk ने संघर्ष की चेतावनी दी थी, Grok 4.7 का Astra के साथ दिखना SpaceXAI के लिए अच्छा संकेत है। शायद Elon ने मॉडल को कम आंका।
निष्कर्ष
मॉडल मेट्रिक्स कुछ-कुछ सिक्का उछाल जैसे हैं। कोडिंग, साइबरसुरक्षा, सुरक्षा, नॉलेज वर्क: यह इस पर निर्भर है कि आप किसके चार्ट पर भरोसा करते हैं। दोनों कंपनियों ने वही संख्याएं चुनीं जो उन्हें अच्छी दिखाएं।
लेकिन Artificial Analysis Intelligence Index यहां उपयोगी है क्योंकि किसी विक्रेता का एक अकेला बेंचमार्क नंबर और किसी निष्पक्ष थर्ड पार्टी का समग्र नंबर एक जैसी गवाही नहीं हैं, और हमें पता है कि कुल मिलाकर Astra आगे है, सिवाय कीमत के, जहां वह बुरी तरह पीछे रह जाता है।