GPT-6 Astra ra mắt ngày 3 tháng 9. Grok 4.7 theo sau vài tuần, vào ngày 21 tháng 9, với các so sánh của chính SpaceXAI với Astra được tích hợp ngay trong thông cáo. Đọc từng bài riêng lẻ, bạn sẽ nghĩ ai cũng thắng. Đặt cạnh nhau, sẽ rõ điều đang diễn ra: hai công ty chọn các thang đo khác nhau để làm tiêu đề, và không bên nào tự so mình với biểu đồ ưa thích của bên kia.
Nhưng các thang đo trong bài ra mắt chỉ cho bạn biết về những tác vụ cụ thể mà mỗi công ty chọn để trình diễn. Chúng không cho biết vị thế tổng thể của một mô hình. Ở câu hỏi lớn hơn này, có lý do để nghĩ rằng Grok 4.7 thực ra không chơi cùng hạng với Astra. Đây là lúc Artificial Analysis Intelligence Index hữu ích vì đó là bên thứ ba. Dẫu vậy, so sánh này không hề gọn gàng. Grok 4.7 rẻ hơn nhiều, và chi phí mỗi token khiến nó trở thành một mô hình tốt.
Grok 4.7 là gì?
Grok 4.7 là mẫu mới nhất của xAI/SpaceXAI, định vị cho công việc lập trình và tri thức. Thông cáo mô tả nó là “nhanh gấp đôi, với nửa giá” so với các mẫu tương đương, và nói rằng nó được phục vụ với cùng mức giá và tốc độ như tiền nhiệm Grok 4.6, một cách hay để tạo tiếng vang.
Bên dưới, Grok 4.7 dùng mô hình nền tảng lớn hơn 4.6, được huấn luyện với thời gian tăng cường học tăng cường dài hơn trên một phối trộn tác vụ khó hơn và được trọng số về các bài toán mất nhiều giờ để hoàn thành. Ngoài ra, mô hình giỏi hơn trong việc tự kiểm tra và quản lý ngữ cảnh dài hơn. Cuối cùng, cần biết rằng nó được huấn luyện để hiểu nguyên bản bộ khung Grok Bot.
GPT-6 Astra là gì?
GPT-6 Astra là mẫu chủ lực hiện tại của OpenAI. OpenAI gọi nó là “mô hình thông minh và đồng bộ nhất thế giới.” OpenAI nói Astra đạt 98% trên FrontierMath Tier 4, 99,9% trên ARC-AGI-3, và 100% trên ExploitBench. Chúng tôi chắc rằng trong các bài viết sau sẽ tham chiếu những bài kiểm định khác vì Astra đã phủ kín nhiều thang đo nổi tiếng nhất. Ngoài ra, Astra đã giúp xử lý các bài toán mở trong toán học, bao gồm hai kết quả mới về khoảng cách giữa các số nguyên tố.
Hơn nữa, OpenAI định vị Astra như một bước tiến lớn trong việc sử dụng máy tính. Nó xử lý các tác vụ như điền biểu mẫu, cập nhật bản ghi CRM, nghiên cứu, xây dựng website và chạy QA frontend. Các mô hình khác đã làm những điều này, nhưng OpenAI nói Astra nhanh hơn và chính xác hơn nữa. Thông cáo cũng nhấn mạnh chất lượng đầu ra chuyên nghiệp, nói rằng Astra bám sát mẫu sẵn có và phong cách biên tập tốt hơn khi tạo tài liệu, bảng tính, bộ slide và tương tự.
So sánh trực diện Grok 4.7 và GPT-6 Astra
Grok 4.7 và GPT-6 Astra về lập trình
Thông cáo của Grok 4.7 lấy CursorBench 4.0 làm thang đo lập trình đặc trưng, nơi nó đạt 46,3% (thiết lập xHigh), vượt Grok 4.6 (40,4%). Nó cũng vượt GPT‑5.6 Sol (41,7%), nhưng kém Claude Fable 5.1 (51,8%).
Bài của GPT‑6 Astra lại nhắc đến Terminal-Bench 4.0, nơi nó đạt 57,9%, vượt GPT‑5.6 Sol (37,3%) và Claude Fable 5.1 (55,8%).
Điều thú vị là thông cáo của Grok cũng báo cáo con số Terminal-Bench 4.0 là 38,0% cho Grok 4.7, thấp hơn nhiều so với điểm của Astra.
Trên DeepSWE v1.1, hai bên khá sát nhau, nhưng Astra dẫn trước: Astra báo 74,1% so với 71,0% của Grok 4.7 (ở mức nỗ lực cao).
- Kết luận nhanh: Bộ thang đo của Astra cho lập trình rộng hơn và cho thấy bức tranh tổng thể mạnh hơn, nhưng hai công ty chọn các thang đo tiêu đề khác nhau, khiến so sánh thực sự khó rút ra. Chúng tôi nhận thấy các công ty thường làm vậy, có lẽ là có chủ ý.
Grok 4.7 và GPT-6 Astra về công việc tri thức
Grok 4.7 làm nổi bật AA Briefcase v1.1 (“công việc văn phòng nhiều giờ”), nơi nó đạt 1.657, vượt Grok 4.6 (1.546) và GPT‑5.6 Sol (1.487). Nhưng vẫn kém Claude Fable 5.1, dẫn đầu bảng ở 1.678.
Grok cũng trích dẫn so sánh GDPval Elo, nơi Fable 5.1 dẫn ở 1.735, tiếp theo là Grok 4.7 ở 1.695, rồi Grok 4.6 ở 1.605. GPT‑6 Astra đứng cuối bảng này ở 1.542, ít nhất là theo cách xAI trình bày.
Các tuyên bố về công việc tri thức của GPT‑6 Astra lại dựa vào các thang đo hoàn toàn khác: AutomationBench (41,4%, vượt GPT‑5.6 Sol và Fable 5.1) và BenchCAD (95,9%, lại vượt Sol và Fable 5.1). Nó cũng trích dẫn Agents' Last Exam, nơi nó đạt 59,3%, vượt 55,5% của Opus 5.
- Kết luận nhanh: Mỗi công ty chọn thang đo có lợi nhất cho mình. Grok dựa vào sức bền công việc văn phòng và điểm Elo tầm xa, trong khi Astra dựa vào thang đo hoàn thành tác vụ và tuân thủ mẫu. Không thông cáo nào so mô hình của mình với thang đo đối thủ chọn và chịu thua, nên khó so sánh. Coi như hòa.
Grok 4.7 và GPT-6 Astra về an ninh mạng
Đây là nơi hai thông cáo kể gần như hai câu chuyện trái ngược.
xAI nói Grok 4.7 chặn 96,7% các lời nhắc rủi ro hai mục đích trên HackerBench v0.3, đồng thời vẫn cho phép công việc an ninh hợp pháp. Nó cũng đứng đầu thang đo an toàn sinh học của LatchBio ở 62,4%. Công ty đề cập cấp quyền truy cập hẹp hơn, chỉ mời đối tác được chọn cho khả năng red-team ít hạn chế, nhưng tiêu đề nhấn mạnh là sự kiềm chế.
OpenAI nói GPT‑6 Astra vượt qua ngưỡng “Critical” của chính họ về năng lực mạng, và báo cáo 100% trên ExploitBench, so với 78,5% của GPT‑5.6 Sol. Họ cũng nói Astra đã tìm ra hai lỗ hổng zero-day thực trong quá trình thử nghiệm và đã thông báo cho đơn vị duy trì. Cùng với đó, OpenAI báo cáo tỷ lệ khai thác “honeypot” 0% khi Astra được thử nghiệm không có lớp bảo vệ sản xuất, và nói Astra sẽ từ chối các tác vụ tấn công nâng cao hơn như tạo bằng chứng khái niệm cho khai thác.
- Kết luận nhanh: Grok 4.7 được tiếp thị là an toàn vì nó kiềm chế. GPT‑6 Astra được tiếp thị là an toàn vì nó được căn chỉnh tốt ngay cả khi không kiềm chế. Đáng chú ý là “an toàn” mang nghĩa khác nhau trong mỗi lập luận.
Vị thế thực sự của Grok 4.7 so với Astra
Hãy lùi lại khỏi những biểu đồ chọn lọc.
Trên Artificial Analysis Intelligence Index — một tổng hợp trên mười thang đo, không phải một tác vụ chọn tay — Grok 4.7 đạt 46. Fable 5.1 và GPT-6 đều đạt 53. Đó là một khoảng cách, và không bài ra mắt nào cho bạn thấy, vì không bên nào đo theo chỉ số đó.
Chính thông cáo của SpaceXAI nói 38% trên Terminal-Bench 4.0, nhưng Artificial Analysis đo độc lập Grok 4.7 chỉ ở 26% trên cùng thang đo. Astra nói đạt 57,9%. Số liệu tự báo cáo và số liệu đo độc lập không phải lúc nào cũng kể cùng một câu chuyện.
Bản thân Elon Musk đã đặt kỳ vọng một tuần trước khi Grok 4.7 ra mắt:
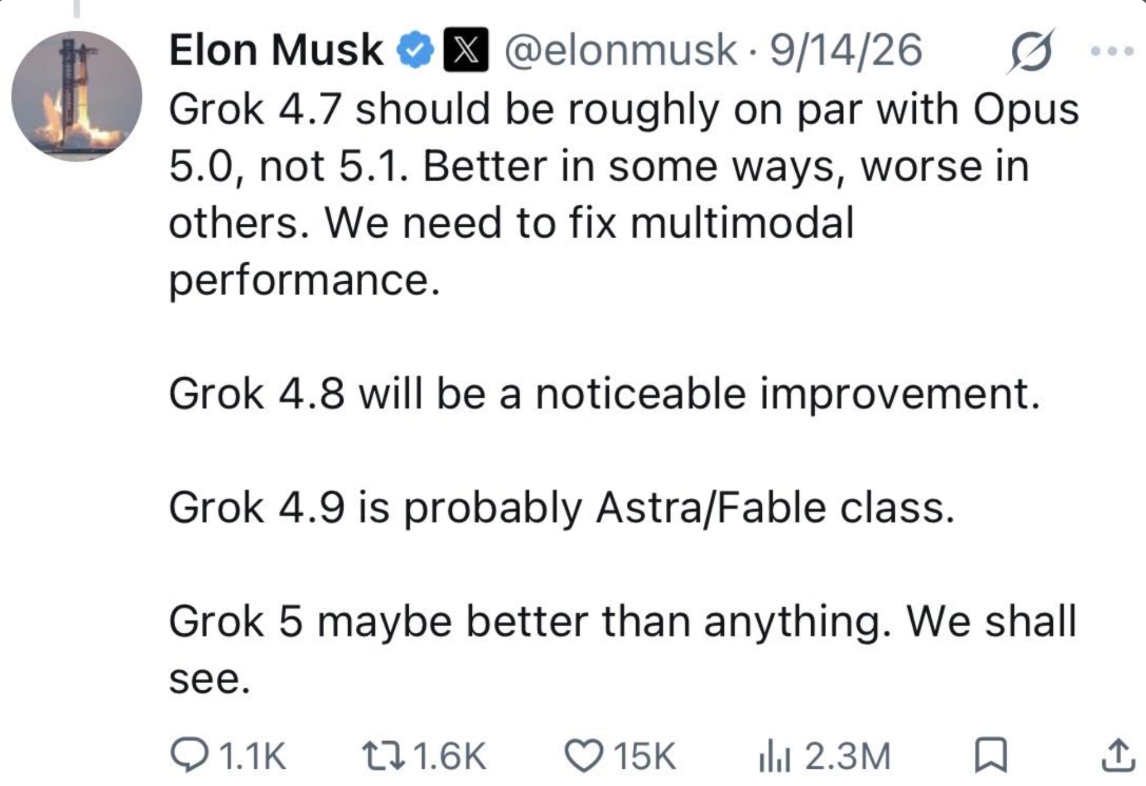
Tất cả điều này không có nghĩa Grok 4.7 là một mô hình tệ — luận điểm về hiệu năng theo giá ở phần sau vẫn đúng. Nhưng đáng để đọc các so sánh theo từng thang đo sau đây với điều này trong đầu: chúng so hai mô hình có thể không cùng đẳng cấp tổng thể, dùng các thước đo mỗi công ty chọn vì mô hình của họ làm tốt trên đó.
Grok 4.7 và GPT-6 Astra về giá
Grok 4.7 rẻ hơn 5 lần với token đầu vào và khoảng 8 lần với token đầu ra. Vì vậy, Grok 4.7 đúng là sánh ngang hoặc vượt các mô hình lớn hơn với một phần nhỏ chi phí, đồng thời giữ mức giá phẳng so với Grok 4.6.
OpenAI thực ra không tranh cãi về khoảng cách giá. Họ lập luận về hiệu quả: Astra được cho là cần ít token hơn để hoàn thành tác vụ, điều mà họ nói một phần thu hẹp khoảng cách về chi phí mỗi tác vụ ngay cả khi mức giá mỗi token cao hơn (cao hơn nhiều).
| | Đầu vào ($/triệu token) | Đầu ra ($/triệu token) | Tầng nhanh |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | Tốc độ gấp 2 với giá gấp 2 |
| GPT‑6 Astra | $10 | $50 | Tốc độ gấp 2 với giá gấp 2 |
Kết luận nhanh: Nếu bạn tối ưu cho chi phí mỗi token, Grok 4.7 thắng.
Grok 4.7 và GPT-6 Astra về an toàn
Thông điệp an toàn của Grok 4.7 xoay quanh từ chối và chống jailbreak. xAI gọi đây là mô hình mạnh nhất họ từng thử nghiệm ở các khía cạnh này, được hậu thuẫn bởi một tầng biện pháp bảo vệ mới. Họ cũng trích dẫn thang đo an toàn sinh học của LatchBio, nơi nó đạt 62,4%, được định khung là cân bằng giữa tính hữu ích cho công việc sinh học hợp pháp và từ chối an toàn với yêu cầu nguy hiểm.
Thông điệp an toàn của GPT-6 Astra nói về căn chỉnh hơn là chỉ từ chối. OpenAI gọi nó là “mô hình được căn chỉnh tốt nhất của chúng tôi,” trỏ tới điểm 0,00% trên một thang đo nội bộ về lách luật (so với 0,29% của GPT-5.6 Sol) và tỷ lệ 4,2% trên một thang đo nội bộ về ảo giác liên quan đến khả năng của chính nó (so với 12,2% của Sol). Họ cũng nói Astra không bao giờ cố vượt qua cơ chế tự rà soát trong thử nghiệm, ngay cả khi cơ chế đó được làm cho dễ bị lách.
- Kết luận nhanh: Grok 4.7 tập trung chặn yêu cầu xấu ngay từ đầu. GPT-6 Astra tập trung vào việc tin cậy phán đoán của nó khi đã hoạt động tự chủ.
Grok 4.7 và GPT-6 Astra về khả dụng
Grok 4.7 hiện đã có sẵn. Bạn có thể dùng trong Cursor, Grok Build, Grok API, và thông qua các khung lập trình bên thứ ba, bộ định tuyến mô hình, và nền tảng đám mây.
GPT‑6 Astra triển khai chậm hơn. Nó bắt đầu với một nhóm tổ chức giới hạn, sau đó là truy cập qua ChatGPT Plus/Pro/Business/Enterprise, OpenAI API, Microsoft Azure, và AWS Bedrock trong những ngày tiếp theo. Quản trị viên doanh nghiệp cũng phải tự bật vì mặc định là tắt.
- Kết luận nhanh: Grok 4.7 ra mắt rộng, Astra ra mắt theo giai đoạn. Nhưng Astra đã ra mắt vài tuần, nên giờ cả hai đều sẵn có rộng rãi.
Những gì người thử sớm đang thấy
Thang đo là một chuyện. Nhưng thử đối đầu có lẽ thú vị hơn. Giờ cả hai mô hình đã ra mắt, chúng ta bắt đầu thấy những thứ hay ho mọi người đang làm.
Một ví dụ: nhà phát triển Aditya đưa cùng một lời nhắc về xây dựng trình mô phỏng bay cho GPT-6 Astra, Grok 4.7, Kimi K3 và Fable 5.1. Kết luận của anh: Astra về nhất chung cuộc, nhưng Grok 4.7 rút ngắn bất ngờ, trong khi Kimi K3 và Fable 5.1 hòa nhau phía sau.
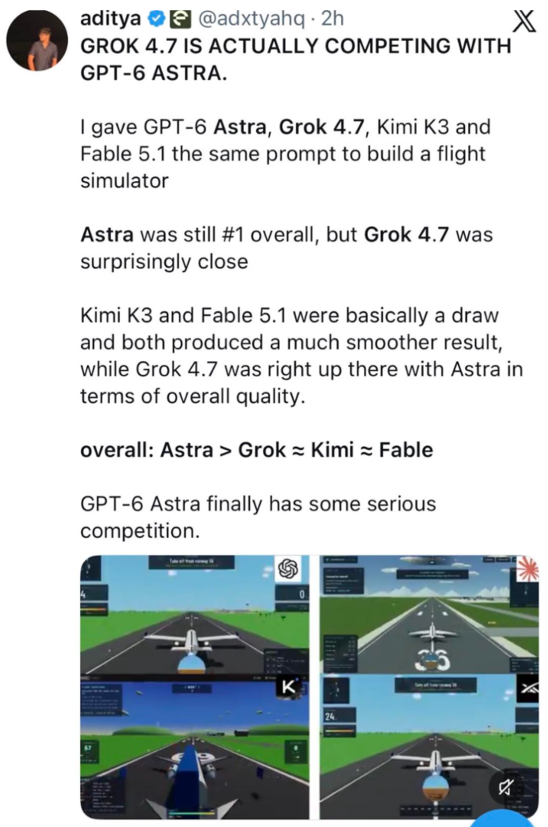
Một tuần trước khi ra mắt, như tôi đã nhắc, Musk ước lượng Grok 4.7 xấp xỉ hạng Opus 5.0 và dưới một bậc so với Astra và Fable, và ông cũng chỉ ra đa phương thức là điểm yếu cụ thể. Trình mô phỏng bay gần như là tác vụ đa phương thức nhất bạn có thể giao cho một mô hình. Nếu có gì, việc Grok 4.7 xuất hiện ngang hàng với Astra đúng ở loại tác vụ mà Musk cảnh báo nó sẽ vật lộn là một tín hiệu tốt cho SpaceXAI. Có lẽ Elon đã đánh giá chưa đủ cao mô hình.
Kết luận
Các chỉ số mô hình hơi kiểu tung đồng xu. Lập trình, an ninh mạng, an toàn, công việc tri thức: Còn tùy bạn tin biểu đồ của ai. Cả hai công ty đều chọn các con số khiến họ trông tốt.
Nhưng Artificial Analysis Intelligence Index hữu ích ở đây vì một con số thang đo đơn lẻ từ nhà cung cấp và một con số tổng hợp từ bên thứ ba trung lập không phải cùng một loại bằng chứng, và chúng ta biết Astra thắng chung cuộc, trừ, dĩ nhiên, về giá, nơi nó thua nặng.


GPT-6 Astra ra mắt ngày 3 tháng 9. Grok 4.7 theo sau vài tuần, vào ngày 21 tháng 9, với các so sánh của chính SpaceXAI với Astra được tích hợp ngay trong thông cáo. Đọc từng bài riêng lẻ, bạn sẽ nghĩ ai cũng thắng. Đặt cạnh nhau, sẽ rõ điều đang diễn ra: hai công ty chọn các thang đo khác nhau để làm tiêu đề, và không bên nào tự so mình với biểu đồ ưa thích của bên kia.
Nhưng các thang đo trong bài ra mắt chỉ cho bạn biết về những tác vụ cụ thể mà mỗi công ty chọn để trình diễn. Chúng không cho biết vị thế tổng thể của một mô hình. Ở câu hỏi lớn hơn này, có lý do để nghĩ rằng Grok 4.7 thực ra không chơi cùng hạng với Astra. Đây là lúc Artificial Analysis Intelligence Index hữu ích vì đó là bên thứ ba. Dẫu vậy, so sánh này không hề gọn gàng. Grok 4.7 rẻ hơn nhiều, và chi phí mỗi token khiến nó trở thành một mô hình tốt.
Grok 4.7 là gì?
Grok 4.7 là mẫu mới nhất của xAI/SpaceXAI, định vị cho công việc lập trình và tri thức. Thông cáo mô tả nó là “nhanh gấp đôi, với nửa giá” so với các mẫu tương đương, và nói rằng nó được phục vụ với cùng mức giá và tốc độ như tiền nhiệm Grok 4.6, một cách hay để tạo tiếng vang.
Bên dưới, Grok 4.7 dùng mô hình nền tảng lớn hơn 4.6, được huấn luyện với thời gian tăng cường học tăng cường dài hơn trên một phối trộn tác vụ khó hơn và được trọng số về các bài toán mất nhiều giờ để hoàn thành. Ngoài ra, mô hình giỏi hơn trong việc tự kiểm tra và quản lý ngữ cảnh dài hơn. Cuối cùng, cần biết rằng nó được huấn luyện để hiểu nguyên bản bộ khung Grok Bot.
GPT-6 Astra là gì?
GPT-6 Astra là mẫu chủ lực hiện tại của OpenAI. OpenAI gọi nó là “mô hình thông minh và đồng bộ nhất thế giới.” OpenAI nói Astra đạt 98% trên FrontierMath Tier 4, 99,9% trên ARC-AGI-3, và 100% trên ExploitBench. Chúng tôi chắc rằng trong các bài viết sau sẽ tham chiếu những bài kiểm định khác vì Astra đã phủ kín nhiều thang đo nổi tiếng nhất. Ngoài ra, Astra đã giúp xử lý các bài toán mở trong toán học, bao gồm hai kết quả mới về khoảng cách giữa các số nguyên tố.
Hơn nữa, OpenAI định vị Astra như một bước tiến lớn trong việc sử dụng máy tính. Nó xử lý các tác vụ như điền biểu mẫu, cập nhật bản ghi CRM, nghiên cứu, xây dựng website và chạy QA frontend. Các mô hình khác đã làm những điều này, nhưng OpenAI nói Astra nhanh hơn và chính xác hơn nữa. Thông cáo cũng nhấn mạnh chất lượng đầu ra chuyên nghiệp, nói rằng Astra bám sát mẫu sẵn có và phong cách biên tập tốt hơn khi tạo tài liệu, bảng tính, bộ slide và tương tự.
So sánh trực diện Grok 4.7 và GPT-6 Astra
Grok 4.7 và GPT-6 Astra về lập trình
Thông cáo của Grok 4.7 lấy CursorBench 4.0 làm thang đo lập trình đặc trưng, nơi nó đạt 46,3% (thiết lập xHigh), vượt Grok 4.6 (40,4%). Nó cũng vượt GPT‑5.6 Sol (41,7%), nhưng kém Claude Fable 5.1 (51,8%).
Bài của GPT‑6 Astra lại nhắc đến Terminal-Bench 4.0, nơi nó đạt 57,9%, vượt GPT‑5.6 Sol (37,3%) và Claude Fable 5.1 (55,8%).
Điều thú vị là thông cáo của Grok cũng báo cáo con số Terminal-Bench 4.0 là 38,0% cho Grok 4.7, thấp hơn nhiều so với điểm của Astra.
Trên DeepSWE v1.1, hai bên khá sát nhau, nhưng Astra dẫn trước: Astra báo 74,1% so với 71,0% của Grok 4.7 (ở mức nỗ lực cao).
Grok 4.7 và GPT-6 Astra về công việc tri thức
Grok 4.7 làm nổi bật AA Briefcase v1.1 (“công việc văn phòng nhiều giờ”), nơi nó đạt 1.657, vượt Grok 4.6 (1.546) và GPT‑5.6 Sol (1.487). Nhưng vẫn kém Claude Fable 5.1, dẫn đầu bảng ở 1.678.
Grok cũng trích dẫn so sánh GDPval Elo, nơi Fable 5.1 dẫn ở 1.735, tiếp theo là Grok 4.7 ở 1.695, rồi Grok 4.6 ở 1.605. GPT‑6 Astra đứng cuối bảng này ở 1.542, ít nhất là theo cách xAI trình bày.
Các tuyên bố về công việc tri thức của GPT‑6 Astra lại dựa vào các thang đo hoàn toàn khác: AutomationBench (41,4%, vượt GPT‑5.6 Sol và Fable 5.1) và BenchCAD (95,9%, lại vượt Sol và Fable 5.1). Nó cũng trích dẫn Agents' Last Exam, nơi nó đạt 59,3%, vượt 55,5% của Opus 5.
Grok 4.7 và GPT-6 Astra về an ninh mạng
Đây là nơi hai thông cáo kể gần như hai câu chuyện trái ngược.
xAI nói Grok 4.7 chặn 96,7% các lời nhắc rủi ro hai mục đích trên HackerBench v0.3, đồng thời vẫn cho phép công việc an ninh hợp pháp. Nó cũng đứng đầu thang đo an toàn sinh học của LatchBio ở 62,4%. Công ty đề cập cấp quyền truy cập hẹp hơn, chỉ mời đối tác được chọn cho khả năng red-team ít hạn chế, nhưng tiêu đề nhấn mạnh là sự kiềm chế.
OpenAI nói GPT‑6 Astra vượt qua ngưỡng “Critical” của chính họ về năng lực mạng, và báo cáo 100% trên ExploitBench, so với 78,5% của GPT‑5.6 Sol. Họ cũng nói Astra đã tìm ra hai lỗ hổng zero-day thực trong quá trình thử nghiệm và đã thông báo cho đơn vị duy trì. Cùng với đó, OpenAI báo cáo tỷ lệ khai thác “honeypot” 0% khi Astra được thử nghiệm không có lớp bảo vệ sản xuất, và nói Astra sẽ từ chối các tác vụ tấn công nâng cao hơn như tạo bằng chứng khái niệm cho khai thác.
Vị thế thực sự của Grok 4.7 so với Astra
Hãy lùi lại khỏi những biểu đồ chọn lọc.
Trên Artificial Analysis Intelligence Index — một tổng hợp trên mười thang đo, không phải một tác vụ chọn tay — Grok 4.7 đạt 46. Fable 5.1 và GPT-6 đều đạt 53. Đó là một khoảng cách, và không bài ra mắt nào cho bạn thấy, vì không bên nào đo theo chỉ số đó.
Chính thông cáo của SpaceXAI nói 38% trên Terminal-Bench 4.0, nhưng Artificial Analysis đo độc lập Grok 4.7 chỉ ở 26% trên cùng thang đo. Astra nói đạt 57,9%. Số liệu tự báo cáo và số liệu đo độc lập không phải lúc nào cũng kể cùng một câu chuyện.
Bản thân Elon Musk đã đặt kỳ vọng một tuần trước khi Grok 4.7 ra mắt:
Tất cả điều này không có nghĩa Grok 4.7 là một mô hình tệ — luận điểm về hiệu năng theo giá ở phần sau vẫn đúng. Nhưng đáng để đọc các so sánh theo từng thang đo sau đây với điều này trong đầu: chúng so hai mô hình có thể không cùng đẳng cấp tổng thể, dùng các thước đo mỗi công ty chọn vì mô hình của họ làm tốt trên đó.
Grok 4.7 và GPT-6 Astra về giá
Grok 4.7 rẻ hơn 5 lần với token đầu vào và khoảng 8 lần với token đầu ra. Vì vậy, Grok 4.7 đúng là sánh ngang hoặc vượt các mô hình lớn hơn với một phần nhỏ chi phí, đồng thời giữ mức giá phẳng so với Grok 4.6.
OpenAI thực ra không tranh cãi về khoảng cách giá. Họ lập luận về hiệu quả: Astra được cho là cần ít token hơn để hoàn thành tác vụ, điều mà họ nói một phần thu hẹp khoảng cách về chi phí mỗi tác vụ ngay cả khi mức giá mỗi token cao hơn (cao hơn nhiều).
Kết luận nhanh: Nếu bạn tối ưu cho chi phí mỗi token, Grok 4.7 thắng.
Grok 4.7 và GPT-6 Astra về an toàn
Thông điệp an toàn của Grok 4.7 xoay quanh từ chối và chống jailbreak. xAI gọi đây là mô hình mạnh nhất họ từng thử nghiệm ở các khía cạnh này, được hậu thuẫn bởi một tầng biện pháp bảo vệ mới. Họ cũng trích dẫn thang đo an toàn sinh học của LatchBio, nơi nó đạt 62,4%, được định khung là cân bằng giữa tính hữu ích cho công việc sinh học hợp pháp và từ chối an toàn với yêu cầu nguy hiểm.
Thông điệp an toàn của GPT-6 Astra nói về căn chỉnh hơn là chỉ từ chối. OpenAI gọi nó là “mô hình được căn chỉnh tốt nhất của chúng tôi,” trỏ tới điểm 0,00% trên một thang đo nội bộ về lách luật (so với 0,29% của GPT-5.6 Sol) và tỷ lệ 4,2% trên một thang đo nội bộ về ảo giác liên quan đến khả năng của chính nó (so với 12,2% của Sol). Họ cũng nói Astra không bao giờ cố vượt qua cơ chế tự rà soát trong thử nghiệm, ngay cả khi cơ chế đó được làm cho dễ bị lách.
Grok 4.7 và GPT-6 Astra về khả dụng
Grok 4.7 hiện đã có sẵn. Bạn có thể dùng trong Cursor, Grok Build, Grok API, và thông qua các khung lập trình bên thứ ba, bộ định tuyến mô hình, và nền tảng đám mây.
GPT‑6 Astra triển khai chậm hơn. Nó bắt đầu với một nhóm tổ chức giới hạn, sau đó là truy cập qua ChatGPT Plus/Pro/Business/Enterprise, OpenAI API, Microsoft Azure, và AWS Bedrock trong những ngày tiếp theo. Quản trị viên doanh nghiệp cũng phải tự bật vì mặc định là tắt.
Những gì người thử sớm đang thấy
Thang đo là một chuyện. Nhưng thử đối đầu có lẽ thú vị hơn. Giờ cả hai mô hình đã ra mắt, chúng ta bắt đầu thấy những thứ hay ho mọi người đang làm.
Một ví dụ: nhà phát triển Aditya đưa cùng một lời nhắc về xây dựng trình mô phỏng bay cho GPT-6 Astra, Grok 4.7, Kimi K3 và Fable 5.1. Kết luận của anh: Astra về nhất chung cuộc, nhưng Grok 4.7 rút ngắn bất ngờ, trong khi Kimi K3 và Fable 5.1 hòa nhau phía sau.
Một tuần trước khi ra mắt, như tôi đã nhắc, Musk ước lượng Grok 4.7 xấp xỉ hạng Opus 5.0 và dưới một bậc so với Astra và Fable, và ông cũng chỉ ra đa phương thức là điểm yếu cụ thể. Trình mô phỏng bay gần như là tác vụ đa phương thức nhất bạn có thể giao cho một mô hình. Nếu có gì, việc Grok 4.7 xuất hiện ngang hàng với Astra đúng ở loại tác vụ mà Musk cảnh báo nó sẽ vật lộn là một tín hiệu tốt cho SpaceXAI. Có lẽ Elon đã đánh giá chưa đủ cao mô hình.
Kết luận
Các chỉ số mô hình hơi kiểu tung đồng xu. Lập trình, an ninh mạng, an toàn, công việc tri thức: Còn tùy bạn tin biểu đồ của ai. Cả hai công ty đều chọn các con số khiến họ trông tốt.
Nhưng Artificial Analysis Intelligence Index hữu ích ở đây vì một con số thang đo đơn lẻ từ nhà cung cấp và một con số tổng hợp từ bên thứ ba trung lập không phải cùng một loại bằng chứng, và chúng ta biết Astra thắng chung cuộc, trừ, dĩ nhiên, về giá, nơi nó thua nặng.