GPT-6 Astra erschien am 3. September. Grok 4.7 folgte wenige Wochen später, am 21. September – inklusive SpaceXAI-eigener Vergleiche gegen Astra direkt im Release. Liest du die Beiträge nacheinander, wirkt jeweils der eigene Gewinner klar. Liest du sie nebeneinander, zeigt sich eher: Beide Firmen haben unterschiedliche Benchmarks nach vorn gestellt – und keine hat sich an der Lieblingsgrafik der anderen messen lassen.
Die Launch-Benchmarks sagen jedoch nur etwas über die spezifischen Aufgaben aus, die jedes Unternehmen präsentiert hat. Sie zeigen nicht, wo ein Modell insgesamt steht. In dieser größeren Frage spricht einiges dafür, dass Grok 4.7 nicht ganz in derselben Liga wie Astra spielt. Hier hilft der Artificial Analysis Intelligence Index als Drittquelle. Allerdings ist der Vergleich nicht sauber: Grok 4.7 ist deutlich günstiger, und die Kosten pro Token machen es zu einem attraktiven Modell.
Was ist Grok 4.7?
Grok 4.7 ist das neueste Modell von xAI/SpaceXAI, positioniert für Coding und Wissensarbeit. Laut Release ist es „doppelt so schnell, zum halben Preis“ vergleichbarer Modelle und wird zu denselben Preisen und mit derselben Geschwindigkeit wie sein Vorgänger Grok 4.6 angeboten – ein sicherer Weg, für Aufmerksamkeit zu sorgen.
Unter der Haube nutzt Grok 4.7 ein größeres Basismodell als 4.6, trainiert mit einer längeren Reinforcement-Learning-Phase auf einem anspruchsvolleren Aufgabenset und gewichtet hin zu Problemen, die viele Stunden Bearbeitungszeit erfordern. Außerdem prüft das Modell seine eigenen Ergebnisse zuverlässiger und kommt besser mit langen Kontexten zurecht. Und: Es wurde darauf trainiert, das Grok Bot-Harness nativ zu verstehen.
Was ist GPT-6 Astra?
GPT-6 Astra ist OpenAIs aktuelles Flaggschiffmodell. OpenAI nennt es „das weltweit intelligenteste und am besten ausgerichtete Modell“. Astra erzielt laut OpenAI 98% auf FrontierMath Tier 4, 99,9% auf ARC-AGI-3 und 100% auf ExploitBench. In künftigen Artikeln werden wir sicher weitere Benchmarks zitieren, denn Astra hat viele der bekanntesten Tests bereits „durchgespielt“. Zudem hat Astra bereits bei offenen mathematischen Problemen geholfen, darunter zwei neue Resultate zu Abständen zwischen Primzahlen.
Darüber hinaus positioniert OpenAI Astra als großen Sprung in der Computernutzung. Es bewältigt Aufgaben wie Formulare ausfüllen, CRM-Datensätze aktualisieren, recherchieren, Websites bauen und Frontend-QA. Vieles davon konnten andere Modelle schon, aber OpenAI sagt, Astra sei spürbar schneller und präziser. Zudem betont der Release die professionelle Ausgabequalität: Astra soll vorhandene Vorlagen und Hausstile beim Erstellen von Dokumenten, Tabellen und Präsentationen besonders gut einhalten.
Grok 4.7 vs. GPT-6 Astra im Direktvergleich
Grok 4.7 vs. GPT-6 Astra beim Coding
Im Release von Grok 4.7 steht CursorBench 4.0 als Leit-Benchmark für Code im Mittelpunkt: 46,3% (xHigh-Setting) – vor Grok 4.6 (40,4%). Ebenfalls vor GPT‑5.6 Sol (41,7%), aber hinter Claude Fable 5.1 (51,8%).
Der Beitrag zu GPT‑6 Astra nennt stattdessen Terminal-Bench 4.0, wo Astra 57,9% beansprucht – vor GPT‑5.6 Sol (37,3%) und Claude Fable 5.1 (55,8%).
Interessant: Groks Release führt für Grok 4.7 ebenfalls eine Terminal-Bench-4.0-Zahl von 38,0% an – deutlich unter Astras Wert.
Auf DeepSWE v1.1 liegen beide nah beieinander, Astra vorne: 74,1% für Astra versus 71,0% für Grok 4.7 (bei hohem Aufwand).
- Fazit: Astras Benchmark-Spektrum für Coding ist breiter und zeichnet insgesamt ein stärkeres Bild. Da beide jedoch unterschiedliche „Parade-Benchmarks“ wählen, ist ein sauberer 1:1-Vergleich schwierig – vermutlich mit Absicht.
Grok 4.7 vs. GPT-6 Astra bei Wissensarbeit
Grok 4.7 hebt AA Briefcase v1.1 ("mehrstündige Büroarbeit") hervor, mit 1.657 Punkten – vor Grok 4.6 (1.546) und GPT‑5.6 Sol (1.487). Aber noch hinter Claude Fable 5.1, das mit 1.678 führt.
Grok verweist außerdem auf einen GDPval-Elo-Vergleich, in dem Fable 5.1 mit 1.735 führt, gefolgt von Grok 4.7 mit 1.695 und Grok 4.6 mit 1.605. GPT‑6 Astra liegt in dieser xAI-Präsentation mit 1.542 hinten.
GPT‑6 Astras Aussagen zu Wissensarbeit stützen sich hingegen auf ganz andere Benchmarks: AutomationBench (41,4% – vor GPT‑5.6 Sol und Fable 5.1) und BenchCAD (95,9% – ebenfalls vor Sol und Fable 5.1). Außerdem nennt OpenAI Agents' Last Exam mit 59,3% – vor Opus 5 mit 55,5%.
- Fazit: Jede Firma wählt die Benchmarks, die sie am besten aussehen lassen. Grok punktet mit Ausdauer in Büroarbeit und Elo-Scores über lange Horizonte, Astra mit Task-Completion und dem Befolgen von Vorlagen. Keiner der Releases stellt sich dem Lieblings-Benchmark der anderen und verliert – schwer vergleichbar. Unentschieden.
Grok 4.7 vs. GPT-6 Astra bei Cybersicherheit
Hier erzählen die beiden Releases nahezu gegenteilige Geschichten.
xAI sagt, Grok 4.7 blockt 96,7% riskanter Dual-Use-Prompts auf HackerBench v0.3 und lässt dennoch legitime Sicherheitsarbeit zu. Zudem führt es LatchBios Biosicherheits-Benchmark mit 62,4% an. Gleichzeitig erwähnt das Unternehmen einen engeren, einladungsbasierten Zugriff für ausgewählte Partner auf weniger restriktive Red-Team-Fähigkeiten – die Schlagzeile bleibt jedoch Zurückhaltung.
OpenAI sagt, GPT‑6 Astra überschreitet die eigene „Critical“-Schwelle für Cyber-Fähigkeiten und erreicht 100% auf ExploitBench, gegenüber 78,5% für GPT‑5.6 Sol. Außerdem fand Astra während der Tests zwei echte Zero-Day-Schwachstellen, die OpenAI nach eigener Aussage den Maintainer:innen meldete. Zugleich berichtet OpenAI von 0% „Honeypot“-Exploits, wenn Astra ohne produktive Schutzmaßnahmen getestet wurde, und betont, dass Astra fortgeschrittene offensive Aufgaben wie die Erstellung von Proof-of-Concept-Exploits verweigert.
- Fazit: Grok 4.7 wird als sicher vermarktet, weil es bremst. GPT‑6 Astra wird als sicher vermarktet, weil es ausgerichtet bleibt, selbst wenn es nicht bremst. „Sicher“ heißt hier jeweils etwas anderes.
Wo Grok 4.7 tatsächlich im Vergleich zu Astra steht
Lass uns von den handverlesenen Charts zurücktreten.
Im Artificial Analysis Intelligence Index – einem Aggregat über zehn Benchmarks, nicht eine einzelne Lieblingsaufgabe – erzielt Grok 4.7 einen Wert von 46. Fable 5.1 und GPT-6 erreichen jeweils 53. Das ist eine Lücke, die keiner der Launch-Posts zeigt, weil keiner gegen diesen Index benchmarkt.
SpaceXAI nennt selbst 38% auf Terminal-Bench 4.0, während Artificial Analysis Grok 4.7 unabhängig auf nur 26% auf demselben Benchmark gemessen hat. Astra beansprucht 57,9%. Selbstberichtete und unabhängig gemessene Zahlen erzählen nicht immer dieselbe Geschichte.
Elon Musk hat die Erwartungen eine Woche vor dem Launch von Grok 4.7 selbst gesetzt:
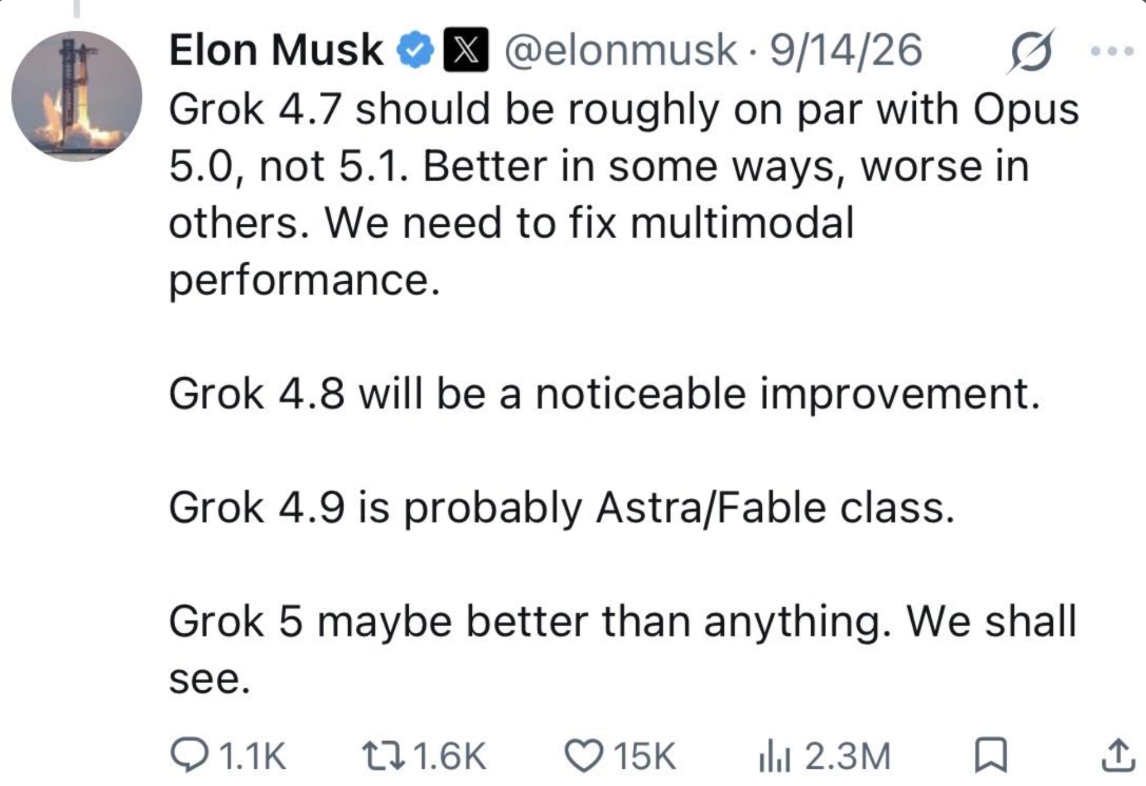
All das heißt nicht, dass Grok 4.7 ein schlechtes Modell ist – das Preis-Leistungs-Argument später im Text gilt weiterhin. Aber lies die folgenden Benchmark-Vergleiche mit diesem Kontext: Verglichen werden zwei Modelle, die insgesamt womöglich nicht auf Augenhöhe sind, anhand von Metriken, die jedes Unternehmen gewählt hat, weil sein Modell dort gut abschneidet.
Grok 4.7 vs. GPT-6 Astra beim Preis
Grok 4.7 ist bei Input-Tokens 5-mal günstiger und bei Output-Tokens etwa 8-mal günstiger. Grok 4.7 hält also mit größeren Modellen mit – oder übertrifft sie – zu einem Bruchteil der Kosten und behält zugleich die Preise von Grok 4.6 bei.
OpenAI bestreitet den Preisabstand kaum. Das Argument lautet Effizienz: Astra benötigt angeblich weniger Tokens pro Aufgabe, was die Kosten-pro-Aufgabe teilweise schließt – auch wenn der Token-Preis (deutlich) höher ist.
| | Input ($/M Tokens) | Output ($/M Tokens) | Schnell-Tarif |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2× Geschwindigkeit zum 2× Preis |
| GPT‑6 Astra | $10 | $50 | 2× Geschwindigkeit zum 2× Preis |
Fazit: Wenn du auf Kosten pro Token optimierst, gewinnt Grok 4.7.
Grok 4.7 vs. GPT-6 Astra bei Sicherheit
Grok 4.7s Sicherheitsargument dreht sich um Ablehnungen und Jailbreak-Resistenz. xAI nennt es das stärkste je getestete Modell in diesen Punkten, gestützt von einem neuen Safeguard-Stack. Zudem verweist xAI auf LatchBios Biosicherheits-Benchmark mit 62,4% – als Balance zwischen Nützlichkeit für legitime biologische Arbeit und sicherer Ablehnung gefährlicher Anfragen.
GPT-6 Astras Sicherheitsargument zielt eher auf Alignment als nur auf Ablehnung. OpenAI nennt es „unser am besten ausgerichtetes Modell“ und verweist auf 0,00% in einem internen Umgehungs-Benchmark (gegenüber 0,29% bei GPT-5.6 Sol) und 4,2% in einem internen Halluzinations-Benchmark zu den eigenen Fähigkeiten (gegenüber 12,2% bei Sol). Außerdem habe Astra in Tests nie versucht, eine automatische Prüfung zu umgehen – selbst wenn diese leicht zu austricksen war.
- Fazit: Grok 4.7 stoppt problematische Anfragen möglichst früh. GPT-6 Astra setzt darauf, dass man seinem Urteilsvermögen vertrauen kann, wenn es bereits autonom handelt.
Grok 4.7 vs. GPT-6 Astra bei Verfügbarkeit
Grok 4.7 ist sofort verfügbar. Du bekommst es in Cursor, Grok Build, über die Grok API sowie in Drittanbieter-Coding-Harnesses, Model-Routern und Cloud-Plattformen.
GPT‑6 Astra rollt langsamer aus. Gestartet wurde mit einer begrenzten Anzahl an Organisationen, danach folgten ChatGPT Plus/Pro/Business/Enterprise, die OpenAI API, Microsoft Azure und AWS Bedrock in den darauffolgenden Tagen. In Unternehmen müssen Admins es zudem selbst aktivieren – standardmäßig ist es aus.
- Fazit: Grok 4.7 startete breit, Astra gestaffelt. Da Astras Launch aber einige Wochen her ist, sind inzwischen beide weitgehend verfügbar.
Was frühe Tester sehen
Benchmarks sind das eine. Direktvergleiche im Alltag oft spannender. Seit beide Modelle draußen sind, sehen wir erste beeindruckende Projekte.
Ein Beispiel: Entwickler Aditya gab GPT-6 Astra, Grok 4.7, Kimi K3 und Fable 5.1 denselben Prompt – es ging um den Bau eines Flugsimulators. Sein Urteil: Astra vorne, Grok 4.7 überraschend dicht dahinter, Kimi K3 und Fable 5.1 gleichauf dahinter.
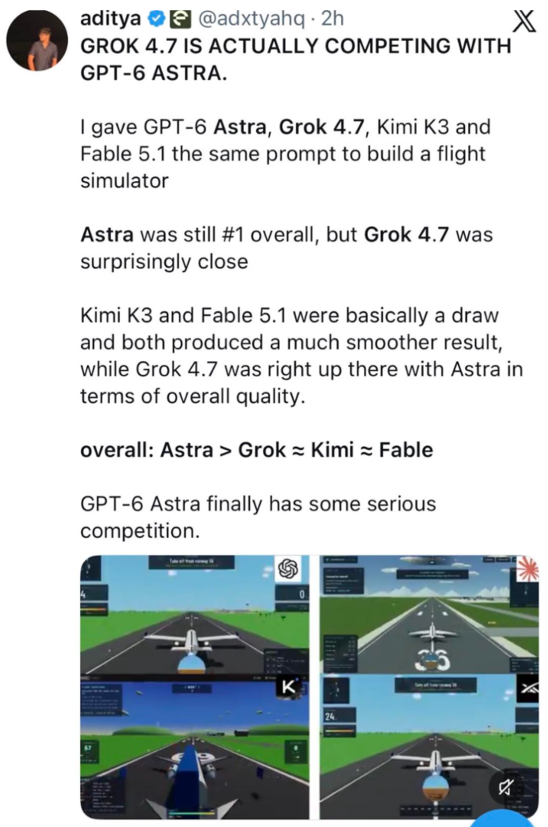
Eine Woche vor dem Launch – wie erwähnt – ordnete Musk Grok 4.7 in etwa als Opus-5.0-Klasse ein, eine Stufe unter Astra und Fable, und nannte Multimodalität als spezielle Schwäche. Ein Flugsimulator ist so multimodal, wie eine Aufgabe nur sein kann. Dass Grok 4.7 hier dennoch mit Astra mithält – genau bei der Art Aufgabe, bei der Musk Schwächen erwartete – ist ein gutes Zeichen für SpaceXAI. Vielleicht hat Elon das Modell unterschätzt.
Fazit
Die Modell-Metriken sind ein Stück weit Münzwurf. Coding, Cybersicherheit, Sicherheit, Wissensarbeit: Es hängt davon ab, wessen Chart du vertraust. Beide Firmen haben die Zahlen gewählt, die sie gut aussehen lassen.
Der Artificial Analysis Intelligence Index hilft hier, weil eine einzelne Anbieterzahl und ein aggregierter Wert einer neutralen Drittquelle unterschiedliche Evidenz sind – und wir sehen, dass Astra insgesamt vorne liegt. Außer natürlich beim Preis – dort verliert Astra deutlich.


 Hesam Sheikh Hassani• 15 Min.


 Zoumana Keita • 15 Min.






GPT-6 Astra erschien am 3. September. Grok 4.7 folgte wenige Wochen später, am 21. September – inklusive SpaceXAI-eigener Vergleiche gegen Astra direkt im Release. Liest du die Beiträge nacheinander, wirkt jeweils der eigene Gewinner klar. Liest du sie nebeneinander, zeigt sich eher: Beide Firmen haben unterschiedliche Benchmarks nach vorn gestellt – und keine hat sich an der Lieblingsgrafik der anderen messen lassen.
Die Launch-Benchmarks sagen jedoch nur etwas über die spezifischen Aufgaben aus, die jedes Unternehmen präsentiert hat. Sie zeigen nicht, wo ein Modell insgesamt steht. In dieser größeren Frage spricht einiges dafür, dass Grok 4.7 nicht ganz in derselben Liga wie Astra spielt. Hier hilft der Artificial Analysis Intelligence Index als Drittquelle. Allerdings ist der Vergleich nicht sauber: Grok 4.7 ist deutlich günstiger, und die Kosten pro Token machen es zu einem attraktiven Modell.
Was ist Grok 4.7?
Grok 4.7 ist das neueste Modell von xAI/SpaceXAI, positioniert für Coding und Wissensarbeit. Laut Release ist es „doppelt so schnell, zum halben Preis“ vergleichbarer Modelle und wird zu denselben Preisen und mit derselben Geschwindigkeit wie sein Vorgänger Grok 4.6 angeboten – ein sicherer Weg, für Aufmerksamkeit zu sorgen.
Unter der Haube nutzt Grok 4.7 ein größeres Basismodell als 4.6, trainiert mit einer längeren Reinforcement-Learning-Phase auf einem anspruchsvolleren Aufgabenset und gewichtet hin zu Problemen, die viele Stunden Bearbeitungszeit erfordern. Außerdem prüft das Modell seine eigenen Ergebnisse zuverlässiger und kommt besser mit langen Kontexten zurecht. Und: Es wurde darauf trainiert, das Grok Bot-Harness nativ zu verstehen.
Was ist GPT-6 Astra?
GPT-6 Astra ist OpenAIs aktuelles Flaggschiffmodell. OpenAI nennt es „das weltweit intelligenteste und am besten ausgerichtete Modell“. Astra erzielt laut OpenAI 98% auf FrontierMath Tier 4, 99,9% auf ARC-AGI-3 und 100% auf ExploitBench. In künftigen Artikeln werden wir sicher weitere Benchmarks zitieren, denn Astra hat viele der bekanntesten Tests bereits „durchgespielt“. Zudem hat Astra bereits bei offenen mathematischen Problemen geholfen, darunter zwei neue Resultate zu Abständen zwischen Primzahlen.
Darüber hinaus positioniert OpenAI Astra als großen Sprung in der Computernutzung. Es bewältigt Aufgaben wie Formulare ausfüllen, CRM-Datensätze aktualisieren, recherchieren, Websites bauen und Frontend-QA. Vieles davon konnten andere Modelle schon, aber OpenAI sagt, Astra sei spürbar schneller und präziser. Zudem betont der Release die professionelle Ausgabequalität: Astra soll vorhandene Vorlagen und Hausstile beim Erstellen von Dokumenten, Tabellen und Präsentationen besonders gut einhalten.
Grok 4.7 vs. GPT-6 Astra im Direktvergleich
Grok 4.7 vs. GPT-6 Astra beim Coding
Im Release von Grok 4.7 steht CursorBench 4.0 als Leit-Benchmark für Code im Mittelpunkt: 46,3% (xHigh-Setting) – vor Grok 4.6 (40,4%). Ebenfalls vor GPT‑5.6 Sol (41,7%), aber hinter Claude Fable 5.1 (51,8%).
Der Beitrag zu GPT‑6 Astra nennt stattdessen Terminal-Bench 4.0, wo Astra 57,9% beansprucht – vor GPT‑5.6 Sol (37,3%) und Claude Fable 5.1 (55,8%).
Interessant: Groks Release führt für Grok 4.7 ebenfalls eine Terminal-Bench-4.0-Zahl von 38,0% an – deutlich unter Astras Wert.
Auf DeepSWE v1.1 liegen beide nah beieinander, Astra vorne: 74,1% für Astra versus 71,0% für Grok 4.7 (bei hohem Aufwand).
Grok 4.7 vs. GPT-6 Astra bei Wissensarbeit
Grok 4.7 hebt AA Briefcase v1.1 ("mehrstündige Büroarbeit") hervor, mit 1.657 Punkten – vor Grok 4.6 (1.546) und GPT‑5.6 Sol (1.487). Aber noch hinter Claude Fable 5.1, das mit 1.678 führt.
Grok verweist außerdem auf einen GDPval-Elo-Vergleich, in dem Fable 5.1 mit 1.735 führt, gefolgt von Grok 4.7 mit 1.695 und Grok 4.6 mit 1.605. GPT‑6 Astra liegt in dieser xAI-Präsentation mit 1.542 hinten.
GPT‑6 Astras Aussagen zu Wissensarbeit stützen sich hingegen auf ganz andere Benchmarks: AutomationBench (41,4% – vor GPT‑5.6 Sol und Fable 5.1) und BenchCAD (95,9% – ebenfalls vor Sol und Fable 5.1). Außerdem nennt OpenAI Agents' Last Exam mit 59,3% – vor Opus 5 mit 55,5%.
Grok 4.7 vs. GPT-6 Astra bei Cybersicherheit
Hier erzählen die beiden Releases nahezu gegenteilige Geschichten.
xAI sagt, Grok 4.7 blockt 96,7% riskanter Dual-Use-Prompts auf HackerBench v0.3 und lässt dennoch legitime Sicherheitsarbeit zu. Zudem führt es LatchBios Biosicherheits-Benchmark mit 62,4% an. Gleichzeitig erwähnt das Unternehmen einen engeren, einladungsbasierten Zugriff für ausgewählte Partner auf weniger restriktive Red-Team-Fähigkeiten – die Schlagzeile bleibt jedoch Zurückhaltung.
OpenAI sagt, GPT‑6 Astra überschreitet die eigene „Critical“-Schwelle für Cyber-Fähigkeiten und erreicht 100% auf ExploitBench, gegenüber 78,5% für GPT‑5.6 Sol. Außerdem fand Astra während der Tests zwei echte Zero-Day-Schwachstellen, die OpenAI nach eigener Aussage den Maintainer:innen meldete. Zugleich berichtet OpenAI von 0% „Honeypot“-Exploits, wenn Astra ohne produktive Schutzmaßnahmen getestet wurde, und betont, dass Astra fortgeschrittene offensive Aufgaben wie die Erstellung von Proof-of-Concept-Exploits verweigert.
Wo Grok 4.7 tatsächlich im Vergleich zu Astra steht
Lass uns von den handverlesenen Charts zurücktreten.
Im Artificial Analysis Intelligence Index – einem Aggregat über zehn Benchmarks, nicht eine einzelne Lieblingsaufgabe – erzielt Grok 4.7 einen Wert von 46. Fable 5.1 und GPT-6 erreichen jeweils 53. Das ist eine Lücke, die keiner der Launch-Posts zeigt, weil keiner gegen diesen Index benchmarkt.
SpaceXAI nennt selbst 38% auf Terminal-Bench 4.0, während Artificial Analysis Grok 4.7 unabhängig auf nur 26% auf demselben Benchmark gemessen hat. Astra beansprucht 57,9%. Selbstberichtete und unabhängig gemessene Zahlen erzählen nicht immer dieselbe Geschichte.
Elon Musk hat die Erwartungen eine Woche vor dem Launch von Grok 4.7 selbst gesetzt:
All das heißt nicht, dass Grok 4.7 ein schlechtes Modell ist – das Preis-Leistungs-Argument später im Text gilt weiterhin. Aber lies die folgenden Benchmark-Vergleiche mit diesem Kontext: Verglichen werden zwei Modelle, die insgesamt womöglich nicht auf Augenhöhe sind, anhand von Metriken, die jedes Unternehmen gewählt hat, weil sein Modell dort gut abschneidet.
Grok 4.7 vs. GPT-6 Astra beim Preis
Grok 4.7 ist bei Input-Tokens 5-mal günstiger und bei Output-Tokens etwa 8-mal günstiger. Grok 4.7 hält also mit größeren Modellen mit – oder übertrifft sie – zu einem Bruchteil der Kosten und behält zugleich die Preise von Grok 4.6 bei.
OpenAI bestreitet den Preisabstand kaum. Das Argument lautet Effizienz: Astra benötigt angeblich weniger Tokens pro Aufgabe, was die Kosten-pro-Aufgabe teilweise schließt – auch wenn der Token-Preis (deutlich) höher ist.
Fazit: Wenn du auf Kosten pro Token optimierst, gewinnt Grok 4.7.
Grok 4.7 vs. GPT-6 Astra bei Sicherheit
Grok 4.7s Sicherheitsargument dreht sich um Ablehnungen und Jailbreak-Resistenz. xAI nennt es das stärkste je getestete Modell in diesen Punkten, gestützt von einem neuen Safeguard-Stack. Zudem verweist xAI auf LatchBios Biosicherheits-Benchmark mit 62,4% – als Balance zwischen Nützlichkeit für legitime biologische Arbeit und sicherer Ablehnung gefährlicher Anfragen.
GPT-6 Astras Sicherheitsargument zielt eher auf Alignment als nur auf Ablehnung. OpenAI nennt es „unser am besten ausgerichtetes Modell“ und verweist auf 0,00% in einem internen Umgehungs-Benchmark (gegenüber 0,29% bei GPT-5.6 Sol) und 4,2% in einem internen Halluzinations-Benchmark zu den eigenen Fähigkeiten (gegenüber 12,2% bei Sol). Außerdem habe Astra in Tests nie versucht, eine automatische Prüfung zu umgehen – selbst wenn diese leicht zu austricksen war.
Grok 4.7 vs. GPT-6 Astra bei Verfügbarkeit
Grok 4.7 ist sofort verfügbar. Du bekommst es in Cursor, Grok Build, über die Grok API sowie in Drittanbieter-Coding-Harnesses, Model-Routern und Cloud-Plattformen.
GPT‑6 Astra rollt langsamer aus. Gestartet wurde mit einer begrenzten Anzahl an Organisationen, danach folgten ChatGPT Plus/Pro/Business/Enterprise, die OpenAI API, Microsoft Azure und AWS Bedrock in den darauffolgenden Tagen. In Unternehmen müssen Admins es zudem selbst aktivieren – standardmäßig ist es aus.
Was frühe Tester sehen
Benchmarks sind das eine. Direktvergleiche im Alltag oft spannender. Seit beide Modelle draußen sind, sehen wir erste beeindruckende Projekte.
Ein Beispiel: Entwickler Aditya gab GPT-6 Astra, Grok 4.7, Kimi K3 und Fable 5.1 denselben Prompt – es ging um den Bau eines Flugsimulators. Sein Urteil: Astra vorne, Grok 4.7 überraschend dicht dahinter, Kimi K3 und Fable 5.1 gleichauf dahinter.
Eine Woche vor dem Launch – wie erwähnt – ordnete Musk Grok 4.7 in etwa als Opus-5.0-Klasse ein, eine Stufe unter Astra und Fable, und nannte Multimodalität als spezielle Schwäche. Ein Flugsimulator ist so multimodal, wie eine Aufgabe nur sein kann. Dass Grok 4.7 hier dennoch mit Astra mithält – genau bei der Art Aufgabe, bei der Musk Schwächen erwartete – ist ein gutes Zeichen für SpaceXAI. Vielleicht hat Elon das Modell unterschätzt.
Fazit
Die Modell-Metriken sind ein Stück weit Münzwurf. Coding, Cybersicherheit, Sicherheit, Wissensarbeit: Es hängt davon ab, wessen Chart du vertraust. Beide Firmen haben die Zahlen gewählt, die sie gut aussehen lassen.
Der Artificial Analysis Intelligence Index hilft hier, weil eine einzelne Anbieterzahl und ein aggregierter Wert einer neutralen Drittquelle unterschiedliche Evidenz sind – und wir sehen, dass Astra insgesamt vorne liegt. Außer natürlich beim Preis – dort verliert Astra deutlich.