
Corso
Comprendere l'intelligenza artificiale
2 ore
427.3K
GPT-6 Astra è stato lanciato il 3 settembre. Grok 4.7 è arrivato qualche settimana dopo, il 21 settembre, con confronti contro Astra inclusi direttamente nel comunicato. Se leggi i due post uno dopo l’altro, penseresti che ciascuno vinca chiaramente. Se li leggi affiancati, è più chiaro cosa sta succedendo: le due aziende hanno scelto benchmark diversi da mettere in evidenza, e nessuna delle due si è misurata contro il grafico preferito dall’altra.
Ma i benchmark dei post di lancio ti dicono solo i compiti specifici che ogni azienda ha scelto di mostrare. Non ti dicono dove si colloca un modello nel complesso. Su questa domanda più ampia, ci sono motivi per pensare che Grok 4.7 non giochi davvero nella stessa fascia di Astra. Qui l’Artificial Analysis Intelligence Index è utile, perché è una terza parte. Detto questo, il confronto non è pulito. Grok 4.7 costa molto meno, e il costo per token lo rende un buon modello.
Grok 4.7 è il nuovo modello di xAI/SpaceXAI, pensato per il coding e il lavoro di conoscenza. Il comunicato lo descrive come "due volte più veloce, alla metà del prezzo" rispetto ai modelli comparabili, e dice che è offerto allo stesso prezzo e alla stessa velocità del suo predecessore, Grok 4.6, il che è un buon modo per generare interesse.
Sotto il cofano, Grok 4.7 usa un modello di base più grande rispetto al 4.6, addestrato con una fase di reinforcement learning più lunga su un mix di compiti più difficili e con peso maggiore su problemi che richiedono molte ore per essere completati. Inoltre, il modello è migliore nel controllare il proprio lavoro e nel gestire contesti più lunghi. Infine, va detto che è stato addestrato per comprendere nativamente l’ambiente Grok Bot.
GPT-6 Astra è l’attuale modello di punta di OpenAI. OpenAI lo definisce "il modello più intelligente e allineato al mondo". OpenAI afferma che Astra totalizza il 98% su FrontierMath Tier 4, il 99,9% su ARC-AGI-3 e il 100% su ExploitBench. Siamo certi che in futuri articoli citeremo altri test di benchmark, perché Astra ha saturato molti dei più noti. Inoltre, Astra ha già contribuito a problemi aperti di matematica, inclusi due nuovi risultati sugli intervalli tra numeri primi.
In più, OpenAI presenta Astra come un grande passo avanti nell’uso del computer. Gestisce compiti come compilare moduli, aggiornare record CRM, fare ricerche, costruire siti web e svolgere QA sul frontend. Altri modelli facevano già tutto questo, ma OpenAI sostiene che Astra sia nettamente più veloce e accurato. Il comunicato sottolinea anche la qualità professionale dell’output, affermando che Astra segue meglio template esistenti e linea editoriale quando produce documenti, fogli di calcolo, presentazioni e simili.
Il lancio di Grok 4.7 mette al centro CursorBench 4.0 come benchmark di riferimento per il coding, dove ottiene il 46,3% (impostazione xHigh), davanti a Grok 4.6 (40,4%). È anche davanti a GPT‑5.6 Sol (41,7%), ma dietro a Claude Fable 5.1 (51,8%).
Il post di GPT‑6 Astra cita invece Terminal-Bench 4.0, dove dichiara il 57,9%, che batte GPT‑5.6 Sol (37,3%) e Claude Fable 5.1 (55,8%).
Curiosamente, il comunicato di Grok riporta anche un valore di 38,0% su Terminal-Bench 4.0 per Grok 4.7, ben al di sotto del punteggio di Astra.
Su DeepSWE v1.1, i due sono vicini, ma Astra è avanti: Astra riporta il 74,1% contro il 71,0% di Grok 4.7 (con alto impegno).
Grok 4.7 mette in evidenza AA Briefcase v1.1 ("lavoro d’ufficio di più ore"), dove ottiene 1.657, davanti a Grok 4.6 (1.546) e GPT‑5.6 Sol (1.487). Ma resta dietro a Claude Fable 5.1, che guida la classifica con 1.678.
Grok cita anche un confronto Elo di GDPval dove Fable 5.1 è in testa con 1.735, seguito da Grok 4.7 a 1.695, poi Grok 4.6 a 1.605. GPT‑6 Astra è ultimo in questo grafico a 1.542, almeno nella presentazione di xAI.
Le affermazioni di GPT‑6 Astra sul lavoro di conoscenza si basano invece su benchmark del tutto diversi: AutomationBench (41,4%, davanti a GPT‑5.6 Sol e Fable 5.1) e BenchCAD (95,9%, di nuovo davanti a Sol e Fable 5.1). Cita anche Agents' Last Exam, dove totalizza il 59,3%, davanti al 55,5% di Opus 5.
Qui i due comunicati raccontano storie quasi opposte.
xAI afferma che Grok 4.7 blocca il 96,7% dei prompt dual-use rischiosi su HackerBench v0.3, consentendo comunque il lavoro di sicurezza legittimo. È anche in testa al benchmark di biosicurezza di LatchBio con il 62,4%. L’azienda menziona l’accesso ristretto, su invito, a capacità di red team meno limitate per partner selezionati, ma la chiave del messaggio è la prudenza.
OpenAI afferma che GPT‑6 Astra supera la propria soglia "Critical" di capacità cyber e riporta un punteggio del 100% su ExploitBench, contro il 78,5% di GPT‑5.6 Sol. Dice anche che Astra ha trovato due vere vulnerabilità zero-day durante i test, che OpenAI afferma di aver divulgato ai maintainer. In parallelo, OpenAI riporta uno 0% di tasso di exploit su "honeypot" quando Astra è stato testato senza protezioni di produzione e afferma che Astra rifiuterà compiti offensivi più avanzati come la creazione di proof-of-concept di exploit.
Facciamo un passo indietro rispetto ai grafici selezionati ad hoc.
Sull’Artificial Analysis Intelligence Index — un aggregato su dieci benchmark, non un singolo compito scelto a mano — Grok 4.7 ottiene 46. Fable 5.1 e GPT-6 ottengono 53. È un gap, e non è qualcosa che i post di lancio ti mostrano, perché nessuno dei due si misura contro quell’indice.
Il comunicato di SpaceXAI dichiara il 38% su Terminal-Bench 4.0, ma Artificial Analysis ha misurato indipendentemente Grok 4.7 al solo 26% sullo stesso benchmark. Astra dichiara il 57,9%. I numeri auto-riferiti e quelli misurati indipendentemente non raccontano sempre la stessa storia.
Lo stesso Elon Musk ha fissato le aspettative una settimana prima del lancio di Grok 4.7:
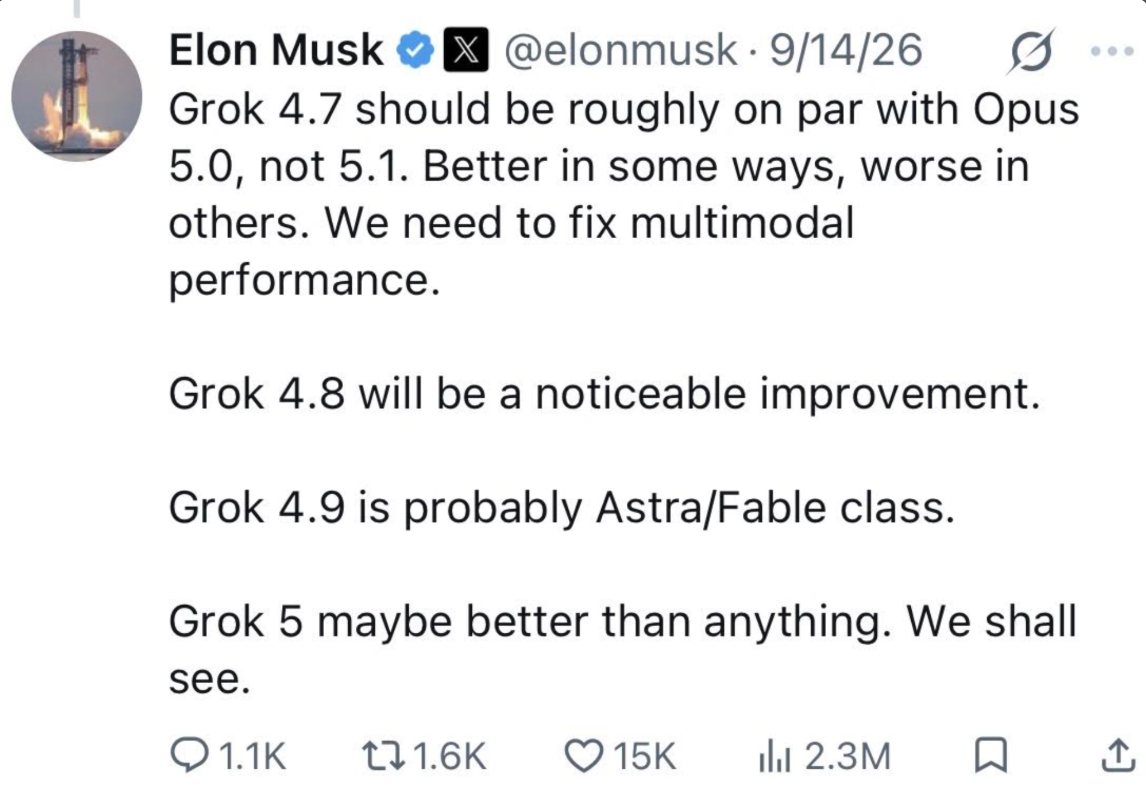
Nulla di tutto questo significa che Grok 4.7 sia un cattivo modello — il rapporto qualità-prezzo che vedremo più avanti resta valido. Ma vale la pena leggere i confronti benchmark per benchmark che seguono tenendo presente questo: stanno confrontando due modelli che forse non sono allo stesso livello nel complesso, usando metriche che ciascuna azienda ha scelto perché il proprio modello ci va forte.
Grok 4.7 costa 5 volte meno sui token in input e circa 8 volte meno sui token in output. Quindi Grok 4.7 eguaglia o batte modelli più grandi a una frazione del costo, mantenendo anche i prezzi invariati rispetto a Grok 4.6.
OpenAI non contesta davvero il divario di prezzo. Ribatte con l’efficienza: a quanto pare Astra necessita di meno token per completare un compito, il che, sostiene, chiude in parte il gap sul costo per compito anche se la tariffa per token è più alta (molto più alta).
| Input ($/M token) | Output ($/M token) | Fascia Fast | |
|---|---|---|---|
| Grok 4.7 (xHigh) | $2 | $6 | Velocità 2x al doppio del prezzo |
| GPT‑6 Astra | $10 | $50 | Velocità 2x al doppio del prezzo |
Conclusione: se stai ottimizzando per costo per token, vince Grok 4.7.
Il messaggio di Grok 4.7 sulla sicurezza è incentrato su rifiuti e resistenza ai jailbreak. xAI lo definisce il modello più forte che abbiano testato su questi fronti, supportato da un nuovo stack di salvaguardie. Cita anche il benchmark di biosicurezza di LatchBio, dove ottiene il 62,4%, presentato come un equilibrio tra utilità per il lavoro biologico legittimo e rifiuto sicuro di richieste pericolose.
Il messaggio di GPT-6 Astra sulla sicurezza riguarda l’allineamento più che i soli rifiuti. OpenAI lo definisce "il nostro modello più allineato", indicando uno 0,00% su un benchmark interno di elusione (contro lo 0,29% di GPT-5.6 Sol) e un tasso del 4,2% su un benchmark interno di allucinazioni sulle proprie capacità (contro il 12,2% di Sol). Aggiunge anche che Astra non ha mai provato ad aggirare una salvaguardia di auto-review nei test, anche quando quella salvaguardia era resa facile da eludere.
Grok 4.7 è disponibile ora. Puoi usarlo in Cursor, Grok Build, nell’API Grok e tramite ambienti di coding di terze parti, router di modelli e piattaforme cloud.
GPT‑6 Astra sta arrivando più lentamente. È partito con un set limitato di organizzazioni, con accesso via ChatGPT Plus/Pro/Business/Enterprise, OpenAI API, Microsoft Azure e AWS Bedrock nei giorni successivi. Gli amministratori Enterprise devono anche attivarlo manualmente, perché è disattivato di default.
I benchmark sono una cosa. Ma i test testa a testa forse sono più interessanti. Ora che entrambi i modelli sono usciti, stiamo iniziando a vedere cose notevoli che le persone stanno creando.
Un esempio: lo sviluppatore Aditya ha dato lo stesso prompt a GPT-6 Astra, Grok 4.7, Kimi K3 e Fable 5.1, su come costruire un simulatore di volo. Il suo verdetto: Astra è arrivato primo in generale, ma Grok 4.7 è stato sorprendentemente vicino, mentre Kimi K3 e Fable 5.1 sono finiti appaiati dietro.
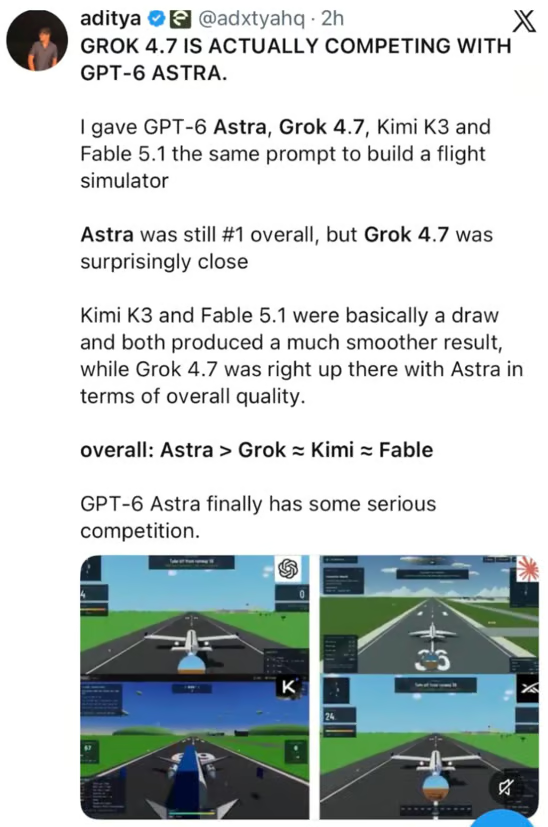
Una settimana prima del lancio, come accennato, Musk aveva collocato Grok 4.7 all’incirca nella classe di Opus 5.0 e un gradino sotto Astra e Fable, indicando anche il multimodale come una debolezza specifica. Un simulatore di volo è uno dei compiti più multimodali che puoi affidare a un modello. Se non altro, il fatto che Grok 4.7 si presenti al livello di Astra proprio sul tipo di compito su cui Musk aveva detto che avrebbe faticato è un buon segnale per SpaceXAI. Forse Elon non ha dato al modello abbastanza credito.
Le metriche del modello sono un po’ una monetina. Coding, cybersecurity, sicurezza, lavoro di conoscenza: dipende da quale grafico ti ispira fiducia. Entrambe le aziende hanno scelto i numeri che le mettevano in buona luce.
Ma l’Artificial Analysis Intelligence Index è utile qui perché un numero di benchmark di un fornitore e un numero aggregato di una terza parte neutrale non sono lo stesso tipo di evidenza, e sappiamo che Astra vince nel complesso, tranne, ovviamente, sul prezzo, dove perde nettamente.
Impara l’AI con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



