GPT-6 Astra 3 Eylül’de piyasaya çıktı. Birkaç hafta sonra, 21 Eylül’de Grok 4.7 geldi; SpaceXAI, sürümde Astra’ya karşı kendi karşılaştırmalarını da paylaştı. Yazıları peş peşe okursanız her birinin net şekilde kazandığını düşünürsünüz. Yan yana okuduğunuzda ise olan biten daha net: iki şirket manşete farklı kıyaslamaları taşıdı ve hiçbiri kendisini diğerinin favori grafiğine göre ölçmedi.
Ancak lansman yazılarındaki kıyaslamalar, yalnızca her şirketin sergilemeyi seçtiği belirli görevler hakkında bilgi verir. Bir modelin genel olarak nerede konumlandığını söylemez. Daha kapsamlı bakıldığında, Grok 4.7’nin aslında Astra ile aynı seviyede oynamadığına dair gerekçeler var. Bu noktada, üçüncü taraf olduğu için Artificial Analysis Intelligence Index işe yarıyor. Yine de karşılaştırma pürüzsüz değil. Grok 4.7 çok daha ucuz ve token başına maliyeti onu iyi bir model yapıyor.
Grok 4.7 Nedir?
Grok 4.7, xAI/SpaceXAI’nin en yeni modeli ve kod yazma ile bilgi işlerine konumlandırılıyor. Sürüm notlarında benzer modellere kıyasla “iki kat hızlı, yarı fiyatına” olduğu ve selefi Grok 4.6 ile aynı fiyat ve hızda sunulduğu belirtiliyor; bu da ilgi çekmenin iyi bir yolu.
Kaputun altında Grok 4.7, 4.6’dan daha büyük bir temel model kullanıyor; daha zorlu görev karmasıyla daha uzun bir pekiştirmeli öğrenme aşamasında eğitilmiş ve tamamlanması saatler süren problemlere ağırlık verilmiş. Ayrıca model, kendi çıktısını denetlemede ve daha uzun bağlamları yönetmede daha iyi. Son olarak, Grok Bot çerçevesini yerel olarak anlaması için eğitildiğini bilmeliyiz.
GPT-6 Astra Nedir?
GPT-6 Astra, OpenAI’ın mevcut amiral gemisi modeli. OpenAI, onu “dünyanın en zeki ve en uyumlu modeli” olarak tanımlıyor. OpenAI’a göre Astra, FrontierMath Tier 4’te %98, ARC-AGI-3’te %99,9 ve ExploitBench’te %100 alıyor. Gelecekte başka kıyaslamalara da atıf yapacağımız kesin, çünkü Astra en bilinen testlerin çoğunu domine etmiş durumda. Ayrıca Astra, asal sayılar arasındaki boşluklara ilişkin iki yeni sonuç da dahil olmak üzere matematikte açık problemler üzerinde de yardımcı oldu.
Bunun da ötesinde, OpenAI Astra’yı bilgisayar kullanımında büyük bir sıçrama olarak konumluyor. Form doldurma, CRM kayıtlarını güncelleme, araştırma yapma, web sitesi kurma ve frontend QA yürütme gibi görevleri üstleniyor. Diğer modeller bunların çoğunu zaten yapıyordu, ancak OpenAI, Astra’nın daha da hızlı ve isabetli olduğunu söylüyor. Sürüm ayrıca profesyonel çıktı kalitesini vurguluyor; Astra’nın belge, hesap tablosu, slayt destesi vb. üretirken mevcut şablonlara ve kurum içi üsluba daha iyi uyduğunu belirtiyor.
Grok 4.7 ve GPT-6 Astra Yüz Yüze Karşılaştırmalar
Grok 4.7 ve GPT-6 Astra: kodlamada
Grok 4.7’nin sürümü, imza kodlama kıyaslaması olarak CursorBench 4.0’a odaklanıyor; burada %46,3 (xHigh ayarı) alıyor ve Grok 4.6’yı (%40,4) geride bırakıyor. GPT‑5.6 Sol’u (%41,7) da geçiyor, ancak Claude Fable 5.1’in (%51,8) gerisinde kalıyor.
GPT‑6 Astra’nın yazısı ise Terminal-Bench 4.0’ı anıyor; burada %57,9 iddia ediyor ve GPT‑5.6 Sol’u (%37,3) ile Claude Fable 5.1’i (%55,8) geçiyor.
İlginç biçimde, Grok’un sürüm notları Grok 4.7 için Terminal-Bench 4.0’da %38,0 sonucu da veriyor; bu da Astra’nın skorunun hayli altında.
DeepSWE v1.1’de iki model yakın, ancak Astra önde: Astra %74,1 raporluyor; Grok 4.7 ise (yüksek çaba seviyesinde) %71,0.
- Özet: Astra’nın kodlama için kullandığı kıyas seti daha geniş ve genel tabloyu daha güçlü gösteriyor, ancak iki şirket farklı amiral kıyaslamaları seçtiği için gerçek bir karşılaştırma yapmak zor. Şirketlerin bunu muhtemelen bilerek yaptığını gözlemliyoruz.
Grok 4.7 ve GPT-6 Astra: bilgi işlerinde
Grok 4.7, AA Briefcase v1.1’i (“çok saatlik ofis işi”) öne çıkarıyor; burada 1.657 puan alıyor ve Grok 4.6’yı (1.546) ile GPT‑5.6 Sol’u (1.487) geride bırakıyor. Ancak bu tabloda zirvede olan 1.678 ile Claude Fable 5.1’in hâlâ gerisinde.
Grok ayrıca GDPval Elo karşılaştırmasına atıf yapıyor: Fable 5.1 1.735 ile lider, ardından Grok 4.7 1.695, sonra Grok 4.6 1.605 geliyor. xAI’ın kendi sunumunda GPT‑6 Astra bu grafikte 1.542 ile son sırada.
GPT‑6 Astra’nın bilgi işi iddiaları ise tamamen farklı kıyaslara dayanıyor: AutomationBench (%41,4; GPT‑5.6 Sol ve Fable 5.1’in önünde) ve BenchCAD (%95,9; yine Sol ve Fable 5.1’in önünde). Ayrıca Agents’ Last Exam’i anıyor; burada %59,3 alıyor ve Opus 5’in %55,5’inin önünde.
- Özet: Her şirket kendisini en çok parlatan kıyasları seçmiş. Grok ofis işi dayanıklılığı ve uzun ufuklu Elo skorlarına yaslanırken, Astra görev tamamlama ve şablon takibi kıyaslarına ağırlık veriyor. Hiçbir sürüm, kendi modelini diğerinin seçtiği kıyasla yarıştırıp kaybetmiyor; kıyaslamak zor. Bunu beraberlik sayalım.
Grok 4.7 ve GPT-6 Astra: siber güvenlikte
İki sürümün neredeyse zıt hikâye anlattığı yer burası.
xAI, Grok 4.7’nin HackerBench v0.3’te riskli çift kullanımlı istemlerin %96,7’sini engellediğini, buna rağmen meşru güvenlik çalışmalarına izin verdiğini söylüyor. LatchBio’nun biyogüvenlik kıyaslamasında da %62,4 ile zirvede. Şirket, seçili iş ortaklarına daha dar kapsamlı, davetle erişilen ve daha az kısıtlı red team yetenekleri sunduğunu belirtiyor; ancak başlık düzeyindeki çerçeve “tedbirli olma”.
OpenAI ise GPT‑6 Astra’nın siber yetkinlikte kendi “Kritik” eşiğini aştığını, ExploitBench’te %100 aldığını (GPT‑5.6 Sol için %78,5) söylüyor. Ayrıca testler sırasında Astra’nın iki gerçek sıfırıncı gün açığı bulduğunu ve bunları sorumlulara bildirdiklerini belirtiyor. Buna paralel olarak, üretim korumaları olmadan test edildiğinde Astra’nın “honeypot” sömürü oranının %0 olduğu ve kanıt-konsept istismar oluşturma gibi daha ileri düzey saldırgan görevleri reddedeceği raporlanıyor.
- Özet: Grok 4.7, frenlediği için “güvenli” olarak pazarlanıyor. GPT‑6 Astra ise frenlemediğinde bile uyumlu davrandığı için “güvenli” olarak pazarlanıyor. “Güvenli”nin her tanıtımda farklı bir anlama geldiğine dikkat etmekte fayda var.
Grok 4.7’nin Astra’ya Göre Gerçekte Nerede Durduğu
Seçmece grafiklerden bir adım geri çekilelim.
Artificial Analysis Intelligence Index’te — tek bir el ile seçilmiş görev değil, on kıyasın birleşiğinde — Grok 4.7, 46 alıyor. Fable 5.1 ve GPT-6 ise 53. Arada bir fark var ve bu farkı, hiçbir şirketin lansman yazısı göstermiyor; çünkü hiçbiri bu endekse göre kıyaslamıyor.
SpaceXAI’nın kendi sürümünde Terminal-Bench 4.0’da %38 iddia ediliyor, ancak Artificial Analysis aynı kıyaslamada Grok 4.7’yi bağımsız olarak sadece %26 ölçtü. Astra %57,9 aldığını iddia ediyor. Öz bildirimli rakamlar ile bağımsız ölçümlerin hikâyeleri her zaman aynı olmuyor.
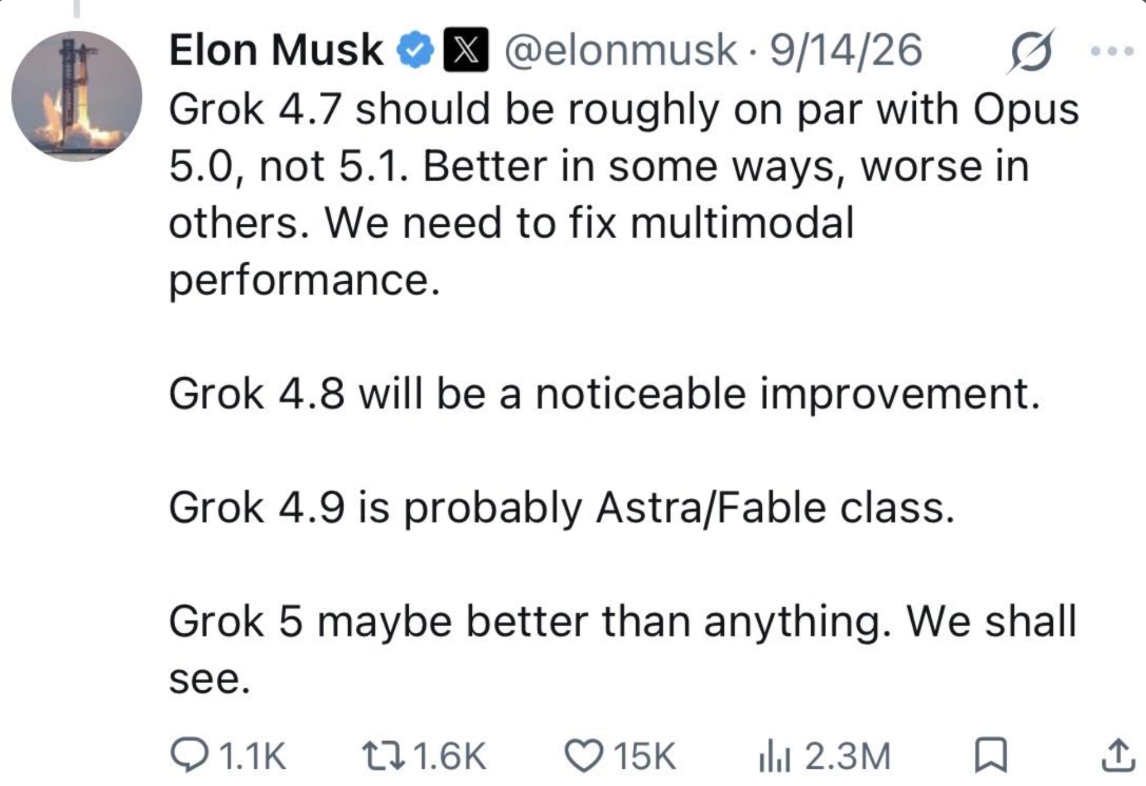
Elon Musk, Grok 4.7 piyasaya çıkmadan bir hafta önce beklentiyi şöyle koydu:
Bunların hiçbiri Grok 4.7’nin kötü bir model olduğu anlamına gelmiyor — aşağıda yer alan fiyat-performans değerlendirmesi hâlâ geçerli. Ancak şu akılda tutularak, takip eden kıyas karşılaştırmalarını okumakta fayda var: Her iki model de genel olarak denk olmayabilir ve şirketler, kendi modellerinin iyi olduğu metrikleri seçti.
Grok 4.7 ve GPT-6 Astra: Fiyat
Girdi token’larında Grok 4.7 5 kat, çıktı token’larında yaklaşık 8 kat daha ucuz. Yani Grok 4.7, daha büyük modellerle başa baş veya daha iyi sonuç verirken maliyetin bir kısmıyla bunu yapıyor ve Grok 4.6’ya kıyasla fiyatlandırmayı sabit tutuyor.
OpenAI fiyat farkını pek tartışmıyor. Verimlilik iddia ediyor: Astra’nın bir görevi tamamlamak için daha az token’a ihtiyaç duyduğu ve token başına ücreti daha yüksek olsa bile (hem de çok daha yüksek) görev başına maliyette farkın bir kısmını kapattığı söyleniyor.
| | Girdi ($/M token) | Çıktı ($/M token) | Hızlı katman |
|---|
| Grok 4.7 (xHigh) | $2 | $6 | 2x hız, 2x fiyat |
| GPT‑6 Astra | $10 | $50 | 2x hız, 2x fiyat |
Özet: Token başına maliyeti optimize ediyorsanız kazanan Grok 4.7.
Grok 4.7 ve GPT-6 Astra: Güvenlik
Grok 4.7’nin güvenlik yaklaşımı, reddetmeler ve jailbreak direncine odaklanıyor. xAI, bu alanlarda test ettikleri en güçlü model olduğunu ve yeni bir koruma yığınıyla desteklendiğini söylüyor. Ayrıca LatchBio’nun biyogüvenlik kıyasını anıyor; burada %62,4 alıyor ve tehlikeli taleplerde güvenli reddetme ile meşru biyolojik çalışmalarda faydalılığı dengeliyor şeklinde çerçeveleniyor.
GPT-6 Astra’nın güvenlik yaklaşımı ise yalnızca reddetmeye değil, hizalanmaya odaklanıyor. OpenAI, onu “şimdiye kadarki en uyumlu modelimiz” olarak tanımlıyor; dahili bir bertaraf etme kıyasında %0,00 (GPT-5.6 Sol için %0,29’a karşı) ve modelin kendi yeteneklerine dair dahili bir halüsinasyon kıyasında %4,2 (Sol için %12,2’ye karşı) skorlarına işaret ediyor. Ayrıca Astra’nın, kaçınmanın kolaylaştırıldığı durumlarda bile testlerde bir otomatik inceleme korumasını atlatmaya hiç teşebbüs etmediğini söylüyor.
- Özet: Grok 4.7, kötü talepleri baştan durdurmaya odaklanıyor. GPT-6 Astra ise model zaten otonom davranırken yargısına güvenmeyi hedefliyor.
Grok 4.7 ve GPT-6 Astra: Erişilebilirlik
Grok 4.7 şu anda kullanılabilir. Cursor, Grok Build, Grok API ve üçüncü taraf kodlama çerçeveleri, model yönlendiricileri ve bulut platformları üzerinden erişebilirsiniz.
GPT‑6 Astra daha yavaş yayılıyor. Sınırlı sayıda kuruluşla başladı; bunu ChatGPT Plus/Pro/Business/Enterprise erişimi, OpenAI API, Microsoft Azure ve AWS Bedrock, takip eden günlerde izledi. Ayrıca kurumsal yöneticilerin kendilerinin etkinleştirmesi gerekiyor; varsayılan olarak kapalı.
- Özet: Grok 4.7 geniş erişimle çıktı, Astra kademeli çıktı. Ancak Astra birkaç hafta önce çıktı; dolayısıyla bugün her ikisi de yaygın şekilde erişilebilir.
Erken Testlerde Görülenler
Kıyaslar bir şeydir. Yüz yüze testler ise belki daha ilgi çekici. İki model de piyasada olduğuna göre, insanların ürettiği güzel örnekler görmeye başladık.
Bir örnek: geliştirici Aditya, GPT-6 Astra, Grok 4.7, Kimi K3 ve Fable 5.1’e aynı istemi verdi; bir uçuş simülatörü inşa etmek. Kararı: Genel olarak Astra zirvede çıktı, ancak Grok 4.7 şaşırtıcı derecede yakındı; Kimi K3 ve Fable 5.1 ise onun gerisinde beraber kaldı.
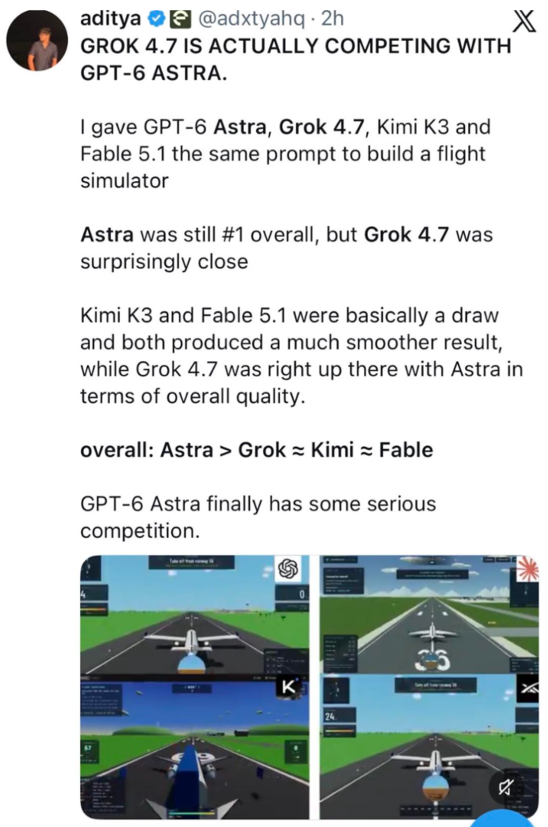
Lansmandan bir hafta önce, az önce de belirttiğim gibi, Musk Grok 4.7’yi kabaca Opus 5.0 sınıfında ve Astra ile Fable’ın bir seviye altında konumlamış, ayrıca çok modluluğu belirgin bir zayıflık olarak işaret etmişti. Bir uçuş simülatörü, bir modele verilebilecek kadar çok modlu bir görevdir. Eğer bir şey varsa, Musk’ın zorlanacağını söylediği türden bir görevde Grok 4.7’nin Astra ile birlikte görünmesi SpaceXAI için iyi bir işaret. Belki de Elon modele yeterince kredi vermedi.
Sonuç
Model metrikleri biraz yazı tura gibi. Kodlama, siber güvenlik, güvenlik, bilgi işleri: Kimin grafiğine güvendiğinize bağlı. İki şirket de kendilerini iyi gösteren rakamları seçti.
Ancak Artificial Analysis Intelligence Index burada faydalı; çünkü bir tedarikçiden gelen tek bir kıyas rakamı ile tarafsız bir üçüncü taraftan gelen birleştirilmiş bir rakam aynı türden kanıtlar değil ve genel olarak Astra’nın kazandığını biliyoruz; tabii fiyat konusunda açık ara kaybettiği yer hariç.



 Abid Ali Awan• 14 dk.

 Dario Radečić• 15 dk.

 Kurtis Pykes • 8 dk.


GPT-6 Astra 3 Eylül’de piyasaya çıktı. Birkaç hafta sonra, 21 Eylül’de Grok 4.7 geldi; SpaceXAI, sürümde Astra’ya karşı kendi karşılaştırmalarını da paylaştı. Yazıları peş peşe okursanız her birinin net şekilde kazandığını düşünürsünüz. Yan yana okuduğunuzda ise olan biten daha net: iki şirket manşete farklı kıyaslamaları taşıdı ve hiçbiri kendisini diğerinin favori grafiğine göre ölçmedi.
Ancak lansman yazılarındaki kıyaslamalar, yalnızca her şirketin sergilemeyi seçtiği belirli görevler hakkında bilgi verir. Bir modelin genel olarak nerede konumlandığını söylemez. Daha kapsamlı bakıldığında, Grok 4.7’nin aslında Astra ile aynı seviyede oynamadığına dair gerekçeler var. Bu noktada, üçüncü taraf olduğu için Artificial Analysis Intelligence Index işe yarıyor. Yine de karşılaştırma pürüzsüz değil. Grok 4.7 çok daha ucuz ve token başına maliyeti onu iyi bir model yapıyor.
Grok 4.7 Nedir?
Grok 4.7, xAI/SpaceXAI’nin en yeni modeli ve kod yazma ile bilgi işlerine konumlandırılıyor. Sürüm notlarında benzer modellere kıyasla “iki kat hızlı, yarı fiyatına” olduğu ve selefi Grok 4.6 ile aynı fiyat ve hızda sunulduğu belirtiliyor; bu da ilgi çekmenin iyi bir yolu.
Kaputun altında Grok 4.7, 4.6’dan daha büyük bir temel model kullanıyor; daha zorlu görev karmasıyla daha uzun bir pekiştirmeli öğrenme aşamasında eğitilmiş ve tamamlanması saatler süren problemlere ağırlık verilmiş. Ayrıca model, kendi çıktısını denetlemede ve daha uzun bağlamları yönetmede daha iyi. Son olarak, Grok Bot çerçevesini yerel olarak anlaması için eğitildiğini bilmeliyiz.
GPT-6 Astra Nedir?
GPT-6 Astra, OpenAI’ın mevcut amiral gemisi modeli. OpenAI, onu “dünyanın en zeki ve en uyumlu modeli” olarak tanımlıyor. OpenAI’a göre Astra, FrontierMath Tier 4’te %98, ARC-AGI-3’te %99,9 ve ExploitBench’te %100 alıyor. Gelecekte başka kıyaslamalara da atıf yapacağımız kesin, çünkü Astra en bilinen testlerin çoğunu domine etmiş durumda. Ayrıca Astra, asal sayılar arasındaki boşluklara ilişkin iki yeni sonuç da dahil olmak üzere matematikte açık problemler üzerinde de yardımcı oldu.
Bunun da ötesinde, OpenAI Astra’yı bilgisayar kullanımında büyük bir sıçrama olarak konumluyor. Form doldurma, CRM kayıtlarını güncelleme, araştırma yapma, web sitesi kurma ve frontend QA yürütme gibi görevleri üstleniyor. Diğer modeller bunların çoğunu zaten yapıyordu, ancak OpenAI, Astra’nın daha da hızlı ve isabetli olduğunu söylüyor. Sürüm ayrıca profesyonel çıktı kalitesini vurguluyor; Astra’nın belge, hesap tablosu, slayt destesi vb. üretirken mevcut şablonlara ve kurum içi üsluba daha iyi uyduğunu belirtiyor.
Grok 4.7 ve GPT-6 Astra Yüz Yüze Karşılaştırmalar
Grok 4.7 ve GPT-6 Astra: kodlamada
Grok 4.7’nin sürümü, imza kodlama kıyaslaması olarak CursorBench 4.0’a odaklanıyor; burada %46,3 (xHigh ayarı) alıyor ve Grok 4.6’yı (%40,4) geride bırakıyor. GPT‑5.6 Sol’u (%41,7) da geçiyor, ancak Claude Fable 5.1’in (%51,8) gerisinde kalıyor.
GPT‑6 Astra’nın yazısı ise Terminal-Bench 4.0’ı anıyor; burada %57,9 iddia ediyor ve GPT‑5.6 Sol’u (%37,3) ile Claude Fable 5.1’i (%55,8) geçiyor.
İlginç biçimde, Grok’un sürüm notları Grok 4.7 için Terminal-Bench 4.0’da %38,0 sonucu da veriyor; bu da Astra’nın skorunun hayli altında.
DeepSWE v1.1’de iki model yakın, ancak Astra önde: Astra %74,1 raporluyor; Grok 4.7 ise (yüksek çaba seviyesinde) %71,0.
Grok 4.7 ve GPT-6 Astra: bilgi işlerinde
Grok 4.7, AA Briefcase v1.1’i (“çok saatlik ofis işi”) öne çıkarıyor; burada 1.657 puan alıyor ve Grok 4.6’yı (1.546) ile GPT‑5.6 Sol’u (1.487) geride bırakıyor. Ancak bu tabloda zirvede olan 1.678 ile Claude Fable 5.1’in hâlâ gerisinde.
Grok ayrıca GDPval Elo karşılaştırmasına atıf yapıyor: Fable 5.1 1.735 ile lider, ardından Grok 4.7 1.695, sonra Grok 4.6 1.605 geliyor. xAI’ın kendi sunumunda GPT‑6 Astra bu grafikte 1.542 ile son sırada.
GPT‑6 Astra’nın bilgi işi iddiaları ise tamamen farklı kıyaslara dayanıyor: AutomationBench (%41,4; GPT‑5.6 Sol ve Fable 5.1’in önünde) ve BenchCAD (%95,9; yine Sol ve Fable 5.1’in önünde). Ayrıca Agents’ Last Exam’i anıyor; burada %59,3 alıyor ve Opus 5’in %55,5’inin önünde.
Grok 4.7 ve GPT-6 Astra: siber güvenlikte
İki sürümün neredeyse zıt hikâye anlattığı yer burası.
xAI, Grok 4.7’nin HackerBench v0.3’te riskli çift kullanımlı istemlerin %96,7’sini engellediğini, buna rağmen meşru güvenlik çalışmalarına izin verdiğini söylüyor. LatchBio’nun biyogüvenlik kıyaslamasında da %62,4 ile zirvede. Şirket, seçili iş ortaklarına daha dar kapsamlı, davetle erişilen ve daha az kısıtlı red team yetenekleri sunduğunu belirtiyor; ancak başlık düzeyindeki çerçeve “tedbirli olma”.
OpenAI ise GPT‑6 Astra’nın siber yetkinlikte kendi “Kritik” eşiğini aştığını, ExploitBench’te %100 aldığını (GPT‑5.6 Sol için %78,5) söylüyor. Ayrıca testler sırasında Astra’nın iki gerçek sıfırıncı gün açığı bulduğunu ve bunları sorumlulara bildirdiklerini belirtiyor. Buna paralel olarak, üretim korumaları olmadan test edildiğinde Astra’nın “honeypot” sömürü oranının %0 olduğu ve kanıt-konsept istismar oluşturma gibi daha ileri düzey saldırgan görevleri reddedeceği raporlanıyor.
Grok 4.7’nin Astra’ya Göre Gerçekte Nerede Durduğu
Seçmece grafiklerden bir adım geri çekilelim.
Artificial Analysis Intelligence Index’te — tek bir el ile seçilmiş görev değil, on kıyasın birleşiğinde — Grok 4.7, 46 alıyor. Fable 5.1 ve GPT-6 ise 53. Arada bir fark var ve bu farkı, hiçbir şirketin lansman yazısı göstermiyor; çünkü hiçbiri bu endekse göre kıyaslamıyor.
SpaceXAI’nın kendi sürümünde Terminal-Bench 4.0’da %38 iddia ediliyor, ancak Artificial Analysis aynı kıyaslamada Grok 4.7’yi bağımsız olarak sadece %26 ölçtü. Astra %57,9 aldığını iddia ediyor. Öz bildirimli rakamlar ile bağımsız ölçümlerin hikâyeleri her zaman aynı olmuyor.
Elon Musk, Grok 4.7 piyasaya çıkmadan bir hafta önce beklentiyi şöyle koydu:
Bunların hiçbiri Grok 4.7’nin kötü bir model olduğu anlamına gelmiyor — aşağıda yer alan fiyat-performans değerlendirmesi hâlâ geçerli. Ancak şu akılda tutularak, takip eden kıyas karşılaştırmalarını okumakta fayda var: Her iki model de genel olarak denk olmayabilir ve şirketler, kendi modellerinin iyi olduğu metrikleri seçti.
Grok 4.7 ve GPT-6 Astra: Fiyat
Girdi token’larında Grok 4.7 5 kat, çıktı token’larında yaklaşık 8 kat daha ucuz. Yani Grok 4.7, daha büyük modellerle başa baş veya daha iyi sonuç verirken maliyetin bir kısmıyla bunu yapıyor ve Grok 4.6’ya kıyasla fiyatlandırmayı sabit tutuyor.
OpenAI fiyat farkını pek tartışmıyor. Verimlilik iddia ediyor: Astra’nın bir görevi tamamlamak için daha az token’a ihtiyaç duyduğu ve token başına ücreti daha yüksek olsa bile (hem de çok daha yüksek) görev başına maliyette farkın bir kısmını kapattığı söyleniyor.
Özet: Token başına maliyeti optimize ediyorsanız kazanan Grok 4.7.
Grok 4.7 ve GPT-6 Astra: Güvenlik
Grok 4.7’nin güvenlik yaklaşımı, reddetmeler ve jailbreak direncine odaklanıyor. xAI, bu alanlarda test ettikleri en güçlü model olduğunu ve yeni bir koruma yığınıyla desteklendiğini söylüyor. Ayrıca LatchBio’nun biyogüvenlik kıyasını anıyor; burada %62,4 alıyor ve tehlikeli taleplerde güvenli reddetme ile meşru biyolojik çalışmalarda faydalılığı dengeliyor şeklinde çerçeveleniyor.
GPT-6 Astra’nın güvenlik yaklaşımı ise yalnızca reddetmeye değil, hizalanmaya odaklanıyor. OpenAI, onu “şimdiye kadarki en uyumlu modelimiz” olarak tanımlıyor; dahili bir bertaraf etme kıyasında %0,00 (GPT-5.6 Sol için %0,29’a karşı) ve modelin kendi yeteneklerine dair dahili bir halüsinasyon kıyasında %4,2 (Sol için %12,2’ye karşı) skorlarına işaret ediyor. Ayrıca Astra’nın, kaçınmanın kolaylaştırıldığı durumlarda bile testlerde bir otomatik inceleme korumasını atlatmaya hiç teşebbüs etmediğini söylüyor.
Grok 4.7 ve GPT-6 Astra: Erişilebilirlik
Grok 4.7 şu anda kullanılabilir. Cursor, Grok Build, Grok API ve üçüncü taraf kodlama çerçeveleri, model yönlendiricileri ve bulut platformları üzerinden erişebilirsiniz.
GPT‑6 Astra daha yavaş yayılıyor. Sınırlı sayıda kuruluşla başladı; bunu ChatGPT Plus/Pro/Business/Enterprise erişimi, OpenAI API, Microsoft Azure ve AWS Bedrock, takip eden günlerde izledi. Ayrıca kurumsal yöneticilerin kendilerinin etkinleştirmesi gerekiyor; varsayılan olarak kapalı.
Erken Testlerde Görülenler
Kıyaslar bir şeydir. Yüz yüze testler ise belki daha ilgi çekici. İki model de piyasada olduğuna göre, insanların ürettiği güzel örnekler görmeye başladık.
Bir örnek: geliştirici Aditya, GPT-6 Astra, Grok 4.7, Kimi K3 ve Fable 5.1’e aynı istemi verdi; bir uçuş simülatörü inşa etmek. Kararı: Genel olarak Astra zirvede çıktı, ancak Grok 4.7 şaşırtıcı derecede yakındı; Kimi K3 ve Fable 5.1 ise onun gerisinde beraber kaldı.
Lansmandan bir hafta önce, az önce de belirttiğim gibi, Musk Grok 4.7’yi kabaca Opus 5.0 sınıfında ve Astra ile Fable’ın bir seviye altında konumlamış, ayrıca çok modluluğu belirgin bir zayıflık olarak işaret etmişti. Bir uçuş simülatörü, bir modele verilebilecek kadar çok modlu bir görevdir. Eğer bir şey varsa, Musk’ın zorlanacağını söylediği türden bir görevde Grok 4.7’nin Astra ile birlikte görünmesi SpaceXAI için iyi bir işaret. Belki de Elon modele yeterince kredi vermedi.
Sonuç
Model metrikleri biraz yazı tura gibi. Kodlama, siber güvenlik, güvenlik, bilgi işleri: Kimin grafiğine güvendiğinize bağlı. İki şirket de kendilerini iyi gösteren rakamları seçti.
Ancak Artificial Analysis Intelligence Index burada faydalı; çünkü bir tedarikçiden gelen tek bir kıyas rakamı ile tarafsız bir üçüncü taraftan gelen birleştirilmiş bir rakam aynı türden kanıtlar değil ve genel olarak Astra’nın kazandığını biliyoruz; tabii fiyat konusunda açık ara kaybettiği yer hariç.