
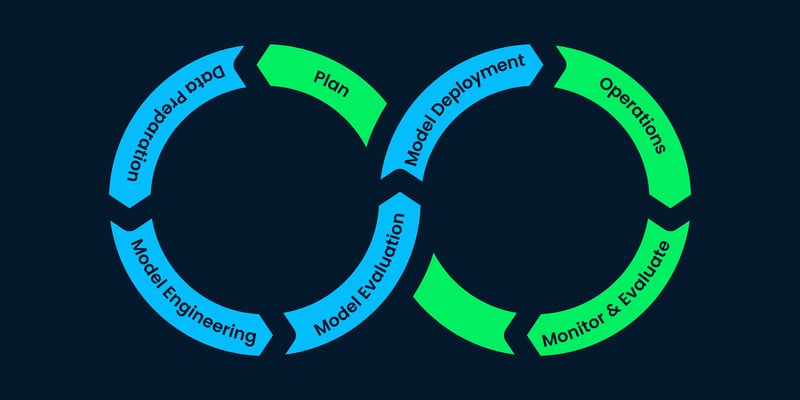
我们通常认为机器学习(ML)项目就是数据处理、模型训练和模型部署。但其实远不止于此。
我们需要业务与数据理解、数据采集技术、数据分析、模型构建和模型评估。此外,在部署之后,还需要持续监控与维护。
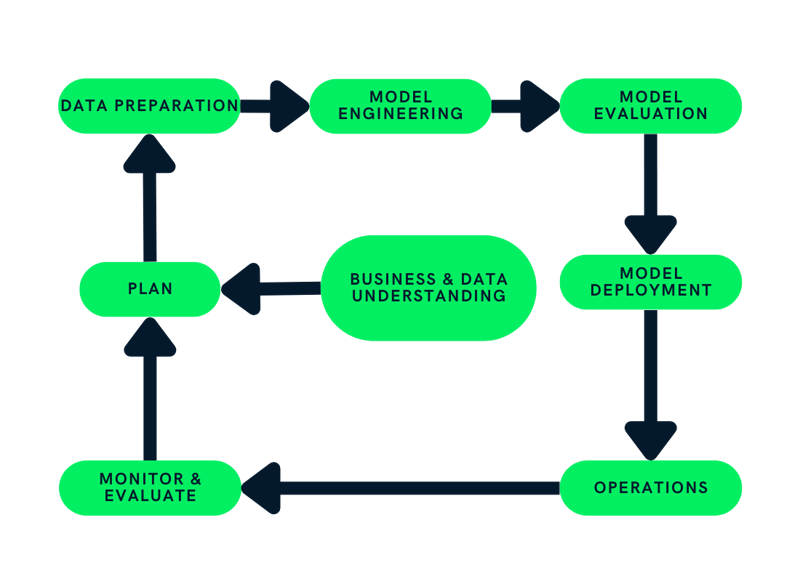
机器学习生命周期由一系列步骤构成,为项目提供结构并有效分配公司的资源。遵循这些步骤有助于企业构建可持续、具成本效益且高质量的 AI 产品。
在本文中,我们将采用跨行业机器学习应用开发与质量保障标准流程(CRISP-ML(Q))来解释机器学习生命周期中的每一步。CRISP-ML(Q) 是构建可持续机器学习应用的行业标准。
标准机器学习生命周期的 6 个步骤:
- 规划
- 数据准备
- 模型工程
- 模型评估
- 模型部署
- 监控与维护
机器学习周期中的每个阶段都遵循质量保障框架,通过严格遵守需求与约束实现持续改进与维护。您可在 CRISP-ML(Q) 博文中进一步了解质量保障。
对于非技术人员和管理者,欢迎查看我们的短课理解机器学习基础课程。这将帮助他们理解通用的机器学习、建模与深度学习(AI)。您也可以在另一篇文章中了解AI 与机器学习的区别。
1. 规划
图片来源:作者
规划阶段涉及评估 ML 应用的范围、成功指标和可行性。您需要理解业务,并了解如何使用机器学习改进当前流程。例如:我们是否一定需要机器学习?是否可以用简单编程实现类似诉求?
您还需要了解成本效益分析,以及如何分阶段交付解决方案。此外,需要为业务、机器学习模型(准确率、F1 分数、AUC)以及经济层面(关键绩效指标)设定明确且可量化的成功指标。
最后,您需要撰写可行性报告。
报告将包含以下信息:
- 数据可用性:我们是否有足够的数据来训练模型?能否持续获得新的、更新的数据?能否使用合成数据来降低成本?
- 适用性:该解决方案能否解决问题或改进现有流程?我们是否真的可以用机器学习来解决这个问题?
- 法律约束:我们是否获得当地政府对实施该方案的许可?我们的数据采集方式是否符合伦理?该应用对社会的影响是什么?
- 鲁棒性与可扩展性:该应用是否足够稳健?是否可扩展?
- 可解释性:我们能否解释机器学习模型得出结果的方式?能否解释深度神经网络的内部机理?
- 资源可用性:我们是否有足够的计算、存储、网络与人力资源?我们是否拥有合格的专业人士?
业务领导者可以通过面向业务的机器学习课程学习机器学习基础知识,并将其应用于制定业务战略与实施 ML 解决方案。
2. 数据准备
 图片来源:作者
数据准备部分进一步分为四个环节:数据获取与标注、清洗、管理与处理。
数据收集与标注
我们首先需要决定如何收集数据:汇集内部数据、使用开源数据、从供应商购买,或生成合成数据。每种方法都有优缺点,在某些情况下,我们会综合使用这四种方法获取数据。
收集完成后,需要对数据进行标注。购买清洗且已标注的数据并非所有公司都负担得起,而且在开发过程中您可能还需要调整数据选择。这也是为什么不能一次性大量购买数据,以及数据最终可能对解决方案失去价值的原因。
数据收集与标注会消耗公司最多的资源:资金、时间、专业人员、领域专家以及法律协议。
数据清洗
接下来,我们通过填补缺失值、分析错误标注、移除离群点、降低噪声来清洗数据。您将创建数据流水线以自动化此过程,并执行数据质量核验。
数据处理
数据处理阶段包括特征选择、处理类别不平衡、特征工程、数据增强,以及对数据进行归一化与缩放。
为确保可复现性,我们将对元数据、数据建模、转换流水线与特征库进行存储与版本化。
数据管理
最后,我们将确定数据存储方案、用于复现的数据版本控制、元数据存储,以及构建 ETL 流水线。此部分将确保为模型训练提供稳定的数据流。
3. 模型工程
图片来源:作者
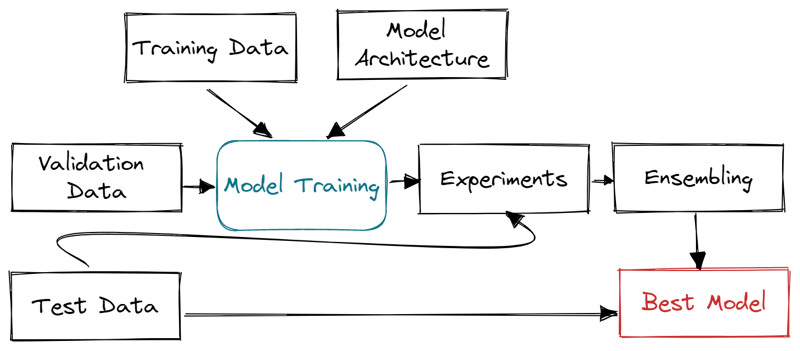
在此阶段,我们将利用规划阶段的全部信息来构建并训练机器学习模型。例如:跟踪模型指标,确保可扩展性与鲁棒性,优化存储与计算资源。
- 通过深入研究构建有效的模型架构。
- 定义模型指标。
- 在训练集与验证集上训练并验证模型。
- 跟踪实验、元数据、特征、代码变更与机器学习流水线。
- 进行模型压缩与集成。
- 结合领域专家知识解释结果。
我们将重点关注模型架构、代码质量、机器学习实验、模型训练与集成。
为保证可复现性,将对特征、超参数、ML 实验、模型架构、开发环境与元数据进行存储与版本化。
通过学习Python 机器学习科学家职业路径,了解模型工程所涉及的具体步骤。它将帮助您掌握成为机器学习工程师所需的关键技能。
4. 模型评估
 图片来源:作者
现在我们已经确定了模型版本,是时候测试各类指标了。为什么?以确保我们的模型可以投入生产。
我们将首先在测试集上测试模型,并确保邀请领域专家参与,以识别预测中的错误。
我们还需要确保在构建 AI 解决方案时遵循行业、伦理与法律框架。
此外,我们将使用随机与真实世界数据测试模型的鲁棒性,确保模型推断速度足够快,能够带来价值。
最后,我们将把结果与既定的成功指标进行比较,并决定是否部署模型。在此阶段,每个过程都会被记录与版本化,以保持质量与可复现性。
5. 模型部署
 图片来源:作者
在此阶段,我们将机器学习模型部署到现有系统中。例如:基于产品形状的自动仓库贴标。我们会将计算机视觉模型部署到当前系统中,利用摄像头图像来打印标签。
一般而言,模型可以部署到云端与本地服务器、网页浏览器、打包为软件,或边缘设备。之后,您可以通过 API、Web 应用、插件或仪表板来获取预测结果。
在部署过程中,我们会定义推理所需的硬件。需要确保具备足够的内存、存储与算力,以便快速产出结果。随后,我们将通过 A/B 测试在生产环境中评估模型表现,确保用户可接受性。
部署策略至关重要。您需要确保变更平滑无缝,并确实改善了用户体验。此外,项目经理应制定灾难管理计划,其中应包括回退策略、持续监控、异常检测以及损失最小化。
6. 监控与维护
 图片来源:作者
将模型部署到生产后,我们需要持续监控并改进系统。我们将监控模型指标、软硬件性能以及客户满意度。
监控将实现全自动化,并在出现异常、模型与系统性能下降以及不良客户评价时通知相关专业人员。
在收到性能下降警报后,我们将评估问题,并尝试用新数据训练模型或调整模型架构。这是一个持续的过程。
在少数情况下,我们需要重塑整个机器学习生命周期,以改进数据处理与模型训练技术,更新软硬件,并引入新的持续集成框架。
结语
多数高校中的数据科学学生只学习数据处理、模型构建与训练,少数情况下涉及部署。他们鲜少接触标准的工业质量保障实践、数据收集与标注技术、机器学习流水线、数据版本控制、ML 实验跟踪以及持续监控与维护。
 图片来源:作者
即使您是数据科学从业者,也需要了解五大科技公司如何为数十亿用户构建可持续的机器学习应用。您也可以学习用 Python 设计机器学习工作流,以构建经得起时间考验的流水线。课程将讲解标准工作流、人工参与流程、模型全生命周期管理以及无监督工作流。
本文中,我们学习了基于需求与约束的机器学习项目规划、数据收集与标注、模型工程、模型评估、模型部署,以及监控与维护。除此之外,我们还了解了在失败情况下如何通过多种方式保持质量、复现实验结果并对流程进行调试。