
Cursus
Machine Learning voor Business
2 uur
47.9K
Oefen en volg je voortgang.
Ga Verder Met Google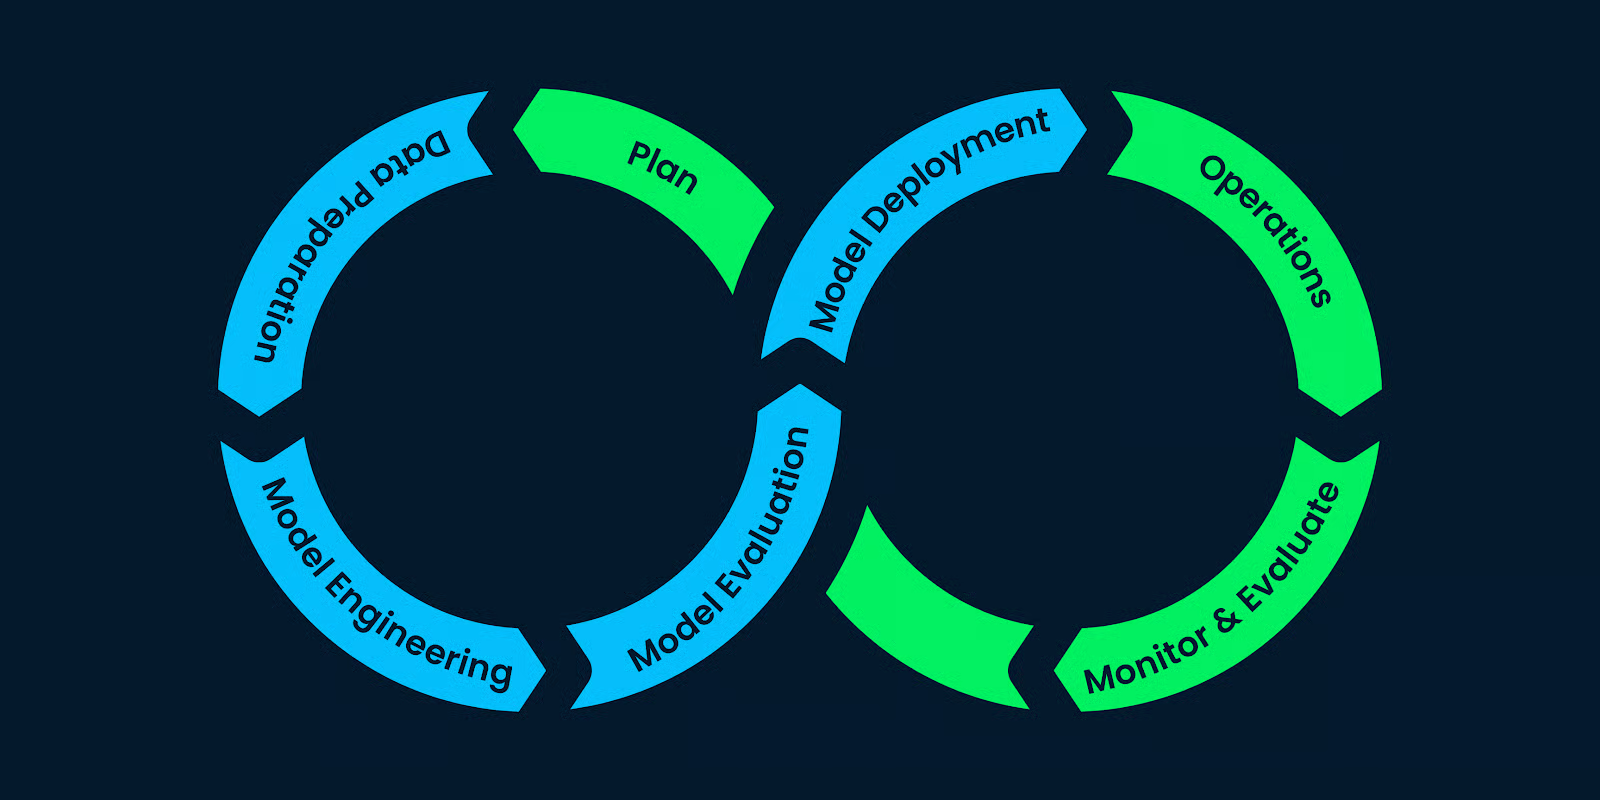
We denken bij machinelearningprojecten vaak aan dataverwerking, modeltraining en modelimplementatie. Maar het is zoveel meer dan dat.
Je hebt begrip van de business en de data nodig, technieken voor dataverzameling, data-analyse, modelbouw en modelevaluatie. En na de uitrol is voortdurende monitoring en onderhoud nodig.
De levenscyclus van machine learning bestaat uit stappen die structuur geven aan het project en de middelen van het bedrijf effectief verdelen. Door deze stappen te volgen, bouwen bedrijven duurzame, kosteneffectieve AI-producten van hoge kwaliteit.
In deze post gebruiken we de Cross-Industry Standard Process for the development of Machine Learning applications with Quality assurance methodology (CRISP-ML(Q)) om elke stap in de machinelearning-levenscyclus uit te leggen. CRISP-ML(Q) is een industriestandaard voor het bouwen van duurzame machinelearningtoepassingen.
Elke fase in de machinelearningcyclus volgt een kader voor kwaliteitsborging voor voortdurende verbetering en onderhoud door eisen en beperkingen strikt te volgen. Leer meer over kwaliteitsborging in de CRISP-ML(Q)-blog.
Voor niet-technische lezers en managers: bekijk onze korte cursus Understanding Machine Learning over de basis. Die helpt je machine learning in het algemeen, modelleren en deep learning (AI) te begrijpen. Je kunt ook in een apart artikel de verschillen tussen AI en machine learning verkennen.

Afbeelding door de auteur
De planningsfase omvat het beoordelen van de scope, succesmetrics en haalbaarheid van de ML-toepassing. Je moet de business begrijpen en hoe je machine learning kunt inzetten om het huidige proces te verbeteren. Bijvoorbeeld: hebben we machine learning nodig? Kunnen we vergelijkbare doelen bereiken met eenvoudige programmering?
Je moet ook de kosten-batenanalyse begrijpen en hoe je de oplossing in meerdere fasen levert. Verder moet je duidelijke en meetbare succesmetrics definiëren voor de business, machinelearningmodellen (accuracy, F1-score, AUC) en economisch (kritieke prestatie-indicatoren).
Tot slot maak je een haalbaarheidsrapport.
Dat bevat informatie over:
Leidinggevenden kunnen de basis van machine learning leren met de cursus Machine Learning for Business en die lessen toepassen om bedrijfsstrategieën te ontwikkelen en ML-oplossingen te implementeren.
 Afbeelding door de auteur
De sectie datavoorbereiding is onderverdeeld in vier delen: dataverwerving en -labeling, opschonen, beheer en verwerking.
We beslissen eerst hoe we data verzamelen: interne data bundelen, open source, inkopen bij leveranciers of synthetische data genereren. Elke methode heeft voor- en nadelen, en in sommige gevallen gebruiken we data uit alle vier de methoden.
Na het verzamelen moeten we de data labelen. Voor alle bedrijven is het niet haalbaar om opgeschoonde en gelabelde data te kopen, en tijdens de ontwikkeling moet je mogelijk ook de dataselectie aanpassen. Daarom kun je die niet in bulk inkopen en kan de data uiteindelijk nutteloos blijken voor de oplossing.
Dataverzameling en -labeling vereisen het grootste deel van de bedrijfsmiddelen: geld, tijd, professionals, domeinexperts en juridische overeenkomsten.
Vervolgens schonen we de data op door ontbrekende waarden te imputeren, verkeerd gelabelde data te analyseren, uitschieters te verwijderen en ruis te verminderen. Je bouwt een datapijplijn om dit te automatiseren en voert datakwaliteitscontroles uit.
De fase dataverwerking omvat featureselectie, omgaan met ongebalanceerde klassen, feature engineering, data-augmentatie en het normaliseren en schalen van de data.
Voor reproduceerbaarheid slaan we de metadata, datamodellering, transformatiepijplijnen en feature stores op en versies we die.
Tot slot bepalen we oplossingen voor dataopslag, dataversiebeheer voor reproduceerbaarheid, het opslaan van metadata en het bouwen van ETL-pijplijnen. Dit deel zorgt voor een constante datastroom voor modeltraining.

Afbeelding door de auteur
In deze fase gebruiken we alle informatie uit de planningsfase om een machinelearningmodel te bouwen en te trainen. Bijvoorbeeld: modelmetrics bijhouden, schaalbaarheid en robuustheid waarborgen, en opslag- en rekenmiddelen optimaliseren.
We focussen op modelarchitectuur, codekwaliteit, ML-experimenten, modeltraining en ensembling.
De features, hyperparameters, ML-experimenten, modelarchitectuur, ontwikkelomgeving en metadata worden opgeslagen en versiebeheerd voor reproduceerbaarheid.
Leer over de stappen in modelengineering via de career track Machine Learning Scientist with Python. Die helpt je de nodige skills te beheersen om een baan als machine learning engineer te krijgen.
 Afbeelding door de auteur
Nu we de modelversie hebben afgerond, is het tijd om verschillende metrics te testen. Waarom? Zodat we zeker weten dat ons model klaar is voor productie.
We testen ons model eerst op een testset en zorgen dat we domeinexperts betrekken om fouten in de voorspellingen te identificeren.
We moeten er ook voor zorgen dat we industriële, ethische en juridische kaders volgen bij het bouwen van AI-oplossingen.
Verder testen we ons model op robuustheid met willekeurige en real-world data. We zorgen dat het model snel genoeg inferenties doet om waarde te leveren.
Tot slot vergelijken we de resultaten met de geplande succesmetrics en beslissen we of we het model uitrollen of niet. In deze fase wordt elk proces vastgelegd en van versies voorzien om kwaliteit en reproduceerbaarheid te borgen.
 Afbeelding door de auteur
In deze fase implementeren we machinelearningmodellen in het huidige systeem. Bijvoorbeeld: automatische magazijnlabeling introduceren op basis van de vorm van het product. We rollen dan een computer vision-model uit in het bestaande systeem, dat de beelden van de camera gebruikt om labels te printen.
Modellen kunnen doorgaans worden geïmplementeerd in de cloud en op een lokale server, in de webbrowser, verpakt als software en op een edge device. Daarna kun je via een API, webapp, plug-ins of dashboard de voorspellingen benaderen.
In het implementatieproces definiëren we de hardware voor inferentie. We moeten zorgen voor voldoende RAM, opslag en rekenkracht om snel resultaten te leveren. Daarna evalueren we de modelprestatie in productie met A/B-tests, om gebruikersacceptatie te borgen.
De implementatiestrategie is belangrijk. Je moet zorgen dat de wijzigingen naadloos zijn en de gebruikerservaring verbeteren. Bovendien moet een projectmanager een rampenplan voorbereiden. Dat omvat een fallbackstrategie, continue monitoring, anomaliëdetectie en het minimaliseren van verliezen.
 Afbeelding door de auteur
Nadat het model in productie is gezet, moeten we het systeem continu monitoren en verbeteren. We houden modelmetrics, hardware- en softwareprestaties en klanttevredenheid in de gaten.
De monitoring is volledig geautomatiseerd, en professionals worden gewaarschuwd bij anomalieën, verminderde model- en systeemprestaties en slechte klantreviews.
Nadat we een waarschuwing over verminderde prestaties krijgen, beoordelen we de problemen en proberen we het model te trainen op nieuwe data of wijzigingen in de modelarchitecturen door te voeren. Het is een continu proces.
In zeldzame gevallen moeten we de volledige machinelearning-levenscyclus vernieuwen om dataverwerking en modeltraining te verbeteren, nieuwe software en hardware te updaten en een nieuw framework voor continue integratie te introduceren.
De data science-student leert aan de meeste universiteiten alleen over dataverwerking, modelbouw en -training, en in sommige gevallen implementatie. Ze leren niet over standaard industriële praktijken voor kwaliteitsborging, technieken voor dataverzameling en -labeling, machinelearningpijplijnen, dataversiebeheer, het bijhouden van ML-experimenten, en constante monitoring en onderhoud.
 Afbeelding door de auteur
Ook als je data science-professional bent, is het belangrijk te leren hoe de vijf grote techbedrijven duurzame machinelearningtoepassingen bouwen voor miljarden klanten. Je kunt ook Designing Machine Learning Workflows in Python volgen om pijplijnen te bouwen die de tand des tijds doorstaan. Je leert een standaard workflow, human-in-the-loop-processen, model lifecycle management en een unsupervised workflow.
In dit artikel hebben we geleerd over projectplanning op basis van eisen en beperkingen, dataverzameling en -labeling, modelengineering, modelevaluatie, modelimplementatie en monitoring en onderhoud. Daarnaast hebben we verschillende manieren gezien om kwaliteit te borgen, resultaten te reproduceren en het proces te debuggen bij falen.
Machine Learning-cursussen
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

