{count, plural, one {Corso} other {Corsi}}
Machine Learning per il business
{hours} ore
47.8K
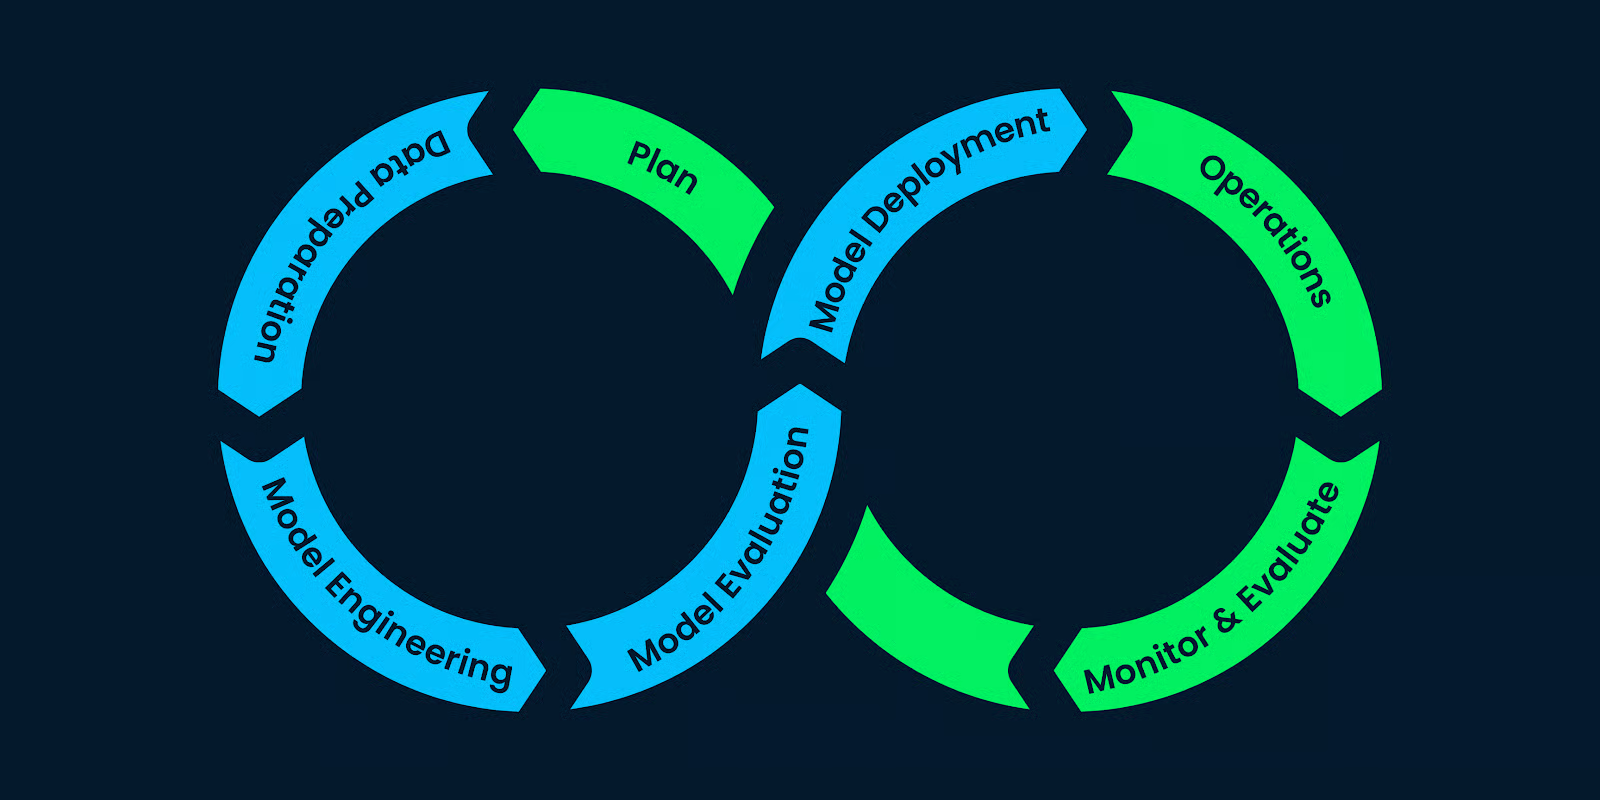
Di solito pensiamo che i progetti di machine learning (ML) riguardino l’elaborazione dei dati, l’addestramento del modello e il deployment. Ma c’è molto di più.
Servono comprensione del business e dei dati, tecniche di raccolta, analisi dei dati, costruzione dei modelli e valutazione dei modelli. Inoltre, dopo il deployment, sono necessari monitoraggio e manutenzione costanti.
Il ciclo di vita del machine learning è composto da passaggi che danno struttura al progetto e consentono di distribuire in modo efficace le risorse dell’azienda. Seguire questi passaggi aiuta a creare prodotti di AI sostenibili, convenienti e di qualità.
In questo post useremo la metodologia Cross-Industry Standard Process for the development of Machine Learning applications with Quality assurance (CRISP-ML(Q)) per spiegare ogni fase del ciclo di vita del machine learning. CRISP-ML(Q) è uno standard industriale per costruire applicazioni di machine learning sostenibili.
Ogni fase del ciclo di ML segue un framework di assicurazione qualità per il miglioramento e la manutenzione continui, rispettando rigorosamente requisiti e vincoli. Scopri di più sull’assicurazione qualità leggendo il blog CRISP-ML(Q).
Per chi non è tecnico e per i manager, dai un’occhiata al nostro corso breve su Understanding Machine Learning fondamentali. Li aiuterà a comprendere il machine learning in generale, il modeling e il deep learning (AI). Puoi anche approfondire le differenze tra AI e machine learning in un articolo dedicato.

Immagine dell’autore
La fase di pianificazione comprende la valutazione dell’ambito, delle metriche di successo e della fattibilità dell’applicazione ML. Devi comprendere il business e come usare il machine learning per migliorare il processo attuale. Ad esempio: ci serve davvero il machine learning? Possiamo ottenere risultati simili con una semplice programmazione?
Devi anche capire l’analisi costi-benefici e come distribuirai la soluzione in più fasi. Inoltre, devi definire metriche di successo chiare e misurabili per il business, per i modelli di machine learning (Accuracy, F1 score, AUC) e per l’economia (indicatori chiave di performance).
Infine, devi redigere un rapporto di fattibilità.
Conterrà informazioni su:
I leader aziendali possono apprendere le basi del machine learning seguendo il corso Machine Learning for Business e applicare queste nozioni per creare strategie e implementare soluzioni ML.
 Immagine dell’autore
La sezione di preparazione dei dati è ulteriormente suddivisa in quattro parti: approvvigionamento e labeling dei dati, pulizia, gestione ed elaborazione.
Per prima cosa dobbiamo decidere come raccogliere i dati: aggregando dati interni, open source, acquistandoli da fornitori o generando dati sintetici. Ogni metodo ha pro e contro e, in alcuni casi, i dati provengono da tutte e quattro le metodologie.
Dopo la raccolta, dobbiamo etichettare i dati. Comprare dati puliti e già etichettati non è fattibile per tutte le aziende, e potresti anche dover modificare la selezione dei dati durante lo sviluppo. Per questo non puoi acquistarli in blocco e per cui i dati potrebbero rivelarsi inutili per la soluzione.
La raccolta e il labeling dei dati richiedono la maggior parte delle risorse aziendali: denaro, tempo, professionisti, esperti di dominio e accordi legali.
Successivamente puliremo i dati imputando i valori mancanti, analizzando le etichette errate, rimuovendo gli outlier e riducendo il rumore. Creerai una pipeline dati per automatizzare questo processo ed eseguire la verifica della qualità dei dati.
La fase di elaborazione dei dati include selezione delle feature, gestione delle classi sbilanciate, feature engineering, data augmentation e normalizzazione e scalatura dei dati.
Per la riproducibilità, archivieremo e versioneremo i metadati, il data modeling, le pipeline di trasformazione e i feature store.
Infine, definiremo le soluzioni di archiviazione, il versioning dei dati per la riproducibilità, l’archiviazione dei metadati e la creazione di pipeline ETL. Questa parte garantirà un flusso costante di dati per l’addestramento del modello.

Immagine dell’autore
In questa fase useremo tutte le informazioni della pianificazione per costruire e addestrare un modello di machine learning. Ad esempio: tracciare le metriche del modello, garantire scalabilità e robustezza e ottimizzare risorse di storage e calcolo.
Ci concentreremo su architettura del modello, qualità del codice, esperimenti di ML, training del modello ed ensembling.
Feature, iperparametri, esperimenti di ML, architettura del modello, ambiente di sviluppo e metadati vengono archiviati e versionati per la riproducibilità.
Scopri le fasi dell’ingegneria dei modelli seguendo il career track Machine Learning Scientist with Python. Ti aiuterà a padroneggiare le competenze necessarie per trovare lavoro come machine learning engineer.
 Immagine dell’autore
Ora che abbiamo finalizzato la versione del modello, è il momento di testare varie metriche. Perché? Per assicurarci che il modello sia pronto per la produzione.
Per prima cosa testeremo il modello su un dataset di test e ci assicureremo di coinvolgere esperti di dominio per identificare gli errori nelle previsioni.
Dobbiamo anche garantire il rispetto dei framework industriali, etici e legali nella costruzione di soluzioni di AI.
Inoltre, testeremo la robustezza del modello con dati casuali e del mondo reale, assicurandoci che le inferenze siano abbastanza rapide da generare valore.
Infine, confronteremo i risultati con le metriche di successo pianificate e decideremo se effettuare o meno il deployment del modello. In questa fase, ogni processo viene registrato e versionato per mantenere qualità e riproducibilità.
 Immagine dell’autore
In questa fase distribuiamo i modelli di machine learning nel sistema esistente. Per esempio: introdurre l’etichettatura automatica in magazzino usando la forma del prodotto. Distribuiremo un modello di computer vision nel sistema attuale, che userà le immagini della telecamera per stampare le etichette.
In generale, i modelli possono essere distribuiti su cloud e server locali, browser web, pacchettizzati come software e su dispositivi edge. Dopodiché puoi usare API, web app, plugin o dashboard per accedere alle previsioni.
Nel processo di deployment definiamo l’hardware di inferenza. Dobbiamo assicurarci di avere RAM, storage e potenza di calcolo sufficienti per produrre risultati rapidi. Successivamente valuteremo le prestazioni del modello in produzione con A/B test, garantendo l’accettazione da parte degli utenti.
La strategia di deployment è importante. Devi assicurarti che i cambiamenti siano senza soluzione di continuità e che migliorino l’esperienza utente. Inoltre, un project manager dovrebbe preparare un piano di gestione delle emergenze. Dovrebbe includere una strategia di fallback, monitoraggio continuo, rilevamento delle anomalie e minimizzazione delle perdite.
 Immagine dell’autore
Dopo aver distribuito il modello in produzione dobbiamo monitorare e migliorare costantemente il sistema. Controlleremo le metriche del modello, le prestazioni hardware e software e la soddisfazione dei clienti.
Il monitoraggio è completamente automatizzato e i professionisti vengono avvisati in caso di anomalie, calo delle prestazioni del modello e del sistema e recensioni negative dei clienti.
Dopo un alert di calo prestazionale, valuteremo i problemi e proveremo ad addestrare il modello su nuovi dati o a modificare le architetture. È un processo continuo.
In rari casi, dobbiamo rinnovare l’intero ciclo di vita del machine learning per migliorare l’elaborazione dei dati e le tecniche di training del modello, aggiornare software e hardware e introdurre un nuovo framework per l’integrazione continua.
Gli studenti di data science nella maggior parte delle università imparano solo l’elaborazione dei dati, la costruzione e l’addestramento dei modelli e, in alcuni casi, il deployment. Non vengono istruiti sulle pratiche standard di assicurazione qualità industriale, sulle tecniche di raccolta ed etichettatura dei dati, sulle pipeline di ML, sul versioning dei dati, sul tracciamento degli esperimenti di ML e sul monitoraggio e la manutenzione continui.
 Immagine dell’autore
Anche se sei un professionista della data science, devi imparare come le cinque grandi aziende tech costruiscono applicazioni di machine learning sostenibili per miliardi di clienti. Puoi anche imparare Designing Machine Learning Workflows in Python per creare pipeline che resistono alla prova del tempo. Imparerai workflow standard, processi human-in-the-loop, gestione del ciclo di vita del modello e workflow non supervisionato.
In questo articolo abbiamo visto la pianificazione dei progetti di ML basata su requisiti e vincoli, la raccolta e l’etichettatura dei dati, l’ingegneria del modello, la valutazione, il deployment e il monitoraggio e la manutenzione. Inoltre, abbiamo esplorato vari modi per mantenere la qualità, riprodurre i risultati e fare debug del processo in caso di problemi.
Corsi di Machine Learning
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



