
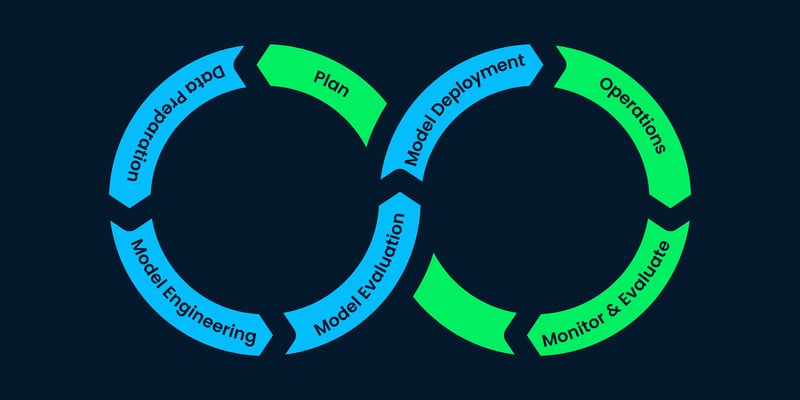
Chúng ta thường nghĩ rằng các dự án machine learning (ML) chỉ liên quan đến xử lý dữ liệu, huấn luyện mô hình và triển khai mô hình. Nhưng thực tế còn nhiều hơn thế.
Chúng ta cần hiểu biết về kinh doanh và dữ liệu, kỹ thuật thu thập dữ liệu, phân tích dữ liệu, xây dựng và đánh giá mô hình. Hơn nữa, sau khi triển khai, chúng ta cần giám sát và bảo trì liên tục.
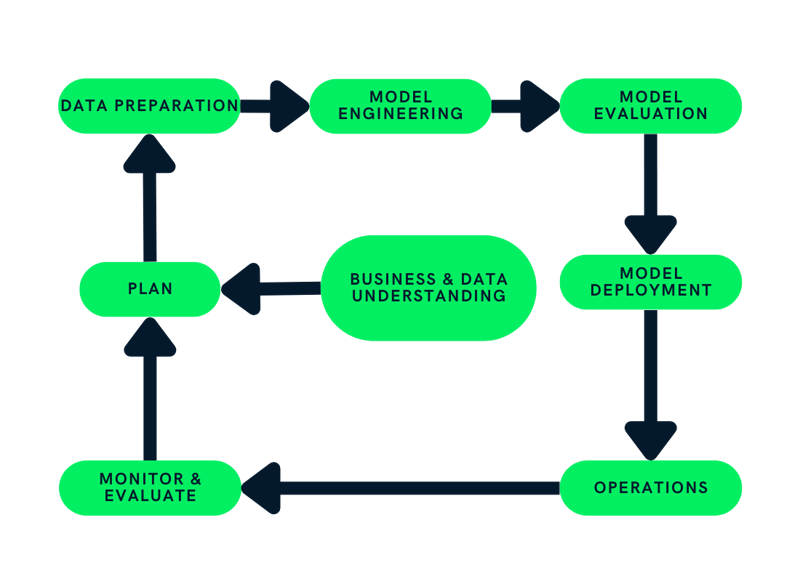
Vòng đời machine learning bao gồm các bước mang lại cấu trúc cho dự án ML và phân bổ hiệu quả nguồn lực của công ty. Tuân thủ các bước này giúp doanh nghiệp xây dựng các sản phẩm AI bền vững, tiết kiệm chi phí và chất lượng.
Trong bài viết này, chúng tôi sẽ sử dụng phương pháp Chuẩn Quy trình Liên ngành để phát triển các ứng dụng Machine Learning với phương pháp đảm bảo chất lượng (CRISP-ML(Q)) để giải thích từng bước trong vòng đời machine learning. CRISP-ML(Q) là một tiêu chuẩn công nghiệp để xây dựng các ứng dụng ML bền vững.
6 bước trong một vòng đời machine learning tiêu chuẩn:
- Lập kế hoạch
- Chuẩn bị dữ liệu
- Kỹ thuật mô hình
- Đánh giá mô hình
- Triển khai mô hình
- Giám sát và bảo trì
Mỗi giai đoạn trong vòng đời ML đều tuân theo khung đảm bảo chất lượng để liên tục cải tiến và bảo trì bằng cách tuân thủ chặt chẽ các yêu cầu và ràng buộc. Tìm hiểu thêm về đảm bảo chất lượng qua blog CRISP-ML(Q).
Đối với người không chuyên và nhà quản lý, hãy xem khóa học ngắn về Hiểu biết về Machine Learning căn bản. Khóa học giúp bạn nắm bắt tổng quan về ML, mô hình hóa và học sâu (AI). Bạn cũng có thể tìm hiểu sự khác nhau giữa AI và machine learning trong một bài viết riêng.
1. Lập kế hoạch
Ảnh: Tác giả
Giai đoạn lập kế hoạch bao gồm đánh giá phạm vi, chỉ số thành công và tính khả thi của ứng dụng ML. Bạn cần hiểu doanh nghiệp và cách dùng machine learning để cải thiện quy trình hiện tại. Ví dụ: chúng ta có thực sự cần ML không? Có thể đạt được yêu cầu tương tự bằng lập trình đơn giản không?
Bạn cũng cần hiểu phân tích chi phí - lợi ích và cách triển khai giải pháp theo nhiều giai đoạn. Bên cạnh đó, cần xác định các chỉ số thành công rõ ràng, đo lường được cho doanh nghiệp, mô hình ML (Accuracy, F1 score, AUC) và kinh tế (các chỉ số hiệu quả chính).
Cuối cùng, bạn cần tạo báo cáo khả thi.
Báo cáo sẽ bao gồm thông tin về:
- Sự sẵn có của dữ liệu: chúng ta có đủ dữ liệu để huấn luyện mô hình không? Có thể đảm bảo nguồn cung dữ liệu mới và cập nhật liên tục không? Có thể dùng dữ liệu tổng hợp để giảm chi phí không?
- Tính áp dụng: giải pháp này có giải quyết vấn đề hoặc cải thiện quy trình hiện tại không? Chúng ta có thể dùng ML để xử lý vấn đề này không?
- Ràng buộc pháp lý: chúng ta có được chính quyền địa phương cho phép triển khai giải pháp này không? Có thu thập dữ liệu theo cách đạo đức không? Ứng dụng này sẽ tác động thế nào đến xã hội?
- Độ bền vững và khả năng mở rộng: ứng dụng này có đủ mạnh mẽ không? Có mở rộng được không?
- Khả năng giải thích: chúng ta có thể giải thích cách mô hình ML đưa ra kết quả không? Có thể giải thích hoạt động bên trong của mạng nơ-ron sâu không?
- Sự sẵn có của nguồn lực: chúng ta có đủ tài nguyên tính toán, lưu trữ, mạng và nhân sự không? Có các chuyên gia đủ năng lực không?
Lãnh đạo doanh nghiệp có thể học các nguyên tắc cơ bản về ML qua khóa Machine Learning for Business và áp dụng để xây dựng chiến lược cũng như triển khai giải pháp ML.
2. Chuẩn bị dữ liệu
 Ảnh: Tác giả
Phần chuẩn bị dữ liệu được chia thành bốn phần: thu thập và gán nhãn dữ liệu, làm sạch, quản lý và xử lý.
Thu thập và gán nhãn dữ liệu
Trước hết, chúng ta cần quyết định cách thu thập dữ liệu: tổng hợp dữ liệu nội bộ, dùng nguồn mở, mua từ nhà cung cấp hoặc tạo dữ liệu tổng hợp. Mỗi cách có ưu và nhược điểm; trong một số trường hợp, chúng ta sử dụng dữ liệu từ cả bốn phương pháp.
Sau khi thu thập, chúng ta cần gán nhãn dữ liệu. Mua dữ liệu đã sạch và gán nhãn không khả thi với mọi công ty, và bạn có thể cần thay đổi lựa chọn dữ liệu trong quá trình phát triển. Do đó, không thể mua với số lượng lớn và dữ liệu có thể trở nên vô dụng cho giải pháp.
Thu thập và gán nhãn dữ liệu tiêu tốn hầu hết nguồn lực của công ty: tiền, thời gian, chuyên gia, chuyên gia lĩnh vực và các thỏa thuận pháp lý.
Làm sạch dữ liệu
Tiếp theo, chúng ta sẽ làm sạch dữ liệu bằng cách bù giá trị thiếu, phân tích dữ liệu gán nhãn sai, loại bỏ ngoại lệ và giảm nhiễu. Bạn sẽ tạo một pipeline dữ liệu để tự động hóa quy trình này và thực hiện kiểm tra chất lượng dữ liệu.
Xử lý dữ liệu
Giai đoạn xử lý dữ liệu bao gồm chọn đặc trưng, xử lý mất cân bằng lớp, kỹ thuật đặc trưng, tăng cường dữ liệu, chuẩn hóa và scale dữ liệu.
Để tái lập, chúng ta sẽ lưu trữ và quản lý phiên bản metadata, mô hình hóa dữ liệu, pipeline biến đổi và kho đặc trưng.
Quản lý dữ liệu
Cuối cùng, chúng ta sẽ tìm giải pháp lưu trữ dữ liệu, quản lý phiên bản dữ liệu để tái lập, lưu metadata và tạo ETL pipeline. Phần này đảm bảo dòng dữ liệu liên tục cho huấn luyện mô hình.
3. Kỹ thuật mô hình
Ảnh: Tác giả
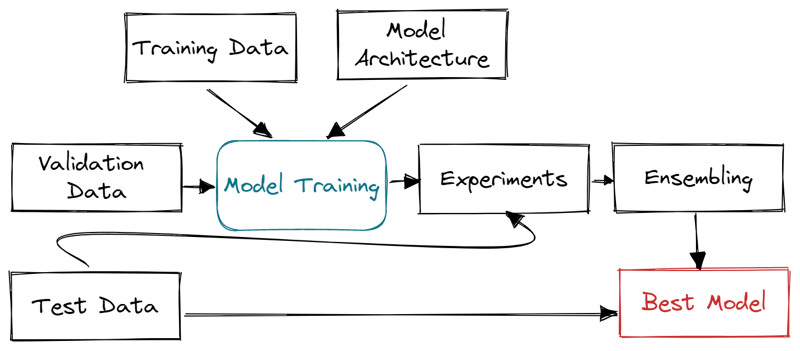
Ở giai đoạn này, chúng ta sử dụng tất cả thông tin từ giai đoạn lập kế hoạch để xây dựng và huấn luyện mô hình ML. Ví dụ: theo dõi chỉ số mô hình, đảm bảo khả năng mở rộng và độ bền, tối ưu tài nguyên lưu trữ và tính toán.
- Xây dựng kiến trúc mô hình hiệu quả dựa trên nghiên cứu chuyên sâu.
- Định nghĩa các chỉ số mô hình.
- Huấn luyện và xác thực mô hình trên tập huấn luyện và tập xác thực.
- Theo dõi thí nghiệm, metadata, đặc trưng, thay đổi mã và pipeline ML.
- Thực hiện nén mô hình và ensemble.
- Diễn giải kết quả với sự tham gia của chuyên gia lĩnh vực.
Chúng ta sẽ tập trung vào kiến trúc mô hình, chất lượng mã, thí nghiệm ML, huấn luyện mô hình và ensemble.
Các đặc trưng, siêu tham số, thí nghiệm ML, kiến trúc mô hình, môi trường phát triển và metadata được lưu trữ và quản lý phiên bản để đảm bảo tái lập.
Tìm hiểu các bước trong kỹ thuật mô hình qua lộ trình nghề nghiệp Machine Learning Scientist with Python. Khóa học giúp bạn nắm kỹ năng cần thiết để trở thành kỹ sư ML.
4. Đánh giá mô hình
 Ảnh: Tác giả
Giờ đây khi đã chốt phiên bản mô hình, đến lúc kiểm tra các chỉ số khác nhau. Tại sao? Để đảm bảo mô hình sẵn sàng đưa vào sản xuất.
Trước tiên, chúng ta sẽ kiểm tra mô hình trên tập kiểm tra và đảm bảo có sự tham gia của chuyên gia lĩnh vực để xác định lỗi trong dự đoán.
Chúng ta cũng cần đảm bảo tuân thủ các khuôn khổ công nghiệp, đạo đức và pháp lý khi xây dựng giải pháp AI.
Hơn nữa, chúng ta sẽ kiểm tra độ bền mô hình trên dữ liệu ngẫu nhiên và dữ liệu thực tế, bảo đảm mô hình suy luận đủ nhanh để tạo ra giá trị.
Cuối cùng, chúng ta so sánh kết quả với các chỉ số thành công đã đề ra và quyết định có triển khai mô hình hay không. Ở giai đoạn này, mọi quy trình đều được ghi lại và quản lý phiên bản để duy trì chất lượng và khả năng tái lập.
5. Triển khai mô hình
 Ảnh: Tác giả
Ở giai đoạn này, chúng ta triển khai mô hình ML vào hệ thống hiện tại. Ví dụ: đưa vào gán nhãn kho tự động dựa trên hình dạng sản phẩm. Chúng ta sẽ triển khai một mô hình thị giác máy tính vào hệ thống hiện hữu, mô hình này sử dụng ảnh từ camera để in nhãn.
Nhìn chung, mô hình có thể được triển khai trên đám mây và máy chủ cục bộ, trình duyệt web, đóng gói dưới dạng phần mềm hoặc thiết bị biên. Sau đó, bạn có thể dùng API, ứng dụng web, plugin hoặc bảng điều khiển để truy cập dự đoán.
Trong quá trình triển khai, chúng ta xác định phần cứng suy luận. Cần đảm bảo đủ RAM, lưu trữ và sức mạnh tính toán để cho ra kết quả nhanh. Sau đó, chúng ta sẽ đánh giá hiệu năng mô hình trong sản xuất bằng A/B testing, bảo đảm khả năng chấp nhận của người dùng.
Chiến lược triển khai rất quan trọng. Bạn cần đảm bảo thay đổi diễn ra mượt mà và cải thiện trải nghiệm người dùng. Ngoài ra, quản lý dự án nên chuẩn bị kế hoạch ứng phó sự cố, bao gồm chiến lược dự phòng, giám sát liên tục, phát hiện bất thường và giảm thiểu tổn thất.
6. Giám sát và bảo trì
 Ảnh: Tác giả
Sau khi triển khai mô hình vào sản xuất, chúng ta cần liên tục giám sát và cải thiện hệ thống. Chúng ta sẽ theo dõi các chỉ số mô hình, hiệu năng phần cứng và phần mềm, cũng như mức độ hài lòng của khách hàng.
Việc giám sát được tự động hóa hoàn toàn và các chuyên gia sẽ được thông báo khi có bất thường, hiệu năng mô hình và hệ thống suy giảm, hoặc đánh giá tiêu cực từ khách hàng.
Khi nhận cảnh báo hiệu năng giảm, chúng ta sẽ đánh giá vấn đề và thử huấn luyện mô hình với dữ liệu mới hoặc thay đổi kiến trúc mô hình. Đây là một quá trình liên tục.
Trong một số ít trường hợp, chúng ta phải đại tu toàn bộ vòng đời ML để cải thiện xử lý dữ liệu và kỹ thuật huấn luyện, cập nhật phần mềm và phần cứng mới, và đưa vào khung tích hợp liên tục mới.
Kết luận
Sinh viên khoa học dữ liệu tại đa số trường đại học chỉ học về xử lý dữ liệu, xây dựng và huấn luyện mô hình, và trong một số trường hợp là triển khai. Họ không được dạy về thực hành đảm bảo chất lượng tiêu chuẩn trong công nghiệp, kỹ thuật thu thập và gán nhãn dữ liệu, pipeline ML, quản lý phiên bản dữ liệu, theo dõi thí nghiệm ML, và giám sát cũng như bảo trì liên tục.
 Ảnh: Tác giả
Ngay cả khi bạn là chuyên gia khoa học dữ liệu, bạn vẫn cần hiểu cách năm công ty công nghệ lớn xây dựng các ứng dụng ML bền vững cho hàng tỷ khách hàng. Bạn cũng có thể học Thiết kế quy trình làm việc Machine Learning bằng Python để xây dựng các pipeline bền bỉ theo thời gian. Khóa học sẽ dạy quy trình chuẩn, quy trình có con người trong vòng lặp, quản lý vòng đời mô hình và quy trình không giám sát.
Trong bài viết này, chúng ta đã tìm hiểu về lập kế hoạch dự án ML dựa trên yêu cầu và ràng buộc, thu thập và gán nhãn dữ liệu, kỹ thuật mô hình, đánh giá mô hình, triển khai mô hình, và giám sát cùng bảo trì. Bên cạnh đó, chúng ta học được nhiều cách duy trì chất lượng, tái lập kết quả và gỡ lỗi quy trình khi gặp sự cố.

