
Kursus
Machine Learning untuk Bisnis
2 jam
47.9K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Google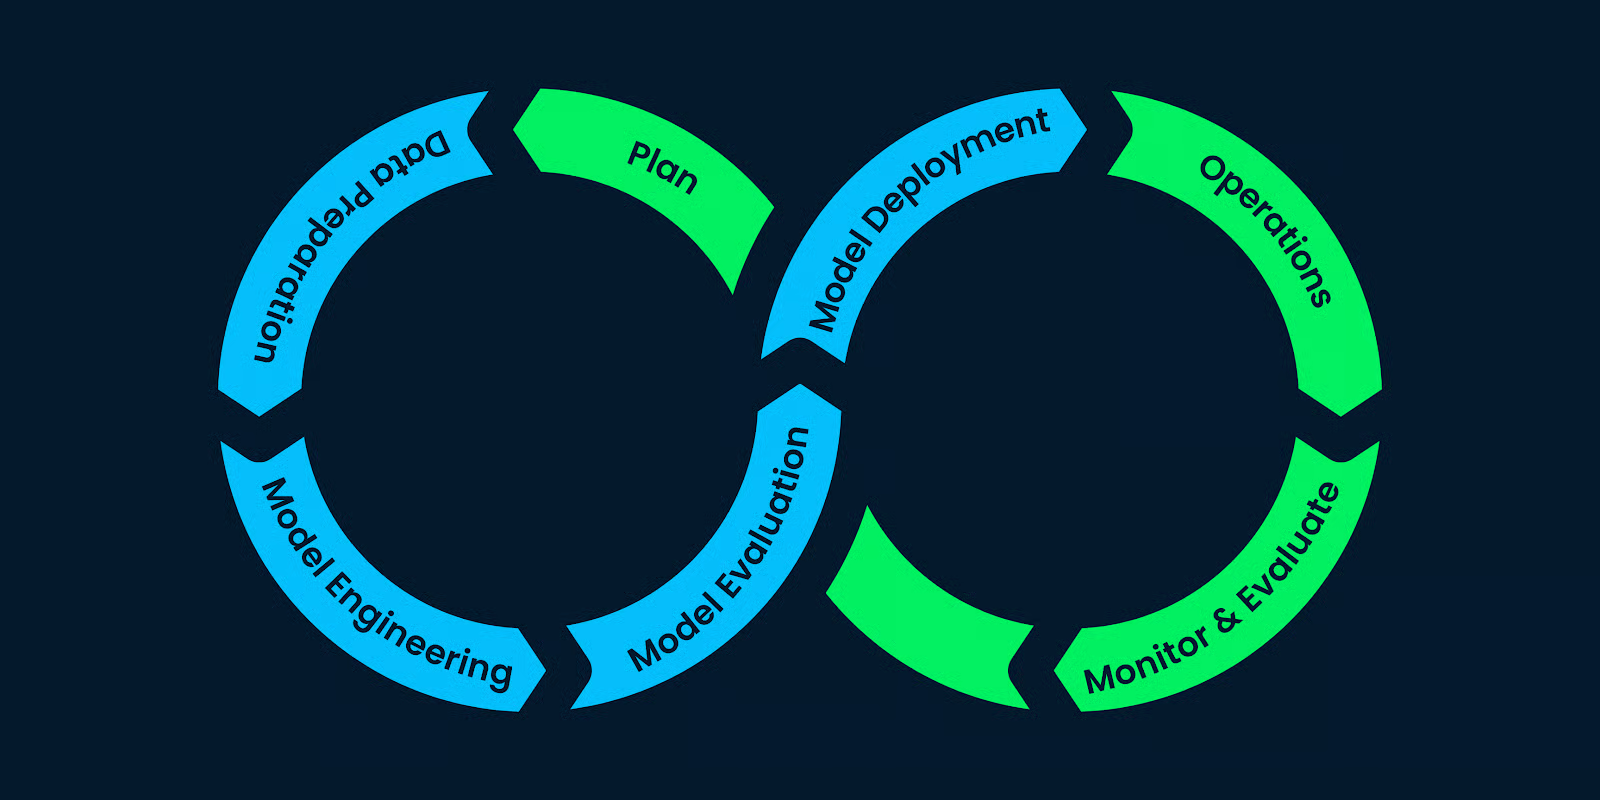
Kita biasanya menganggap proyek machine learning (ML) mencakup pemrosesan data, pelatihan model, dan penerapan model. Namun, cakupannya jauh lebih luas dari itu.
Kita memerlukan pemahaman bisnis dan data, teknik pengumpulan data, analitik data, pembuatan model, dan evaluasi model. Lebih jauh lagi, setelah penerapan, kita memerlukan pemantauan dan pemeliharaan yang berkelanjutan.
Siklus hidup machine learning terdiri dari langkah-langkah yang memberi struktur pada proyek machine learning dan membagi sumber daya perusahaan secara efektif. Mengikuti langkah-langkah ini membantu perusahaan membangun produk AI yang berkelanjutan, hemat biaya, dan berkualitas.
Dalam artikel ini, kami akan menggunakan metodologi Cross-Industry Standard Process for the development of Machine Learning applications with Quality assurance (CRISP-ML(Q)) untuk menjelaskan setiap langkah dalam siklus hidup machine learning. CRISP-ML(Q) adalah standar industri untuk membangun aplikasi machine learning yang berkelanjutan.
Setiap fase dalam siklus machine learning mengikuti kerangka jaminan mutu untuk perbaikan dan pemeliharaan berkelanjutan dengan secara ketat mengikuti persyaratan dan kendala. Pelajari lebih lanjut tentang jaminan mutu dengan membaca blog CRISP-ML(Q).
Untuk individu non-teknis dan para manajer, lihat kursus singkat kami tentang dasar-dasar Memahami Machine Learning. Kursus ini akan membantu mereka memahami machine learning secara umum, pemodelan, dan deep learning (AI). Anda juga dapat menelusuri perbedaan antara AI dan machine learning dalam artikel terpisah.

Gambar oleh Penulis
Fase perencanaan mencakup penilaian ruang lingkup, metrik keberhasilan, dan kelayakan aplikasi ML. Anda perlu memahami bisnis dan bagaimana menggunakan machine learning untuk meningkatkan proses saat ini. Contohnya: apakah kita memerlukan machine learning? Bisakah kita mencapai kebutuhan serupa dengan pemrograman sederhana?
Anda juga perlu memahami analisis biaya-manfaat dan bagaimana Anda akan mengirimkan solusi dalam beberapa tahap. Selain itu, Anda perlu menentukan metrik keberhasilan yang jelas dan terukur untuk bisnis, model machine learning (Accuracy, F1 score, AUC), dan ekonomi (indikator kinerja utama).
Terakhir, Anda perlu membuat laporan kelayakan.
Laporan ini akan berisi informasi tentang:
Pemimpin bisnis dapat mempelajari dasar-dasar machine learning dengan mengikuti kursus Machine Learning for Business dan menerapkan pelajaran ini untuk membuat strategi bisnis serta menerapkan solusi ML.
 Gambar oleh Penulis
Bagian persiapan data dibagi lagi menjadi empat bagian: pengadaan dan pelabelan data, pembersihan, manajemen, dan pemrosesan.
Kita perlu terlebih dahulu memutuskan bagaimana kita akan mengumpulkan data dengan menghimpun data internal, sumber terbuka, membelinya dari vendor, atau menghasilkan data sintetis. Setiap metode memiliki kelebihan dan kekurangan, dan dalam beberapa kasus, kita memperoleh data dari keempat metodologi tersebut.
Setelah pengumpulan, kita perlu memberi label pada data. Membeli data yang sudah dibersihkan dan dilabeli tidak selalu layak bagi semua perusahaan, dan Anda mungkin juga perlu melakukan perubahan pada pemilihan data selama proses pengembangan. Itulah mengapa Anda tidak bisa membelinya dalam jumlah besar dan mengapa data tersebut pada akhirnya bisa tidak berguna bagi solusi.
Pengumpulan dan pelabelan data membutuhkan sebagian besar sumber daya perusahaan: uang, waktu, profesional, pakar materi, dan perjanjian hukum.
Selanjutnya, kita akan membersihkan data dengan mengimputasi nilai yang hilang, menganalisis data yang salah label, menghapus pencilan, dan mengurangi derau. Anda akan membuat pipeline data untuk mengotomatisasi proses ini dan melakukan verifikasi kualitas data.
Tahap pemrosesan data mencakup pemilihan fitur, menangani kelas yang tidak seimbang, rekayasa fitur, augmentasi data, serta normalisasi dan penskalaan data.
Demi reprodusibilitas, kita akan menyimpan dan melakukan versioning pada metadata, pemodelan data, pipeline transformasi, dan feature store.
Terakhir, kita akan menentukan solusi penyimpanan data, versioning data untuk reprodusibilitas, penyimpanan metadata, dan pembuatan pipeline ETL. Bagian ini akan memastikan aliran data yang konstan untuk pelatihan model.

Gambar oleh Penulis
Dalam fase ini, kita akan menggunakan semua informasi dari fase perencanaan untuk membangun dan melatih model machine learning. Contohnya: melacak metrik model, memastikan skalabilitas dan keandalan, serta mengoptimalkan sumber daya penyimpanan dan komputasi.
Kita akan berfokus pada arsitektur model, kualitas kode, eksperimen machine learning, pelatihan model, dan ensembling.
Fitur, hiperparameter, eksperimen ML, arsitektur model, lingkungan pengembangan, dan metadata disimpan serta diberi versi untuk reprodusibilitas.
Pelajari langkah-langkah dalam rekayasa model dengan mengikuti jalur karier Machine Learning Scientist with Python. Ini akan membantu Anda menguasai keterampilan yang diperlukan untuk mendapatkan pekerjaan sebagai machine learning engineer.
 Gambar oleh Penulis
Sekarang setelah kita memfinalkan versi model, saatnya menguji berbagai metrik. Mengapa? Agar kita bisa memastikan bahwa model kita siap untuk produksi.
Pertama, kita akan menguji model pada dataset uji dan memastikan kita melibatkan pakar materi untuk mengidentifikasi kesalahan pada prediksi.
Kita juga perlu memastikan bahwa kita mengikuti kerangka kerja industri, etika, dan hukum untuk membangun solusi AI.
Selanjutnya, kita akan menguji ketangguhan model pada data acak dan data dunia nyata. Memastikan bahwa inferensi model cukup cepat untuk menghadirkan nilai.
Terakhir, kita akan membandingkan hasilnya dengan metrik keberhasilan yang direncanakan dan memutuskan apakah akan menerapkan model atau tidak. Pada fase ini, setiap proses dicatat dan diberi versi untuk menjaga kualitas dan reprodusibilitas.
 Gambar oleh Penulis
Pada fase ini, kita menerapkan model machine learning ke sistem saat ini. Contohnya: memperkenalkan pelabelan gudang otomatis menggunakan bentuk produk. Kita akan menerapkan model visi komputer ke sistem yang ada, yang akan menggunakan gambar dari kamera untuk mencetak label.
Secara umum, model dapat diterapkan di cloud dan server lokal, peramban web, dikemas sebagai perangkat lunak, dan perangkat edge. Setelah itu, Anda dapat menggunakan API, aplikasi web, plugin, atau dasbor untuk mengakses prediksi.
Dalam proses penerapan, kita menentukan perangkat keras untuk inferensi. Kita perlu memastikan bahwa kita memiliki RAM, penyimpanan, dan daya komputasi yang cukup untuk menghasilkan hasil dengan cepat. Setelah itu, kita akan mengevaluasi kinerja model di produksi menggunakan pengujian A/B, memastikan penerimaan pengguna.
Strategi penerapan itu penting. Anda perlu memastikan perubahan berjalan mulus dan meningkatkan pengalaman pengguna. Selain itu, seorang manajer proyek harus menyiapkan rencana penanggulangan bencana. Rencana tersebut harus mencakup strategi fallback, pemantauan berkelanjutan, deteksi anomali, dan meminimalkan kerugian.
 Gambar oleh Penulis
Setelah menerapkan model ke produksi, kita perlu terus memantau dan meningkatkan sistem. Kita akan memantau metrik model, kinerja perangkat keras dan perangkat lunak, serta kepuasan pelanggan.
Pemantauan dilakukan sepenuhnya otomatis, dan para profesional diberi tahu tentang anomali, penurunan kinerja model dan sistem, serta ulasan pelanggan yang buruk.
Setelah kita menerima peringatan penurunan kinerja, kita akan menilai masalahnya dan mencoba melatih model pada data baru atau melakukan perubahan pada arsitektur model. Ini adalah proses yang berkelanjutan.
Dalam kasus yang jarang, kita harus merombak seluruh siklus hidup machine learning untuk meningkatkan teknik pemrosesan data dan pelatihan model, memperbarui perangkat lunak dan perangkat keras baru, serta memperkenalkan kerangka kerja baru untuk integrasi berkelanjutan.
Mahasiswa data science di sebagian besar universitas hanya mempelajari pemrosesan data, pembuatan dan pelatihan model, dan dalam beberapa kasus, penerapan. Mereka tidak diajari praktik jaminan mutu standar industri, teknik pengumpulan dan pelabelan data, pipeline machine learning, versioning data, pelacakan eksperimen ML, serta pemantauan dan pemeliharaan berkelanjutan.
 Gambar oleh Penulis
Bahkan jika Anda seorang profesional data science, Anda perlu mempelajari bagaimana lima raksasa teknologi membangun aplikasi machine learning yang berkelanjutan untuk miliaran pelanggan. Anda juga dapat mempelajari Designing Machine Learning Workflows in Python untuk membangun pipeline yang tahan uji waktu. Kursus ini akan mengajarkan alur kerja standar, proses human-in-the-loop, manajemen siklus hidup model, dan alur kerja tanpa supervisi.
Dalam artikel ini, kita telah mempelajari perencanaan proyek machine learning berdasarkan persyaratan dan kendala, pengumpulan dan pelabelan data, rekayasa model, evaluasi model, penerapan model, serta pemantauan dan pemeliharaan. Selain itu, kita mempelajari berbagai cara untuk menjaga kualitas, mereproduksi hasil, dan menelusuri kesalahan proses jika terjadi kegagalan.
Kursus Machine Learning
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



