
Kurs
İş Dünyası için Machine Learning
2 sa
47.9K
Alıştırma and program your progress.
Google Ile Devam Edin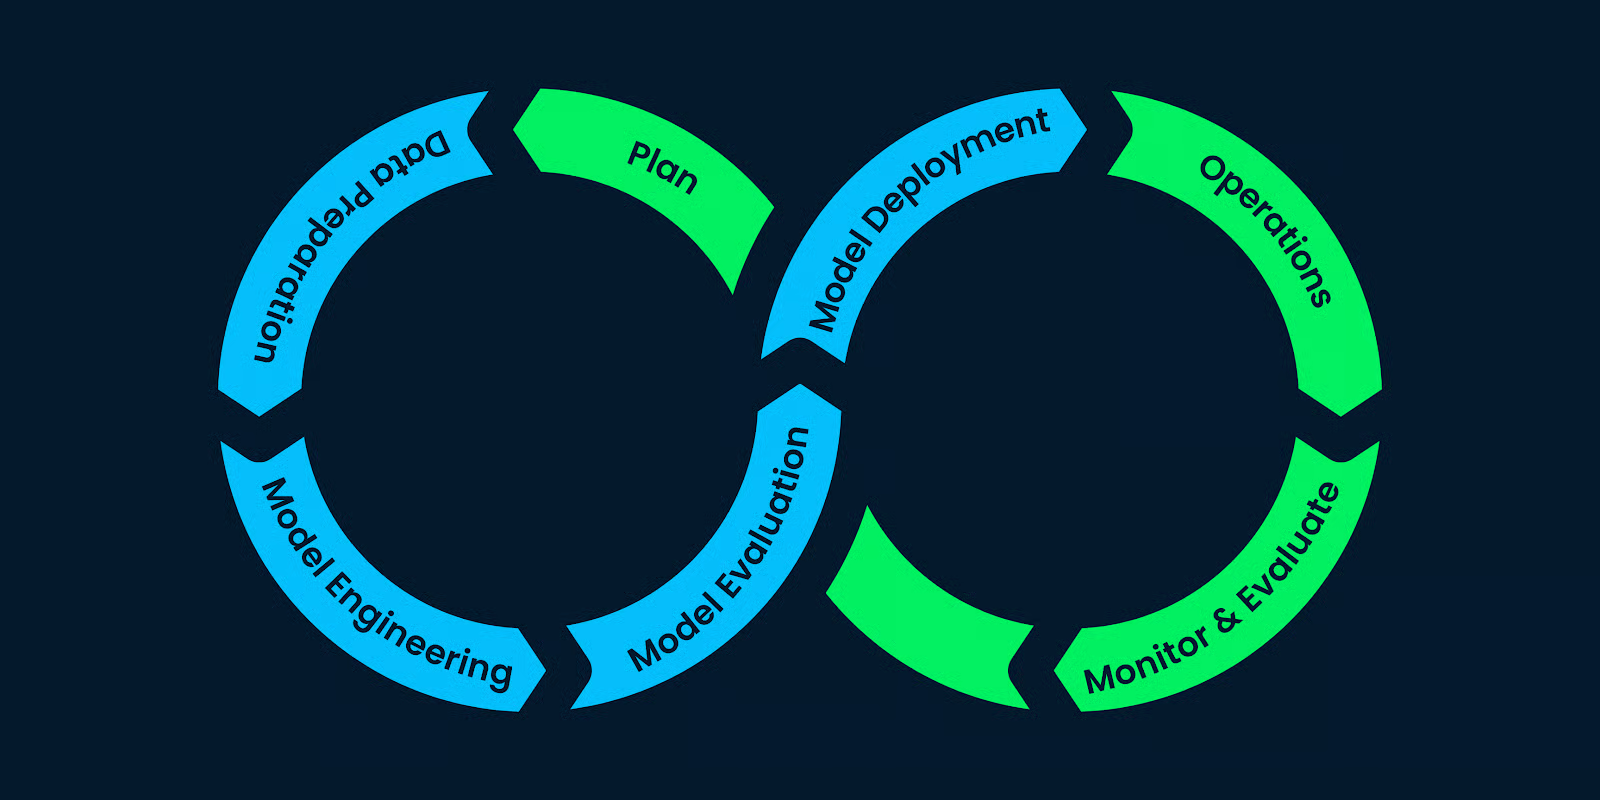
Genellikle makine öğrenimi (ML) projelerinin veri işleme, model eğitimi ve model dağıtımını içerdiğini düşünürüz. Ancak bundan çok daha fazlası var.
İş ve veri anlayışına, veri toplama tekniklerine, veri analizine, model kurmaya ve model değerlendirmeye ihtiyacımız var. Ayrıca, dağıtımdan sonra sürekli izleme ve bakıma ihtiyaç duyulur.
Makine öğrenimi yaşam döngüsü, projeye yapı kazandıran ve şirket kaynaklarını etkin şekilde bölen adımlardan oluşur. Bu adımları izlemek, şirketlerin sürdürülebilir, uygun maliyetli ve kaliteli yapay zekâ ürünleri geliştirmesine yardımcı olur.
Bu yazıda, makine öğrenimi yaşam döngüsündeki her adımı açıklamak için Kalite güvencesi metodolojisine sahip Sektörler Arası Standart Makine Öğrenimi Uygulamaları Geliştirme Süreci (CRISP-ML(Q))’ni kullanacağız. CRISP-ML(Q), sürdürülebilir makine öğrenimi uygulamaları geliştirmek için endüstriyel bir standarttır.
Makine öğrenimi döngüsündeki her aşama, gereksinim ve kısıtlamalara sıkı sıkıya uyarak sürekli iyileştirme ve bakım için bir kalite güvence çerçevesini izler. CRISP-ML(Q) blogunu okuyarak kalite güvencesi hakkında daha fazla bilgi edinin.
Teknik olmayan bireyler ve yöneticiler için, Makine Öğrenimini Anlamak temellerine yönelik kısa kursumuza göz atın. Bu kurs, genel olarak makine öğrenimini, modellemeyi ve derin öğrenmeyi (AI) anlamalarına yardımcı olur. Ayrıca ayrı bir yazıda yapay zekâ ile makine öğrenimi arasındaki farkları da keşfedebilirsiniz.

Görsel: Yazar
Planlama aşaması, ML uygulamasının kapsamını, başarı ölçütünü ve uygulanabilirliğini değerlendirmeyi içerir. İşi ve mevcut süreci iyileştirmek için makine öğrenimini nasıl kullanacağınızı anlamanız gerekir. Örneğin: Makine öğrenimine gerçekten ihtiyaç var mı? Benzer çıktılara basit programlamayla ulaşabilir miyiz?
Ayrıca maliyet-fayda analizini ve çözümü birden fazla aşamada nasıl sunacağınızı anlamalısınız. Bunun yanında, işletme için, makine öğrenimi modelleri için (Doğruluk, F1 skoru, AUC) ve ekonomik açıdan (temel performans göstergeleri) net ve ölçülebilir başarı metrikleri tanımlamalısınız.
Son olarak bir uygulanabilirlik raporu oluşturmanız gerekir.
Bu rapor şu bilgileri içerecektir:
İş liderleri, İş Dünyası için Makine Öğrenimi kursunu alarak makine öğreniminin temellerini öğrenebilir ve bu dersleri iş stratejileri oluşturmak ve ML çözümleri uygulamak için kullanabilir.
 Görsel: Yazar
Veri hazırlama bölümü; veri tedariki ve etiketleme, temizleme, yönetim ve işlemeye ayrılan dört kısımdan oluşur.
Önce verileri nasıl toplayacağımıza karar vermemiz gerekir: dahili verileri bir araya getirerek, açık kaynaklardan, tedarikçilerden satın alarak veya sentetik veri üreterek. Her yöntemin artıları ve eksileri vardır ve bazı durumlarda verileri bu dört yöntemin tümünden elde ederiz.
Toplamadan sonra verileri etiketlememiz gerekir. Temizlenmiş ve etiketlenmiş veriyi satın almak tüm şirketler için mümkün değildir ve geliştirme sürecinde veri seçimine ilişkin değişiklikler yapmanız da gerekebilir. Bu nedenle veriyi toplu halde satın alamazsınız ve veri zamanla çözüm için kullanılmaz hale gelebilir.
Veri toplama ve etiketleme, şirket kaynaklarının büyük kısmını gerektirir: para, zaman, profesyoneller, konu uzmanları ve yasal anlaşmalar.
Ardından, eksik değerleri atayarak, yanlış etiketlenmiş verileri analiz ederek, aykırı değerleri kaldırarak ve gürültüyü azaltarak veriyi temizleyeceğiz. Bu süreci otomatikleştirmek için bir veri hattı (pipeline) oluşturacak ve veri kalitesi doğrulaması gerçekleştireceksiniz.
Veri işleme aşaması; özellik seçimi, dengesiz sınıflarla başa çıkma, özellik mühendisliği, veri artırma ve veriyi normalleştirme/ölçeklendirmeyi içerir.
Tekrar üretilebilirlik için, üstveriyi, veri modellemeyi, dönüşüm hatlarını ve özellik depolarını saklayıp sürümlendireceğiz.
Son olarak veri depolama çözümlerini, tekrar üretilebilirlik için veri sürümlendirmeyi, üstveri depolamayı ve ETL hatları oluşturmayı belirleyeceğiz. Bu bölüm, model eğitimi için sürekli bir veri akışı sağlayacaktır.

Görsel: Yazar
Bu aşamada, planlama aşamasındaki tüm bilgileri kullanarak bir makine öğrenimi modeli inşa edip eğiteceğiz. Örneğin: model metriklerini izleme, ölçeklenebilirlik ve sağlamlığı sağlama, depolama ve hesaplama kaynaklarını optimize etme.
Model mimarisi, kod kalitesi, makine öğrenimi deneyleri, model eğitimi ve topluluk yöntemlerine odaklanacağız.
Özellikler, hiperparametreler, ML deneyleri, model mimarisi, geliştirme ortamı ve üstveri; tekrar üretilebilirlik için saklanır ve sürümlendirilir.
Model mühendisliğinde yer alan adımlar hakkında bilgi edinmek için Python ile Makine Öğrenimi Bilimcisi kariyer yolunu takip edin. Bir makine öğrenimi mühendisi olarak işe girmenize yardımcı olacak gerekli becerilerde ustalaşmanızı sağlar.
 Görsel: Yazar
Artık modelin sürümünü sonlandırdığımıza göre, çeşitli metrikleri test etme zamanı. Neden? Böylece modelimizin üretime hazır olduğundan emin olabilelim.
Önce modelimizi bir test veri kümesi üzerinde deneyeceğiz ve tahminlerdeki hataları belirlemek için konu uzmanlarını mutlaka sürece dahil edeceğiz.
Ayrıca yapay zekâ çözümleri geliştirirken endüstriyel, etik ve yasal çerçevelere uyduğumuzdan emin olmalıyız.
Ek olarak modelimizi rastgele ve gerçek dünya verileri üzerinde sağlamlık açısından test edeceğiz. Modelin yeterince hızlı çıkarım yaptığından ve değer kattığından emin olacağız.
Son olarak, sonuçları planlanan başarı metrikleriyle karşılaştıracak ve modeli dağıtıp dağıtmamaya karar vereceğiz. Bu aşamada kalite ve tekrar üretilebilirliği korumak için her işlem kaydedilir ve sürümlendirilir.
 Görsel: Yazar
Bu aşamada, makine öğrenimi modellerini mevcut sisteme dağıtırız. Örneğin: ürünün şekline göre otomatik depo etiketleme getirmek. Kameradan alınan görüntüleri kullanarak etiket basacak bir bilgisayarlı görü modelini mevcut sisteme dağıtacağız.
Genel olarak modeller bulutta ve yerel sunucuda, web tarayıcısında, yazılım olarak paketlenmiş şekilde ve uç cihazlarda dağıtılabilir. Sonrasında tahminlere API, web uygulaması, eklentiler veya gösterge paneli üzerinden erişebilirsiniz.
Dağıtım sürecinde çıkarım donanımını tanımlarız. Hızlı sonuç üretmek için yeterli RAM, depolama ve işlem gücüne sahip olduğumuzdan emin olmamız gerekir. Ardından, kullanıcı kabulünü güvence altına almak için A/B testini kullanarak model performansını üretimde değerlendireceğiz.
Dağıtım stratejisi önemlidir. Değişikliklerin sorunsuz olduğundan ve kullanıcı deneyimini iyileştirdiğinden emin olmanız gerekir. Ayrıca bir proje yöneticisi bir felaket yönetimi planı hazırlamalıdır. Bu plan; geri dönüş stratejisi, sürekli izleme, anomali tespiti ve kayıpların en aza indirilmesini içermelidir.
 Görsel: Yazar
Modeli üretime aldıktan sonra sistemi sürekli izleyip iyileştirmemiz gerekir. Model metriklerini, donanım ve yazılım performansını ve müşteri memnuniyetini izleyeceğiz.
İzleme tamamen otomatik yapılır ve profesyonellere anomaliler, azalan model ve sistem performansı ile olumsuz müşteri yorumları hakkında bildirim gider.
Azalan performans uyarısı aldıktan sonra sorunları değerlendirecek ve modeli yeni verilerle eğitmeyi veya model mimarisinde değişiklik yapmayı deneyeceğiz. Bu, kesintisiz bir süreçtir.
Nadir durumlarda, veri işleme ve model eğitimi tekniklerini iyileştirmek, yeni yazılım ve donanımlar eklemek ve sürekli entegrasyon için yeni bir çerçeve sunmak amacıyla makine öğrenimi yaşam döngüsünün tamamını yenilememiz gerekebilir.
Çoğu üniversitedeki veri bilimi öğrencileri yalnızca veri işleme, model kurma ve eğitme, bazı durumlarda ise dağıtım hakkında eğitim alır. Standart endüstriyel kalite güvence uygulamaları, veri toplama ve etiketleme teknikleri, makine öğrenimi hatları, veri sürümlendirme, ML deneylerinin takibi ile sürekli izleme ve bakım konularında eğitim verilmez.
 Görsel: Yazar
Bir veri bilimi profesyoneli olsanız bile, en büyük beş teknoloji şirketinin milyarlarca müşteri için nasıl sürdürülebilir makine öğrenimi uygulamaları geliştirdiğini öğrenmeniz gerekir. Zamanın testinden geçen hatlar (pipeline) oluşturmak için Python'da Makine Öğrenimi İş Akışları Tasarlama eğitimini de alabilirsiniz. Bu kurs; standart iş akışı, insan-döngüde süreçleri, model yaşam döngüsü yönetimi ve gözetimsiz iş akışını öğretir.
Bu yazıda, gereksinim ve kısıtlamalara dayalı makine öğrenimi proje planlamasını; veri toplama ve etiketlemeyi, model mühendisliğini, model değerlendirmeyi, model dağıtımını ve izleme ile bakımı öğrendik. Bunların yanı sıra, kaliteyi korumanın, sonuçları tekrar üretmenin ve başarısızlık durumunda süreci hata ayıklamanın çeşitli yollarını ele aldık.
Makine Öğrenimi Kursları
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




